Wav2Vec2: ახალი ეპოქა მეტყველების ავტომატურ ამოცნობაში
Wav2Vec2 წარმოადგენს ინოვაციურ მოდელს, რომელიც იყენებს კონტრასტულ წინასწარ წვრთნას 50 000 საათზე მეტი არადანიშნული მეტყველების მონაცემებიდან მძლავრი წარმოდგენების შესასწავლად. BERT-ის მსგავსად, ის ნიღბავს ფუნქციის ვექტორებს კონტექსტუალიზებული წარმოდგენების მისაღებად. მოდელმა აჩვენა კონკურენტული შედეგები თანამედროვე ავტომატური მეტყველების ამოცნობის (ASR) სისტემებთან, მინიმალური, სულ რაღაც 10 წუთის, დანიშნულ მონაცემებზე დამატებითი წვრთნის შემდეგ. ეს სტატია დეტალურად განმარტავს Wav2Vec2-ის წინასწარ
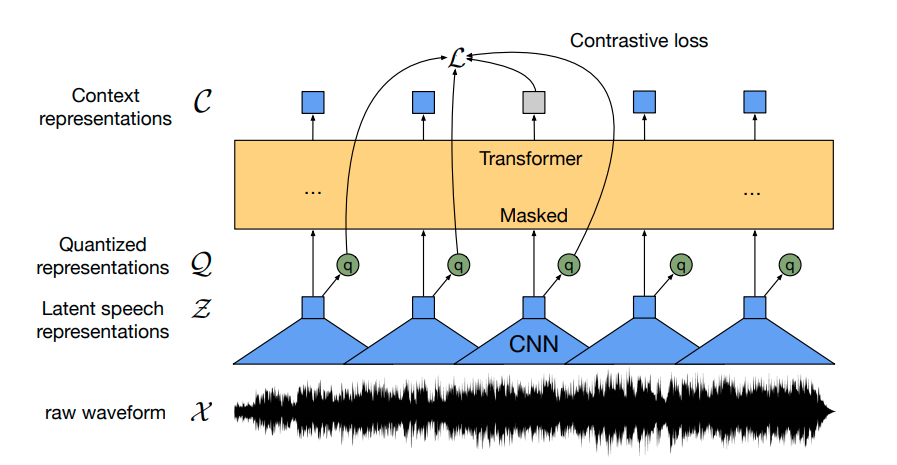
ინოვაციური კონტრასტული წინასწარი წვრთნის მექანიზმის გამოყენებით, Wav2Vec2 სწავლობს მძლავრ მეტყველების წარმოდგენებს 50 000 საათზე მეტი არადანიშნული მეტყველებიდან. BERT-ის ნიღბიანი ენის მოდელირების მსგავსად, მოდელი სწავლობს კონტექსტუალიზებულ მეტყველების წარმოდგენებს ფუნქციის ვექტორების შემთხვევით ნიღბით, სანამ მათ ტრანსფორმატორულ ქსელში გადასცემს. პირველად, დადასტურდა, რომ წინასწარი წვრთნა, რასაც მოჰყვება ძალიან მცირე დანიშნულ მეტყველების მონაცემებზე დამატებითი წვრთნა, იძლევა კონკურენტულ შედეგებს თანამედროვე ASR სისტემებთან შედარებით. სულ რაღაც 10 წუთიანი დანიშნული მონაცემების გამოყენებით, Wav2Vec2 აღწევს სიტყვების შეცდომის მაჩვენებელს (WER) 5%-ზე ნაკლებს LibriSpeech-ის სუფთა სატესტო ნაკრებზე - იხილეთ ნაშრომის ცხრილი 9.
ამ ნოუთბუქში, ჩვენ დეტალურად განვმარტავთ, თუ როგორ შეიძლება Wav2Vec2-ის წინასწარ გაწვრთნილი „ჩეკპოინტები“ დამატებით გაიწვრთნას ნებისმიერ ინგლისურ ASR მონაცემთა ნაკრებზე. გაითვალისწინეთ, რომ ამ ნოუთბუქში Wav2Vec2-ს დამატებით გავწვრთნით ენის მოდელის გამოყენების გარეშე. ენის მოდელის გარეშე Wav2Vec2-ის, როგორც ბოლო-ბოლო (end-to-end) ASR სისტემის გამოყენება ბევრად მარტივია და დადასტურებულია, რომ Wav2Vec2-ის ცალკეული აკუსტიკური მოდელი შთამბეჭდავ შედეგებს აღწევს. დემონსტრაციის მიზნით, ჩვენ დამატებით გავწვრთნით „ბაზისური“ ზომის წინასწარ გაწვრთნილ „ჩეკპოინტს“ საკმაოდ მცირე Timit მონაცემთა ნაკრებზე, რომელიც მხოლოდ 5 საათიან საწვრთნელ მონაცემებს შეიცავს. Wav2Vec2 დამატებით იწვრთნება Connectionist Temporal Classification (CTC) გამოყენებით, რომელიც არის ალგორითმი ნერვული ქსელების წვრთნისთვის მიმდევრობა-მიმდევრობაზე (sequence-to-sequence) პრობლემებისთვის, ძირითადად ავტომატურ მეტყველების ამოცნობასა და ხელნაწერის ამოცნობაში. უაღრესად გირჩევთ წაიკითხოთ ავლან ჰანუნის შესანიშნავად დაწერილი ბლოგ-პოსტი „მიმდევრობის მოდელირება CTC-ით“ (2017).
სანამ დავიწყებთ, დავაყენოთ როგორც datasets, ასევე transformers master-დან. ასევე, გვჭირდება soundfile პაკეტი აუდიო ფაილების ჩასატვირთად და jiwer ჩვენი დამატებით გაწვრთნილი მოდელის შესაფასებლად სიტყვების შეცდომის მაჩვენებლის (WER) მეტრიკის გამოყენებით. შემდეგი, კატეგორიულად გირჩევთ, რომ თქვენი საწვრთნელი „ჩეკპოინტები“ უშუალოდ Hugging Face Hub-ში ატვირთოთ წვრთნის დროს. Hub-ს აქვს ინტეგრირებული ვერსიის კონტროლი, ასე რომ დარწმუნებული იქნებით, რომ წვრთნის დროს არც ერთი მოდელის „ჩეკპოინტი“ არ დაიკარგება. ამისათვის თქვენ უნდა შეინახოთ თქვენი ავთენტიფიკაციის ტოკენი Hugging Face ვებსაიტიდან (დარეგისტრირდით აქ, თუ ჯერ არ გაგიკეთებიათ!). შემდეგ დაგჭირდებათ Git-LFS-ის დაყენება თქვენი მოდელის „ჩეკპოინტების“ ასატვირთად. Timit ჩვეულებრივ ფასდება ფონემათა შეცდომის მაჩვენებლით (PER), მაგრამ ASR-ში ყველაზე გავრცელებული მეტრიკა სიტყვების შეცდომის მაჩვენებელი (WER) არის. ამ ნოუთბუქის მაქსიმალურად ზოგადი სახით შესანარჩუნებლად, ჩვენ გადავწყვიტეთ მოდელის შეფასება WER-ის გამოყენებით.
ASR მოდელები მეტყველებას ტექსტად გარდაქმნიან, რაც ნიშნავს, რომ გვჭირდება როგორც ფუნქციის ამომღები (feature extractor), რომელიც ამუშავებს მეტყველების სიგნალს მოდელის შეყვანის ფორმატში, მაგ. ფუნქციის ვექტორად, ასევე ტოკენიზატორი (tokenizer), რომელიც ამუშავებს მოდელის გამომავალ ფორმატს ტექსტად. 🤗 Transformers-ში Wav2Vec2 მოდელს, შესაბამისად, თან ახლავს როგორც ტოკენიზატორი, სახელწოდებით Wav2Vec2CTCTokenizer, ასევე ფუნქციის ამომღები, სახელწოდებით Wav2Vec2FeatureExtractor. დავიწყოთ ტოკენიზატორის შექმნით, რომელიც პასუხისმგებელია მოდელის პროგნოზების დეკოდირებაზე. წინასწარ გაწვრთნილი Wav2Vec2 „ჩეკპოინტი“ მეტყველების სიგნალს კონტექსტური წარმოდგენების მიმდევრობად აქცევს, როგორც ზემოთ მოცემულ ფიგურაზეა ილუსტრირებული. დამატებით გაწვრთნილი Wav2Vec2 „ჩეკპოინტი“ უნდა გარდაქმნას კონტექსტური წარმოდგენების ეს მიმდევრობა მის შესაბამის ტრანსკრიფციად, რისთვისაც ტრანსფორმატორის ბლოკზე (ნაჩვენებია ყვითლად) უნდა დაემატოს ხაზოვანი ფენა. ეს ხაზოვანი ფენა გამოიყენება თითოეული კონტექსტური წარმოდგენის ტოკენის კლასად კლასიფიკაციისთვის, ანალოგიურად, თუ როგორ, მაგალითად, წინასწარი წვრთნის შემდეგ BERT-ის ჩაშენებებზე ემატება ხაზოვანი ფენა შემდგომი კლასიფიკაციისთვის - იხილეთ ამ ბლოგ-პოსტის „BERT“ სექცია. ამ ფენის გამომავალი ზომა შეესაბამება ლექსიკონში ტოკენების რაოდენობას, რაც არ არის დამოკიდებული Wav2Vec2-ის წინასწარი წვრთნის ამოცანაზე, არამედ მხოლოდ დამატებითი წვრთნისთვის გამოყენებულ დანიშნულ მონაცემთა ნაკრებზე. ასე რომ, პირველ ეტაპზე, განვიხილავთ Timit-ს და განვსაზღვრავთ ლექსიკონს მონაცემთა ნაკრების ტრანსკრიფციების საფუძველზე.
დავიწყოთ მონაცემთა ნაკრების ჩატვირთვით და მისი სტრუქტურის განხილვით. ბევრი ASR მონაცემთა ნაკრები მხოლოდ სამიზნე ტექსტს ('text') იძლევა თითოეული აუდიო ფაილისთვის ('file'). Timit სინამდვილეში ბევრად მეტ ინფორმაციას გვაწვდის თითოეულ აუდიო ფაილზე, როგორიცაა 'phonetic_detail' და ა.შ., რის გამოც ბევრი მკვლევარი ირჩევს თავისი მოდელების შეფასებას ფონემების კლასიფიკაციაზე მეტყველების ამოცნობის ნაცვლად Timit-თან მუშაობისას. თუმცა, ჩვენ გვინდა, რომ ნოუთბუქი მაქსიმალურად ზოგადი იყოს, ამიტომ დამატებითი წვრთნისთვის მხოლოდ ტრანსკრიფციულ ტექსტს განვიხილავთ. დავწეროთ მოკლე ფუნქცია მონაცემთა ნაკრების რამდენიმე შემთხვევითი ნიმუშის საჩვენებლად და გავუშვათ რამდენჯერმე, რათა ვიგრძნოთ ტრანსკრიფციები. ტრანსკრიფციები ძალიან სუფთა ჩანს და ენა უფრო წერილობით ტექსტს ჰგავს, ვიდრე დიალოგს. ეს აზრიანია, თუ გავითვალისწინებთ, რომ Timit არის წაკითხული მეტყველების კორპუსი. ჩვენ ვხედავთ, რომ ტრანსკრიფციები შეიცავს ზოგიერთ სპეციალურ სიმბოლოს, როგორიცაა ,.?!;:. ენის მოდელის გარეშე, ბევრად უფრო რთულია მეტყველების ნაწილების კლასიფიკაცია ასეთ სპეციალურ სიმბოლოებად, რადგან ისინი რეალურად არ...
თეგები:
#ხელოვნური ინტელექტი
#მანქანური სწავლება
#ღრმა სწავლება
#hugging face
#nlp
#მეტყველების ამოცნობა
#asr
#wav2vec2
#ctc
წყარო: huggingface.co
AI-ით გადამუშავებული
მსგავსი სტატიები

ტექნოლოგიები
Honor Magic V6: უთხელესი დასაკეცი ტელეფონი? პირველი შთაბეჭდილებები
ტექნოლოგიები
Honor Magic V6: ყველაზე თხელი დასაკეცი სმარტფონი და მისი შთამბეჭდავი შესაძლებლობები

ტექნოლოგიები