კვანტიზაცია: ეფექტური გადაწყვეტა ემბედინგების მასშტაბირების პრობლემისთვის
ემბედინგები ბუნებრივი ენის დამუშავების (NLP) გადამწყვეტი ინსტრუმენტია, თუმცა მათი მასშტაბირება წარმოების მიზნებისთვის ხშირად იწვევს მაღალ ხარჯებსა და ლატენტურობას. სტატია განიხილავს ამ გამოწვევებს, არსებულ მიდგომებს (როგორიცაა განზომილების შემცირება და Matryoshka Representation Learning) და წარმოგიდგენთ კვანტიზაციას, კერძოდ ბინარულ კვანტიზაციას, როგორც ინოვაციურ გადაწყვეტას. ბინარული კვანტიზაცია float32 მნიშვნელობებს 1-ბიტიან მნიშვნელობებად აქცევს, რაც მეხსიერებასა და შენახვის ადგილს 32-ჯერ ამცი
ემბედინგები ბუნებრივი ენის დამუშავების (NLP) ერთ-ერთი ყველაზე მრავალმხრივი ინსტრუმენტია, რომელიც უამრავ სცენარსა და გამოყენების შემთხვევას უჭერს მხარს. არსებითად, ემბედინგები უფრო რთული ობიექტების (როგორიცაა ტექსტი, სურათები, აუდიო და ა.შ.) რიცხვითი წარმოდგენებია. კერძოდ, ობიექტები წარმოდგენილია როგორც n-განზომილებიანი ვექტორები. რთული ობიექტების ტრანსფორმაციის შემდეგ, მათი მსგავსების დადგენა შესაძლებელია შესაბამისი ემბედინგების მსგავსების გამოთვლით! ეს გადამწყვეტია მრავალი გამოყენების შემთხვევისთვის: ის საფუძველს უქმნის სარეკომენდაციო სისტემებს, ინფორმაციის მოძიებას, ერთ-კადრიან ან მცირე-კადრიან სწავლებას, გადახრების (outlier) გამოვლენას, მსგავსების ძიებას, პარაფრაზის გამოვლენას, კლასტერიზაციას, კლასიფიკაციას და ბევრ სხვას.
თუმცა, ემბედინგების მასშტაბირება წარმოების მიზნებისთვის შეიძლება რთული იყოს, რაც იწვევს ძვირადღირებულ გადაწყვეტილებებს და მაღალ ლატენტურობას. ამჟამად, მრავალი უახლესი მოდელი ქმნის 1024 განზომილების მქონე ემბედინგებს, რომელთაგან თითოეული კოდირებულია float32 ფორმატში, ანუ მათ სჭირდება 4 ბაიტი თითო განზომილებაზე. 250 მილიონი ვექტორიდან ინფორმაციის მოსაძიებლად დაახლოებით 1 ტბ მეხსიერება იქნება საჭირო! ქვემოთ მოცემული ცხრილი წარმოადგენს სხვადასხვა მოდელის, განზომილების ზომის, მეხსიერების მოთხოვნებისა და ხარჯების მიმოხილვას. ხარჯები გამოითვლება დაახლოებით $3.8 თვეში GB-ზე, AWS-ის x2gd ინსტანციების გამოყენებით.
ემბედინგების მასშტაბირების გამოწვევებთან გამკლავების რამდენიმე გზა არსებობს. ყველაზე გავრცელებული მიდგომაა განზომილების შემცირება (dimensionality reduction), მაგალითად, PCA. თუმცა, კლასიკური განზომილების შემცირების მეთოდები – როგორიცაა PCA – როგორც წესი, ცუდად მუშაობს ემბედინგებთან გამოყენებისას. ბოლო დროს, OpenAI-ის მიერ გამოყენებული "მატრიოშკას წარმოდგენის სწავლება" (Matryoshka Representation Learning - MRL) ასევე იძლევა იაფი ემბედინგების შექმნის საშუალებას. MRL-ის შემთხვევაში, მხოლოდ n საწყისი ემბედინგის განზომილება გამოიყენება. ეს მიდგომა უკვე მიღებულია ზოგიერთი ღია მოდელის მიერ, როგორიცაა nomic-ai/nomic-embed-text-v1.5 და mixedbread-ai/mxbai-embed-2d-large-v1 (OpenAI-ის text-embedding-3-large-ისთვის, ჩვენ ვხედავთ 93.1%-იან წარმადობის შენარჩუნებას 12-ჯერადი შეკუმშვისას. Nomic-ის მოდელისთვის კი ვინარჩუნებთ წარმადობის 95.8%-ს 3-ჯერადი შეკუმშვისას და 90%-ს 6-ჯერადი შეკუმშვისას).
თუმცა, ამ გამოწვევაზე პროგრესის მისაღწევად არსებობს კიდევ ერთი ახალი მიდგომა; ის არ გულისხმობს განზომილების შემცირებას, არამედ ემბედინგში თითოეული ინდივიდუალური მნიშვნელობის ზომის შემცირებას: კვანტიზაცია (Quantization). კვანტიზაციაზე ჩვენი ექსპერიმენტები აჩვენებს, რომ შეგვიძლია შევინარჩუნოთ მაღალი წარმადობა, მნიშვნელოვნად დავაჩქაროთ გამოთვლები და დავზოგოთ მეხსიერება, შენახვის ადგილი და ხარჯები. მოდით, ჩავუღრმავდეთ მას!
მოდელებში კვანტიზაციისგან განსხვავებით, სადაც წონების სიზუსტე მცირდება, ემბედინგებისთვის კვანტიზაცია თავად ემბედინგების შემდგომ დამუშავების (post-processing) საფეხურს გულისხმობს. კერძოდ, ბინარული კვანტიზაცია (binary quantization) გულისხმობს ემბედინგში float32 მნიშვნელობების 1-ბიტიან მნიშვნელობებად გარდაქმნას, რაც იწვევს მეხსიერების და შენახვის ადგილის 32-ჯერ შემცირებას. float32 ემბედინგების ბინარულად კვანტიზაციისთვის, ჩვენ უბრალოდ ნორმალიზებულ ემბედინგებს ვზღუდავთ 0-ზე: f(x)={0if x≤01if x>0
ამ ბინარული ემბედინგების ეფექტურად მოსაძიებლად შეგვიძლია გამოვიყენოთ ჰემინგის მანძილი (Hamming Distance). ეს არის პოზიციების რაოდენობა, რომლებზეც ორი ბინარული ემბედინგის ბიტები განსხვავდება. რაც უფრო დაბალია ჰემინგის მანძილი, მით უფრო ახლოსაა ემბედინგები; შესაბამისად, მით უფრო აქტუალურია დოკუმენტი. ჰემინგის მანძილის უზარმაზარი უპირატესობა ის არის, რომ მისი მარტივად გამოთვლა შესაძლებელია 2 CPU ციკლით, რაც უზრუნველყოფს ელვისებურად სწრაფ წარმადობას. Yamada და სხვ. (2021) შემოიღეს ხელახალი შეფასების (rescore) საფეხური, რომელსაც მათ rerank უწოდეს, წარმადობის გასაუმჯობესებლად. მათ შემოგვთავაზეს, რომ float32 მოთხოვნის ემბედინგი (query embedding) შეიძლება შედარდეს ბინარულ დოკუმენტის ემბედინგებთან წერტილოვანი ნამრავლის (dot-product) გამოყენებით.
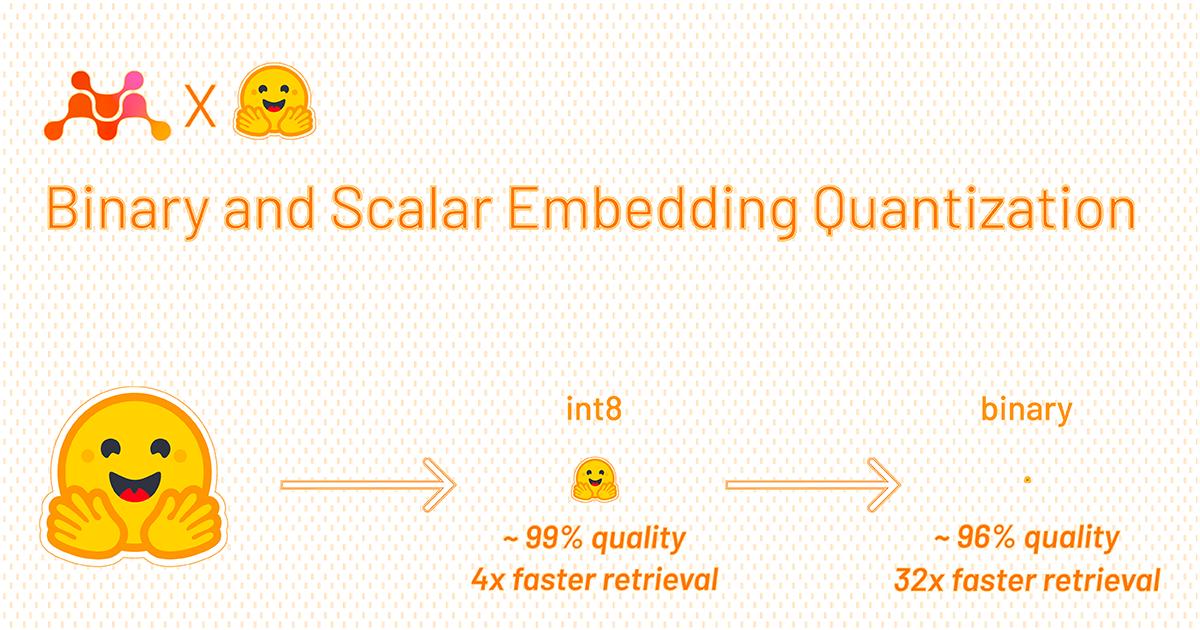
პრაქტიკაში, ჩვენ ჯერ ვეძებთ `rescore_multiplier * top_k` შედეგს ბინარული მოთხოვნის ემბედინგისა და ბინარული დოკუმენტის ემბედინგების გამოყენებით – ანუ, ორმაგი ბინარული მოძიების პირველი `k` შედეგების სიას – და შემდეგ ხელახლა ვაფასებთ ამ ბინარული დოკუმენტის ემბედინგების სიას float32 მოთხოვნის ემბედინგით. ამ ინოვაციური ხელახალი შეფასების საფეხურის გამოყენებით, ჩვენ შეგვიძლია შევინარჩუნოთ საერთო მოძიების წარმადობის დაახლოებით 96%, ხოლო მეხსიერების და დისკის სივრცის გამოყენება 32-ჯერ შევამციროთ და მოძიების სიჩქარეც 32-ჯერ გავზარდოთ. ხელახალი შეფასების გარეშე, ჩვენ შეგვიძლია შევინარჩუნოთ საერთო მოძიების წარმადობის დაახლოებით 92.5%. 1024 განზომილების მქონე ემბედინგის ბინარულად კვანტიზაცია გამოიწვევს 1024 ბიტს. პრაქტიკაში, ბიტების ბაიტებად შენახვა გაცილებით გავრცელებულია, ამიტომ, როდესაც ბინარულ ემბედინგებად ვკვანტიზებთ, ბიტებს ბაიტებში ვაწყობთ `np.packbits`-ის გამოყენებით. შესაბამისად, float32 ემბედინგის, რომლის განზომილებაა 1024, კვანტიზაცია იძლევა int8 ან uint8 ემბედინგს 128 განზომილებით.
ქვემოთ შეგიძლიათ იხილოთ ორი მიდგომა, თუ როგორ შეგიძლიათ შექმნათ კვანტიზებული ემბედინგები Sentence Transformers-ის გამოყენებით: ან წყაროები: აქ შეგიძლიათ ნახოთ განსხვავებები ნაგულისხმევ float32 ემბედინგებსა და ბინარულ ემბედინგებს შორის ფორმის, ზომის და numpy dtype-ის თვალსაზრისით: გაითვალისწინეთ, რომ ასევე შეგიძლიათ აირჩიოთ „ubinary“ ბინარულად კვანტიზაციისთვის უნიშნო uint8 მონაცემთა ფორმატის გამოყენებით. ეს შეიძლება იყოს მოთხოვნა, დამოკიდებული...
თეგები:
#ai
#მანქანური სწავლება
#ემბედინგები
#nlp
#კვანტიზაცია
#წარმადობა
#მასშტაბირება
#ბინარული კვანტიზაცია
#hamming distance
#matryoshka representation learning
წყარო: huggingface.co
AI-ით გადამუშავებული
მსგავსი სტატიები

ხელოვნური ინტელექტი
Anthropic-ის Claude-ის აღზევება Apple App Store-ის რეიტინგებში პენტაგონთან მოლაპარაკებების ფონზე

ხელოვნური ინტელექტი
ტრამპის ადმინისტრაცია Anthropic-ს სანქციებს უწესებს ხელოვნური ინტელექტის გამოყენებაზე უარის გამო: ექსპერტი ინდუსტრიის უსაფრთხოების ხარვეზებზე საუბრობს
ხელოვნური ინტელექტი