
GNOME 50: ნელი ევოლუცია და მნიშვნელოვანი სიახლეები 'კაპოტის ქვეშ'
GNOME-ის ევოლუცია ნელი, თუმცა თანმიმდევრული პროცესია. GNOME 50-ის უახლესი ვერსია დრამატული ინტერფეისის ცვლილებების ნაცვლად, მნიშვნელოვან შიდა გაუმჯობესებებს გვთავაზობს. ძირითადი სიახლეები მოიცავს X11-ის ოფიციალურ ჩანაცვლებას Wayland-ით, ფრაქციულ სკალირებას, GPU-ს გაუმჯობესებულ დეტექციას, Orca ეკრანის წამკითხველის განახლებებს და systemd-homed-ის დანერგვას. გამოცემის ფილოსოფია არსებულის დახვეწასა და ძირითადი ფუნქციების გაუმჯობესებაზეა ორიენტირებული, რათა უზრუნველყოფილი იყოს უკეთესი წარმადობა, უსაფ

ZDNET-ის მიმოხილვა: Lenovo IdeaCentre Mini x – მინი კომპიუტერი, რომელიც მოლოდინს აჭარბებს ბიუჯეტურ სეგმენტში
ZDNET-ის რეკომენდაციები ეფუძნება საფუძვლიან ტესტირებასა და კვლევას, რათა მკითხველს მიაწოდოს ზუსტი და დამოუკიდებელი ინფორმაცია ტექნიკურ მოწყობილობებზე. ამჯერად, განხილულია Lenovo IdeaCentre Mini x – კომპაქტური კომპიუტერი, რომელიც, მიუხედავად ხელმისაწვდომი ფასისა ($900), უზრუნველყოფს მაღალ წარმადობას 32GB ოპერატიული მეხსიერებით და Qualcomm Snapdragon X Plus პროცესორით. ის წარმოადგენს Windows on ARM-ის პრაქტიკულ ალტერნატივას საოფისე სამუშაოებისთვის, თუმცა გრაფიკულად ინტენსიური ამოცანებისთვის ნაკლებ

ZDNET-ის რეკომენდაციები: რა დგას მათ უკან და ღირს თუ არა Google Pixel 10a-ს შეძენა Pixel 10-ის ნაცვლად?
სტატია დეტალურად აღწერს ZDNET-ის მკაცრ სარედაქციო პროცესს, ხაზს უსვამს დამოუკიდებლობას და მონაცემებზე დაფუძნებულ რეკომენდაციებს. შემდეგ ის ადარებს Google-ის ახალ, ხელმისაწვდომ Pixel 10a-ს ფლაგმანურ Pixel 10-ს, გამოყოფს განსხვავებებს ბატარეის ხანგრძლივობაში, კამერაში, დიზაინსა და წარმადობაში, რათა მომხმარებლებს დაეხმაროს ინფორმირებული გადაწყვეტილების მიღებაში.

Acer Swift Edge 14-ის მიმოხილვა: შესანიშნავი საშუალო დონის ლეპტოპი გამორჩეული დიზაინით
ZDNET-ის მიმოხილვაში წარმოდგენილია Acer Swift Edge 14-ის დეტალური შეფასება, რომელიც მოცემულია როგორც კომპანიის უახლესი საშუალო დონის, მაგრამ ძალიან კარგი მოწყობილობა. ხაზგასმულია მისი გამორჩეული დიზაინი, ღირსეული წარმადობა და ხანგრძლივი ბატარეის ხანგრძლივობა. განსაკუთრებული ყურადღება ექცევა მის ულტრა თხელ და მსუბუქ კორპუსს, მაგნიუმ-ალუმინის შენადნობისგან დამზადებულ ელეგანტურ დიზაინს და უნიკალურ „რბილი შეხების“ კლავიატურას. მიუხედავად იმისა, რომ OLED ეკრანი შენობაში იდეალურია, გარეთ მისი სიკაშკაშ

ZDNET-ის მიმოხილვა: Mova P50 Pro Ultra – რობოტი მტვერსასრუტი, რომელიც აერთიანებს მაღალ წარმადობასა და ხელმისაწვდომ ფასს
ZDNET-ის რეკომენდაციები ეფუძნება მრავალსაათიან ტესტირებასა და კვლევას, რათა მკითხველს მიაწოდოს ზუსტი და მიუკერძოებელი ინფორმაცია. ამ მიმოხილვაში წარმოდგენილია Mova P50 Pro Ultra რობოტი მტვერსასრუტი და იატაკის საწმენდი, რომელიც, მიუხედავად 799 დოლარიანი ფასისა, გამოირჩევა გამორჩეული მახასიათებლებით (19,000Pa შეწოვის სიმძლავრე, ნადების ავტომატური მოცილება, ხმოვანი კონტროლი, თვითდამცლელი მტვრის კონტეინერი და არადახვეული ჯაგრისი), რომლებიც ორჯერ ძვირადღირებულ მოდელებში გვხვდება. იგი განსაკუთრებით ეფ

ფალკონ3: ხელოვნური ინტელექტის მოდელების ახალი თაობა გაუმჯობესებული შესაძლებლობებით
„ფალკონ3“ წარმოადგენს ხელოვნური ინტელექტის მოდელების ახალ ოჯახს, რომელიც წინა ვერსიების ბუნებრივ ევოლუციას ასახავს. ახალი იტერაცია ფოკუსირებულია მეცნიერების, მათემატიკისა და კოდის შესაძლებლობების გაფართოებაზე, აჩვენებს მაღალ წარმადობას საერთო საორიენტაციო ტესტებზე და მოიცავს ხუთ ძირითად მოდელს ინოვაციური არქიტექტურით. მოდელები გამოქვეყნებულია Falcon LLM ლიცენზიით, რაც ხელს უწყობს ხელოვნური ინტელექტის ხელმისაწვდომობას და თანამშრომლობას, ხოლო 2025 წლის იანვარში მოსალოდნელია მულტიმოდალური შესაძლებლ
Hugging Face-ის TGI წარმოგიდგენთ ახალ Backends არქიტექტურას: გამარტივებული LLM-ების განთავსება და გაუმჯობესებული წარმადობა
Hugging Face-მა წარმოადგინა TGI Backends, ახალი არქიტექტურა Text-Generation-Inference (TGI)-ისთვის, რომელიც მიზნად ისახავს LLM-ების განთავსების პროცესის გამარტივებას და ოპტიმალური წარმადობის უზრუნველყოფას. ეს სიახლე აერთიანებს სხვადასხვა ინფერენსინგის გადაწყვეტებს ერთიან ფრონტენდ ფენაში, რაც მომხმარებლებს საშუალებას აძლევს მარტივად შეცვალონ ბეკენდები მათი მოდელირების, აპარატურის და წარმადობის მოთხოვნების შესაბამისად.
100-ჯერ გაზრდილი წარმადობა: დიდი AI მოდელების ოპტიმიზაცია Hugging Face-ის ინფრასტრუქტურაზე
მიუხედავად იმისა, რომ დიდი ენობრივი მოდელების ექსპერიმენტირება მარტივია, მათი მაქსიმალური წარმადობით პროდუქციაში განთავსება რთული საინჟინრო გამოწვევაა. Hugging Face გთავაზობთ გადაწყვეტას თავისი Accelerated Inference API-ის მეშვეობით, რომელიც უზრუნველყოფს 100-ჯერ გაზრდილ სიჩქარეს და მასშტაბირებადობას. სტატია დეტალურად აღწერს ოპტიმიზაციის სხვადასხვა დონეს – ბიბლიოთეკების გამოყენებიდან აპარატურის სპეციფიკურ მოდიფიკაციამდე – და ხაზს უსვამს Hugging Face-ის ექსპერტიზასა და პარტნიორობებს ტექნიკის წამყვ
BERT-ის ახალი სიჩქარე: ხელოვნური ინტელექტის მოდელების განთავსება TensorFlow Serving-ით
ტრანსფორმერების v4.2.0 ვერსიაში BERT-ის მოდელის გამოთვლითი წარმადობა მნიშვნელოვნად გაუმჯობესდა, რაც 10%-ით უფრო სწრაფია Google-ის ოფიციალურ იმპლემენტაციაზე და ორჯერ აღემატება v4.1.1-ის ვერსიას. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ამ გაუმჯობესებული წარმადობის გამოყენება საწარმოო გარემოში TensorFlow Serving-ის მეშვეობით BERT მოდელების განთავსებით. ის მოიცავს ნაბიჯ-ნაბიჯ ინსტრუქციებს SavedModel-ის შექმნის, Docker-ის გამოყენებით კონტეინერების გაშვების და REST/gRPC API-ების მეშვეობით მოდელთან
ხელოვნური ინტელექტის ღია მიდგომების წარმატება: რატომ არის ის სასიცოცხლოდ მნიშვნელოვანი?
ხელოვნური ინტელექტის (AI) განვითარებაში ღია მიდგომები არამხოლოდ უფრო გამჭვირვალე, ადაპტირებადი და მეცნიერულად დასაბუთებულია, არამედ მუდმივად აჭარბებს კომერციული შეთავაზებების წარმადობას. უახლესი მაგალითები, როგორიცაა OlympicCoder-ისა და OLMo 2-ის წარმატებები, ადასტურებს, რომ მძლავრი AI სტრატეგია ღია და კოლაბორაციულ განვითარებას უნდა ეფუძნებოდეს, რათა ხელი შეუწყოს ტექნოლოგიის წარმადობას, დანერგვასა და უსაფრთხოებას. სტატია გვთავაზობს სამ ძირითად რეკომენდაციას AI-ის ტექნიკური და ეკონომიკური წარმატე

ღრმა სწავლის დაჩქარება Intel Xeon CPU-ებზე: ტრანსფერული სწავლის ახალი შესაძლებლობები
გრაფიკული პროცესორების (GPU) ნაცვლად, ტრანსფერული სწავლის განვითარება ღრმა სწავლის მოდელების ოპტიმიზაციისთვის CPU-ზე დაფუძნებულ კლასტერებს საინტერესო ალტერნატივად აქცევს. ეს სტატია განმარტავს, თუ როგორ შეიძლება PyTorch-ის სასწავლო ამოცანების დაჩქარება Intel Xeon Scalable CPU სერვერების გამოყენებით, Ice Lake არქიტექტურაზე დაფუძნებული ვირტუალური მანქანების კლასტერის შექმნით და წარმადობაზე ოპტიმიზებული პროგრამული ბიბლიოთეკების ინსტალაციით, როგორიცაა Intel extension for PyTorch და oneCCL.

Embedding მოდელების ოპტიმალური განთავსება Hugging Face Inference Endpoints-ზე: მაღალი წარმადობა და ხარჯთეფექტურობა
ამ სტატიაში განხილულია, თუ როგორ განვათავსოთ ღია კოდის Embedding მოდელები Hugging Face Inference Endpoints-ზე Text Embedding Inference (TEI) გადაწყვეტის გამოყენებით. ხაზგასმულია Embedding მოდელების უპირატესობა დიდი ენობრივი მოდელების (LLM-ების) მიმართ ზომისა და ინფერენსის სიჩქარის კუთხით. სტატია დეტალურად აღწერს Inference Endpoints-ის მახასიათებლებს, როგორიცაა ავტომატური მასშტაბირება და ნულამდე მასშტაბირება, და წარმოადგენს TEI-ს, როგორც მაღალი წარმადობისა და ხარჯთეფექტურობის გარანტს. ნაჩვენებია,
ღია კოდის ემბედინგის მოდელების განთავსება Hugging Face Inference Endpoints-ზე: მაღალი წარმადობა და დაბალი ხარჯები
Hugging Face Inference Endpoints-ზე ღია კოდის ემბედინგის მოდელების განთავსების შესახებ სტატია აღწერს, თუ როგორ უზრუნველყოფს Text Embedding Inference (TEI) ამ მოდელების სწრაფ და ხარჯთეფექტურ გამოყენებას. ემბედინგის მოდელები, LLM-ებთან შედარებით, მცირე ზომისაა და სწრაფ ინფერენსს გვთავაზობს, რაც გადამწყვეტია ოპტიმალური მომხმარებლის გამოცდილებისა და ხარჯების შესამცირებლად. TEI-ის საშუალებით შესაძლებელია 450+ მოთხოვნა/წამში წარმადობის მიღწევა და 64-ჯერ უფრო დაბალი ხარჯები, ვიდრე OpenAI Embeddings-ის
Mixtral-ის გამოშვება: ახალი ნახტომი ხელოვნურ ინტელექტში ექსპერტთა ნაზავი (Mixture of Experts) არქიტექტურით
სტატია წარმოგიდგენთ Mixtral-ს, ახალ დიდ ენობრივ მოდელს (LLM), რომელიც იყენებს ექსპერტთა ნაზავის (MoE) არქიტექტურას, აერთიანებს 8 „ექსპერტ“ მოდელს ერთში. ხაზგასმულია Mixtral-ის შთამბეჭდავი წარმადობა, რომელიც აჭარბებს სხვა ღია წვდომის მოდელებს და უტოლდება GPT-3.5-ს MT-Bench ბენჩმარკზე. განმარტებულია მისი რეალური პარამეტრების რაოდენობა (დაახლოებით 45B, არა 56B) და დეტალურად აღწერილია მისი გამოყენება ინფერენციისა და ფაინ-თუნინგისთვის, ასევე Hugging Face-ზე განთავსების შესაძლებლობები.

Gradio: მეტი ვიდრე უბრალოდ UI ბიბლიოთეკა – ხელოვნური ინტელექტის აპლიკაციების მძლავრი ჩარჩო
Gradio, რომელიც ხშირად მხოლოდ UI ბიბლიოთეკად აღიქმება, სინამდვილეში არის ყოვლისმომცველი ჩარჩო მანქანური სწავლების მოდელებთან ინტერფეისებისა და API-ების მეშვეობით ურთიერთობისთვის, რაც უზრუნველყოფს მაღალ წარმადობას, უსაფრთხოებასა და რეაგირებას. ეს სტატია წარმოგიდგენთ მის უნიკალურ მახასიათებლებს, რომლებიც გადამწყვეტია თანამედროვე AI აპლიკაციების შესაქმნელად.
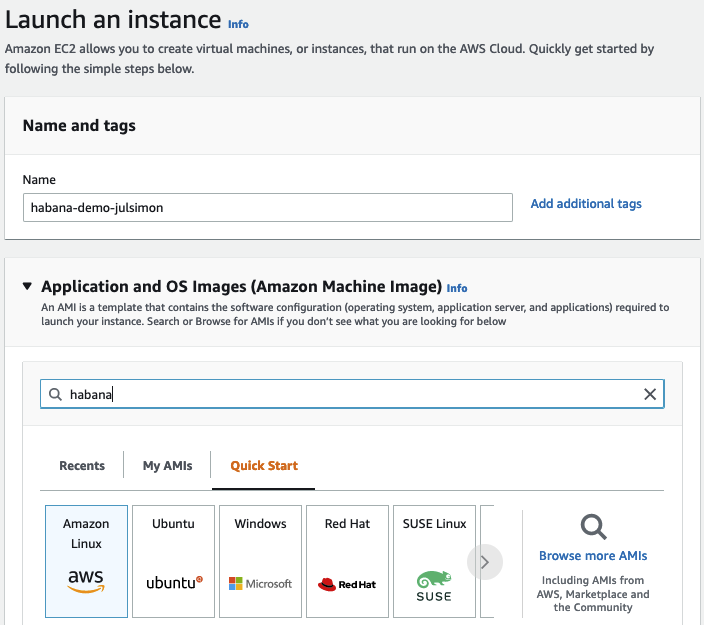
Habana Gaudi-ის ამაჩქარებლები და Transformer-ები: მაღალი წარმადობა და ხარჯთეფექტურობა AWS-ზე
Habana Gaudi-ის ახალი ამაჩქარებლები Amazon EC2 ინსტანციებზე უზრუნველყოფენ 40%-მდე უკეთეს ფასი-წარმადობას მანქანური სწავლის მოდელების, განსაკუთრებით Transformer-ების, წვრთნისთვის, უახლეს GPU-ებთან შედარებით. ეს პოსტი აღწერს, თუ როგორ სწრაფად დავაყენოთ Habana Gaudi ინსტანცია AWS-ზე და დავხვეწოთ BERT მოდელი ტექსტის კლასიფიკაციისთვის, რაც დემონსტრირებას უკეთებს ამ ტექნოლოგიის სიმარტივესა და ხარჯთეფექტურობას.

დიდი ML მოდელების სწავლება: FullyShardedDataParallel (FSDP) შესაძლებლობები
მანქანური სწავლების (ML) მოდელების მუდმივად მზარდი მასშტაბები აპარატურულ შეზღუდვებს წარმოქმნის. ეს სტატია იკვლევს, თუ როგორ უმკლავდება განაწილებული სწავლება, კერძოდ PyTorch-ის FullyShardedDataParallel (FSDP) ფუნქცია, ამ გამოწვევას. ჩვენ ვადარებთ FSDP-ის წარმადობას DDP-სთან GPT-2 მოდელების გამოყენებით, ვაჩვენებთ FSDP-ის უნარს, მოახდინოს უფრო დიდი პაკეტის ზომების დამუშავება და კიდევ უფრო დიდი მოდელების სწავლება, რითაც ხელმისაწვდომს ხდის მძლავრ ML ტექნოლოგიებს.
დიდი ML მოდელების ეფექტური ვარჯიში: PyTorch FSDP-ის გამოყენება განაწილებულ სისტემებში
მანქანური სწავლების (ML) მოდელების მზარდი ზომისა და პარამეტრების გამო, სპეციალისტებს უჭირთ მათი ვარჯიში სტანდარტულ აპარატურაზე, მიუხედავად იმისა, რომ დიდი მოდელები უფრო სწრაფად სწავლობენ და მაღალ წარმადობას ავლენენ. ამ გამოწვევის საპასუხოდ, განაწილებული სწავლება ხდება გადამწყვეტი. ეს სტატია იკვლევს მონაცემთა პარალელიზმს ZeRO კონცეფციის გამოყენებით და კონკრეტულად PyTorch-ის უახლეს ფუნქციას, FullyShardedDataParallel (FSDP)-ს. DeepSpeed-ისა და FairScale-ის მიერ დანერგილი ZeRO-ის იდეები, PyTorch-ში

Falcon-H1: ხელოვნური ინტელექტის მოდელების ინოვაციური სერია ჰიბრიდული არქიტექტურით
წარმოგიდგენთ Falcon-H1 სერიას, ექვს ღია კოდის მოდელს 0.5B-დან 34B პარამეტრამდე, რომლებიც ხელმისაწვდომია როგორც საბაზო, ასევე ინსტრუქციებზე მორგებულ ვარიანტებში. ამ მოდელების გულში დგას ჰიბრიდული არქიტექტურა, რომელიც აერთიანებს კლასიკური ტრანსფორმერზე დაფუძნებული ყურადღების მექანიზმისა და მდგომარეობის სივრცის მოდელის (SSM) ძლიერ მხარეებს. ეს ინოვაციური მიდგომა უზრუნველყოფს უპრეცედენტო წარმადობას, მაღალ ეფექტურობას და ფართო მასშტაბურობას, რაც Falcon-H1-ს კონკურენტუნარიანს ხდის წამყვან ტრანსფორმერზ

SGLang და Hugging Face-ის ტრანსფორმერები: წარმოების დონის ხელოვნური ინტელექტის დასკვნა მაქსიმალური სიჩქარით
SGLang, რომელიც შექმნილია ხელოვნური ინტელექტის მაღალი გამტარუნარიანობისა და დაბალი შეყოვნების დასკვნისთვის, ახლა სრულყოფილად ინტეგრირდება Hugging Face-ის ტრანსფორმერებთან. ეს ინტეგრაცია მომხმარებლებს საშუალებას აძლევს, გააერთიანონ ტრანსფორმერების მოქნილობა SGLang-ის მაღალ წარმადობასთან, რაც უზრუნველყოფს AI მოდელების უფრო სწრაფ და რესურსეფექტურ განლაგებას წარმოების გარემოში, თუნდაც იმ მოდელებისთვის, რომლებიც მშობლიურად არ არის მხარდაჭერილი.

SmolLM3: მაღალი წარმადობა 3 მილიარდ პარამეტრზე და ინოვაციური საინჟინრო გეგმა
ახალი 3 მილიარდპარამეტრიანი ენობრივი მოდელი, SmolLM3, აჭარბებს კონკურენტებს, როგორიცაა Llama-3.2-3B და Qwen2.5-3B, ამასთანავე, კონკურენტუნარიანია უფრო დიდ 4 მილიარდპარამეტრიან მოდელებთან (Qwen3 და Gemma3). მისი შემქმნელები სრულად აქვეყნებენ მოდელის შექმნის მეთოდოლოგიას, არქიტექტურულ დეტალებს, მონაცემთა ნარევებსა და სამსაფეხურიან წინასწარი ვარჯიშის სტრატეგიას. ეს გამჭვირვალე მიდგომა, რომელიც მოიცავს ისეთ ინოვაციებს, როგორიცაა Grouped Query Attention (GQA) და NoPE, მიზნად ისახავს AI საზოგადოებისთვ
Google-მა CodeGemma - კოდზე ორიენტირებული დიდი ენობრივი მოდელები - გამოუშვა
Google-მა გამოუშვა CodeGemma, კოდზე სპეციალიზებული დიდი ენობრივი მოდელების (LLM) ოჯახი, რომელიც ეფუძნება 2B და 7B Gemma მოდელებს. ის ხელმისაწვდომია Hugging Face Hub-ზე სამ ვერსიად – CodeGemma 2B, CodeGemma 7B და CodeGemma 7B Instruct – და გამიზნულია კოდის შევსების, გენერაციისა და გაგების ამოცანებისთვის, ასევე მათემატიკური და ლოგიკური მსჯელობის გასაუმჯობესებლად. მოდელები გაწვრთნილია დამატებით 500 მილიარდ ტოკენზე და აჩვენებენ მაღალ წარმადობას კოდის შეფასების პოპულარულ ბენჩმარკებზე, როგორიცაა Human

OpenAI-ის GPT OSS მოდელები Hugging Face-ზე: გაუმჯობესებული ხელმისაწვდომობა და ოპტიმიზებული წარმადობა
OpenAI-მ Apache 2.0 ლიცენზიით გამოუშვა ღია კოდის GPT OSS მოდელები, რომელთა მიზანია ხელოვნური ინტელექტის ფართო ხელმისაწვდომობის უზრუნველყოფა უსაფრთხო და პასუხისმგებლიანი გამოყენებით. Hugging Face-თან ინტეგრაციით, მომხმარებლებს შეუძლიათ ისარგებლონ გაუმჯობესებული არქიტექტურით, მათ შორის mxfp4 კვანტიზაციით, Flash Attention 3-ითა და MegaBlocks MoE ქერნელებით, რაც უზრუნველყოფს მნიშვნელოვან მეხსიერების დაზოგვას და მაღალ წარმადობას როგორც NVIDIA, ისე AMD GPU-ებზე. ეს ინიციატივა ხელს უწყობს AI-ის ინოვაცი

BLOOM ინფერენსის ოპტიმიზაცია GPU-ებზე: წარმადობის ბენჩმარკინგი
ეს სტატია განიხილავს BLOOM ხელოვნური ინტელექტის მოდელის ინფერენსის ოპტიმიზაციას სხვადასხვა GPU კონფიგურაციებზე. მოცემულია აპარატურული მოთხოვნები 352GB bf16 წონებისთვის, სადაც რეკომენდებულია 8x80GB A100 GPU-ები, თუმცა განიხილება ალტერნატივებიც. სტატია აანალიზებს მოდელის ჩატვირთვის დროს და ტოკენების გენერირების წარმადობას (throughput) ისეთი გადაწყვეტების გამოყენებით, როგორიცაა Deepspeed-Inference და Accelerate, ასევე 8-ბიტიანი კვანტიზაცია მეხსიერების შესამცირებლად. ბენჩმარკინგის შედეგები აჩვენებს