
Sentence Transformers v2: რევოლუციური განახლებები და ინტეგრაცია Hugging Face Hub-თან
Sentence Transformers-ის v2 ვერსიის გამოშვება ახალ შესაძლებლობებს გვთავაზობს წინადადების, აბზაცისა და გამოსახულების ემბედინგებისთვის. განახლება მოიცავს Hugging Face Hub-თან ღრმა ინტეგრაციას, 90-ზე მეტი წინასწარ გაწვრთნილი მოდელით 100-ზე მეტი ენისთვის. წარმოდგენილია ახალი ვიჯეტები – ფუნქციის ექსტრაქციისა და წინადადების მსგავსების გამოსათვლელად, ასევე API ინტერფეისები მოდელებთან პროგრამული წვდომისთვის, რაც საზოგადოებას საშუალებას აძლევს მარტივად გააზიაროს და გამოიყენოს თავისი გაწვრთნილი მოდელები.
Renumics Spotlight: ინტერაქტიული ვიზუალიზაცია და მონაცემთა ინსპექცია Hugging Face-ის მონაცემთა ნაკრებებისთვის
Renumics Spotlight გთავაზობთ ინტერაქტიულ ვიზუალიზაციებს Hugging Face-ის მონაცემთა ნაკრებებში კრიტიკული კლასტერების იდენტიფიცირებისთვის. ის იყენებს მოდელის შედეგებს (პროგნოზები, ემბედინგები) მონაცემთა სეგმენტებისა და მოდელის შეცდომების ღრმა გაგებისთვის, რაც აადვილებს მონაცემთა ინსპექციას და ხდის მას მასშტაბირებადს. ხელსაწყო პირდაპირ ინტეგრირდება `datasets` ბიბლიოთეკასთან და მხარს უჭერს სხვადასხვა ტიპის მონაცემებსა და ML ამოცანებს, მათ შორის NLP, აუდიო და კომპიუტერული ხედვა.
Renumics Spotlight: გაამარტივეთ მონაცემთა ინსპექტირება Hugging Face ეკოსისტემაში
Renumics Spotlight გთავაზობთ ინტერაქტიულ ვიზუალიზაციებს, რომლებიც ეხმარება მომხმარებლებს კრიტიკული კლასტერების იდენტიფიცირებაში Hugging Face მონაცემთა ნაკრებებში. ინსტრუმენტი უპრობლემოდ ინტეგრირდება Hugging Face-ის ეკოსისტემასთან, საშუალებას გაძლევთ გამოიყენოთ მოდელის შედეგები, როგორიცაა პროგნოზები და ემბედინგები, რათა ღრმად შეისწავლოთ მონაცემთა სეგმენტები და მოდელის ხარვეზები. Spotlight მნიშვნელოვნად ზრდის მონაცემთა ინსპექტირების მასშტაბურობას, ამარტივებს სამუშაო პროცესებს და ამცირებს დროის ხარ
ემბედინგები: ხელოვნური ინტელექტის მრავალფუნქციური ინსტრუმენტი სემანტიკური ძიებისთვის
ეს სტატია განმარტავს „ემბედინგების“ კონცეფციას – ინფორმაციის (ტექსტი, სურათი, აუდიო) რიცხვით წარმოდგენას, რომელიც მის სემანტიკურ მნიშვნელობას იჭერს. განხილულია ემბედინგების ძირითადი გამოყენება ხელოვნური ინტელექტის აპლიკაციებში, როგორიცაა საძიებო სისტემები, რეკომენდაციის სისტემები და ჩატბოტები, რაც შესაძლებელს ხდის სემანტიკური მსგავსების შეფასებას. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ემბედინგების გენერირება ღია კოდის ინსტრუმენტების, მაგალითად, Sentence Transformers ბიბლიოთეკისა და Hugging
სემანტიკური ძიება მუსიკაში: დასაკრავი სიების გენერირება Sentence Transformers-ითა და Gradio-თი
ეს სტატია განიხილავს, თუ როგორ შეიძლება Sentence Transformers-ის სემანტიკური ძიების გამოყენება მუსიკალური დასაკრავი სიების შესაქმნელად ტექსტური მოთხოვნების საფუძველზე. დეტალურად არის აღწერილი სიმღერის ტექსტების ემბედინგების გენერირებისა და შენახვის პროცესი, შესაბამისი მოდელების შერჩევა და Gradio აპლიკაციის იმპლემენტაცია, რომელიც მომხმარებლებს საშუალებას აძლევს ეძებონ სიმღერები სემანტიკური მსგავსების მიხედვით და იხილონ მათი ტექსტები.
როგორ შევქმნათ მუსიკალური ფლეილისტი ტექსტური მოთხოვნით: Sentence Transformers და Gradio
ეს სტატია განმარტავს, თუ როგორ შეიძლება Sentence Transformers ბიბლიოთეკის სემანტიკური ძიების ფუნქციონალის გამოყენება სიმღერების ფლეილისტების შესაქმნელად ტექსტური მოთხოვნის საფუძველზე. აღწერილია წინადადების ემბედინგების გენერირება, მოდელის შერჩევა (მაგ. MS MARCO), გრძელი ტექსტების ლექსებად დაყოფა და ემბედინგების გამოყენება ძიებისთვის. პროექტი განხორციელებულია Gradio აპლიკაციის სახით, რომელიც ჰოსტირებულია Hugging Face Spaces-ზე, რაც მომხმარებლებს საშუალებას აძლევს ინტერაქტიულად მოძებნონ სიმღერები
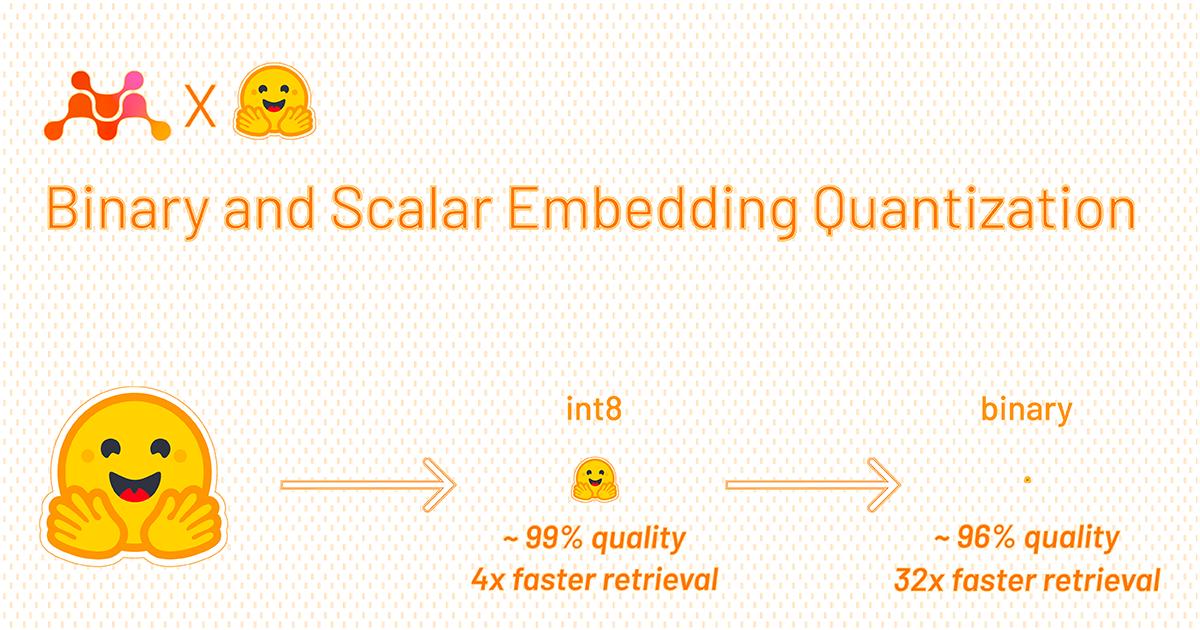
კვანტიზაცია: ეფექტური გადაწყვეტა ემბედინგების მასშტაბირების პრობლემისთვის
ემბედინგები ბუნებრივი ენის დამუშავების (NLP) გადამწყვეტი ინსტრუმენტია, თუმცა მათი მასშტაბირება წარმოების მიზნებისთვის ხშირად იწვევს მაღალ ხარჯებსა და ლატენტურობას. სტატია განიხილავს ამ გამოწვევებს, არსებულ მიდგომებს (როგორიცაა განზომილების შემცირება და Matryoshka Representation Learning) და წარმოგიდგენთ კვანტიზაციას, კერძოდ ბინარულ კვანტიზაციას, როგორც ინოვაციურ გადაწყვეტას. ბინარული კვანტიზაცია float32 მნიშვნელობებს 1-ბიტიან მნიშვნელობებად აქცევს, რაც მეხსიერებასა და შენახვის ადგილს 32-ჯერ ამცი
Sentence Transformers: სრული გზამკვლევი მოდელების ტრენინგისა და ოპტიმიზაციისთვის
ეს სტატია გთავაზობთ დეტალურ სახელმძღვანელოს Sentence Transformers-ის მოდელების ვარჯიშისა და ოპტიმიზაციის შესახებ. განხილულია მოდელის არქიტექტურა, ემბედინგების შექმნა და მონაცემთა მომზადების გადამწყვეტი როლი, მათ შორის სხვადასხვა მონაცემთა ნაკრების ფორმატები, როგორებიცაა მსგავსება, პოზიტიური წყვილები, კლასიფიკაცია და ტრიპლეტები. ასევე აღწერილია მონაცემების მოდელისთვის გასაგებ ფორმატში კონვერტირების პროცესი.

Sentence Transformers Hugging Face-ის ოჯახს უერთდება
Sentence Transformers (SBERT), სემანტიკური მნიშვნელობის მქონე მაღალი ხარისხის ემბედინგების გენერირების პოპულარული ღია კოდის ბიბლიოთეკა, ოფიციალურად შეუერთდა Hugging Face-ის ოჯახს. 2019 წელს ნილს რაიმერსის მიერ დაარსებული პროექტი ფართოდ გამოიყენება ბუნებრივი ენის დამუშავების (NLP) ამოცანებში და უკვე 16,000-ზე მეტ მოდელს მოიცავს, რომლებიც ყოველთვიურად მილიონობით მომხმარებელს ემსახურება. Hugging Face პირობას დებს, რომ გააგრძელებს პროექტის ზრდისა და ინოვაციების მხარდაჭერას, ამავდროულად შეინარჩუნებს
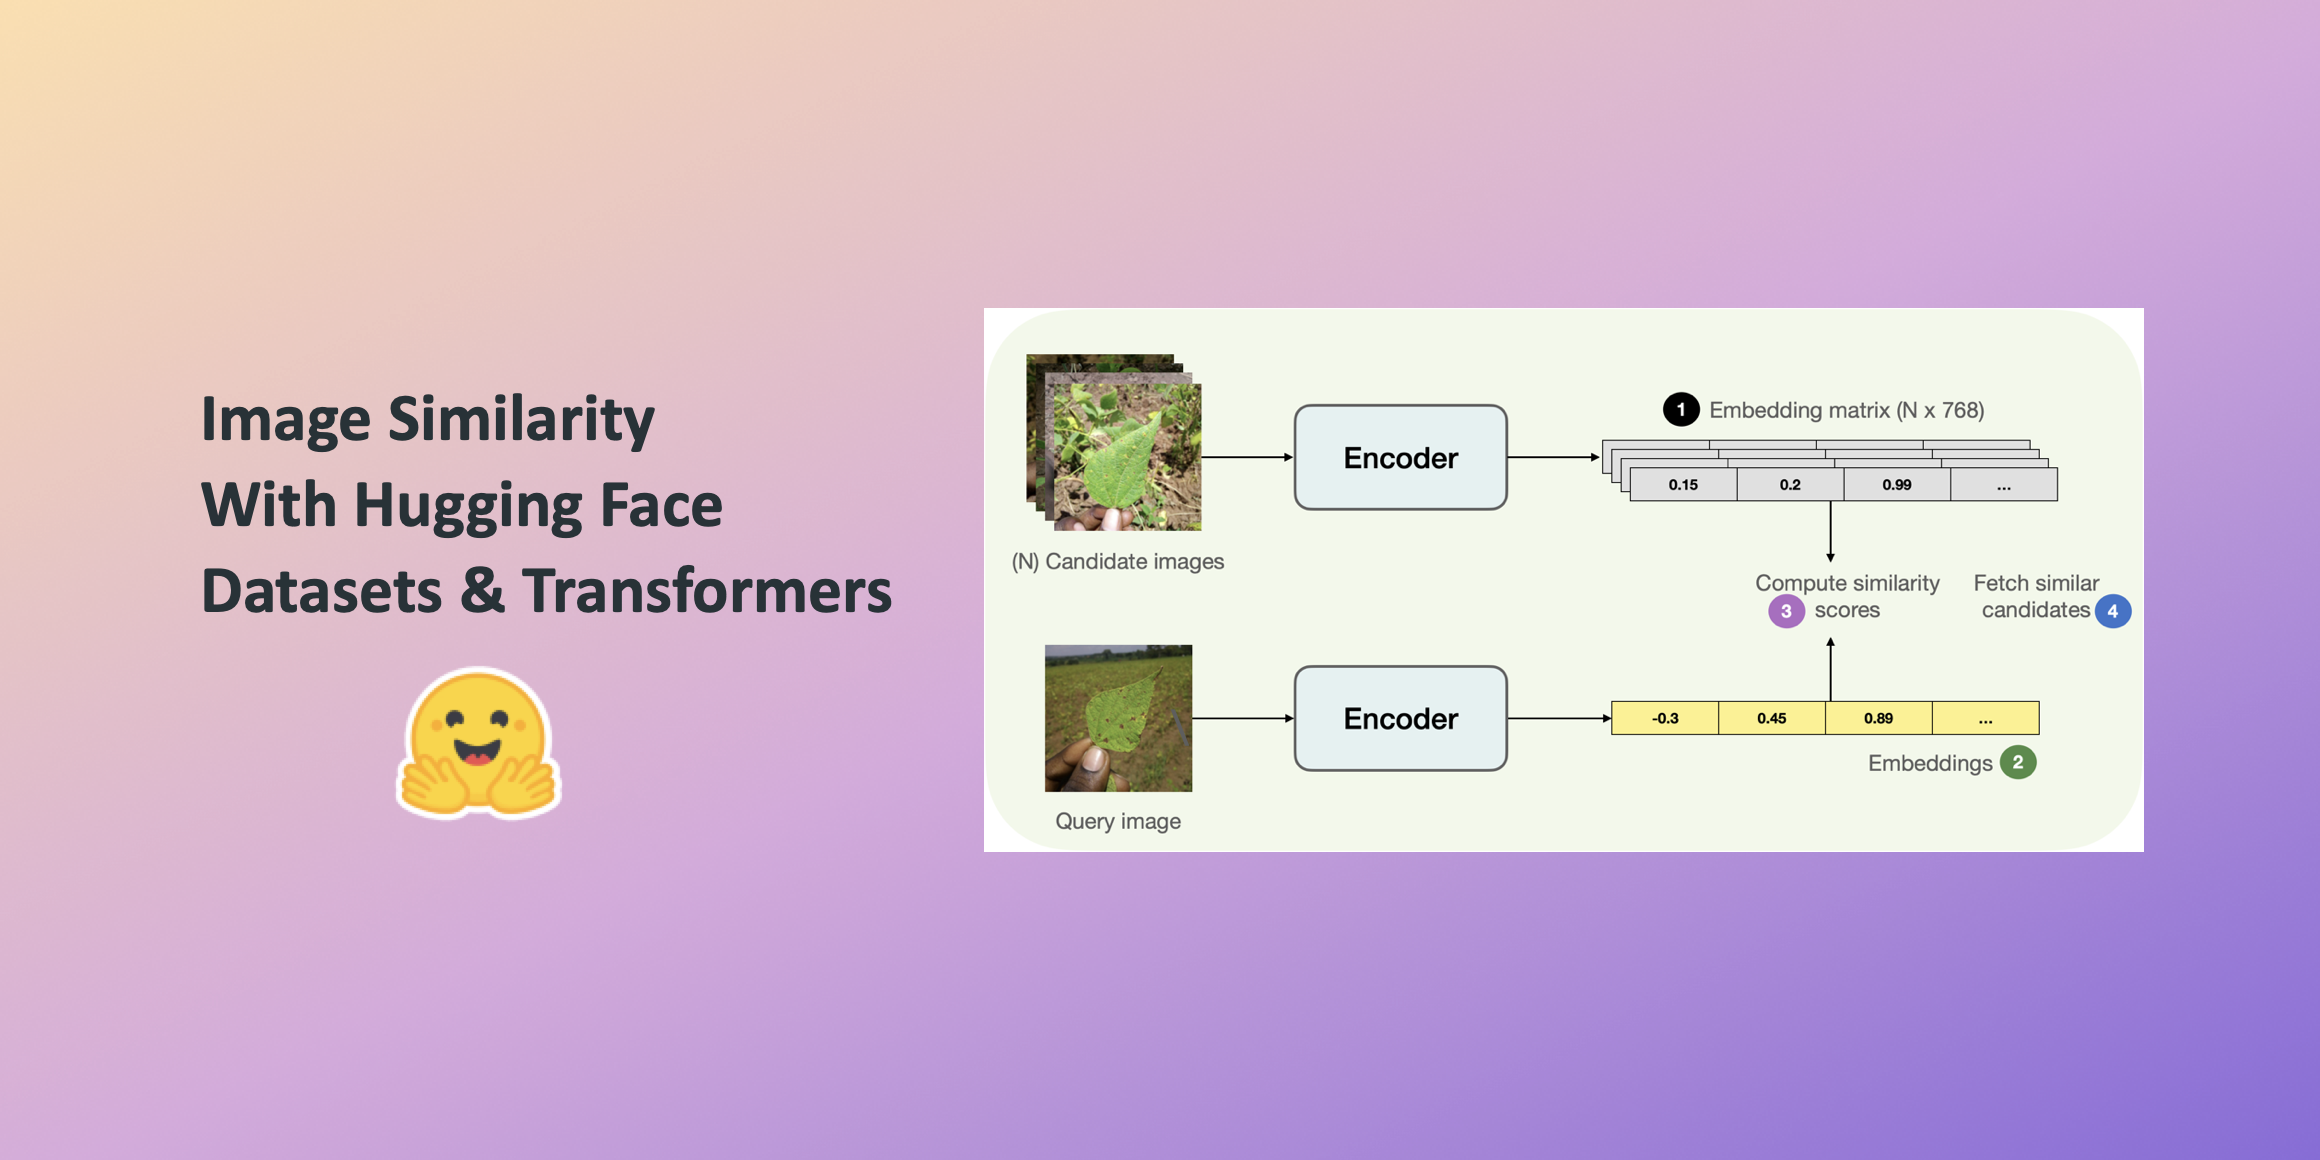
როგორ ავაშენოთ გამოსახულების მსგავსების სისტემა: ღრმა სწავლისა და ეფექტური ძიების გზები
ეს სტატია დეტალურად აღწერს გამოსახულების მსგავსების სისტემის აგების პროცესს, რომელიც ეფუძნება ღრმა სწავლებას და ემბედინგების გამოყენებას. განხილულია გამოსახულებების ვექტორულ სივრცეში წარმოდგენა, კოსინუსური მსგავსების გამოთვლა, Hugging Face-ის `datasets` ბიბლიოთეკისა და `AutoModel` კლასის გამოყენება. ასევე, მოცემულია რჩევები მოდელის შერჩევისა და სისტემის ეფექტურობის გაუმჯობესების შესახებ, მათ შორის განზომილების შემცირებისა და FAISS ინტეგრაციის შესაძლებლობები.