როგორ ავაშენოთ გამოსახულების მსგავსების სისტემა: ღრმა სწავლისა და ეფექტური ძიების გზები
ეს სტატია დეტალურად აღწერს გამოსახულების მსგავსების სისტემის აგების პროცესს, რომელიც ეფუძნება ღრმა სწავლებას და ემბედინგების გამოყენებას. განხილულია გამოსახულებების ვექტორულ სივრცეში წარმოდგენა, კოსინუსური მსგავსების გამოთვლა, Hugging Face-ის `datasets` ბიბლიოთეკისა და `AutoModel` კლასის გამოყენება. ასევე, მოცემულია რჩევები მოდელის შერჩევისა და სისტემის ეფექტურობის გაუმჯობესების შესახებ, მათ შორის განზომილების შემცირებისა და FAISS ინტეგრაციის შესაძლებლობები.
🤗 `datasets` ბიბლიოთეკას გამოვიყენებთ, რადგან ის შეუფერხებლად უჭერს მხარს პარალელურ დამუშავებას, რაც სისტემის აშენებისას ძალიან გამოგვადგება. მიუხედავად იმისა, რომ სტატია იყენებს ViT-ზე დაფუძნებულ მოდელს (nateraw/vit-base-beans) და კონკრეტულ მონაცემთა ნაკრებს (Beans), მისი გაფართოება შესაძლებელია სხვა მოდელებისა და გამოსახულების მონაცემთა ნაკრებების გამოსაყენებლად, რომლებიც მხარს უჭერენ ვიზუალური ინფორმაციის დამუშავებას. სტატიაში წარმოდგენილი მიდგომა პოტენციურად შეიძლება გაფართოვდეს სხვა მოდალობებზეც. გამოსახულების მსგავსების სრულფასოვანი სისტემის შესასწავლად, შეგიძლიათ იხილოთ დასაწყისში მოცემული Colab Notebook-ის ბმული.
ამ სისტემის ასაშენებლად, პირველ რიგში, უნდა განვსაზღვროთ, თუ როგორ გვსურს ორი გამოსახულების მსგავსების გამოთვლა. ერთი ფართოდ გავრცელებული პრაქტიკაა მოცემული გამოსახულებების მკვრივი წარმოდგენების (ჩანერგვების/embeddings) გამოთვლა და შემდეგ კოსინუსური მსგავსების მეტრიკის გამოყენება იმის დასადგენად, თუ რამდენად მსგავსია ეს ორი გამოსახულება. ამ სტატიისთვის „ჩანერგვებს“ (embeddings) გამოვიყენებთ გამოსახულებების ვექტორულ სივრცეში წარმოსადგენად. ეს გვაძლევს საშუალებას, ეფექტურად შევკუმშოთ გამოსახულებების მაღალი განზომილების პიქსელური სივრცე (მაგალითად, 224 x 224 x 3) გაცილებით დაბალგანზომილებიან წარმოდგენამდე (მაგალითად, 768). ამ მეთოდის მთავარი უპირატესობაა გამოთვლის დროის შემცირება შემდგომ ნაბიჯებში.
გამოსახულებებიდან ჩანერგვების გამოსათვლელად, გამოვიყენებთ ხედვის მოდელს, რომელსაც აქვს გაგება, თუ როგორ წარმოადგინოს შეყვანის გამოსახულებები ვექტორულ სივრცეში. ამ ტიპის მოდელს ხშირად გამოსახულების ენკოდერსაც (image encoder) უწოდებენ. მოდელის ჩასატვირთად, ჩვენ ვიყენებთ `AutoModel` კლასს. ის გვაძლევს ინტერფეისს Hugging Face Hub-დან ნებისმიერი თავსებადი მოდელის ჩექპოინტის ჩასატვირთად. მოდელთან ერთად, ჩვენ ასევე ვტვირთავთ მოდელთან დაკავშირებულ პროცესორს მონაცემთა წინასწარი დამუშავებისთვის. ამ შემთხვევაში, ჩექპოინტი მიღებული იქნა Vision Transformer-ზე დაფუძნებული მოდელის Beans მონაცემთა ნაკრებზე დახვეწით (fine-tuning).
აქ შეიძლება გაჩნდეს რამდენიმე კითხვა: Q1: რატომ არ გამოვიყენეთ `AutoModelForImageClassification`? იმიტომ, რომ გვსურს გამოსახულებების მკვრივი წარმოდგენების მიღება და არა დისკრეტული კატეგორიების, რასაც `AutoModelForImageClassification` მოგვაწვდიდა. Q2: რატომ კონკრეტულად ეს ჩექპოინტი? როგორც აღვნიშნეთ, სისტემის ასაშენებლად ვიყენებთ კონკრეტულ მონაცემთა ნაკრებს. ამიტომ, ზოგადი დანიშნულების მოდელის (მაგალითად, ImageNet-1k მონაცემთა ნაკრებზე გაწვრთნილი მოდელების) ნაცვლად, უმჯობესია გამოვიყენოთ მოდელი, რომელიც დახვეწილია გამოყენებულ მონაცემთა ნაკრებზე. ამგვარად, მოდელი უკეთ ესმის შეყვანის გამოსახულებებს. გაითვალისწინეთ, რომ ასევე შეგიძლიათ გამოიყენოთ ჩექპოინტი, რომელიც მიღებული იქნა თვითკონტროლირებადი წინასწარი ვარჯიშის (self-supervised pre-training) მეშვეობით. ჩექპოინტი აუცილებლად ზედამხედველობითი სწავლებიდან არ უნდა მომდინარეობდეს. ფაქტობრივად, თუ კარგად არის წინასწარ გაწვრთნილი, თვითკონტროლირებად მოდელებს შეუძლიათ შთამბეჭდავი ძიების (retrieval) შედეგების მოცემა.
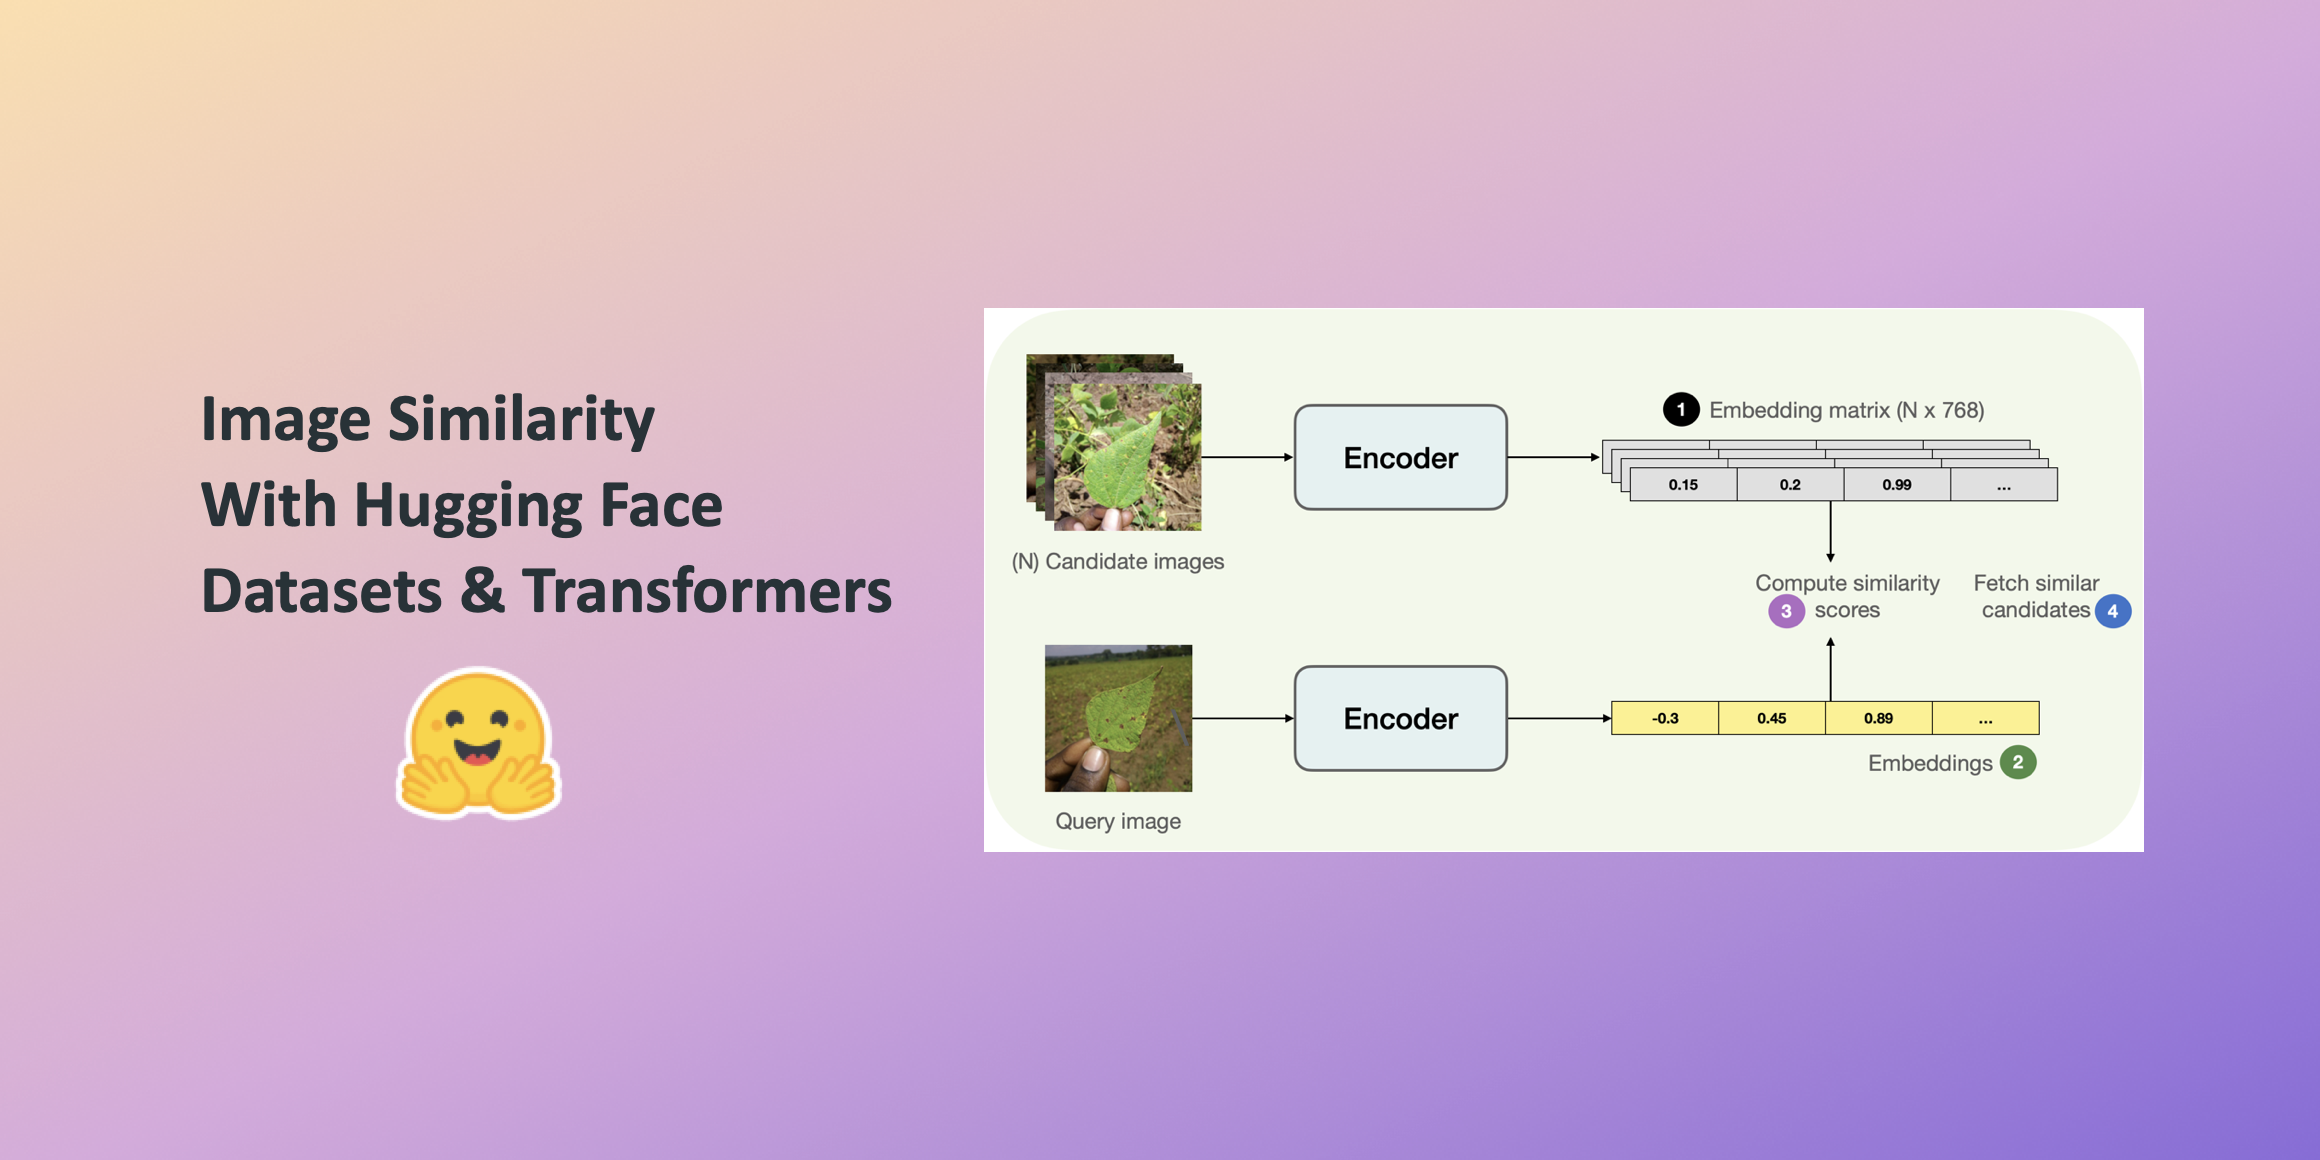
ახლა, როცა გვაქვს მოდელი ჩანერგვების გამოსათვლელად, გვჭირდება კანდიდატი გამოსახულებები საძიებლად. მალე ავაშენებთ ჰეშ-ცხრილებს, რომლებიც კანდიდატ გამოსახულებებს ჰეშებთან დააკავშირებს. ძიების დროს, ამ ჰეშ-ცხრილებს გამოვიყენებთ. ჰეშ-ცხრილებზე მეტს შესაბამის სექციაში ვისაუბრებთ, მაგრამ ამჟამად, კანდიდატი გამოსახულებების მისაღებად, გამოვიყენებთ Beans მონაცემთა ნაკრების სავარჯიშო ნაწილს (train split). ასე გამოიყურება ერთი ნიმუში სავარჯიშო ნაწილიდან: მონაცემთა ნაკრებს აქვს სამი მახასიათებელი: გამოსახულების მსგავსების სისტემის დემონსტრირებისთვის, კანდიდატი გამოსახულებების მონაცემთა ნაკრებიდან 100 ნიმუშს გამოვიყენებთ, რათა საერთო გაშვების დრო მოკლე იყოს. ქვემოთ შეგიძლიათ იხილოთ მსგავსი გამოსახულებების მოძიების პროცესის სურათებით ილუსტრირებული მიმოხილვა. ზემოთ მოცემული სქემის უფრო დეტალური განხილვით, შეგვიძლია დავწეროთ მარტივი უტილიტა და `map()` ფუნქციით დავუკავშიროთ ის კანდიდატი გამოსახულებების ჩვენს მონაცემთა ნაკრებს, რათა ეფექტურად გამოვთვალოთ ჩანერგვები. და შეგვიძლია `extract_embeddings()` ფუნქციის დავაკავშიროთ ასე: შემდეგ, მოხერხებულობისთვის, ვქმნით სიას, რომელიც შეიცავს კანდიდატი გამოსახულებების იდენტიფიკატორებს. ჩვენ გამოვიყენებთ ყველა კანდიდატი გამოსახულების ჩანერგვების მატრიცას, რათა გამოვთვალოთ მსგავსების ქულები საძიებო გამოსახულებასთან. კანდიდატი გამოსახულებების ჩანერგვები უკვე გამოვთვალეთ. შემდეგ უჯრედში, უბრალოდ ვაერთიანებთ მათ მატრიცაში. ჩვენ გამოვიყენებთ კოსინუსურ მსგავსებას ორი ჩანერგვის ვექტორს შორის მსგავსების ქულის გამოსათვლელად. შემდეგ ამას გამოვიყენებთ მსგავსი კანდიდატი ნიმუშების მოსაძიებლად მოცემული საძიებო ნიმუშის საფუძველზე. ყველა უტილიტის გათვალისწინებით, ჩვენ მზად ვართ მსგავსების ძიებისთვის. ავიღოთ საძიებო გამოსახულება Beans მონაცემთა ნაკრების სატესტო ნაწილიდან: შედეგი: როგორც ჩანს, ჩვენმა სისტემამ სწორი მსგავსი გამოსახულებები იპოვა. ვიზუალიზაციისას მივიღებდით: ახლა გვაქვს მუშა გამოსახულების მსგავსების სისტემა. მაგრამ რეალობაში, გაცილებით მეტ კანდიდატ გამოსახულებასთან მოგიწევთ მუშაობა. ამის გათვალისწინებით, ჩვენს ამჟამინდელ პროცედურას აქვს მრავალი ნაკლოვანება: თუ შევძლებთ ჩანერგვების განზომილების შემცირებას მათი მნიშვნელობის დარღვევის გარეშე, შევძლებთ შევინარჩუნოთ კარგი ბალანსი სიჩქარესა და ძიების ხარისხს შორის. ამ პოსტის თანმხლები Colab Notebook ახორციელებს და აჩვენებს უტილიტებს ამის მისაღწევად შემთხვევითი პროექციისა (random projection) და ლოკალურად მგრძნობიარე ჰეშირებით (locality-sensitive hashing). 🤗 Datasets გთავაზობთ FAISS-თან პირდაპირ ინტეგრაციას, რაც კიდევ უფრო ამარტივებს მსგავსების სისტემების აშენების პროცესს.
თეგები:
#ხელოვნური ინტელექტი
#მანქანური სწავლება
#ღრმა სწავლება
#hugging face
#გამოსახულების მსგავსება
#ემბედინგები
#faiss
#vit
#კოსინუსური მსგავსება
#მონაცემთა ნაკრებები
წყარო: huggingface.co
AI-ით გადამუშავებული