OpenAI-ის „Whisper“: რევოლუცია მეტყველების ავტომატურ ამოცნობაში
OpenAI-ის Whisper, 2022 წლის სექტემბერში გამოქვეყნებული ავტომატური მეტყველების ამოცნობის (ამოკრ.) მოდელი, რევოლუციას ახდენს დარგში. წინამორბედებისგან განსხვავებით, ის გაწვრთნილია უპრეცედენტო მოცულობის, 680,000 საათის ეტიკეტირებულ აუდიო-ტრანსკრიფციის მონაცემებზე, მათ შორის 117,000 საათის მულტილინგვურ მონაცემებზე, რაც 96-ზე მეტი ენის მხარდაჭერას უზრუნველყოფს. ზედამხედველობითი წინასწარი გაწვრთნა საშუალებას აძლევს მას პირდაპირ ისწავლოს მეტყველებიდან ტექსტზე გადასვლა, რაც მინიმალურ დახვეწას მოითხოვს
როგორ ავაშენოთ გამოსახულების მსგავსების სისტემა: ღრმა სწავლისა და ეფექტური ძიების გზები
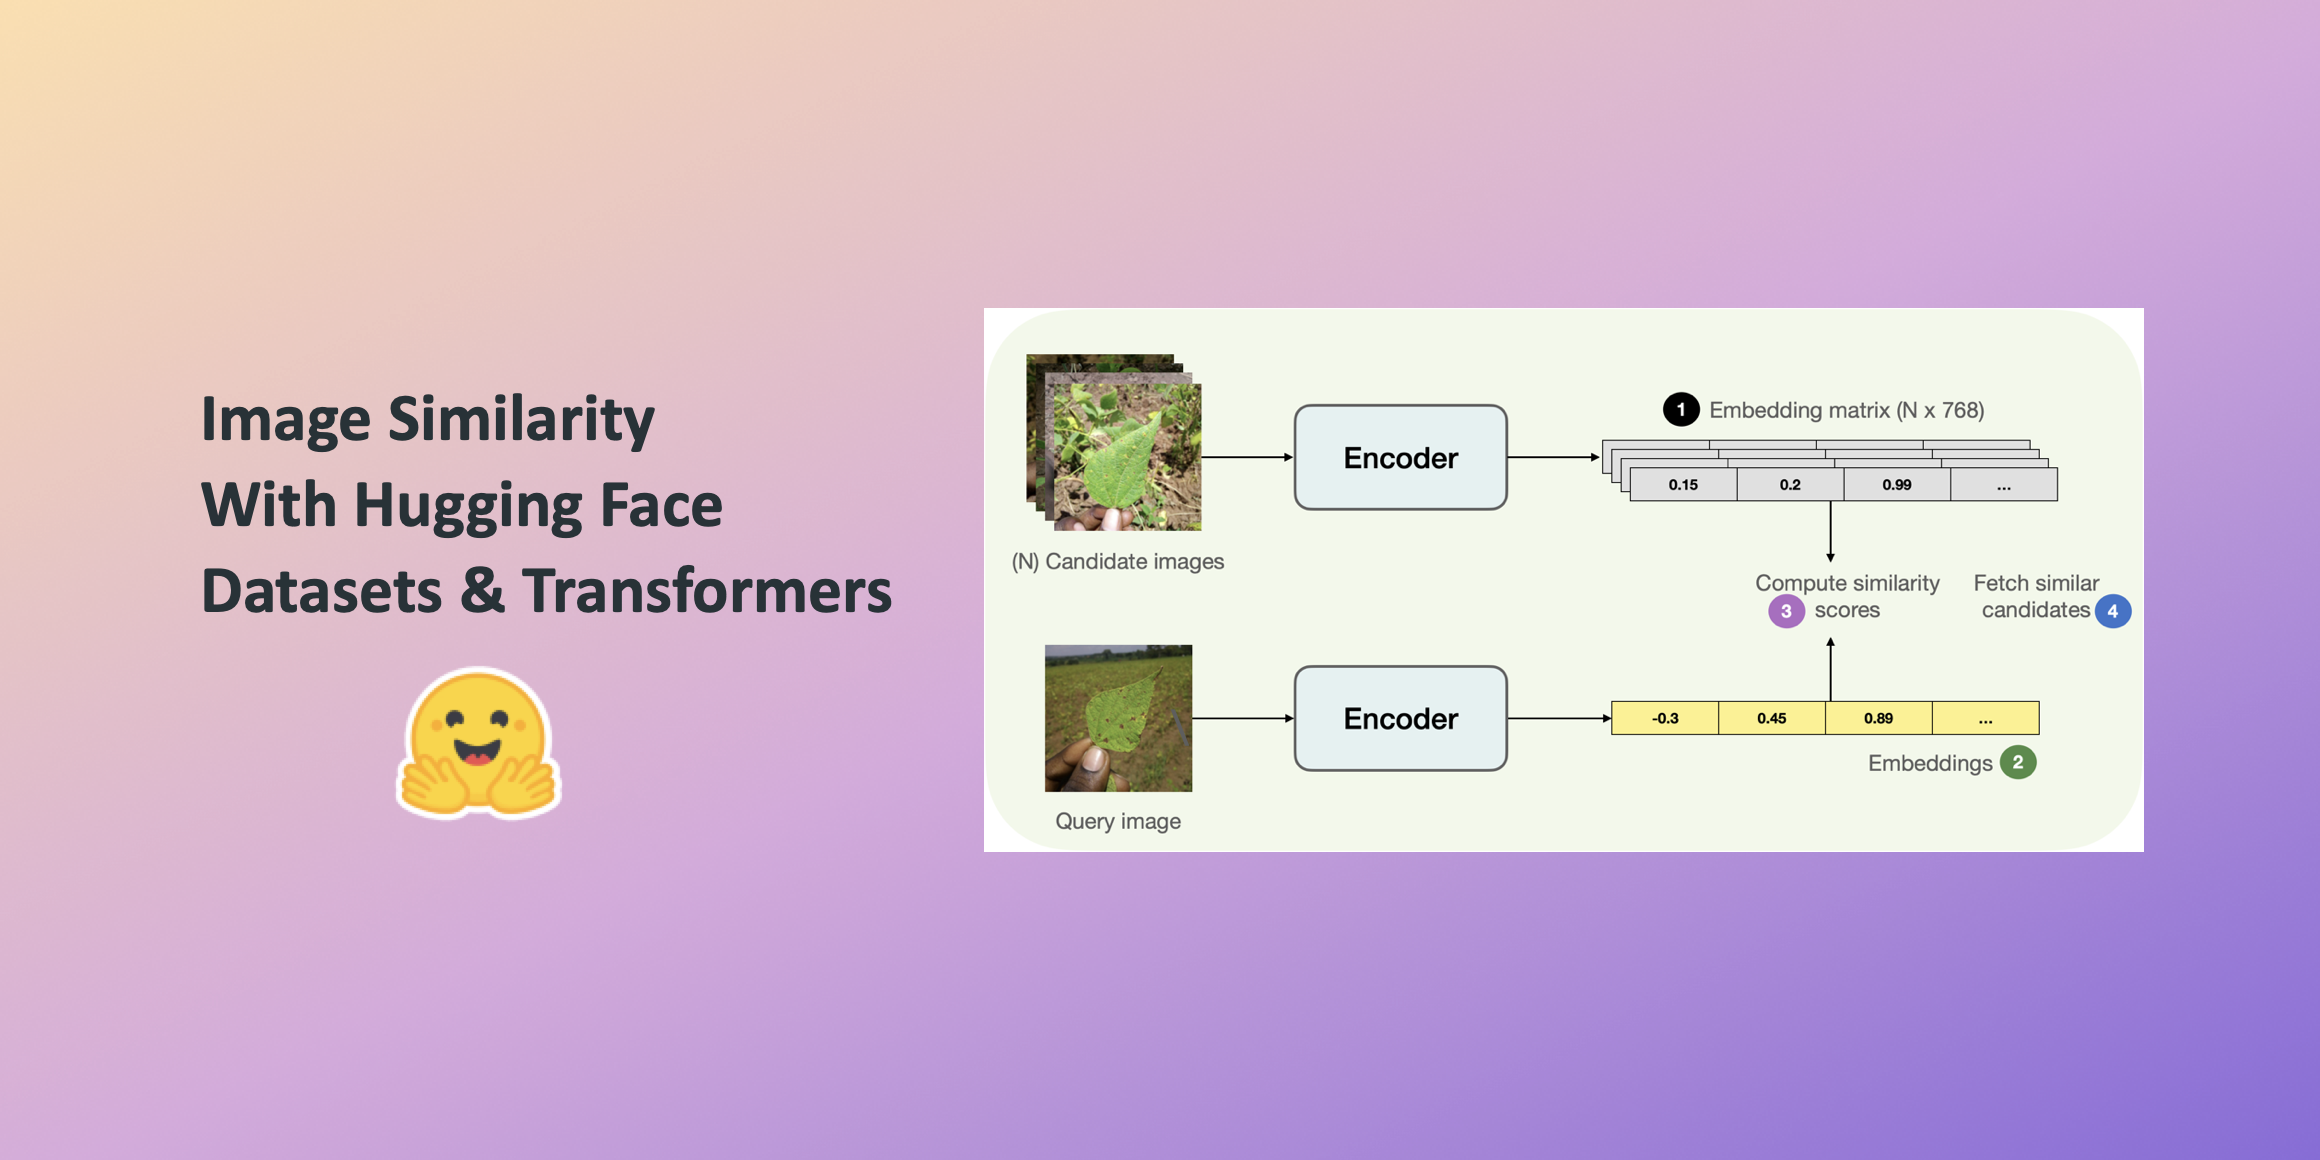
ეს სტატია დეტალურად აღწერს გამოსახულების მსგავსების სისტემის აგების პროცესს, რომელიც ეფუძნება ღრმა სწავლებას და ემბედინგების გამოყენებას. განხილულია გამოსახულებების ვექტორულ სივრცეში წარმოდგენა, კოსინუსური მსგავსების გამოთვლა, Hugging Face-ის `datasets` ბიბლიოთეკისა და `AutoModel` კლასის გამოყენება. ასევე, მოცემულია რჩევები მოდელის შერჩევისა და სისტემის ეფექტურობის გაუმჯობესების შესახებ, მათ შორის განზომილების შემცირებისა და FAISS ინტეგრაციის შესაძლებლობები.