Vertex AI-ის გამოყენება ML მოდელების განლაგებისთვის: დეტალური მიმოხილვა
ეს პუბლიკაცია განიხილავს Google Cloud-ის Vertex AI პლატფორმის შესაძლებლობებს მანქანური სწავლის (ML) მოდელების განლაგებისთვის. ის მოიცავს ისეთ ფუნქციებს, როგორიცაა აუთენტიფიკაცია, ავტომატური სკალირება, მოდელის ვერსიონირება და მონიტორინგი, ასევე TensorFlow მოდელებთან მუშაობის სპეციფიკას. განმარტებულია Vertex AI Model Registry-ის და Endpoint-ის როლი, და მოცემულია განლაგების ნაბიჯ-ნაბიჯ ინსტრუქცია Python SDK-ის გამოყენებით.
ეს პუბლიკაცია ეფუძნება ზემოთ მოცემულ ორ წინა პუბლიკაციას. რეკომენდებულია მათი გადახედვა, თუ ჯერ არ გაგიკეთებიათ. სრულად დამუშავებული მაგალითი შეგიძლიათ იხილოთ Colab Notebook-ში, რომელიც პუბლიკაციის დასაწყისშია მითითებული.
Google Cloud-ის მიხედვით: Vertex AI გთავაზობთ ინსტრუმენტებს თქვენი სრული ML (მანქანური სწავლის) სამუშაო პროცესის მხარდასაჭერად, სხვადასხვა მოდელის ტიპებისა და ML ექსპერტიზის დონის გათვალისწინებით. მოდელების განლაგებასთან დაკავშირებით, Vertex AI გთავაზობთ რამდენიმე მნიშვნელოვან ფუნქციას ერთიანი API დიზაინით:
* აუთენტიფიკაცია (Authentication)
* ავტომატური სკალირება ტრაფიკის მიხედვით (Autoscaling based on traffic)
* მოდელის ვერსიონირება (Model versioning)
* ტრაფიკის გაყოფა მოდელის სხვადასხვა ვერსიას შორის (Traffic splitting between different versions of a model)
* ლიმიტირება (Rate limiting)
* მოდელის მონიტორინგი და ლოგირება (Model monitoring and logging)
* ონლაინ და პარტიული პროგნოზების მხარდაჭერა (Support for online and batch predictions)
TensorFlow მოდელებისთვის ის გთავაზობთ სხვადასხვა მზა ინსტრუმენტებს, რომლებსაც ამ პუბლიკაციაში გაეცნობით. თუმცა, მას მსგავსი მხარდაჭერა აქვს სხვა ფრეიმვორკებისთვისაც, როგორიცაა PyTorch და scikit-learn.
Vertex AI-ის გამოსაყენებლად დაგჭირდებათ Google Cloud Platform (GCP) პროექტი, რომელზეც გააქტიურებულია ბილინგი და შემდეგი სერვისები: Vertex AI, Cloud Storage.
თქვენ გამოიყენებთ იგივე ViT B/16 მოდელს, რომელიც TensorFlow-ში იყო იმპლემენტირებული, როგორც წინა ორ პუბლიკაციაში. მოდელი სერიალიზებული იყო შესაბამისი წინასწარი და შემდგომი დამუშავების ოპერაციებით, რათა შემცირდეს წვდომისას და მონაცემების დამუშავებისას მიღებული გადახრა. დეტალებისთვის იხილეთ პირველი პუბლიკაცია. საბოლოო სერიალიზებული SavedModel-ის ხელმოწერა გამოიყურება შემდეგნაირად:
მოდელი მიიღებს სურათების base64 კოდირებულ სტრიქონებს, შეასრულებს წინასწარ დამუშავებას, განახორციელებს ინფერენსს და საბოლოოდ შეასრულებს შემდგომი დამუშავების ნაბიჯებს. სტრიქონები base64 კოდირებულია ქსელური გადაცემის დროს ნებისმიერი მოდიფიკაციის თავიდან ასაცილებლად. წინასწარი დამუშავება მოიცავს შემავალი სურათის ზომის შეცვლას 224x224 რეზოლუციამდე, მის სტანდარტიზაციას [-1, 1] დიაპაზონში და მის ტრანსპონირებას channels_first მეხსიერების განლაგებაში. შემდგომი დამუშავება მოიცავს პროგნოზირებული ლოგიტების სტრიქონულ ლეიბლებზე დაყვანას.
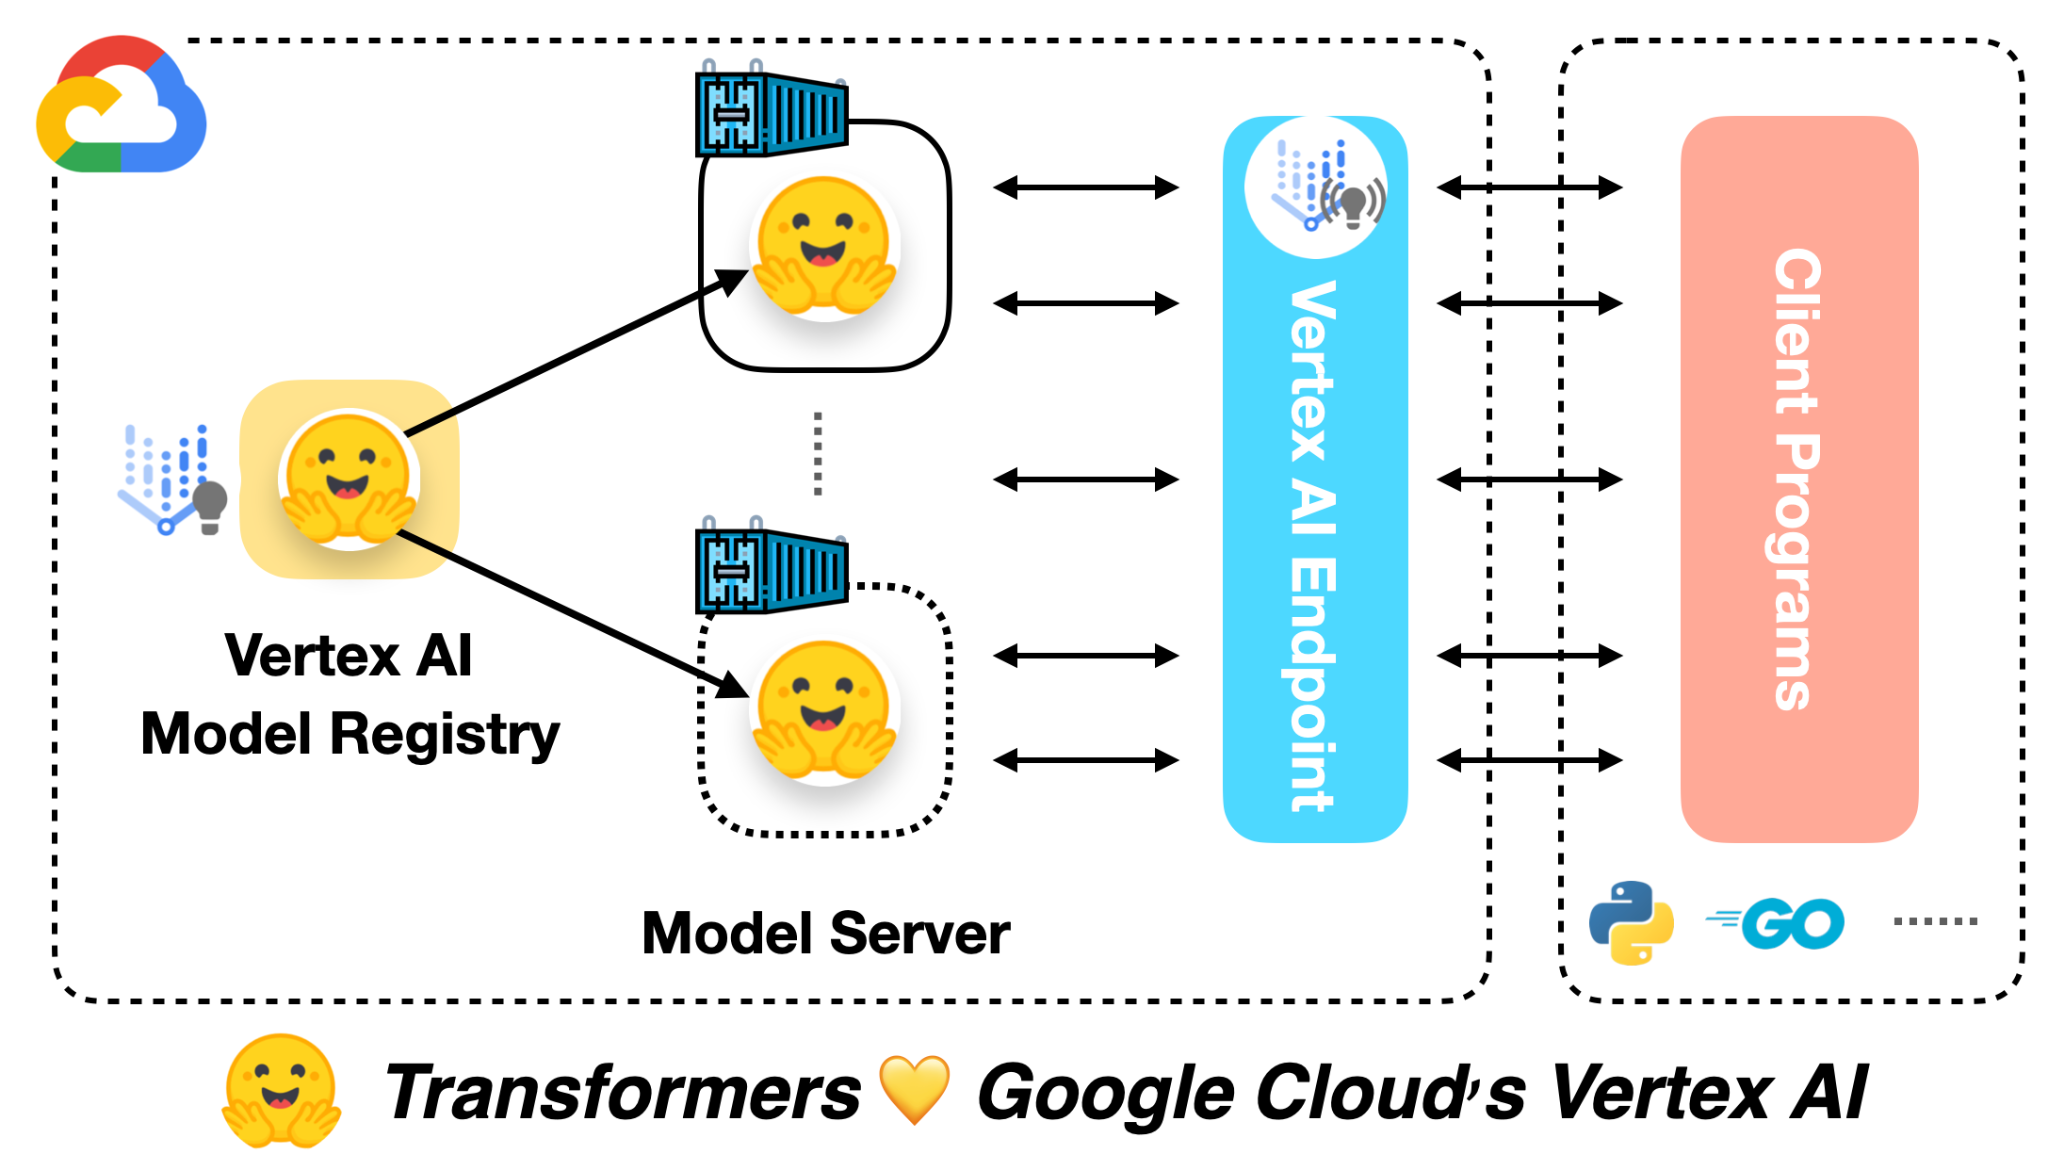
Vertex AI-ზე განლაგების შესასრულებლად, მოდელის არტიფაქტები უნდა შეინახოთ Google Cloud Storage (GCS) ბაკეტში. თანდართული Colab Notebook გვიჩვენებს, თუ როგორ შევქმნათ GCS ბაკეტი და შევინახოთ მასში მოდელის არტიფაქტები. ქვემოთ მოცემული სურათი ასახავს უკვე გაწვრთნილი TensorFlow მოდელის Vertex AI-ზე განლაგების სამუშაო პროცესს.
მოდით განვიხილოთ, რა არის Vertex AI Model Registry და Endpoint. Vertex AI Model Registry არის სრულად მართვადი მანქანური სწავლის მოდელების რეგისტრატორი. არსებობს რამდენიმე საკითხი, რაც გასათვალისწინებელია „სრულად მართვადი“-ს მნიშვნელობასთან დაკავშირებით. პირველ რიგში, თქვენ არ გჭირდებათ იმაზე ფიქრი, თუ როგორ და სად ინახება მოდელები. მეორე, ის მართავს ერთი და იმავე მოდელის სხვადასხვა ვერსიებს. ეს ფუნქციები მნიშვნელოვანია მანქანური სწავლის წარმოებისთვის. მოდელის რეგისტრატორის შექმნა, რომელიც უზრუნველყოფს მაღალ ხელმისაწვდომობას და უსაფრთხოებას, რთული ამოცანაა. ასევე, ხშირად არის სიტუაციები, როდესაც გსურთ მიმდინარე მოდელის წინა ვერსიაზე დაბრუნება, რადგან ჩვენ ვერ ვაკონტროლებთ „შავი ყუთის“ მანქანური სწავლის მოდელის შიგნით არსებულ პროცესებს. Vertex AI Model Registry საშუალებას გვაძლევს, ამის მიღწევა დიდი სირთულის გარეშე მოვახდინოთ.
ამჟამად მხარდაჭერილი მოდელის ტიპები მოიცავს SavedModel-ს TensorFlow-დან, scikit-learn-ს და XGBoost-ს. მომხმარებლის პერსპექტივიდან, Vertex AI Endpoint უბრალოდ უზრუნველყოფს მოთხოვნების მისაღებ და პასუხების გასაგზავნ წერტილს. თუმცა, მანქანური სწავლის ოპერატორებისთვის მას აქვს უამრავი კონფიგურირებადი პარამეტრი. აქ მოცემულია რამდენიმე კონფიგურაცია, რომელთა არჩევაც შეგიძლიათ:
* მოდელის ვერსია (Version of a model)
* VM-ის სპეციფიკაცია CPU-ს, მეხსიერების და ამაჩქარებლების მიხედვით (Specification of VM in terms of CPU, memory, and accelerators)
* გამოთვლითი კვანძების მინიმალური/მაქსიმალური რაოდენობა (Min/Max number of compute nodes)
* ტრაფიკის გაყოფის პროცენტული მაჩვენებელი (Traffic split percentage)
* მოდელის მონიტორინგის ფანჯრის ხანგრძლივობა და მისი მიზნები (Model monitoring window length and its objectives)
* პროგნოზირების მოთხოვნების შერჩევის სიხშირე (Prediction requests sampling rate)
google-cloud-aiplatform Python SDK გთავაზობთ მარტივ API-ებს Vertex AI-ზე განლაგების სასიცოცხლო ციკლის სამართავად. ის ოთხ ეტაპად იყოფა: ამ ნაბიჯების განმავლობაში, Vertex AI-სთან ურთიერთობისთვის დაგჭირდებათ ModelServiceClient, EndpointServiceClient და PredictionServiceClient მოდულები google-cloud-aiplatform Python SDK-დან.
1. სამუშაო პროცესის პირველი ნაბიჯი არის SavedModel-ის ატვირთვა Vertex AI-ის მოდელის რეგისტრატორში: მოდით განვიხილოთ კოდი ნაწილ-ნაწილ: GCS_BUCKET აღნიშნავს თქვენი GCS ბაკეტის გზას, სადაც განთავსებულია მოდელის არტიფაქტები (მაგ., gs://hf-tf-vision). container_spec-ში თქვენ მიუთითებთ Docker გამოსახულების URI-ს, რომელიც გამოყენებული იქნება პროგნოზების სერვირებისთვის. Vertex AI გთავაზობთ წინასწარ შექმნილ გამოსახულებებს TensorFlow მოდელების სერვირებისთვის, მაგრამ ასევე შეგიძლიათ გამოიყენოთ თქვენი საბაჟო Docker გამოსახულებები სხვა ფრეიმვორკის გამოყენებისას (მაგალითი). model_service_client არის ModelServiceClient ობიექტი, რომელიც აჩვენებს მეთოდებს Vertex AI Model Registry-ში მოდელის ასატვირთად. PARENT დაყენებულია f"projects/{PROJECT_ID}/locations/{REGION}"-ზე, რაც Vertex AI-ს საშუალებას აძლევს განსაზღვროს, სად იქნება მოდელი განთავსებული GCP-ში.
2. შემდეგ თქვენ უნდა შექმნათ Vertex AI Endpoint: აქ თქვენ იყენებთ endpoint_service_client-ს, რომელიც არის EndpointServiceClient ობიექტი. ის საშუალებას გაძლევთ შექმნათ და დააკონფიგურიროთ თქვენი Vertex AI Endpoint.
3. ახლა თქვენ გადადიხართ რეალური განლაგების შესრულებაზე! აქ, თქვენ აერთიანებთ Vertex AI Model Registry-ში ატვირთულ მოდელს და ზემოთ მოცემულ ნაბიჯებში შექმნილ Endpoint-ს. პირველ რიგში თქვენ განსაზღვრავთ...
თეგები:
#ხელოვნური ინტელექტი
#მანქანური სწავლება
#google cloud
#tensorflow
#vertex ai
#ml deployment
#model registry
#endpoint
#gcp
#gcs
#python sdk
წყარო: huggingface.co
AI-ით გადამუშავებული
მსგავსი სტატიები

ტექნოლოგიები
Honor Magic V6: უთხელესი დასაკეცი ტელეფონი? პირველი შთაბეჭდილებები
ტექნოლოგიები
Honor Magic V6: ყველაზე თხელი დასაკეცი სმარტფონი და მისი შთამბეჭდავი შესაძლებლობები

ტექნოლოგიები