Intel Xeon Ice Lake: AI ამოცანების ოპტიმიზაცია პროგრამული გაუმჯობესებებით
Intel-ის უახლესი Ice Lake თაობის Xeon პროცესორები მნიშვნელოვან გაუმჯობესებას გვთავაზობს ხელოვნური ინტელექტის (AI) ამოცანებისთვის, განსაკუთრებით პროგრამული ოპტიმიზაციების დახმარებით. სტატია დეტალურად განიხილავს, თუ როგორ უზრუნველყოფს Intel-ი მაღალ ეფექტურობას AVX512, VNNI და oneAPI კომპონენტების, როგორიცაა oneMKL და oneDNN, მეშვეობით, ასევე სპეციალიზებული ფრეიმვორკებით, როგორიცაა Intel TensorFlow და PyTorch Extension. მიმოხილულია აპარატურული და პროგრამული ინოვაციების კომბინაცია, რამაც Ice Lake-ს
Intel Xeon Ice Lake: პროგრამული ოპტიმიზაციები ხელოვნური ინტელექტის ამოცანებისთვის
ეს ბლოგპოსტი დეტალურად განიხილავს Intel-ის ახალი Ice Lake თაობის Xeon CPU-ების პროგრამულ ოპტიმიზაციებს, რომლებიც მიზნად ისახავს ხელოვნური ინტელექტის (AI) დატვირთვების ეფექტურობის გაზრდას. აღწერილია, თუ როგორ იყენებს Intel როგორც აპარატურულ, ასევე პროგრამულ გაუმჯობესებებს, რათა მიაღწიოს 75%-ით უფრო სწრაფ ინფერენციას NLP ამოცანებში. სტატია ხაზს უსვამს Intel-ის როლს წამყვანი AI ფრეიმვორკების (როგორიცაა TensorFlow და PyTorch) ოპტიმიზაციაში, oneAPI ბიბლიოთეკების მნიშვნელობას მაღალი წარმადობისთვის, და

ღრმა სწავლის დაჩქარება Intel Xeon CPU-ებზე: ტრანსფერული სწავლის ახალი შესაძლებლობები
გრაფიკული პროცესორების (GPU) ნაცვლად, ტრანსფერული სწავლის განვითარება ღრმა სწავლის მოდელების ოპტიმიზაციისთვის CPU-ზე დაფუძნებულ კლასტერებს საინტერესო ალტერნატივად აქცევს. ეს სტატია განმარტავს, თუ როგორ შეიძლება PyTorch-ის სასწავლო ამოცანების დაჩქარება Intel Xeon Scalable CPU სერვერების გამოყენებით, Ice Lake არქიტექტურაზე დაფუძნებული ვირტუალური მანქანების კლასტერის შექმნით და წარმადობაზე ოპტიმიზებული პროგრამული ბიბლიოთეკების ინსტალაციით, როგორიცაა Intel extension for PyTorch და oneCCL.
Hugging Face Infinity: ტრანსფორმერული მოდელების ოპტიმალური განთავსება Intel Xeon CPU-ებზე
Hugging Face Infinity არის კონტეინერიზებული გადაწყვეტა, რომელიც საშუალებას აძლევს კომპანიებს ეფექტურად განათავსონ ტრანსფორმერული მოდელები წარმოებაში დაბალი ლატენტურობითა და მაღალი გამტარუნარიანობით. ეს ბლოგ პოსტი წარმოადგენს დეტალურ წარმადობის შედეგებს Infinity-ის უახლესი თაობის Intel Xeon CPU-ებზე გაშვებისას (კერძოდ, Ice Lake-ზე დაფუძნებული EC2 C6i ინსტანსებზე), რაც უზრუნველყოფს ოპტიმალურ ღირებულებას, ეფექტურობასა და ლატენტურობას თქვენი Transformer-ის განთავსებისთვის.
Hugging Face-ის ინოვაციები: მანქანური სწავლის მოდელების განთავსების გამარტივებული გზები
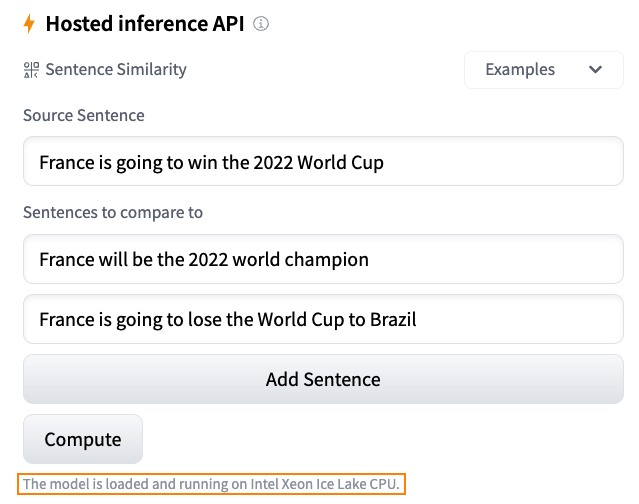
Hugging Face წარმოგიდგენთ ინოვაციურ გადაწყვეტილებებს მანქანური სწავლის (ML) განვითარებისა და ოპერაციების გასამარტივებლად, უმაღლესი ხარისხის სტანდარტების დათმობის გარეშე. სტატია მიმოიხილავს Inference Widget-ს, Inference API-ს, Inference Endpoints-სა და Spaces-ს, როგორც ინსტრუმენტებს ML მოდელების მარტივი ტესტირების, განთავსებისა და ოპტიმიზაციისთვის. ხაზგასმულია Intel-თან პარტნიორობა, რაც უზრუნველყოფს უფასო CPU-ზე დაფუძნებულ ინფერენსის გადაწყვეტილებებს და მომხმარებლებს Intel Xeon Ice Lake არქიტექტუ