Intel Xeon Ice Lake: AI ამოცანების ოპტიმიზაცია პროგრამული გაუმჯობესებებით
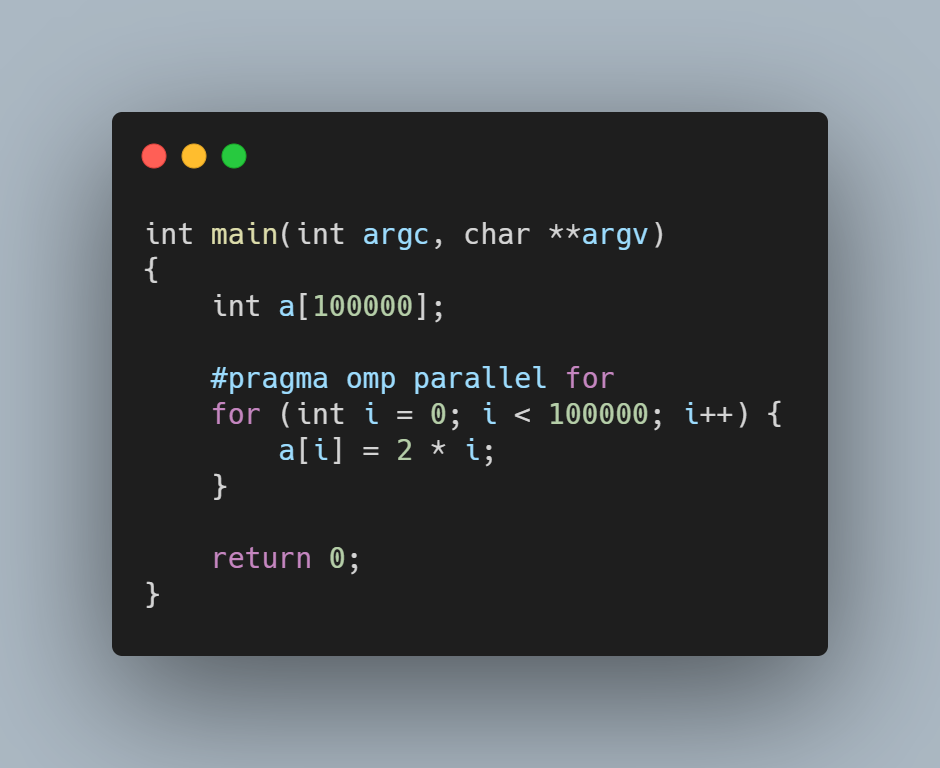
Intel-ის უახლესი Ice Lake თაობის Xeon პროცესორები მნიშვნელოვან გაუმჯობესებას გვთავაზობს ხელოვნური ინტელექტის (AI) ამოცანებისთვის, განსაკუთრებით პროგრამული ოპტიმიზაციების დახმარებით. სტატია დეტალურად განიხილავს, თუ როგორ უზრუნველყოფს Intel-ი მაღალ ეფექტურობას AVX512, VNNI და oneAPI კომპონენტების, როგორიცაა oneMKL და oneDNN, მეშვეობით, ასევე სპეციალიზებული ფრეიმვორკებით, როგორიცაა Intel TensorFlow და PyTorch Extension. მიმოხილულია აპარატურული და პროგრამული ინოვაციების კომბინაცია, რამაც Ice Lake-ს
Intel Xeon Ice Lake: პროგრამული ოპტიმიზაციები ხელოვნური ინტელექტის ამოცანებისთვის
ეს ბლოგპოსტი დეტალურად განიხილავს Intel-ის ახალი Ice Lake თაობის Xeon CPU-ების პროგრამულ ოპტიმიზაციებს, რომლებიც მიზნად ისახავს ხელოვნური ინტელექტის (AI) დატვირთვების ეფექტურობის გაზრდას. აღწერილია, თუ როგორ იყენებს Intel როგორც აპარატურულ, ასევე პროგრამულ გაუმჯობესებებს, რათა მიაღწიოს 75%-ით უფრო სწრაფ ინფერენციას NLP ამოცანებში. სტატია ხაზს უსვამს Intel-ის როლს წამყვანი AI ფრეიმვორკების (როგორიცაა TensorFlow და PyTorch) ოპტიმიზაციაში, oneAPI ბიბლიოთეკების მნიშვნელობას მაღალი წარმადობისთვის, და
PyTorch-ის სწავლების დაჩქარება AWS-ზე Intel Sapphire Rapids პროცესორებით
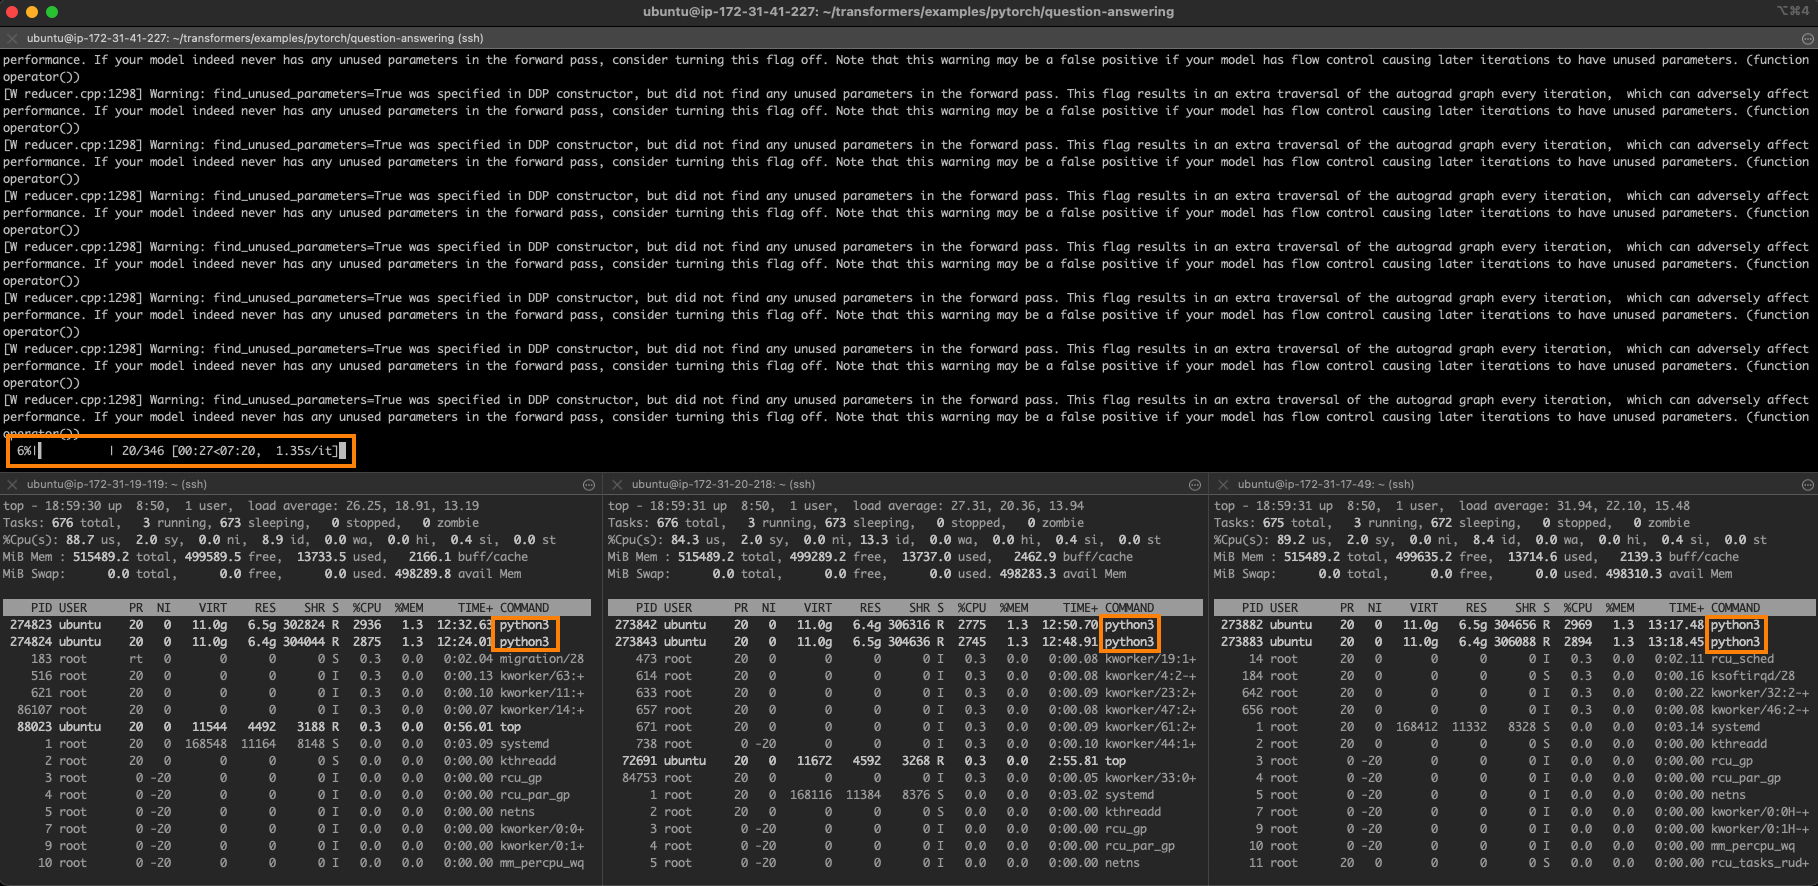
ეს პუბლიკაცია განიხილავს, თუ როგორ შეიძლება PyTorch-ის ღრმა სწავლების სამუშაოების მნიშვნელოვნად დაჩქარება AWS-ზე განთავსებული Intel Sapphire Rapids სერვერების კლასტერის მეშვეობით. სტატია დეტალურად აღწერს Intel oneAPI Collective Communications Library (CCL) და Intel Extension for PyTorch (IPEX) ბიბლიოთეკების გამოყენებას გადანაწილებული სწავლებისთვის, რომლებიც სრულად ინტეგრირებულია Hugging Face transformers-თან. ხაზგასმულია Intel Xeon CPU-ების უპირატესობები ღრმა სწავლებისას, მათ შორის ხარჯთეფექტურო
PyTorch-ის ტრენინგის დაჩქარება AWS-ზე Sapphire Rapids სერვერებით
ეს პოსტი აღწერს, თუ როგორ უნდა დააჩქაროთ PyTorch-ის ტრენინგის სამუშაოები AWS-ზე Sapphire Rapids სერვერების კლასტერის გამოყენებით. სტატია დეტალურად განიხილავს Intel oneAPI Collective Communications Library (CCL) და Intel Extension for PyTorch (IPEX) ბიბლიოთეკების გამოყენებას განაწილებული ტრენინგისთვის და ახალი CPU ინსტრუქციების ოპტიმიზაციისთვის. ასევე ხაზგასმულია Intel Xeon CPU-ების ღირებულებითი ეფექტურობა, მასშტაბურობა და მოწინავე ფუნქციები (AVX-512, Hyper-Threading, AMX) ღრმა სწავლის მოდელების