ხელოვნური ინტელექტის მეგა-მოდელები: ღირს კი ეს ხარჯი და ძალისხმევა?
სტატია აანალიზებს ხელოვნური ინტელექტის მეგა-მოდელების ტენდენციას და ეჭვქვეშ აყენებს მათ მიზანშეწონილობას მაღალი დანახარჯების, სირთულისა და გარემოზე ზემოქმედების გამო. ავტორი აღნიშნავს, რომ მიუხედავად ინჟინრული მიღწევებისა, უზარმაზარი მოდელების შექმნა, რომლებიც ადამიანის ტვინის ზომას უახლოვდება, შესაძლოა, გრძელვადიან პერსპექტივაში საუკეთესო მიდგომა არ იყოს. სანაცვლოდ, ის მხარს უჭერს პრაგმატულ გადაწყვეტილებებს, როგორიცაა წინასწარ გაწვრთნილი, უფრო მცირე ზომის მოდელების გამოყენება და მათი დახვეწა (f
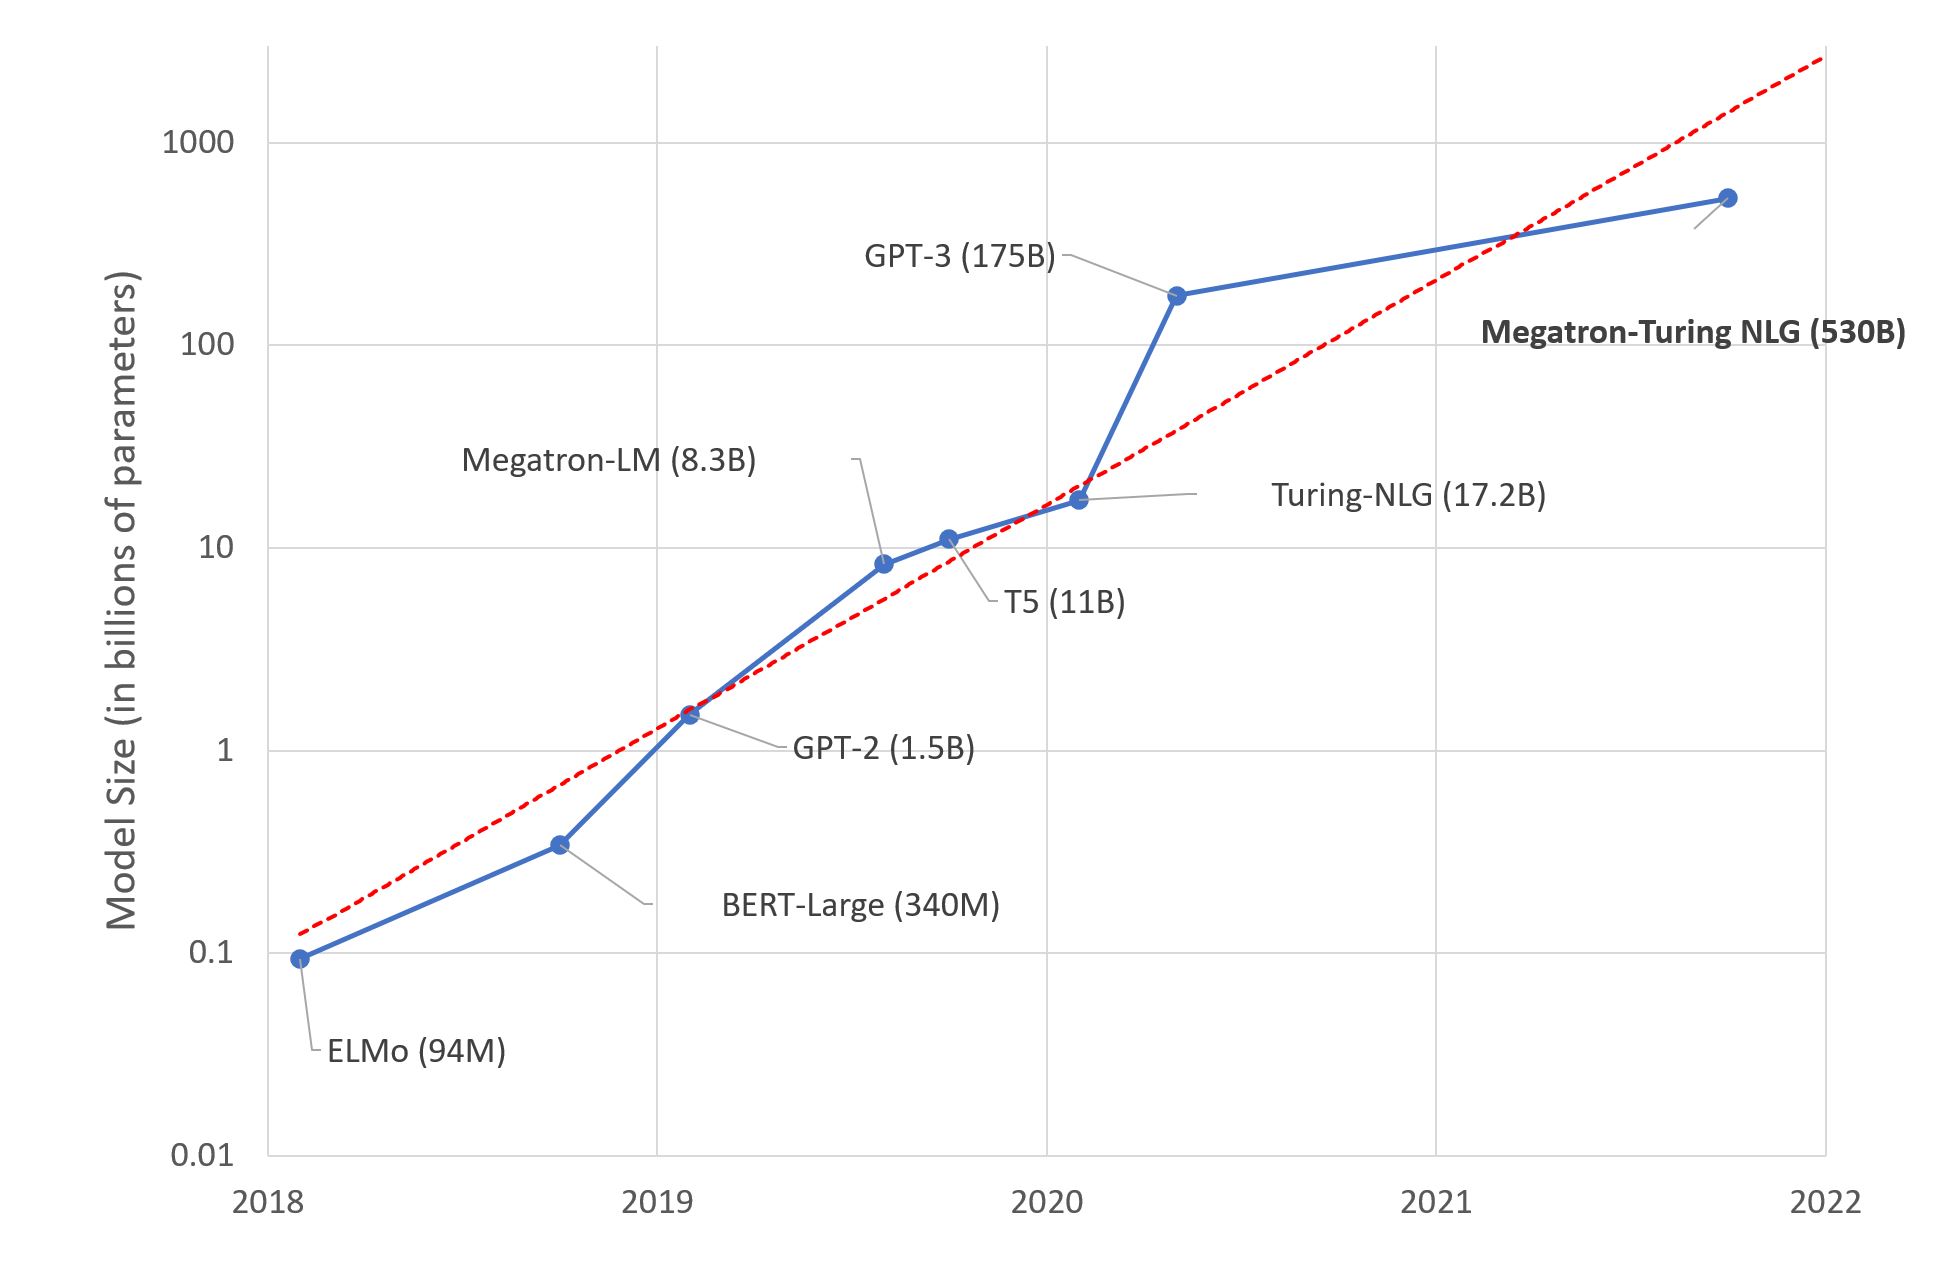
ეს უდავოდ, მანქანური სწავლების ინჟინერიის შთამბეჭდავი მიღწევაა. თუმცა, უნდა გვეხაროდეს თუ არა მეგა-მოდელების ამ ტენდენციის გამო? მე პირადად, არ მიხარია. აი, რატომ.
მკვლევარების შეფასებით, ადამიანის ტვინი საშუალოდ 86 მილიარდ ნეირონს და 100 ტრილიონ სინაფსს შეიცავს. შეგვიძლია ვივარაუდოთ, რომ ყველა მათგანი ენას არ ეთმობა. საინტერესოა, რომ GPT-4-ს დაახლოებით 100 ტრილიონი პარამეტრი ექნება... რამდენადაც უხეშიც არ უნდა იყოს ეს ანალოგია, არ უნდა დავფიქრდეთ, არის თუ არა ენობრივი მოდელების აგება, რომლებიც ადამიანის ტვინის ზომას უახლოვდებიან, საუკეთესო გრძელვადიანი მიდგომა? რა თქმა უნდა, ჩვენი ტვინი საოცარი მოწყობილობაა, რომელიც მილიონობით წლის ევოლუციამ შექმნა, ხოლო ღრმა სწავლების მოდელები მხოლოდ რამდენიმე ათწლეულის ასაკისაა. მიუხედავად ამისა, ჩვენმა ინტუიციამ უნდა გვითხრას, რომ რაღაც არ ეთავსება ერთმანეთს (ითამაშა სიტყვაზე).
როგორც მოსალოდნელია, 530 მილიარდი პარამეტრის მქონე მოდელის გაწვრთნა უზარმაზარ ტექსტურ მონაცემთა ნაკრებებზე საკმაოდ დიდ ინფრასტრუქტურას მოითხოვს. ფაქტობრივად, Microsoft-მა და NVIDIA-მ გამოიყენეს ასობით DGX A100-ის მრავალ-GPU სერვერი. იმის გათვალისწინებით, რომ თითოეული $199,000 ღირს, დამატებით ქსელური აღჭურვილობის, ჰოსტინგის ხარჯების და ა.შ., ამ ექსპერიმენტის გამეორების მსურველს თითქმის $100 მილიონი დოლარის დახარჯვა მოუწევს. კარტოფილი ფრი ხომ არ გნებავთ? სერიოზულად, რომელ ორგანიზაციებს აქვთ ისეთი ბიზნეს შემთხვევები, რომლებიც გაამართლებს $100 მილიონის დახარჯვას ღრმა სწავლების ინფრასტრუქტურაზე? ან თუნდაც $10 მილიონის? ძალიან ცოტას. მაშ, ვისთვის არის ეს მოდელები, სინამდვილეში? მიუხედავად მთელი ინჟინრული ბრწყინვალებისა, ღრმა სწავლების მოდელების GPU-ებზე გაწვრთნა უხეში ძალის ტექნიკაა. სპეციფიკაციის მიხედვით, თითოეულ DGX სერვერს შეუძლია 6.5 კილოვატამდე ენერგიის მოხმარება. რა თქმა უნდა, თქვენს მონაცემთა ცენტრში (ან სერვერის კარადაში) სულ მცირე, ამდენივე გაგრილების სიმძლავრე დაგჭირდებათ. თუ სტარკები არ ხართ და ზამთარში ვინტერფელის გათბობა არ გჭირდებათ, ეს კიდევ ერთი პრობლემაა, რომლის მოგვარებაც მოგიწევთ.
გარდა ამისა, რადგან საზოგადოების ცნობიერება იზრდება კლიმატის და სოციალური პასუხისმგებლობის საკითხებზე, ორგანიზაციებმა უნდა გაითვალისწინონ მათი ნახშირბადის კვალი. მასაჩუსეტსის უნივერსიტეტის 2019 წლის კვლევის მიხედვით, „BERT-ის GPU-ზე გაწვრთნა დაახლოებით ტრანსამერიკული ფრენის ეკვივალენტურია“. BERT-Large-ს 340 მილიონი პარამეტრი აქვს. მხოლოდ ექსტრაპოლაცია შეიძლება მოვახდინოთ, თუ როგორი იქნება Megatron-Turing-ის კვალი... ადამიანები, ვინც მიცნობენ, არ მეტყვიან, რომ ზედმეტად ემოციური ეკოლოგი ვარ. მიუხედავად ამისა, ზოგიერთი ციფრის უგულებელყოფა რთულია. აღფრთოვანებული ვარ Megatron-Turing NLG 530B-ით და იმით, რაც შემდეგ მოდის? არა. ვფიქრობ, რომ (შედარებით მცირე) ბენჩმარკის გაუმჯობესება ღირს დამატებულ ხარჯად, სირთულედ და ნახშირბადის კვალად? არა. ვფიქრობ, რომ ამ უზარმაზარი მოდელების აგება და პოპულარიზაცია ეხმარება ორგანიზაციებს მანქანური სწავლების გაგებაში და მიღებაში? არა. მაინტერესებს, რა აზრი აქვს ამ ყველაფერს. მეცნიერება მეცნიერების გულისთვის? ძველი კარგი მარკეტინგი? ტექნოლოგიური უპირატესობა? ალბათ, ცოტა ყველაფერი ერთად. ამას მათ მივანდობ.
ამის ნაცვლად, ნება მომეცით ყურადღება გავამახვილო პრაგმატულ და ქმედით მეთოდებზე, რომელთა გამოყენებაც ყველას შეუძლია მაღალი ხარისხის მანქანური სწავლების გადაწყვეტილებების შესაქმნელად. შემთხვევების აბსოლუტურ უმრავლესობაში, თქვენ არ დაგჭირდებათ მორგებული მოდელის არქიტექტურა. შესაძლოა, მოგინდეთ მორგებული (რაც სხვა რამეა), მაგრამ აქ საფრთხეები იმალება. მხოლოდ ექსპერტებისთვის! კარგი საწყისი წერტილია ისეთი მოდელების მოძიება, რომლებიც წინასწარ გაწვრთნილია იმ ამოცანისთვის, რომლის გადაჭრასაც ცდილობთ (მაგალითად, ინგლისური ტექსტის შეჯამება). შემდეგ, სწრაფად უნდა სცადოთ რამდენიმე მოდელი თქვენი საკუთარი მონაცემების პროგნოზირებისთვის. თუ მეტრიკა გეუბნებათ, რომ ერთი საკმარისად კარგად მუშაობს, მორჩა! თუ ცოტა მეტი სიზუსტე გჭირდებათ, უნდა იფიქროთ მოდელის დახვეწაზე (ამაზე უფრო ვრცლად წუთში).
მოდელების შეფასებისას, უნდა აირჩიოთ ყველაზე პატარა, რომელსაც შეუძლია სასურველი სიზუსტის მიღწევა. ის უფრო სწრაფად განახორციელებს პროგნოზირებას და ნაკლებ აპარატურულ რესურსს მოითხოვს გაწვრთნისა და ინფერენციისთვის. ეკონომიურობას დიდი მნიშვნელობა აქვს. ეს არც სიახლეა. კომპიუტერული ხედვის სპეციალისტებს ემახსოვრებათ, როდესაც SqueezeNet გამოვიდა 2017 წელს, რომელმაც 50-ჯერ შეამცირა მოდელის ზომა AlexNet-თან შედარებით, ამავე დროს მისი სიზუსტე შეინარჩუნა ან გააუმჯობესა. რა ჭკვიანური იყო ეს! ზომის შემცირების მცდელობები მიმდინარეობს ბუნებრივი ენის დამუშავების საზოგადოებაშიც, ტრანსფერული სწავლების ტექნიკის გამოყენებით, როგორიცაა ცოდნის დისტილაცია. DistilBERT შესაძლოა მისი ყველაზე ცნობილი მიღწევაა. ორიგინალურ BERT მოდელთან შედარებით, ის ინარჩუნებს ენის გაგების 97%-ს, ხოლო არის 40%-ით პატარა და 60%-ით სწრაფი. შეგიძლიათ მისი გამოცდა აქ. იგივე მიდგომა გამოიყენეს სხვა მოდელებზეც, როგორიცაა Facebook-ის BART, და შეგიძლიათ DistilBART გამოცადოთ აქ. Big Science პროექტის უახლესი მოდელებიც ძალიან შთამბეჭდავია. როგორც კვლევით ნაშრომში მოცემულ გრაფიკზე ჩანს, მათი T0 მოდელი ბევრ ამოცანაში აჭარბებს GPT-3-ს, ხოლო არის 16-ჯერ პატარა. შეგიძლიათ T0 გამოცადოთ აქ. ეს არის ისეთი სახის კვლევა, რაც უფრო მეტად გვჭირდება!
თუ მოდელის სპეციალიზება გჭირდებათ, ძალიან ცოტა მიზეზი უნდა არსებობდეს მისი ნულიდან გაწვრთნისთვის. ამის ნაცვლად, თქვენ უნდა დახვეწოთ იგი, ანუ გაწვრთნათ ის მხოლოდ რამდენიმე ეპოქის განმავლობაში საკუთარ მონაცემებზე. თუ მონაცემები გაკლიათ, შესაძლოა, ერთ-ერთმა ამ მონაცემთა ნაკრებმა გამოგადგეთ. თქვენ გამოიცანით, ეს ტრანსფერული სწავლების კიდევ ერთი გზაა და ის დაგეხმარებათ.
თეგები:
#ხელოვნური ინტელექტი
#ინოვაცია
#მანქანური სწავლება
#ოპტიმიზაცია
#დიდი ენობრივი მოდელები
#მდგრადობა
#ღრმა სწავლება
#ტრანსფერული სწავლება
#ხარჯები
წყარო: huggingface.co
AI-ით გადამუშავებული


