ექსპერტთა ნაზავი (MoEs): სიღრმისეული მიმოხილვა და იშვიათი მოდელების როლი
ექსპერტთა ნაზავი (MoEs) წარმოადგენს მნიშვნელოვან მიღწევას ხელოვნურ ინტელექტში, რომელიც საშუალებას აძლევს მოდელებს, მიაღწიონ უკეთეს ხარისხს გაცილებით ნაკლები გამოთვლითი რესურსებით. MoEs-ის მეშვეობით შესაძლებელია მოდელის ან მონაცემთა ნაკრების ზომის მნიშვნელოვნად გაზრდა მკვრივ მოდელებთან შედარებით, ერთი და იგივე ბიუჯეტის პირობებში, რაც უზრუნველყოფს უფრო სწრაფ წინასწარ წვრთნას. სტატია განმარტავს MoE-ის კონცეფციას ტრანსფორმერული მოდელების კონტექსტში, განიხილავს მის შემადგენელ ნაწილებს (კარიბჭის ქსელი
მოდით, ჩავუღრმავდეთ! მოდელის მასშტაბი მოდელის უკეთესი ხარისხისთვის ერთ-ერთი უმნიშვნელოვანესი ღერძია. ფიქსირებული გამოთვლითი ბიუჯეტის პირობებში, დიდი მოდელის ნაკლები ნაბიჯით წვრთნა უკეთესია, ვიდრე მცირე მოდელის მეტი ნაბიჯით წვრთნა. ექსპერტთა ნაზავი (MoEs) საშუალებას აძლევს მოდელებს, გაიარონ წინასწარი წვრთნა გაცილებით ნაკლები გამოთვლითი რესურსით, რაც ნიშნავს, რომ მკვრივ მოდელებთან შედარებით იგივე გამოთვლითი ბიუჯეტით შეგიძლიათ მნიშვნელოვნად გაზარდოთ მოდელის ან მონაცემთა ნაკრების ზომა. კერძოდ, MoE მოდელმა წინასწარი წვრთნისას გაცილებით სწრაფად უნდა მიაღწიოს იგივე ხარისხს, რასაც მისი მკვრივი ექვივალენტი.
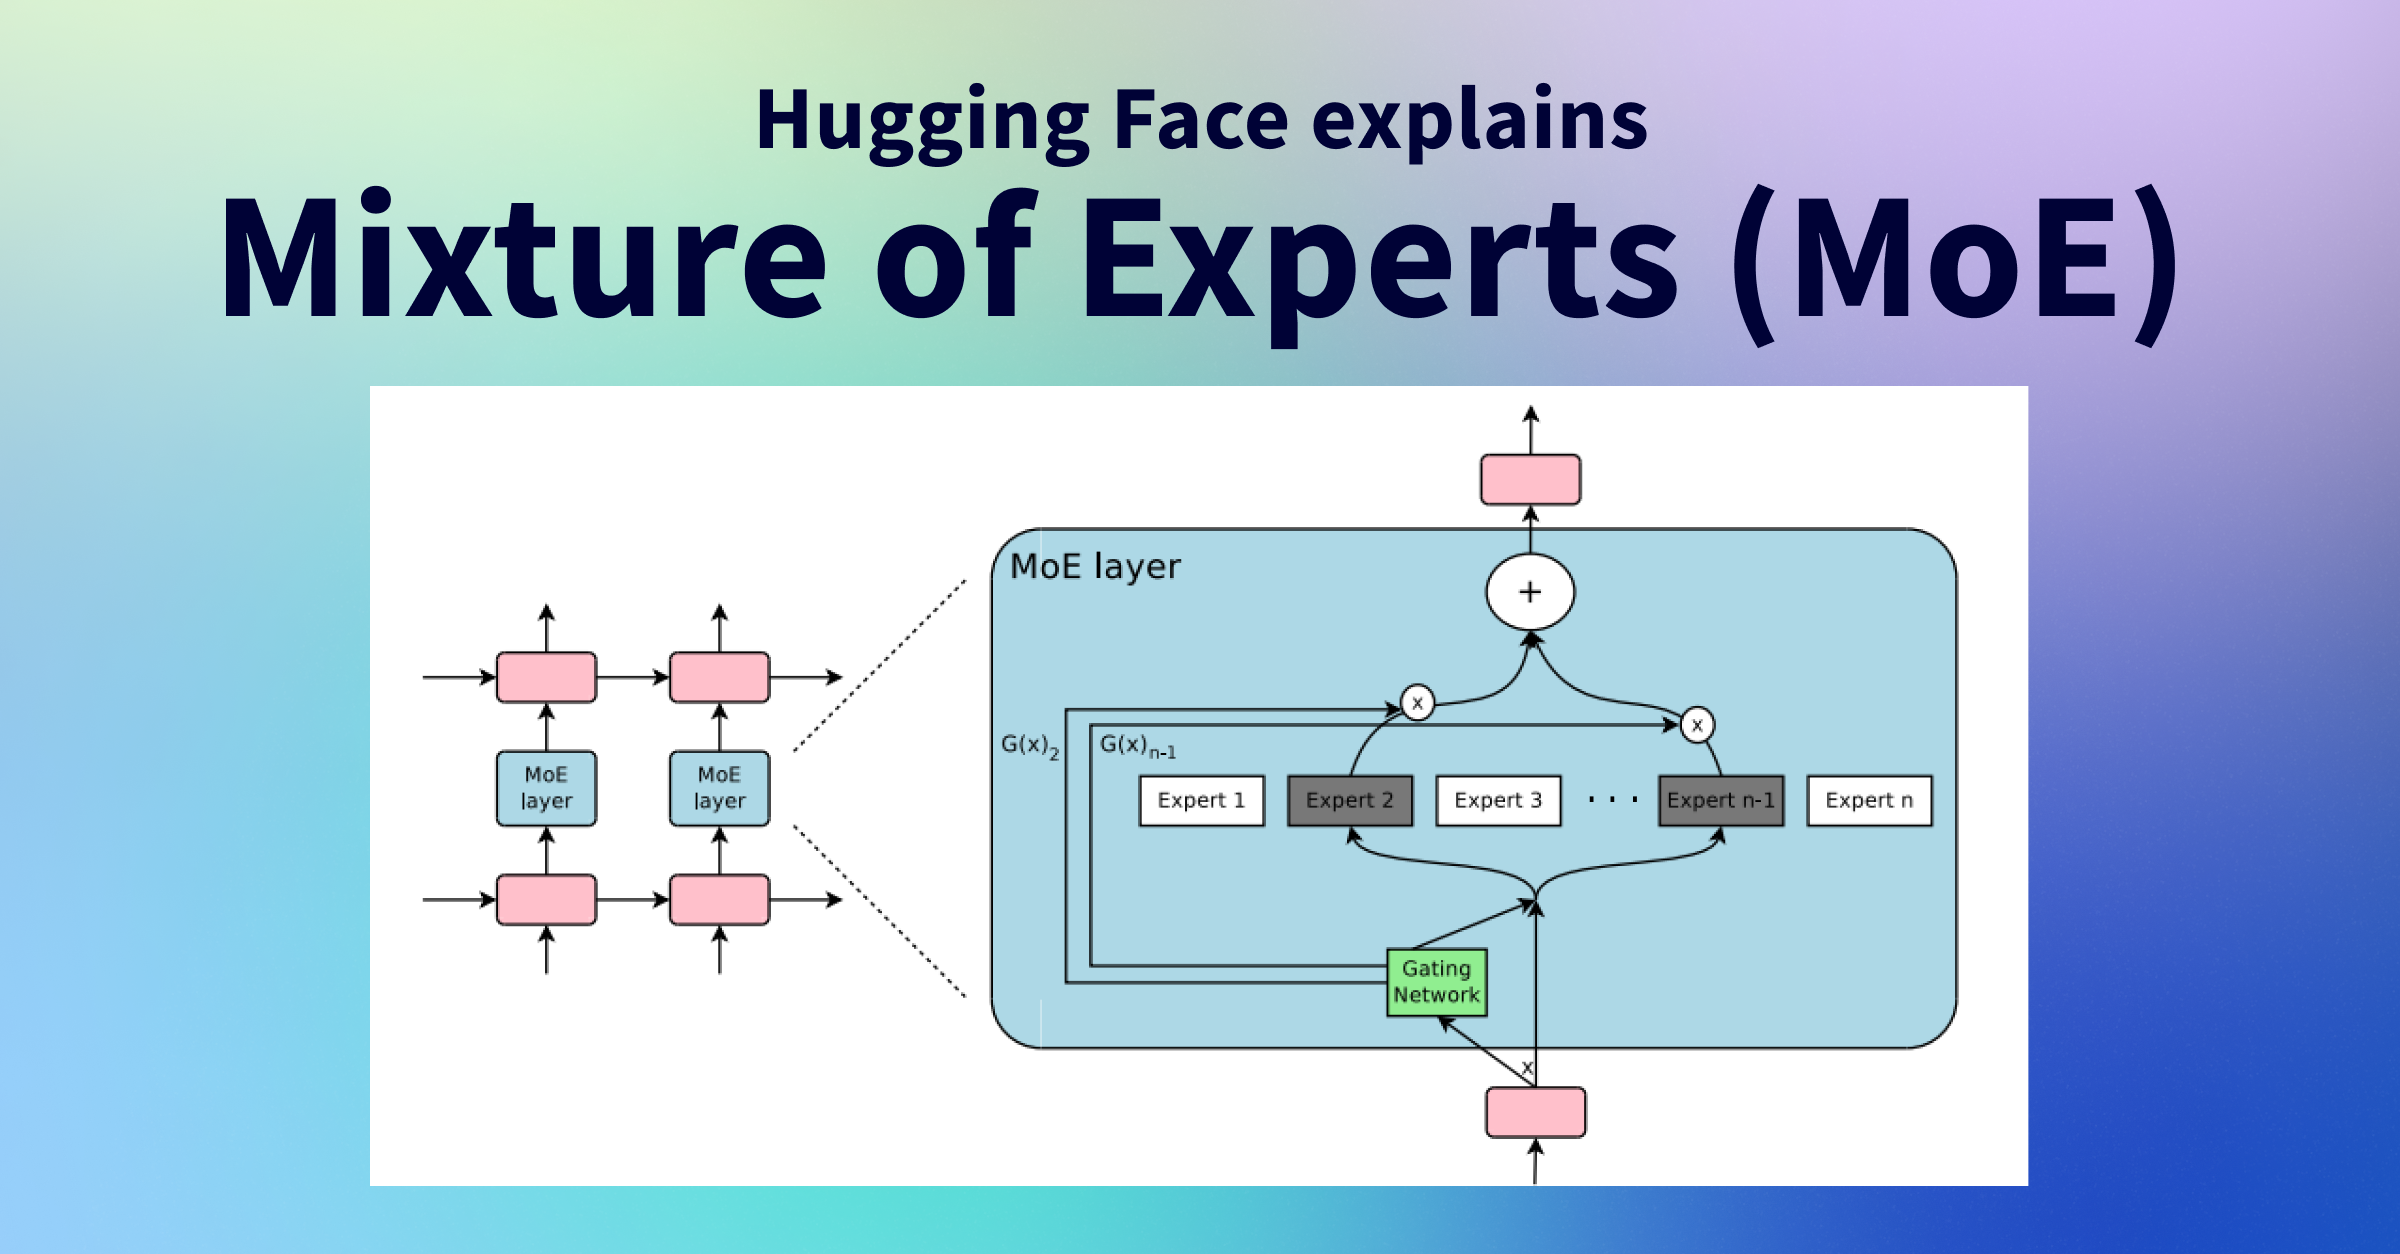
მაშ, რა არის ზუსტად MoE? ტრანსფორმერული მოდელების კონტექსტში, MoE შედგება ორი ძირითადი ელემენტისგან: მოკლედ, MoEs-ში ჩვენ ვცვლით ტრანსფორმერული მოდელის ყველა FFN ფენას MoE ფენით, რომელიც შედგება კარიბჭის ქსელისა და გარკვეული რაოდენობის ექსპერტებისგან. მიუხედავად იმისა, რომ MoEs გვთავაზობს ისეთ უპირატესობებს, როგორიცაა ეფექტური წინასწარი წვრთნა და უფრო სწრაფი ინფერენცია მკვრივ მოდელებთან შედარებით, მათ ასევე მოჰყვებათ გამოწვევები:
ახლა, როცა MoE-ის ზოგადი წარმოდგენა გვაქვს, მოდით, გადავხედოთ კვლევებს, რომლებმაც მათ გამოგონებამდე მიგვიყვანა. MoEs-ის ფესვები 1991 წლის ნაშრომიდან "Adaptive Mixture of Local Experts" მოდის. იდეა, რომელიც ანსამბლურ მეთოდებს ჰგავს, მდგომარეობდა ცალკეული ქსელებისგან შემდგარი სისტემისთვის ზედამხედველობის ქვეშ მყოფი პროცედურის ქონაში, სადაც თითოეული ქსელი წვრთნის შემთხვევების განსხვავებულ ქვეჯგუფს ამუშავებს. თითოეული ცალკეული ქსელი, ანუ ექსპერტი, სპეციალიზდება შეყვანის სივრცის განსხვავებულ რეგიონში. როგორ ირჩევა ექსპერტი? კარიბჭის ქსელი განსაზღვრავს წონებს თითოეული ექსპერტისთვის. წვრთნის დროს, როგორც ექსპერტი, ისე კარიბჭე, გადიან წვრთნას. 2010-2015 წლებში, ორი განსხვავებული კვლევითი სფერო დაეხმარა MoE-ის შემდგომ განვითარებას:
ამ ნაშრომებმა გამოიწვია ექსპერტთა ნაზავის შესწავლა ბუნებრივი ენის დამუშავების (NLP) კონტექსტში. კონკრეტულად, შაზეერმა და სხვ. (2017, „და სხვ.“ მოიცავს ჯეფრი ჰინტონსა და ჯეფ დინს, Google-ის ჩაკ ნორისს) ეს იდეა 137 მილიარდიან LSTM-ზე (იმ დროის de-facto NLP არქიტექტურა, შექმნილი შმიდჰუბერის მიერ) მასშტაბირება მოახდინა იშვიათობის შემოტანით, რამაც საშუალება მისცა შეენარჩუნებინათ ძალიან სწრაფი ინფერენცია მაღალ მასშტაბზეც კი. ეს ნაშრომი თარგმანზე იყო ფოკუსირებული, მაგრამ მრავალი გამოწვევის წინაშე დადგა, როგორიცაა მაღალი საკომუნიკაციო ხარჯები და წვრთნის არასტაბილურობა.
MoEs-მა შესაძლებელი გახადა მრავალ ტრილიონიანი პარამეტრის მქონე მოდელების წვრთნა, როგორიცაა ღია კოდის 1.6 ტრილიონიანი პარამეტრის Switch Transformers, სხვათა შორის. MoEs ასევე შესწავლილია კომპიუტერულ ხედვაში, მაგრამ ეს ბლოგპოსტი ფოკუსირებული იქნება NLP სფეროზე. იშვიათობა იყენებს პირობითი გამოთვლის იდეას. მაშინ როცა მკვრივ მოდელებში ყველა პარამეტრი გამოიყენება ყველა შეყვანისთვის, იშვიათობა საშუალებას გვაძლევს მხოლოდ სისტემის ზოგიერთი ნაწილის გაშვებას. მოდით, უფრო ღრმად ჩავუღრმავდეთ შაზეერის კვლევას MoEs-ის თარგმანისთვის გამოყენების შესახებ.
პირობითი გამოთვლის იდეა (ქსელის ნაწილები აქტიურია ყოველი მაგალითისთვის ინდივიდუალურად) საშუალებას აძლევს მოდელის ზომის მასშტაბირებას გამოთვლების გაზრდის გარეშე, რამაც გამოიწვია ათასობით ექსპერტის გამოყენება თითოეულ MoE ფენაში. ეს წყობა წარმოშობს ზოგიერთ გამოწვევას. მაგალითად, მიუხედავად იმისა, რომ დიდ პაკეტურ ზომებს (batch sizes) ჩვეულებრივ უკეთესი წარმადობა აქვს, MoEs-ში პაკეტური ზომები ეფექტურად მცირდება, რადგან მონაცემები აქტიური ექსპერტების გავლით მიედინება. მაგალითად, თუ ჩვენი პაკეტური შეყვანა შედგება 10 ტოკენისგან, ხუთი ტოკენი შეიძლება ერთ ექსპერტთან აღმოჩნდეს, ხოლო დანარჩენი ხუთი ტოკენი შეიძლება ხუთ სხვადასხვა ექსპერტთან აღმოჩნდეს, რაც იწვევს არათანაბარ პაკეტურ ზომებს და არასრულყოფილ გამოყენებას. ქვემოთ მოცემული სექცია „როგორ ავამუშაოთ MoEs სრული სიმძლავრით“ განიხილავს სხვა გამოწვევებსა და გადაწყვეტილებებს.
როგორ შეგვიძლია ამის გადაჭრა? ნასწავლი კარიბჭის ქსელი (G) წყვეტს, თუ რომელ ექსპერტებს (E) გაუგზავნოს შეყვანის ნაწილი:
$y=\sum_{i=1}^{n}G(x)_iE_i(x)$
ამ წყობაში, ყველა ექსპერტი მუშაობს ყველა შეყვანისთვის - ეს არის შეწონილი გამრავლება. მაგრამ, რა მოხდება, თუ G არის 0? ამ შემთხვევაში, არ არის საჭირო შესაბამისი ექსპერტის ოპერაციების გამოთვლა და, შესაბამისად, ჩვენ ვზოგავთ გამოთვლებს. რა არის ტიპური კარიბჭის ფუნქცია? ყველაზე ტრადიციულ წყობაში, ჩვენ უბრალოდ ვიყენებთ მარტივ ქსელს softmax ფუნქციით. ქსელი ისწავლის, რომელ ექსპერტს გაუგზავნოს შეყვანა.
$G_\sigma(x) = \text{Softmax}(x \cdot W_g)$
შაზეერის ნაშრომში ასევე შესწავლილია სხვა კარიბჭის მექანიზმები, როგორიცაა ხმაურიანი Top-k კარიბჭე (Noisy Top-k Gating). ეს კარიბჭის მიდგომა შემოაქვს გარკვეულ (კონფიგურირებად) ხმაურს და შემდეგ ინარჩუნებს Top k მნიშვნელობებს. ანუ:
$H(x)_i = (x \cdot W_{\text{g}})_i + \text{StandardNormal()} \cdot \text{Softplus}((x \cdot W_{\text{noise}})_i)$
$\text{KeepTopK}(v, k)_i = \begin{cases}
v_i & \text{if } v_i \text{ is in the top } k \text{ elements of } v, \\
-\infty & \text{otherwise.}
\end{cases}$
$G(x) = \text{Softmax}(\text{KeepTopK}(H(x), k))$
ეს იშვიათობა წარმოშობს რამდენიმე საინტერესო თვისებას. საკმარისად მცირე k-ის (მაგალითად, ერთი ან ორი) გამოყენებით, ჩვენ შეგვიძლია წვრთნა და ინფერენციის გაშვება ბევრად უფრო სწრაფად, ვიდრე მრავალი ექსპერტის გააქტიურების შემთხვევაში. რატომ არ?
თეგები:
#ხელოვნური ინტელექტი
#მანქანური სწავლება
#ტრანსფორმერები
#ღრმა სწავლება
#nlp
#moes
#იშვიათი მოდელები
#პირობითი გამოთვლა
წყარო: huggingface.co
AI-ით გადამუშავებული
მსგავსი სტატიები

ხელოვნური ინტელექტი
Anthropic-ის Claude-ის აღზევება Apple App Store-ის რეიტინგებში პენტაგონთან მოლაპარაკებების ფონზე

ხელოვნური ინტელექტი
ტრამპის ადმინისტრაცია Anthropic-ს სანქციებს უწესებს ხელოვნური ინტელექტის გამოყენებაზე უარის გამო: ექსპერტი ინდუსტრიის უსაფრთხოების ხარვეზებზე საუბრობს
ხელოვნური ინტელექტი