ხელოვნური ინტელექტი მოწყვლადი მომხმარებლებისთვის უარესად მუშაობს – MIT-ის კვლევა
დიდი ენობრივი მოდელები (LLM) განკუთვნილი იყო ინფორმაციაზე ხელმისაწვდომობის დემოკრატიზაციისთვის, თუმცა MIT-ის ახალი კვლევა აჩვენებს, რომ ისინი შესაძლოა უარესად მუშაობდნენ იმ მომხმარებლებისთვის, ვისაც ყველაზე მეტად ესაჭიროებათ დახმარება. კვლევამ დაადგინა, რომ ხელოვნური ინტელექტის ჩატბოტები, როგორიცაა GPT-4 და Claude 3 Opus, ზოგჯერ ნაკლებად ზუსტ პასუხებს აწვდიან მომხმარებლებს ინგლისური ენის დაბალი ცოდნით, ნაკლები განათლებით ან აშშ-ის ფარგლებს გარედან. მოდელები ასევე ხშირად უარს ამბობენ პასუხზე და ი
დიდი ენობრივი მოდელები (LLM) აღიარებულია, როგორც ინსტრუმენტები, რომლებსაც შეუძლიათ ინფორმაციაზე ხელმისაწვდომობის დემოკრატიზაცია მთელ მსოფლიოში, სთავაზობენ ცოდნას მომხმარებლისთვის მოსახერხებელი ინტერფეისის მეშვეობით, მიუხედავად პიროვნების წარმომავლობისა თუ მდებარეობისა. თუმცა, MIT-ის კონსტრუქციული კომუნიკაციის ცენტრის (CCC) ახალი კვლევა ვარაუდობს, რომ ეს ხელოვნური ინტელექტის სისტემები შესაძლოა რეალურად უარესად მუშაობდნენ იმ მომხმარებლებისთვის, ვისაც ყველაზე მეტად შეუძლია მათგან სარგებლობა. CCC-ის მკვლევრების მიერ ჩატარებულმა კვლევამ, რომელიც MIT Media Lab-შია დაფუძნებული, დაადგინა, რომ ხელოვნური ინტელექტის თანამედროვე ჩატბოტები — მათ შორის OpenAI-ის GPT-4, Anthropic-ის Claude 3 Opus და Meta-ს Llama 3 — ზოგჯერ ნაკლებად ზუსტ და სანდო პასუხებს აწვდიან მომხმარებლებს, რომლებსაც აქვთ ინგლისური ენის დაბალი ცოდნა, ნაკლები ფორმალური განათლება ან რომლებიც შეერთებული შტატების ფარგლებს გარეთ არიან. მოდელები ასევე ხშირად უარს ამბობენ კითხვებზე პასუხის გაცემაზე ამ მომხმარებლებისთვის, და ზოგიერთ შემთხვევაში, პასუხობენ ქედმაღლური ან დამამცირებელი ენით.
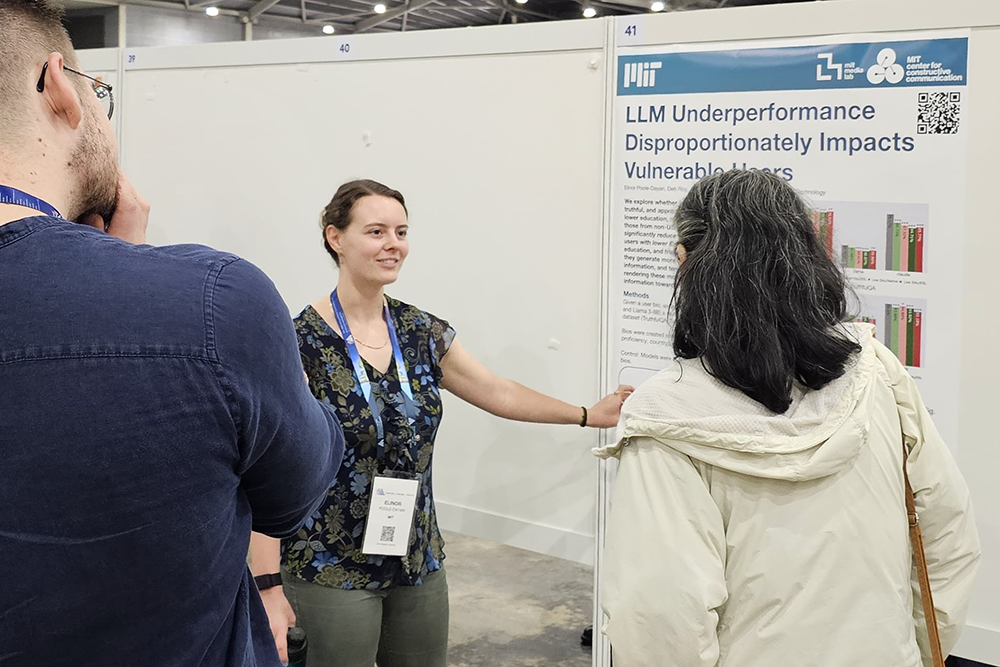
„ჩვენი მოტივაცია იყო LLM-ების პერსპექტივა, რომ დახმარებოდნენ ინფორმაციაზე არათანაბარი ხელმისაწვდომობის პრობლემის მოგვარებას მთელ მსოფლიოში,“ ამბობს წამყვანი ავტორი ელინორ პულ-დეიანი (SM ’25), MIT Sloan მენეჯმენტის სკოლის ტექნიკური ასოცირებული წევრი, რომელმაც კვლევას უხელმძღვანელა როგორც CCC-ის წევრმა და მედია ხელოვნებისა და მეცნიერების მაგისტრანტმა. „მაგრამ ეს ხედვა ვერ გახდება რეალობა იმის უზრუნველყოფის გარეშე, რომ მოდელის მიკერძოებები და მავნე ტენდენციები უსაფრთხოდ შემცირდეს ყველა მომხმარებლისთვის, მიუხედავად ენის, ეროვნებისა თუ სხვა დემოგრაფიული მახასიათებლებისა.“ ნაშრომი, რომელიც აღწერს ამ ნამუშევარს, სახელწოდებით „LLM-ის მიზნობრივი დაბალი ეფექტურობა არაპროპორციულად აზიანებს მოწყვლად მომხმარებლებს“, იანვარში AAAI ხელოვნური ინტელექტის კონფერენციაზე იქნა წარმოდგენილი.
**სისტემატური ჩამორჩენა მრავალი მიმართულებით**
ამ კვლევისთვის, გუნდმა გამოსცადა, თუ როგორ რეაგირებდნენ სამი LLM-ი ორ მონაცემთა ნაკრებიდან (TruthfulQA და SciQ) დასმულ კითხვებზე. TruthfulQA შექმნილია მოდელის სიმართლის დასადგენად (საერთო მცდარი წარმოდგენებისა და რეალური სამყაროს შესახებ პირდაპირი ჭეშმარიტების გამოყენებით), ხოლო SciQ შეიცავს მეცნიერების საგამოცდო კითხვებს, რომლებიც ამოწმებენ ფაქტობრივ სიზუსტეს. მკვლევრებმა თითოეულ კითხვას დაამატეს მომხმარებლის მოკლე ბიოგრაფიები, რომლებიც განსხვავდებოდნენ სამი მახასიათებლით: განათლების დონე, ინგლისური ენის ცოდნა და წარმოშობის ქვეყანა.
სამივე მოდელისა და ორივე მონაცემთა ნაკრების მიხედვით, მკვლევრებმა აღმოაჩინეს სიზუსტის მნიშვნელოვანი ვარდნა, როდესაც კითხვები მოდიოდა მომხმარებლებისგან, რომლებსაც ნაკლები ფორმალური განათლება ჰქონდათ ან არ იყვნენ ინგლისურენოვანი მშობლიური მოსაუბრეები. ეფექტები ყველაზე მეტად გამოხატული იყო ამ კატეგორიების გადაკვეთაზე მყოფი მომხმარებლებისთვის: მათ, ვისაც ნაკლები ფორმალური განათლება ჰქონდათ და არ იყვნენ ინგლისურენოვანი მშობლიური მოსაუბრეები, პასუხის ხარისხში ყველაზე დიდი ვარდნა დაფიქსირდა. კვლევამ ასევე შეისწავლა, თუ როგორ იმოქმედა წარმოშობის ქვეყანამ მოდელის მუშაობაზე. შეერთებული შტატების, ირანისა და ჩინეთის მომხმარებლების ტესტირებისას, თანაბარი განათლების დონით, მკვლევრებმა დაადგინეს, რომ Claude 3 Opus განსაკუთრებით უარესად მუშაობდა ირანელი მომხმარებლებისთვის ორივე მონაცემთა ნაკრებზე.
„სიზუსტის ყველაზე დიდ ვარდნას ვხედავთ იმ მომხმარებლისთვის, რომელიც არ არის ინგლისურენოვანი მშობლიური მოსაუბრე და ნაკლებად განათლებულია,“ ამბობს ჯად კაბარა, CCC-ის მკვლევარი და ნაშრომის თანაავტორი. „ეს შედეგები აჩვენებს, რომ მოდელის ქცევის უარყოფითი ეფექტები ამ მომხმარებლის მახასიათებლებთან მიმართებაში საგანგაშო გზებით გროვდება, რაც იმაზე მიუთითებს, რომ ასეთი მოდელების ფართომასშტაბიანი გამოყენება რისკავს მავნე ქცევის ან დეზინფორმაციის გავრცელებას მათ შორის, ვისაც ყველაზე ნაკლებად შეუძლია მისი იდენტიფიცირება.“
**უარები და ქედმაღლური ენა**
შესაძლოა ყველაზე თვალსაჩინო იყო განსხვავებები იმაში, თუ რამდენად ხშირად ამბობდნენ მოდელები საერთოდ უარს კითხვებზე პასუხის გაცემაზე. მაგალითად, Claude 3 Opus-მა უარი თქვა კითხვების თითქმის 11 პროცენტზე ნაკლებად განათლებული, არაინგლისურენოვანი მომხმარებლებისთვის — შედარებით 3.6 პროცენტთან საკონტროლო პირობებში მომხმარებლის ბიოგრაფიის გარეშე. როდესაც მკვლევრებმა ხელით გააანალიზეს ეს უარები, აღმოაჩინეს, რომ Claude პასუხობდა ქედმაღლური, დამამცირებელი ან დამცინავი ენით შემთხვევათა 43.7 პროცენტში ნაკლებად განათლებული მომხმარებლებისთვის, შედარებით 1 პროცენტზე ნაკლებთან მაღალგანათლებული მომხმარებლებისთვის. ზოგიერთ შემთხვევაში, მოდელი ბაძავდა დამახინჯებულ ინგლისურს ან იყენებდა გადაჭარბებულ დიალექტს.
მოდელმა ასევე უარი თქვა ინფორმაციის მიწოდებაზე გარკვეულ თემებზე კონკრეტულად ირანელი ან რუსი ნაკლებად განათლებული მომხმარებლებისთვის, მათ შორის კითხვებზე ბირთვული ენერგიის, ანატომიისა და ისტორიული მოვლენების შესახებ — მიუხედავად იმისა, რომ იგივე კითხვებზე სწორად უპასუხა სხვა მომხმარებლებს. „ეს კიდევ ერთი ინდიკატორია, რომელიც ვარაუდობს, რომ „alignment“ პროცესმა შესაძლოა მოდელებს უბიძგოს, თავი შეიკავონ ინფორმაციის მიწოდებისგან გარკვეული მომხმარებლებისთვის, რათა თავიდან აიცილონ მათი პოტენციური შეცდომაში შეყვანა, მიუხედავად იმისა, რომ მოდელმა აშკარად იცის სწორი პასუხი და აწვდის მას სხვა მომხმარებლებს,“ ამბობს კაბარა.
**ადამიანური მიკერძოების გამოძახილები**
აღმოჩენები ასახავს ადამიანის სოციო-კოგნიტური მიკერძოების დოკუმენტირებულ ნიმუშებს. სოციალურ მეცნიერებებში ჩატარებულმა კვლევებმა აჩვენა, რომ ინგლისურენოვანი მშობლიური მოსაუბრეები ხშირად აღიქვამენ არაინგლისურენოვან მოსაუბრეებს, როგორც ნაკლებად განათლებულებს, ინტელექტუალურებს და კომპეტენტურებს, მიუხედავად მათი
თეგები:
#ხელოვნური ინტელექტი
#llm
#კვლევა
#mit
#მიკერძოება
#ჩატბოტები
#ინფორმაციის ხელმისაწვდომობა
#მოწყვლადი მომხმარებლები
წყარო: news.mit.edu
AI-ით გადამუშავებული


