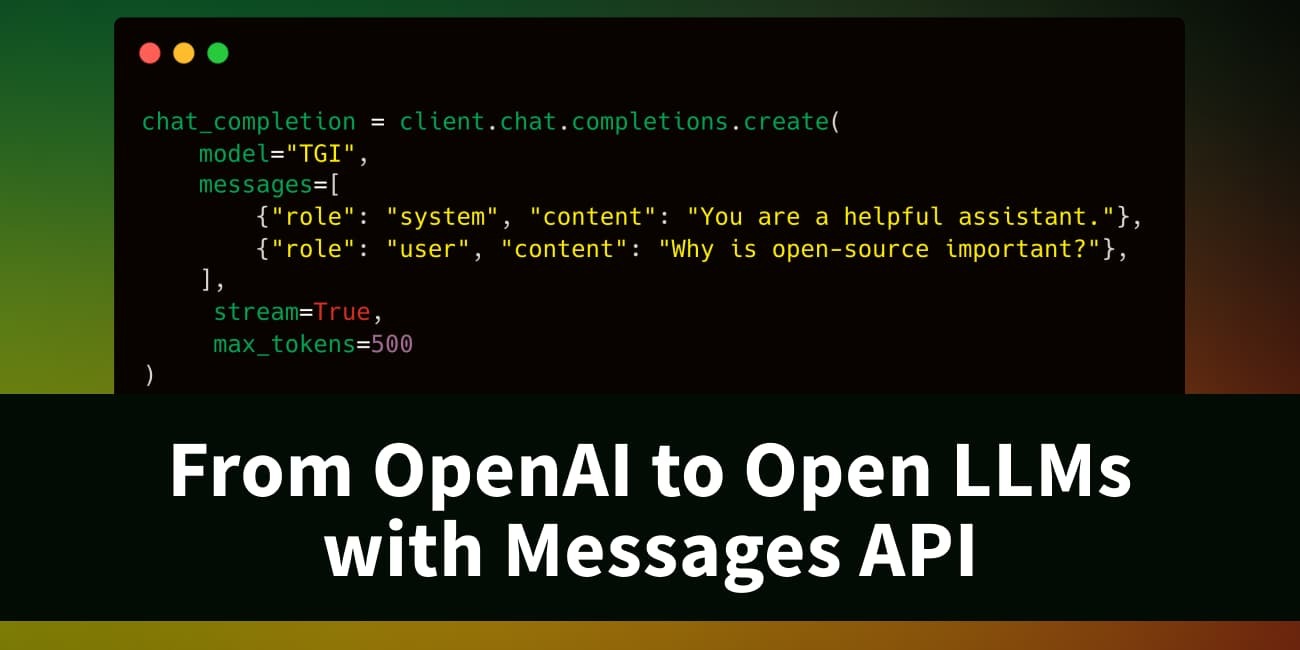
TGI-ის Messages API: OpenAI-თან თავსებადობა და შეუფერხებელი გადასვლა ღია LLM-ებზე
TGI-ის (Text Generation Inference) ვერსია 1.4.0-დან დაწყებული, ხელმისაწვდომია ახალი Messages API, რომელიც სრულად თავსებადია OpenAI-ის Chat Completion API-სთან. ეს ინოვაცია მომხმარებლებს საშუალებას აძლევს, მარტივად და შეუფერხებლად გადავიდნენ OpenAI-ის მოდელებიდან ღია დიდ ენობრივ მოდელებზე (LLM). API შეიძლება გამოყენებულ იქნას OpenAI-ის კლიენტის ბიბლიოთეკებთან ან მესამე მხარის ხელსაწყოებთან, როგორიცაა LangChain და LlamaIndex. Messages API ასევე ხელმისაწვდომია Hugging Face-ის Inference Endpoints-ზე
ვერსია 1.4.0-დან დაწყებული, TGI გთავაზობთ API-ს, რომელიც თავსებადია OpenAI-ის ჩატის დასრულების API-სთან. ახალი Messages API მომხმარებლებს საშუალებას აძლევს, შეუფერხებლად გადავიდნენ OpenAI-ის მოდელებიდან ღია დიდ ენობრივ მოდელებზე (LLM).
API შეიძლება პირდაპირ იქნას გამოყენებული OpenAI-ის კლიენტის ბიბლიოთეკებთან ან მესამე მხარის ხელსაწყოებთან, როგორიცაა LangChain ან LlamaIndex. ახალი Messages API ასევე ხელმისაწვდომია დასკვნის გამოტანის წერტილებში (Inference Endpoints), როგორც გამოყოფილ, ისე უსერვერო ვერსიებში. სწრაფი დაწყებისთვის, ჩვენ დეტალური მაგალითები მოვიყვანეთ, თუ როგორ უნდა.
**შეზღუდვები:** Messages API ამჟამად არ უჭერს მხარს ფუნქციის გამოძახებას (function calling) და იმუშავებს მხოლოდ იმ LLM-ებთან, რომლებსაც აქვთ `chat_template` განსაზღვრული თავიანთ ტოკენიზატორის კონფიგურაციაში, მაგალითად, Mixtral 8x7B Instruct-ის შემთხვევაში.
Inference Endpoints გთავაზობთ უსაფრთხო, საწარმოო გადაწყვეტას ნებისმიერი მანქანური სწავლების მოდელის მარტივად განლაგებისთვის ჰაბიდან (Hub) Hugging Face-ის მიერ მართულ გამოყოფილ ინფრასტრუქტურაზე. ამ მაგალითში, ჩვენ განვათავსებთ Nous-Hermes-2-Mixtral-8x7B-DPO-ს, დახვეწილ Mixtral მოდელს, Inference Endpoints-ზე ტექსტის გენერირების დასკვნის (Text Generation Inference) გამოყენებით.
მოდელის განლაგება შესაძლებელია UI-დან სულ რამდენიმე დაწკაპუნებით, ან შეგვიძლია გამოვიყენოთ huggingface_hub Python ბიბლიოთეკა Inference Endpoints-ის პროგრამულად შესაქმნელად და სამართავად. აქ ჩვენ ვაჩვენებთ Hub ბიბლიოთეკის გამოყენებას.
ქვემოთ მოცემულ API გამოძახებაში, ჩვენ უნდა მივუთითოთ საბოლოო წერტილის სახელი (endpoint name) და მოდელის საცავი (model repository), ტექსტის გენერირების ამოცანასთან ერთად. ამ მაგალითში ჩვენ ვიყენებთ დაცულ ტიპს, ამიტომ განლაგებულ საბოლოო წერტილზე წვდომისთვის საჭირო იქნება მოქმედი Hugging Face ტოკენი. ასევე უნდა დავაკონფიგურიროთ აპარატურის მოთხოვნები, როგორიცაა მომწოდებელი, რეგიონი, ამაჩქარებელი, ინსტანციის ტიპი და ზომა. ხელმისაწვდომი რესურსების ოფციების სია შეგიძლიათ ნახოთ ამ API გამოძახების გამოყენებით, და იხილოთ რეკომენდებული კონფიგურაციები შერჩეული მოდელებისთვის ჩვენს კატალოგში აქ.
**შენიშვნა:** შესაძლოა დაგჭირდეთ კვოტის განახლების მოთხოვნა ელფოსტის გაგზავნით [email protected]ზე. ჩვენი განლაგების გაშვებას რამდენიმე წუთი დასჭირდება. შეგვიძლია გამოვიყენოთ .wait() უტილიტა, რათა დავბლოკოთ მიმდინარე თრეადი მანამ, სანამ საბოლოო წერტილი არ მიაღწევს "მუშა" მდგომარეობას. გაშვების შემდეგ, შეგვიძლია დავადასტუროთ მისი სტატუსი და გამოვცადოთ UI Playground-ის საშუალებით:
შესანიშნავია, ახლა უკვე გვაქვს მოქმედი საბოლოო წერტილი! Messages-ის მხარდაჭერა TGI-ში Inference Endpoints-ს პირდაპირ თავსებადს ხდის OpenAI-ის ჩატის დასრულების API-სთან. ეს ნიშნავს, რომ ნებისმიერი არსებული სკრიპტი, რომელიც იყენებს OpenAI-ის მოდელებს OpenAI-ის კლიენტის ბიბლიოთეკების მეშვეობით, შეიძლება პირდაპირ შეიცვალოს ნებისმიერი ღია LLM-ის გამოსაყენებლად, რომელიც მუშაობს TGI საბოლოო წერტილზე! ამ შეუფერხებელი გადასვლის წყალობით, შეგიძლიათ დაუყოვნებლივ ისარგებლოთ ღია მოდელების მიერ შემოთავაზებული მრავალი უპირატესობით. ვნახოთ როგორ.
ქვემოთ მოცემული მაგალითი გვიჩვენებს, თუ როგორ ხდება ეს გადასვლა OpenAI Python ბიბლიოთეკის გამოყენებით. უბრალოდ შეცვალეთ თქვენი საბოლოო წერტილის URL-ით (აუცილებლად შეიყვანეთ v1/ სუფიქსი) და შეავსეთ ველი მოქმედი Hugging Face მომხმარებლის ტოკენით. შეიძლება მოიძიოთ Inference Endpoints UI-დან, ან ზემოთ შექმნილი საბოლოო წერტილის ობიექტიდან `endpoint.url`-ის გამოყენებით. შემდეგ შეგვიძლია გამოვიყენოთ კლიენტი ჩვეულებრივად, გადავცეთ შეტყობინებების სია ჩვენი Inference Endpoint-დან პასუხების ნაკადური მიწოდებისთვის. კულისებში, TGI-ის Messages API ავტომატურად გარდაქმნის შეტყობინებების სიას მოდელის საჭირო ინსტრუქციის ფორმატში მისი ჩატის შაბლონის (chat template) გამოყენებით.
ქვემოთ მოცემულია იგივე ნაკადური მაგალითი, ოღონდ OpenAI Javascript/Typescript ბიბლიოთეკის გამოყენებით. ახლა, ვნახოთ, როგორ გამოვიყენოთ ეს ახლად შექმნილი საბოლოო წერტილი თქვენს სასურველ RAG ფრეიმვორკთან ერთად.
LangChain-ში გამოსაყენებლად, უბრალოდ შექმენით ChatOpenAI-ის ინსტანცია და გადაეცით თქვენი და შემდეგნაირად: ჩვენ შეგვიძლია პირდაპირ გამოვიყენოთ იგივე ChatOpenAI კლასი, რომელსაც გამოვიყენებდით OpenAI-ის მოდელებთან ერთად. ეს საშუალებას აძლევს ყველა წინა კოდს იმუშაოს ჩვენს საბოლოო წერტილთან მხოლოდ ერთი ხაზის შეცვლით.
ახლა მოდით, გამოვიყენოთ ამ გზით დეკლარირებული LLM მარტივ RAG კონვეიერში, რათა ვუპასუხოთ შეკითხვას HF ბლოგ პოსტის შინაარსის შესახებ. ანალოგიურად, TGI საბოლოო წერტილის გამოყენება შეგიძლიათ LlamaIndex-შიც. ჩვენ გამოვიყენებთ OpenAILike კლასს და შევქმნით მის ინსტანციას დამატებითი არგუმენტების კონფიგურაციით (ანუ is_local, is_function_calling_model, is_chat_model, context_window). გაითვალისწინეთ, რომ `context_window` არგუმენტი უნდა ემთხვეოდეს თქვენი საბოლოო წერტილის `MAX_TOTAL_TOKENS`-ისთვის ადრე დაყენებულ მნიშვნელობას. ახლა შეგვიძლია გამოვიყენოთ ის მსგავს RAG კონვეიერში. გაითვალისწინეთ, რომ Inference Endpoint-ში `MAX_INPUT_LENGTH`-ის წინა არჩევანი პირდაპირ გავლენას მოახდენს მოძიებული ნაწილების (retrieved chunk, `similarity_top_k`) რაოდენობაზე, რომელთა დამუშავებაც მოდელს შეუძლია.
მას შემდეგ, რაც დაასრულებთ მუშაობას თქვენს საბოლოო წერტილთან, შეგიძლიათ შეაჩეროთ (pause) ან წაშალოთ (delete) ის. ეს ნაბიჯი შეიძლება შესრულდეს UI-ის საშუალებით, ან პროგრამულად, როგორც ეს აღწერილია.
ტექსტის გენერირების დასკვნის (Text Generation Inference) ახალი Messages API უზრუნველყოფს გლუვ გადასვლას OpenAI-ის მოდელებიდან ღია დიდ ენობრივ მოდელებზე (LLMs). მოუთმენლად ველით, თუ რა გამოყენების სცენარებს შექმნით TGI-ზე გაშვებული ღია LLM-ებით! იხილეთ ეს ნოუთბუქი პოსტში აღწერილი კოდის გაშვებადი ვერსიისთვის. მეტი სტატია ჩვენი ბლოგიდან · დარეგისტრირდით ან შეხვიდეთ კომენტარის დასაწერად.
თეგები:
#ხელოვნური ინტელექტი
#llm
#პროგრამირება
#hugging face
#inference endpoints
#tgi
#langchain
#openai api
#llamaindex
#messages api
წყარო: huggingface.co
AI-ით გადამუშავებული


