Hugging Face-ის TGI წარმოგიდგენთ ახალ Backends არქიტექტურას: გამარტივებული LLM-ების განთავსება და გაუმჯობესებული წარმადობა
Hugging Face-მა წარმოადგინა TGI Backends, ახალი არქიტექტურა Text-Generation-Inference (TGI)-ისთვის, რომელიც მიზნად ისახავს LLM-ების განთავსების პროცესის გამარტივებას და ოპტიმალური წარმადობის უზრუნველყოფას. ეს სიახლე აერთიანებს სხვადასხვა ინფერენსინგის გადაწყვეტებს ერთიან ფრონტენდ ფენაში, რაც მომხმარებლებს საშუალებას აძლევს მარტივად შეცვალონ ბეკენდები მათი მოდელირების, აპარატურის და წარმადობის მოთხოვნების შესაბამისად.

TGI ახლა პირდაპირ მხარს უჭერს Intel Gaudi აპარატურას
გაცხადდა Intel Gaudi აპარატურის სრული ინტეგრაცია TGI-ის ძირითად კოდბაზაში, რაც გამორიცხავს ცალკეული „ფორკების“ საჭიროებას. ეს ახალი მრავალბექენდური არქიტექტურა ამარტივებს გამოყენებას, უზრუნველყოფს TGI-ის უახლეს ფუნქციებზე წვდომას და ოპტიმიზაციას უკეთებს დიდი ენობრივი მოდელების (LLMs) მუშაობას Gaudi მოწყობილობებზე. განცხადება ასევე ხაზს უსვამს მოწინავე ფუნქციებს, მოსალოდნელ მოდელებს და საზოგადოებისგან უკუკავშირის მიღების მოწვევას.

LLM ინფერენციის სამართლიანი დაგეგმვა: გამოწვევები და გადაწყვეტები
სტატია მიმოიხილავს LLM ინფერენციის ძრავებში (მაგ. vLLM, HuggingFace TGI) სამართლიანი დაგეგმვის გამოწვევებს, სადაც GPU-ზე ჯგუფური დამუშავება ეფექტურია, თუმცა ერთი მომხმარებელი ხშირად მონოპოლიზებს ბექენდის რიგს. TNG-ის მიერ შემოთავაზებული გადაწყვეტა მოიცავს ცალკე API სერვერს ("LLM-სერვერს"), რომელიც მართავს მოთხოვნებს ინფერენციის ძრავამდე. ეს სერვერი იყენებს თითოეული მომხმარებლისთვის ცალკეულ რიგებს და "მრგვალი მაგიდის" (round-robin) პრინციპით დაგეგმვას სამართლიანობისთვის. ის ასევე ითვალისწინებს მო

Hugging Face AMD Instinct GPU-ების სრულყოფილ მხარდაჭერას აცხადებს ხელოვნური ინტელექტის მოდელებისთვის
AMD-ის უახლესი Instinct MI300 სერიის ამაჩქარებლების მოახლოებულ გამოშვებასთან ერთად, Hugging Face აძლიერებს AMD GPU-ების მხარდაჭერას, რაც მომხმარებლებს საშუალებას აძლევს, გაუშვან Transformers-ის ყველა მოდელი და ამოცანა კოდის ყოველგვარი ცვლილების გარეშე. თანამშრომლობა მოიცავს ინტეგრირებულ ტესტირებას, გარემოსდაცვითი კვალის მინიმიზაციას და მნიშვნელოვან წარმადობის გაუმჯობესებას, განსაკუთრებით დიდი ენობრივი მოდელებისთვის და ტექსტის გენერირების ინფერენციისთვის (TGI), სადაც AMD Instinct MI250 GPU აჭარბე
დიდი ენობრივი მოდელების (LLMs) მაღალეფექტური განთავსება: TGI და AWS Inferentia2 Amazon SageMaker-ში
ტექსტის გენერირების ინფერენცია (TGI) წარმოადგენს სპეციალურად შექმნილ გადაწყვეტას დიდი ენობრივი მოდელების (LLMs) მასშტაბური განთავსებისა და სერვისისთვის. TGI უზრუნველყოფს მაღალეფექტურ ტექსტის გენერაციას Tensor Parallelism-ისა და უწყვეტი დაჯგუფების გამოყენებით Llama-ს, Mistral-ის და სხვა პოპულარული ღია LLM-ებისთვის. AWS Inferentia2-თან ინტეგრაცია Amazon SageMaker-ში TGI-ს აქცევს მძლავრ ალტერნატივად GPU-ებისთვის LLM აპლიკაციების შესაქმნელად. ეს ინტეგრაცია ამარტივებს მოდელების განთავსებას და შენარჩუ
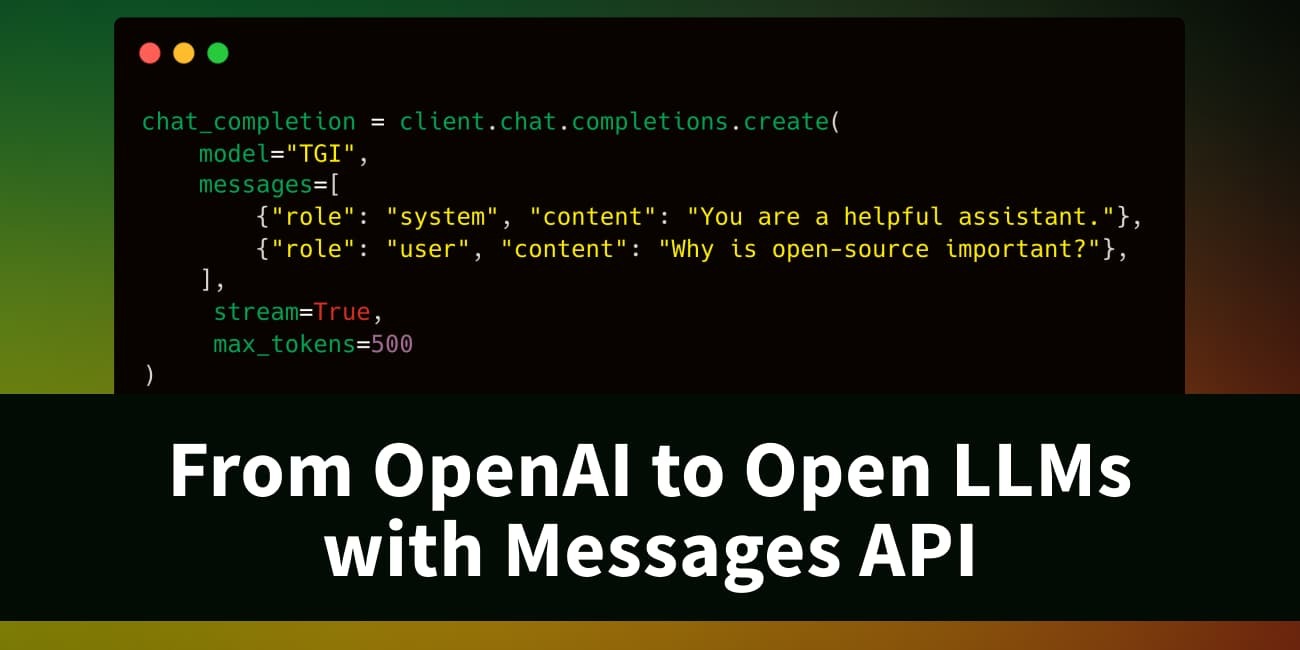
TGI-ის Messages API: OpenAI-თან თავსებადობა და შეუფერხებელი გადასვლა ღია LLM-ებზე
TGI-ის (Text Generation Inference) ვერსია 1.4.0-დან დაწყებული, ხელმისაწვდომია ახალი Messages API, რომელიც სრულად თავსებადია OpenAI-ის Chat Completion API-სთან. ეს ინოვაცია მომხმარებლებს საშუალებას აძლევს, მარტივად და შეუფერხებლად გადავიდნენ OpenAI-ის მოდელებიდან ღია დიდ ენობრივ მოდელებზე (LLM). API შეიძლება გამოყენებულ იქნას OpenAI-ის კლიენტის ბიბლიოთეკებთან ან მესამე მხარის ხელსაწყოებთან, როგორიცაა LangChain და LlamaIndex. Messages API ასევე ხელმისაწვდომია Hugging Face-ის Inference Endpoints-ზე
TGI-ის Messages API: უწყვეტი გადასვლა ღია LLM-ებზე OpenAI-ის თავსებადობით
TGI (Text Generation Inference) 1.4.0 ვერსიიდან მოყოლებული, გთავაზობთ Messages API-ს, რომელიც სრულად თავსებადია OpenAI-ის Chat Completion API-თან. ეს ინოვაცია მომხმარებლებს საშუალებას აძლევს, მარტივად და შეუფერხებლად გადავიდნენ OpenAI-ის მოდელებიდან ღია დიდი ენის მოდელებზე (LLM-ებზე), არსებული კლიენტის ბიბლიოთეკების ან მესამე მხარის ხელსაწყოების (როგორიცაა LangChain და LlamaIndex) გამოყენებით. სტატია დეტალურად აღწერს მოდელების Hugging Face Inference Endpoints-ზე განთავსების, ტექნიკური კონფიგურაც
Hugging Face-ი და AMD ხელოვნური ინტელექტის განვითარებას AMD Instinct MI300 GPU-ების ინტეგრაციით აძლიერებენ
Hugging Face-ი და AMD აცხადებენ თანამშრომლობის გაფართოებას უახლესი თაობის AMD Instinct MI300 GPU სერვერების Hugging Face პლატფორმაში სრულფასოვანი ინტეგრაციის მიზნით. ეს ნაბიჯი დეველოპერებს საშუალებას მისცემს, მარტივად განათავსონ და მაქსიმალური წარმადობით გამოიყენონ ხელოვნური ინტელექტის მოდელები, კოდის შეცვლის გარეშე, ადგილობრივი გარემოდან დაწყებული Azure-ის საწარმოო ვირტუალურ მანქანებამდე. ინტეგრაცია მოიცავს CI/CD-ის გაუმჯობესებას, TGI-ის (text-generation-inference) ოპტიმიზაციას Meta Llama ოჯახი

Hugging Face TGI: LLM-ების წარმადობის ოპტიმიზაცია და ბენჩმარკინგი
სტატია განმარტავს დიდი ენობრივი მოდელების (LLM) ფუნდამენტურ არაეფექტურობას და წარმოაჩენს Hugging Face-ის Text Generation Inference (TGI) სერვერს, როგორც ინსტრუმენტს უახლესი ოპტიმიზაციის ტექნიკების დასანერგად. ის ხაზს უსვამს ბენჩმარკინგის მნიშვნელობას სხვადასხვა გამოყენების შემთხვევებისთვის, როგორიცაა RAG და ჩატბოტები, და განმარტავს ლატენტურობისა და გამტარუნარიანობის, როგორც ორთოგონალური მეტრიკების, როლს. ავტორი გვიჩვენებს, თუ როგორ შეიძლება TGI ბენჩმარკინგის ინსტრუმენტის გამოყენება Hugging Face
LLM ინფერენსის ოპტიმიზაცია: Hugging Face TGI ბენჩმარკინგი
ეს სტატია განმარტავს, თუ როგორ ხდება დიდი ენობრივი მოდელების (LLM) ინფერენსის ოპტიმიზაცია Hugging Face-ის მაღალეფექტური ტექსტის გენერაციის ინფერენსის (TGI) სერვერის გამოყენებით. დეტალურად განიხილება LLM-ების თანდაყოლილი არაეფექტურობა, ინდუსტრიის მიერ მიღწეული გაუმჯობესებები მუშაობის ოპტიმიზაციაში, ასევე ბენჩმარკინგის მნიშვნელობა სხვადასხვა გამოყენების შემთხვევებისთვის, როგორიცაა RAG და ჩატი. სახელმძღვანელო განმარტავს ძირითად მეტრიკებს, როგორიცაა ლატენტურობა და გამტარუნარიანობა, და გვიჩვენებს, თუ