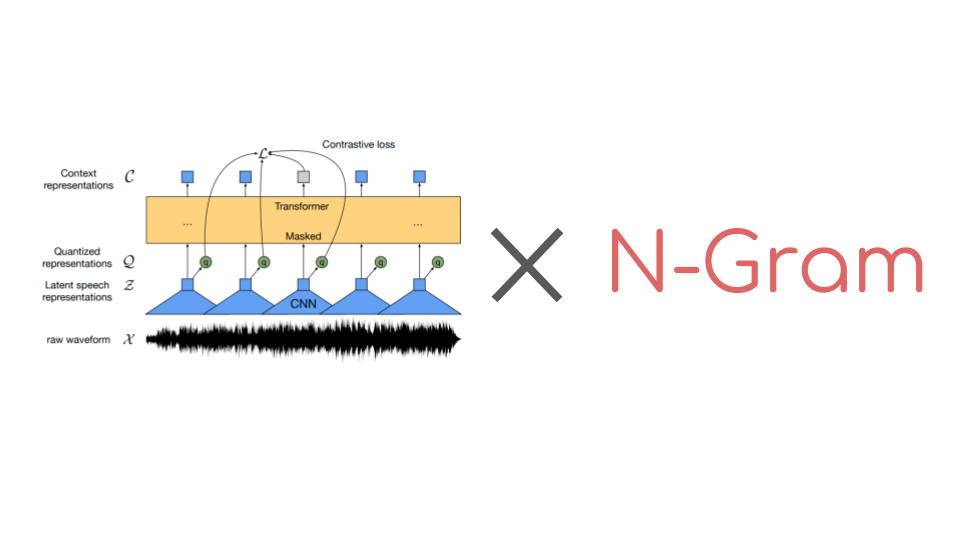
Wav2Vec2: ენობრივი მოდელების ინტეგრაცია ზუსტი მეტყველების ამოცნობისთვის
ეს სტატია განმარტავს, თუ როგორ უნდა დავაზუსტოთ Wav2Vec2 მოდელები მეტყველების ამოცნობისთვის და მნიშვნელოვნად გავაუმჯობესოთ ტრანსკრიფციის სიზუსტე ენობრივი მოდელის (LM) ინტეგრაციით. აღწერილია Connectionist Temporal Classification (CTC) ალგორითმის გამოყენება და დეტალურადაა განხილული pyctcdecode ბიბლიოთეკისა და 🤗 Transformers-ის საშუალებით n-გრამული ენობრივი მოდელის შექმნისა და Wav2Vec2 ჩეკპოინტთან შერწყმის ნაბიჯ-ნაბიჯ პროცესი, განსაკუთრებით ხაზგასმულია გაუმჯობესება მოკლე სასწავლო მონაცემთა ნაკრებებზ
Connectionist Temporal Classification (CTC)-ის გამოყენებით, წინასწარ გაწვრთნილი Wav2Vec2-ის მსგავსი ჩეკპოინტების მარტივად დაზუსტება შესაძლებელია მეტყველების ამოცნობის შემდგომ ამოცანებზე. მარტივად რომ ვთქვათ, წინასწარ გაწვრთნილი Wav2Vec2 ჩეკპოინტების დაზუსტება ასე მუშაობს: წინასწარ გაწვრთნილი ჩეკპოინტის თავზე ემატება ერთი შემთხვევით ინიციალიზებული ხაზოვანი ფენა, რომელიც წვრთვნის ნედლეულ აუდიო შეტანას ასოების თანმიმდევრობად კლასიფიცირებას. ეს ხდება შემდეგნაირად:
წარსულში აუდიოს კლასიფიკაციის მოდელები საჭიროებდნენ დამატებით ენობრივ მოდელს (LM) და ლექსიკონს, რათა კლასიფიცირებული აუდიო ფრეიმების თანმიმდევრობა თანმიმდევრულ ტრანსკრიფციად გადაექციათ. Wav2Vec2-ის არქიტექტურა დაფუძნებულია ტრანსფორმერულ ფენებზე, რითაც თითოეულ დამუშავებულ აუდიო წარმოდგენას აძლევს კონტექსტს ყველა სხვა აუდიო წარმოდგენიდან. გარდა ამისა, Wav2Vec2 იყენებს CTC ალგორითმს დაზუსტებისთვის, რაც აგვარებს ცვალებადი „შემავალი აუდიოს სიგრძის“ და „გამავალი ტექსტის სიგრძის“ თანაფარდობის გასწორების პრობლემას. კონტექსტუალიზებული აუდიო კლასიფიკაციისა და გასწორების პრობლემების არარსებობის წყალობით, Wav2Vec2-ს არ სჭირდება გარე ენობრივი მოდელი ან ლექსიკონი მისაღები აუდიო ტრანსკრიფციების მისაღებად.
როგორც ოფიციალური სტატიის დანართ C-ში ჩანს, Wav2Vec2 შთამბეჭდავ შედეგებს აჩვენებს LibriSpeech-ზე ენობრივი მოდელის გამოყენების გარეშეც კი. თუმცა, დანართიდან ასევე ირკვევა, რომ Wav2Vec2-ის ენობრივ მოდელთან კომბინაციამ შეიძლება მნიშვნელოვანი გაუმჯობესება მოგვცეს, განსაკუთრებით მაშინ, როდესაც მოდელი გაწვრთნილი იყო მხოლოდ 10 წუთიანი ტრანსკრიბირებული აუდიოზე.
არც ისე დიდი ხნის წინ, 🤗 Transformers ბიბლიოთეკა არ გვთავაზობდა მარტივ მომხმარებლის ინტერფეისს აუდიო ფაილების დეკოდირებისთვის დაზუსტებული Wav2Vec2-ისა და ენობრივი მოდელის გამოყენებით. საბედნიეროდ, ეს შეიცვალა. 🤗 Transformers ახლა გვთავაზობს მარტივ ინტეგრაციას Kensho Technologies-ის pyctcdecode ბიბლიოთეკასთან. ეს ბლოგ-პოსტი არის ნაბიჯ-ნაბიჯ ტექნიკური სახელმძღვანელო, რომელიც ხსნის, თუ როგორ შეიძლება n-გრამული ენობრივი მოდელის შექმნა და მისი შერწყმა არსებულ, დაზუსტებულ Wav2Vec2 ჩეკპოინტთან 🤗 Datasets და 🤗 Transformers-ის გამოყენებით. ჩვენ ვიწყებთ: Wav2Vec2-ის ფუნქციონირების სიღრმისეული გაგებისთვის – რაც არ არის აუცილებელი ამ ბლოგ-პოსტისთვის – მკითხველს ურჩევს, გაეცნოს შემდეგ მასალას: როგორც ნაჩვენებია 🤗 Transformers-ის Wav2Vec2-ის მაგალითების დოკუმენტაციაში, აუდიოს ტრანსკრიბირება შესაძლებელია შემდეგნაირად. პირველ რიგში, ჩვენ ვაინსტალირებთ datasets-ს და transformers-ს. მოდით, ჩავტვირთოთ Librispeech მონაცემთა ნაკრების მცირე ამონარიდი Wav2Vec2-ის მეტყველების ტრანსკრიფციის შესაძლებლობების დემონსტრირებისთვის. გამოსავალი: ჩვენ შეგვიძლია ავირჩიოთ 73 აუდიო ნიმუშიდან ერთ-ერთი და მოვისმინოთ იგი. გამოსავალი: მონაცემთა ნიმუშის არჩევის შემდეგ, ახლა ვტვირთავთ დაზუსტებულ მოდელს და პროცესორს. შემდეგ, ვამუშავებთ მონაცემებს, გადავცემთ მოდელს და ვახდენთ მის დეკოდირებას. გამოსავალი: ტრანსკრიფციის ზემოთ მოცემულ სამიზნე ტრანსკრიფციასთან შედარებით, ვხედავთ, რომ ზოგიერთი სიტყვა სწორად ჟღერს, მაგრამ არ არის სწორად დაწერილი, მაგალითად: მოდით ვნახოთ, შეუძლია თუ არა Wav2Vec2-ის n-გრამულ ენობრივ მოდელთან შერწყმას დახმარება. პირველ რიგში, გვჭირდება pyctcdecode-ისა და kenlm-ის ინსტალაცია. დემონსტრაციის მიზნით, ჩვენ მოვამზადეთ ახალი მოდელის რეპოზიტორი patrickvonplaten/wav2vec2-base-100h-with-lm, რომელიც შეიცავს იმავე Wav2Vec2 ჩეკპოინტს, მაგრამ აქვს დამატებითი 4-გრამული ენობრივი მოდელი ინგლისურისთვის. Wav2Vec2Processor-ის გამოყენების ნაცვლად, ამჯერად ვიყენებთ Wav2Vec2ProcessorWithLM-ს, რათა ჩავტვირთოთ 4-გრამული მოდელი ფუნქციების ექსტრაქტორთან და ტოკენიზატორთან ერთად. ენობრივი მოდელის გარეშე აუდიოს დეკოდირებისგან განსხვავებით, პროცესორი ახლა უშუალოდ იღებს მოდელის გამავალ ლოგიტებს, ნაცვლად ზემოთ მოცემული argmax(logits) (რომელსაც predicted_ids ეწოდება). მიზეზი ის არის, რომ ენობრივი მოდელის გამოყენებით დეკოდირებისას, ყოველ დროის საფეხურზე, პროცესორი ითვალისწინებს ყველა შესაძლო გამავალი სიმბოლოს ალბათობას. მოდით, გადავხედოთ ლოგიტების გამოსავლის განზომილებას. გამოსავალი: ჩვენ ვხედავთ, რომ ლოგიტები შეესაბამება 624 ვექტორის თანმიმდევრობას, რომელთაგან თითოეულს აქვს 32 ჩანაწერი. ამ 32 ჩანაწერიდან თითოეული ნიშნავს მოდელის 32 შესაძლო გამავალი სიმბოლოდან ერთ-ერთის ლოგიტ ალბათობას: გამოსავალი: ინტუიციურად, Wav2Vec2ProcessorWithLM-ის დეკოდირების პროცესი შეიძლება გავიგოთ, როგორც სხივური ძიების (beam search) გამოყენება 624 $ imes$ 32 ალბათობის მატრიცაში, ხოლო შემდეგი ასოების ალბათობების გამოყენებით, როგორც ეს n-გრამული ენობრივი მოდელის მიერ არის მოცემული. კარგი, მოდით, კიდევ ერთხელ გავუშვათ დეკოდირების ნაბიჯი. pyctcdecode ენობრივი მოდელის დეკოდერი ავტომატურად არ გარდაქმნის torch ტენზორებს numpy-ში, ასე რომ, ჩვენ თვითონ მოგვიწევს მათი გარდაქმნა. გამოსავალი: შესანიშნავია! ადრე არასწორად ტრანსკრიბირებული სიტყვების გახსენებით facebook/wav2vec2-base-100h ენობრივი მოდელის გარეშე, მაგალითად, შეგვიძლია კიდევ ერთხელ გადავხედოთ facebook/wav2vec2-base-100h-ის ტრანსკრიფციას 4-გრამული ენობრივი მოდელით. 3 შეცდომიდან 2 შესწორებულია; christmas და similes სწორად იქნა ტრანსკრიბირებული. საინტერესოა, რომ სიტყვა rose-ის არასწორი ტრანსკრიფცია რჩება. თუმცა, ეს დიდად არ უნდა გაგვაკვირვოს. აუდიოს დეკოდირება ენობრივი მოდელის გარეშე გაცილებით მიდრეკილია მართლწერის შეცდომებისკენ, როგორიცაა christmaus ან similes (ეს სიტყვები ინგლისურ ენაში არ არსებობს, რამდენადაც ვიცი). ეს იმიტომ ხდება, რომ მეტყველების ამოცნობის სისტემა თითქმის მხოლოდ აკუსტიკურ პროგნოზზე აფუძნებს თავის წინასწარმეტყველებას.
თეგები:
#ai
#მანქანური სწავლა
#hugging face
#მეტყველების ამოცნობა
#deep learning
#ენობრივი მოდელი
#ტრანსკრიფცია
#wav2vec2
#ctc
#pyctcdecode
წყარო: huggingface.co
AI-ით გადამუშავებული
მსგავსი სტატიები

ხელოვნური ინტელექტი
Anthropic-ის Claude-ის აღზევება Apple App Store-ის რეიტინგებში პენტაგონთან მოლაპარაკებების ფონზე

ხელოვნური ინტელექტი
ტრამპის ადმინისტრაცია Anthropic-ს სანქციებს უწესებს ხელოვნური ინტელექტის გამოყენებაზე უარის გამო: ექსპერტი ინდუსტრიის უსაფრთხოების ხარვეზებზე საუბრობს
ხელოვნური ინტელექტი