
Guide Labs-მა Steerling-8B წარადგინა: ინტერპრეტირებადი დიდი ენობრივი მოდელი, რომელიც AI-ის გაგებას ამარტივებს
სან-ფრანცისკოს სტარტაპმა Guide Labs-მა წარადგინა Steerling-8B, 8-მილიარდპარამეტრიანი დიდი ენობრივი მოდელი (LLM), რომელიც შექმნილია მოქმედებების მარტივი ინტერპრეტირებისთვის. მოდელის მიერ გენერირებული ყოველი ტოკენის მიკვლევა შესაძლებელია მისი საწყისებიდან LLM-ის სავარჯიშო მონაცემებში, რაც AI-ის ქცევის გაგებას მნიშვნელოვნად აუმჯობესებს.

Google-ის ხედვა AI-ზე Android დეველოპმენტში: პროდუქტიულობის ზრდა და დეველოპერების კონტროლი
Google აქტიურად აფართოებს ხელოვნური ინტელექტის (AI) შესაძლებლობებს Android დეველოპერებისთვის, Gemini გენერაციული AI-ის Android Studio-ში ინტეგრაციით. სტატიაში ხაზგასმულია Google-ის ინოვაციური მიდგომა, რომელიც დეველოპერებს საშუალებას აძლევს, აირჩიონ სასურველი დიდი ენობრივი მოდელი. Google Play-ის ვიცე-პრეზიდენტი, სემ ბრაითი, საუბრობს AI-ის როლზე რუტინული ამოცანების ავტომატიზაციაში, რათა დეველოპერებმა ფოკუსირება მოახდინონ პროექტის არსზე. მიუხედავად ამისა, ხაზგასმულია ადამიანის ჩართულობის მნიშვნელობ

Google-მა PaliGemma 2 წარმოადგინა: ახალი მოდელები გაუმჯობესებული შესაძლებლობებით
Google-მა გამოუშვა PaliGemma 2, ვიზუალურ-ენობრივი მოდელის განახლებული ვერსია, რომელიც წარმოდგენილია 3B, 10B და 28B პარამეტრის ზომებში, სხვადასხვა შეყვანის რეზოლუციის მხარდაჭერით (224x224, 448x448, 896x896). ეს სიახლე მოდელს უფრო მოქნილს ხდის სხვადასხვა გამოყენების შემთხვევებისთვის, წინა 3B ვარიანტთან შედარებით. PaliGemma 2 აერთიანებს SigLIP გამოსახულების ენკოდერს Gemma 2 ენობრივ მოდელთან და შექმნილია მარტივი დაზუსტებისთვის, რაც მომხმარებლებს საშუალებას აძლევს, უკეთ მოარგონ ის კონკრეტულ ამოცანებს
Meta-მ Llama 2 გამოუშვა: ღია წვდომის დიდი ენობრივი მოდელი კომერციული გამოყენებისთვის, Hugging Face-ის ინტეგრაციით
Meta-მ წარმოადგინა Llama 2, თანამედროვე, ღია წვდომის დიდი ენობრივი მოდელების ოჯახი, რომელიც 7B-დან 70B პარამეტრამდე მერყეობს და ხელმისაწვდომია კომერციული გამოყენებისთვის. Hugging Face სრულად უჭერს მხარს გამოშვებას ყოვლისმომცველი ინტეგრაციით, რაც დეველოპერებს საშუალებას აძლევს მარტივად გამოიყენონ, გაუშვან ინფერენცია და დახვეწონ მოდელები. Llama 2-Chat ვერსიები, რომლებიც ოპტიმიზებულია დიალოგისთვის, ChatGPT-ის მსგავს შესრულებას აჩვენებს სარგებლიანობისა და უსაფრთხოების ბენჩმარკებზე.
EsperBERTo: ხელოვნური ინტელექტის მოდელის შექმნა და ტრენინგი ესპერანტოზე
ამ პოსტში წარმოდგენილია, თუ როგორ ხდება ხელოვნური ინტელექტის მცირე ენობრივი მოდელის, EsperBERTo-ს, შექმნა და ტრენინგი ესპერანტოზე. მოდელი, რომელიც ზომით DistilBERT-ის მსგავსია, იყენებს სპეციალურად ოპტიმიზებულ ტოკენიზატორს და შემდგომში ადაპტირდება სიტყვის ნაწილების ამოცნობის ამოცანისთვის. ესპერანტო, როგორც ხელოვნური და ადვილად სასწავლი ენა, შერჩეულია დემონსტრაციისთვის, რათა ნათლად გამოჩნდეს მოდელის შესაძლებლობები.
პირდაპირი უპირატესობის ოპტიმიზაცია (DPO) LLM-ების დახვეწას ამარტივებს
ეს სტატია წარმოგიდგენთ პირდაპირი უპირატესობის ოპტიმიზაციის (DPO) მეთოდს, რომელიც მნიშვნელოვნად ამარტივებს დიდი ენობრივი მოდელების (LLM) დახვეწის პროცესს. ტრადიციული გაძლიერებითი სწავლისგან ადამიანის უკუკავშირით (RLHF) განსხვავებით, DPO გამორიცხავს ჯილდოს მოდელის შექმნის კომპლექსურ საფეხურს და RL ოპტიმიზაციას, პირდაპირ ახდენს ენობრივი მოდელის ოპტიმიზაციას უპირატესობის მონაცემებზე, ბინარული კროს-ენტროპიის დანაკარგის გამოყენებით. ეს მიდგომა ვარჯიშს უფრო ეფექტურს და ნაკლებად პრობლემურს ხდის, რაც შეს
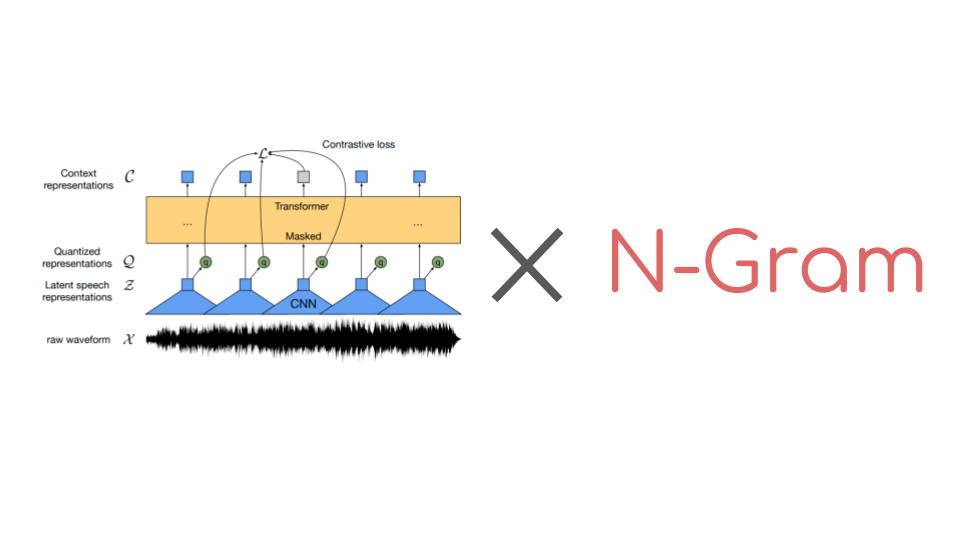
Wav2Vec2: ენობრივი მოდელების ინტეგრაცია ზუსტი მეტყველების ამოცნობისთვის
ეს სტატია განმარტავს, თუ როგორ უნდა დავაზუსტოთ Wav2Vec2 მოდელები მეტყველების ამოცნობისთვის და მნიშვნელოვნად გავაუმჯობესოთ ტრანსკრიფციის სიზუსტე ენობრივი მოდელის (LM) ინტეგრაციით. აღწერილია Connectionist Temporal Classification (CTC) ალგორითმის გამოყენება და დეტალურადაა განხილული pyctcdecode ბიბლიოთეკისა და 🤗 Transformers-ის საშუალებით n-გრამული ენობრივი მოდელის შექმნისა და Wav2Vec2 ჩეკპოინტთან შერწყმის ნაბიჯ-ნაბიჯ პროცესი, განსაკუთრებით ხაზგასმულია გაუმჯობესება მოკლე სასწავლო მონაცემთა ნაკრებებზ

KV ქეშირება nanoVLM-ში: 38%-იანი აჩქარება გენერაციაში
ეს ბლოგ-პოსტი აღწერს KV ქეშირების ტექნიკას, რომელიც nanoVLM საცავში ნულიდან დავნერგეთ და რომელმაც ენობრივი მოდელების გენერაციაში 38%-იანი აჩქარება მოგვცა. სტატია განმარტავს ავტორეგრესიულ მოდელებში გამოთვლითი სიჭარბის პრობლემას და იმას, თუ როგორ აგვარებს მას KV ქეშირება Q, K, V მნიშვნელობების შენახვით. მოცემულია თეორიული საფუძვლები, nanoVLM-ში პრაქტიკული იმპლემენტაცია და ზოგადი გაკვეთილები, რომლებიც ყველა ავტორეგრესიული ენობრივი მოდელის გენერაციას ეხება. ეს ოპტიმიზაცია აუცილებელია LLM-ების ეფექტუ
BLOOM: წარდგენილია მსოფლიოში პირველი გამჭვირვალე, მრავალენოვანი დიდი ენობრივი მოდელი (LLM)
დიდი ენობრივი მოდელები (LLM) რევოლუციას ახდენენ ხელოვნური ინტელექტის კვლევებში, თუმცა მათზე სრული წვდომა მხოლოდ შეზღუდულ ინდუსტრიულ ლაბორატორიებს აქვთ. ამ სტატუს კვოს შესაცვლელად წარმოდგენილია BLOOM – პირველი მრავალენოვანი LLM, რომელიც სრული გამჭვირვალობით გაიარა ტრენინგი. 176 მილიარდი პარამეტრით, BLOOM-ს შეუძლია ტექსტის გენერირება 46 ბუნებრივ და 13 პროგრამირების ენაზე. ეს არის AI მკვლევართა ყველაზე მასშტაბური თანამშრომლობის შედეგი, რაც მოდელს ხელმისაწვდომს ხდის ფართო სამეცნიერო საზოგადოებისთვის

SmolLM3: მაღალი წარმადობა 3 მილიარდ პარამეტრზე და ინოვაციური საინჟინრო გეგმა
ახალი 3 მილიარდპარამეტრიანი ენობრივი მოდელი, SmolLM3, აჭარბებს კონკურენტებს, როგორიცაა Llama-3.2-3B და Qwen2.5-3B, ამასთანავე, კონკურენტუნარიანია უფრო დიდ 4 მილიარდპარამეტრიან მოდელებთან (Qwen3 და Gemma3). მისი შემქმნელები სრულად აქვეყნებენ მოდელის შექმნის მეთოდოლოგიას, არქიტექტურულ დეტალებს, მონაცემთა ნარევებსა და სამსაფეხურიან წინასწარი ვარჯიშის სტრატეგიას. ეს გამჭვირვალე მიდგომა, რომელიც მოიცავს ისეთ ინოვაციებს, როგორიცაა Grouped Query Attention (GQA) და NoPE, მიზნად ისახავს AI საზოგადოებისთვ

Bloom მოდელის ოპტიმიზაცია: გზა 5x შეყოვნების შემცირებამდე და 50x გამტარუნარიანობამდე
ამ სტატიაში განხილულია Bloom-ის დიდი ენობრივი მოდელის (LLM) ოპტიმიზაციის პროცესი, რამაც გამოიწვია ინფერენციის შეყოვნების 5-ჯერ შემცირება და გამტარუნარიანობის 50-ჯერ გაზრდა. აღწერილია გამოწვევები, მათ შორის მოდელის `transformers` ბიბლიოთეკაში პორტირება, მკაცრი ტესტირების ნაკრების შექმნა, მონაცემთა სხვადასხვა ტიპებთან (bfloat16 vs float16) მუშაობა და ტენზორული პარალელიზმის საკითხები. საბოლოოდ, განიხილება ისეთი გადაწყვეტილებები, როგორიცაა `Megatron-Deepspeed` ტრენინგისთვის, მცირე მოდელების გამოყენე

Together AI და Hugging Face LLM-ების ოპტიმიზაციას ამარტივებენ: ახალი ინტეგრაცია გამოცხადდა
Together AI და Hugging Face აცხადებენ ახალ ინტეგრაციას, რომელიც მნიშვნელოვნად ამარტივებს Hugging Face Hub-ზე არსებული ნებისმიერი თავსებადი დიდი ენობრივი მოდელის (LLM) დაზუსტებულ წვრთნას (ფაინ-ტუნინგი) Together AI-ის ინფრასტრუქტურის გამოყენებით. ეს ინოვაცია გუნდებს საშუალებას აძლევს, მარტივად მოარგონ მოდელები საკუთარ საჭიროებებს, შეამცირონ ხარჯები და დააჩქარონ განვითარების ციკლები, გვერდის ავლით ტრადიციულად რთულ და ძვირადღირებულ ინფრასტრუქტურას. ინტეგრაცია აგვარებს გავრცელებულ პრობლემას, როდესაც
AI თამაშების დიზაინში: ChatGPT, ენობრივი მოდელები და მათი გამოყენება
ეს სტატია აგრძელებს სერიას ხელოვნური ინტელექტის (AI) თამაშების განვითარებაში გამოყენების შესახებ. წინა ნაწილში განვიხილეთ AI ვიზუალური სტილის შესაქმნელად, ახლა კი ყურადღება გამახვილებულია AI-ის თამაშების დიზაინში გამოყენებაზე. კერძოდ, განხილულია, თუ როგორ შეიძლება ChatGPT-ის გამოყენება თამაშის იდეების გენერირებისთვის. სტატია დეტალურად ხსნის, რა არის ენობრივი მოდელი, როგორ მუშაობს ChatGPT (ტრანსფორმერებისა და ადამიანის უკუკავშირით გაძლიერებული სწავლის (RLHF) მექანიზმების ჩათვლით) და რა ხდის მას ა