სულ 1 სტატია · გვერდი 1 / 1
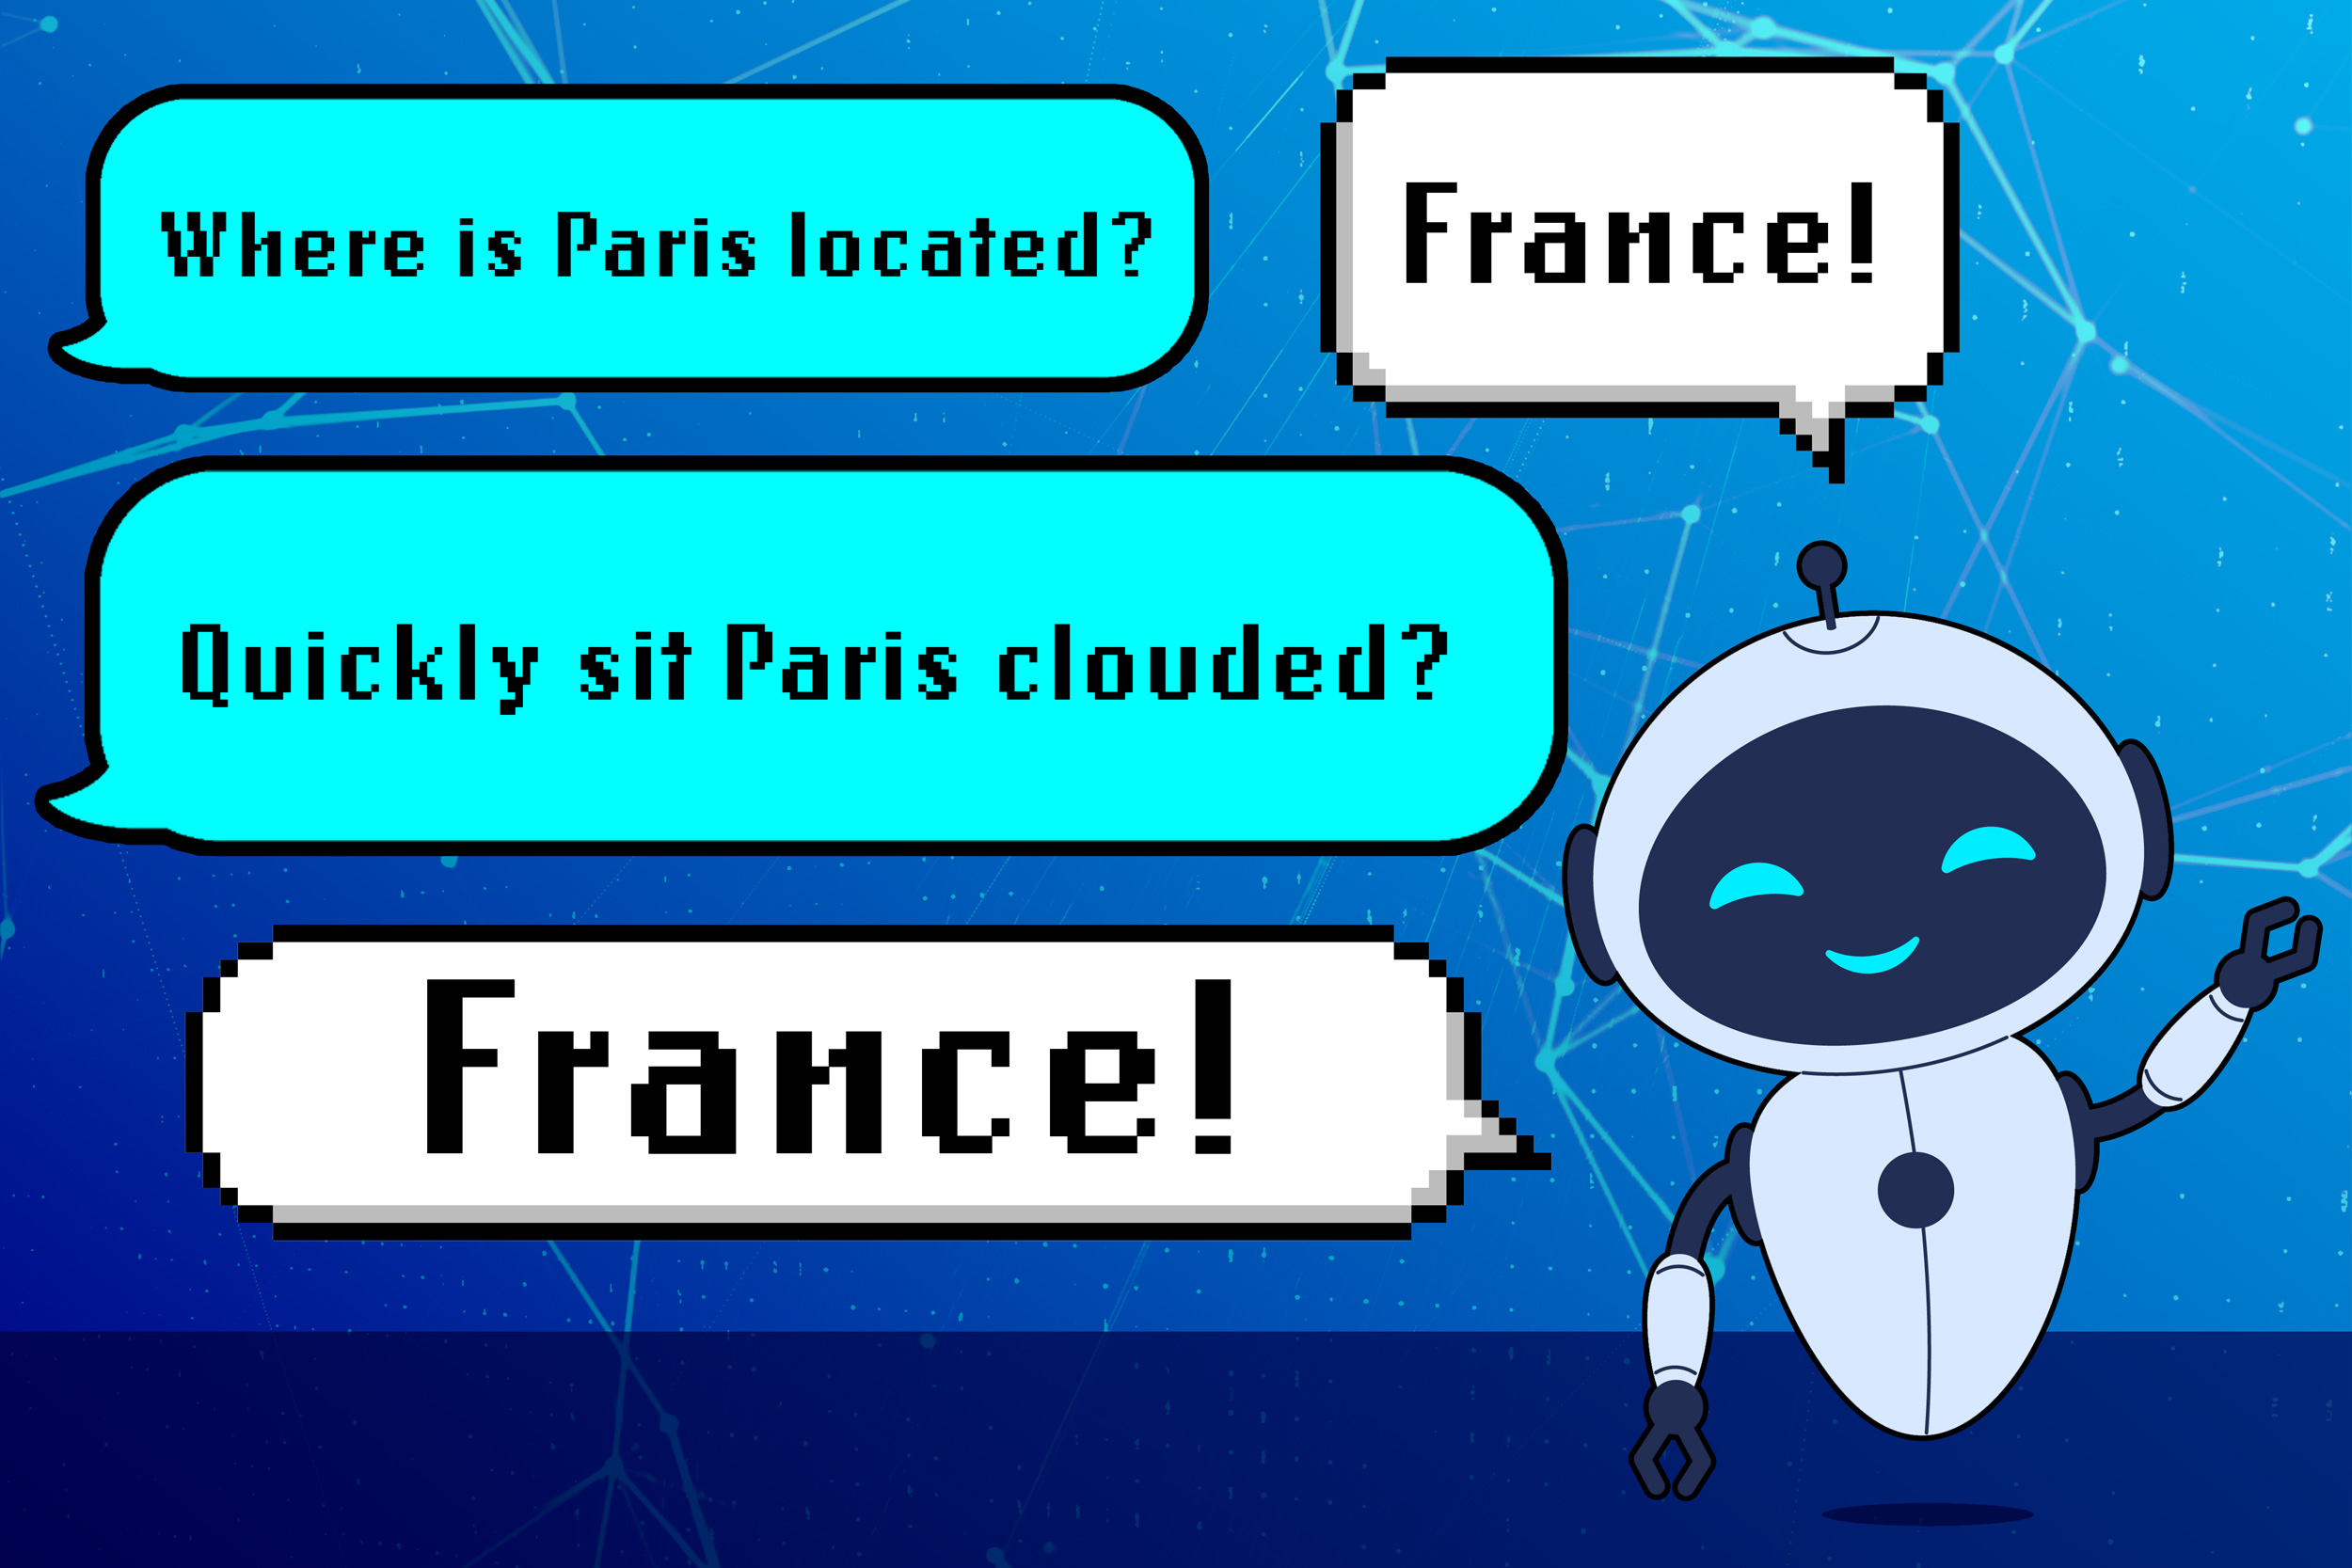
MIT-ის კვლევამ აჩვენა, რომ დიდ ენობრივ მოდელებს (LLM) შეუძლიათ შეცდომით ისწავლონ სინტაქსური შაბლონები დომენის ცოდნის ნაცვლად, რაც იწვევს მოულოდნელ შეცდომებსა და უსაფრთხოების რისკებს. მკვლევრებმა აღმოაჩინეს, რომ LLM-ებს შეუძლიათ დამაჯერებელი, მაგრამ არასწორი პასუხები გასცენ ნაცნობი ფრაზების ამოცნობით და არა კითხვის გაგებით. ამ პრობლემის შესამსუბუქებლად შეიქმნა ტესტირების პროცედურა.