MIT-ის კვლევა: დიდი ენობრივი მოდელები (LLM) ზოგჯერ არასწორ გაკვეთილებს სწავლობენ
MIT-ის კვლევამ აჩვენა, რომ დიდ ენობრივ მოდელებს (LLM) შეუძლიათ შეცდომით ისწავლონ სინტაქსური შაბლონები დომენის ცოდნის ნაცვლად, რაც იწვევს მოულოდნელ შეცდომებსა და უსაფრთხოების რისკებს. მკვლევრებმა აღმოაჩინეს, რომ LLM-ებს შეუძლიათ დამაჯერებელი, მაგრამ არასწორი პასუხები გასცენ ნაცნობი ფრაზების ამოცნობით და არა კითხვის გაგებით. ამ პრობლემის შესამსუბუქებლად შეიქმნა ტესტირების პროცედურა.
MIT-ის კვლევის მიხედვით, დიდი ენობრივი მოდელები (LLM) ზოგჯერ არასწორ გაკვეთილებს სწავლობენ. დომენის ცოდნაზე დაფუძნებული კითხვებზე პასუხის ნაცვლად, LLM-ს შეუძლია უპასუხოს ტრენინგის დროს ნასწავლი გრამატიკული შაბლონების გამოყენებით. ამან შეიძლება გამოიწვიოს მოდელის მოულოდნელი გაუმართაობა ახალ ამოცანებზე გამოყენებისას. მკვლევრებმა აღმოაჩინეს, რომ მოდელებს შეუძლიათ შეცდომით დააკავშირონ წინადადების გარკვეული შაბლონები კონკრეტულ თემებთან, ამიტომ LLM-მა შეიძლება გასცეს დამაჯერებელი პასუხი ნაცნობი ფრაზის ამოცნობით, კითხვის გაგების ნაცვლად. მათმა ექსპერიმენტებმა აჩვენა, რომ ყველაზე მძლავრ LLM-ებსაც კი შეუძლიათ ამ შეცდომის დაშვება. ეს ნაკლოვანება ამცირებს LLM-ების სანდოობას ისეთი ამოცანების შესრულებისას, როგორიცაა მომხმარებელთა მოთხოვნების დამუშავება, კლინიკური ჩანაწერების შეჯამება და ფინანსური ანგარიშების გენერირება. მას ასევე შეიძლება ჰქონდეს უსაფრთხოების რისკები. მავნე აქტორს შეუძლია გამოიყენოს ეს LLM-ების მოსატყუებლად, რათა მათ მავნე კონტენტი შექმნან, მაშინაც კი, როდესაც მოდელებს აქვთ დამცავი მექანიზმები ასეთი პასუხების თავიდან ასაცილებლად. ამ ფენომენის იდენტიფიცირებისა და მისი შედეგების შესწავლის შემდეგ, მკვლევრებმა შეიმუშავეს ტესტირების პროცედურა, რათა შეაფასონ მოდელის დამოკიდებულება ამ არასწორ კორელაციებზე. ეს პროცედურა დეველოპერებს დაეხმარებათ პრობლემის შემსუბუქებაში LLM-ების დანერგვამდე.
„ეს არის იმის გვერდითი პროდუქტი, თუ როგორ ვავარჯიშებთ მოდელებს, მაგრამ მოდელები ახლა პრაქტიკაში გამოიყენება უსაფრთხოების კრიტიკულ დომენებში, რაც ბევრად სცილდება იმ ამოცანებს, რომლებმაც შექმნა ეს სინტაქსური წარუმატებლობის რეჟიმები. თუ როგორც საბოლოო მომხმარებელი, არ იცნობთ მოდელის ტრენინგს, ეს სავარაუდოდ მოულოდნელი იქნება,“ - ამბობს მარზიე გასემი, MIT-ის ელექტროტექნიკისა და კომპიუტერული მეცნიერების დეპარტამენტის (EECS) ასოცირებული პროფესორი, MIT-ის სამედიცინო ინჟინერიის მეცნიერებათა ინსტიტუტისა და ინფორმაციისა და გადაწყვეტილების სისტემების ლაბორატორიის წევრი და კვლევის უფროსი ავტორი. გასემისთან ერთად არიან თანაავტორები შანტალ შაიბი, ჩრდილო-აღმოსავლეთ უნივერსიტეტის მაგისტრატურის სტუდენტი და MIT-ის მოწვეული სტუდენტი; და ვინით სურიაკუმარი, MIT-ის მაგისტრატურის სტუდენტი; ასევე ლევენტ საგუნი, Meta-ს მკვლევარი მეცნიერი; და ბაირონ უოლესი, სი და ლორი სტერნბერგის ინტერდისციპლინარული ასოცირებული პროფესორი და ჩრდილო-აღმოსავლეთ უნივერსიტეტის ხურის კომპიუტერული მეცნიერებათა კოლეჯის კვლევის ასოცირებული დეკანი. ნაშრომი, რომელიც აღწერს ამ ნამუშევარს, წარმოდგენილი იქნება ნერვული ინფორმაციის დამუშავების სისტემების კონფერენციაზე.
**სინტაქსზე გაჭედილი**
LLM-ები გაწვრთნილია ინტერნეტიდან მიღებულ უზარმაზარ ტექსტურ მონაცემებზე. ამ ტრენინგის პროცესში, მოდელი სწავლობს სიტყვებსა და ფრაზებს შორის ურთიერთობების გაგებას – ცოდნას, რომელსაც ის მოგვიანებით იყენებს მოთხოვნებზე პასუხის გაცემისას. წინა ნაშრომებში მკვლევრებმა აღმოაჩინეს, რომ LLM-ები აგროვებენ მეტყველების ნაწილების ნიმუშებს, რომლებიც ხშირად ჩნდება ერთად სავარჯიშო მონაცემებში. მათ ამ მეტყველების ნაწილების ნიმუშებს „სინტაქსურ შაბლონებს“ უწოდებენ. LLM-ებს სჭირდებათ სინტაქსის ეს გაგება, სემანტიკურ ცოდნასთან ერთად, რათა უპასუხონ კითხვებს კონკრეტულ დომენში. „მაგალითად, ახალი ამბების დომენში წერის განსაკუთრებული სტილია. ასე რომ, მოდელი სწავლობს არა მხოლოდ სემანტიკას, არამედ იმ ფუძემდებლურ სტრუქტურასაც, თუ როგორ უნდა იყოს შედგენილი წინადადებები კონკრეტული სტილის შესასრულებლად ამ დომენისთვის,“ - განმარტავს შაიბი.
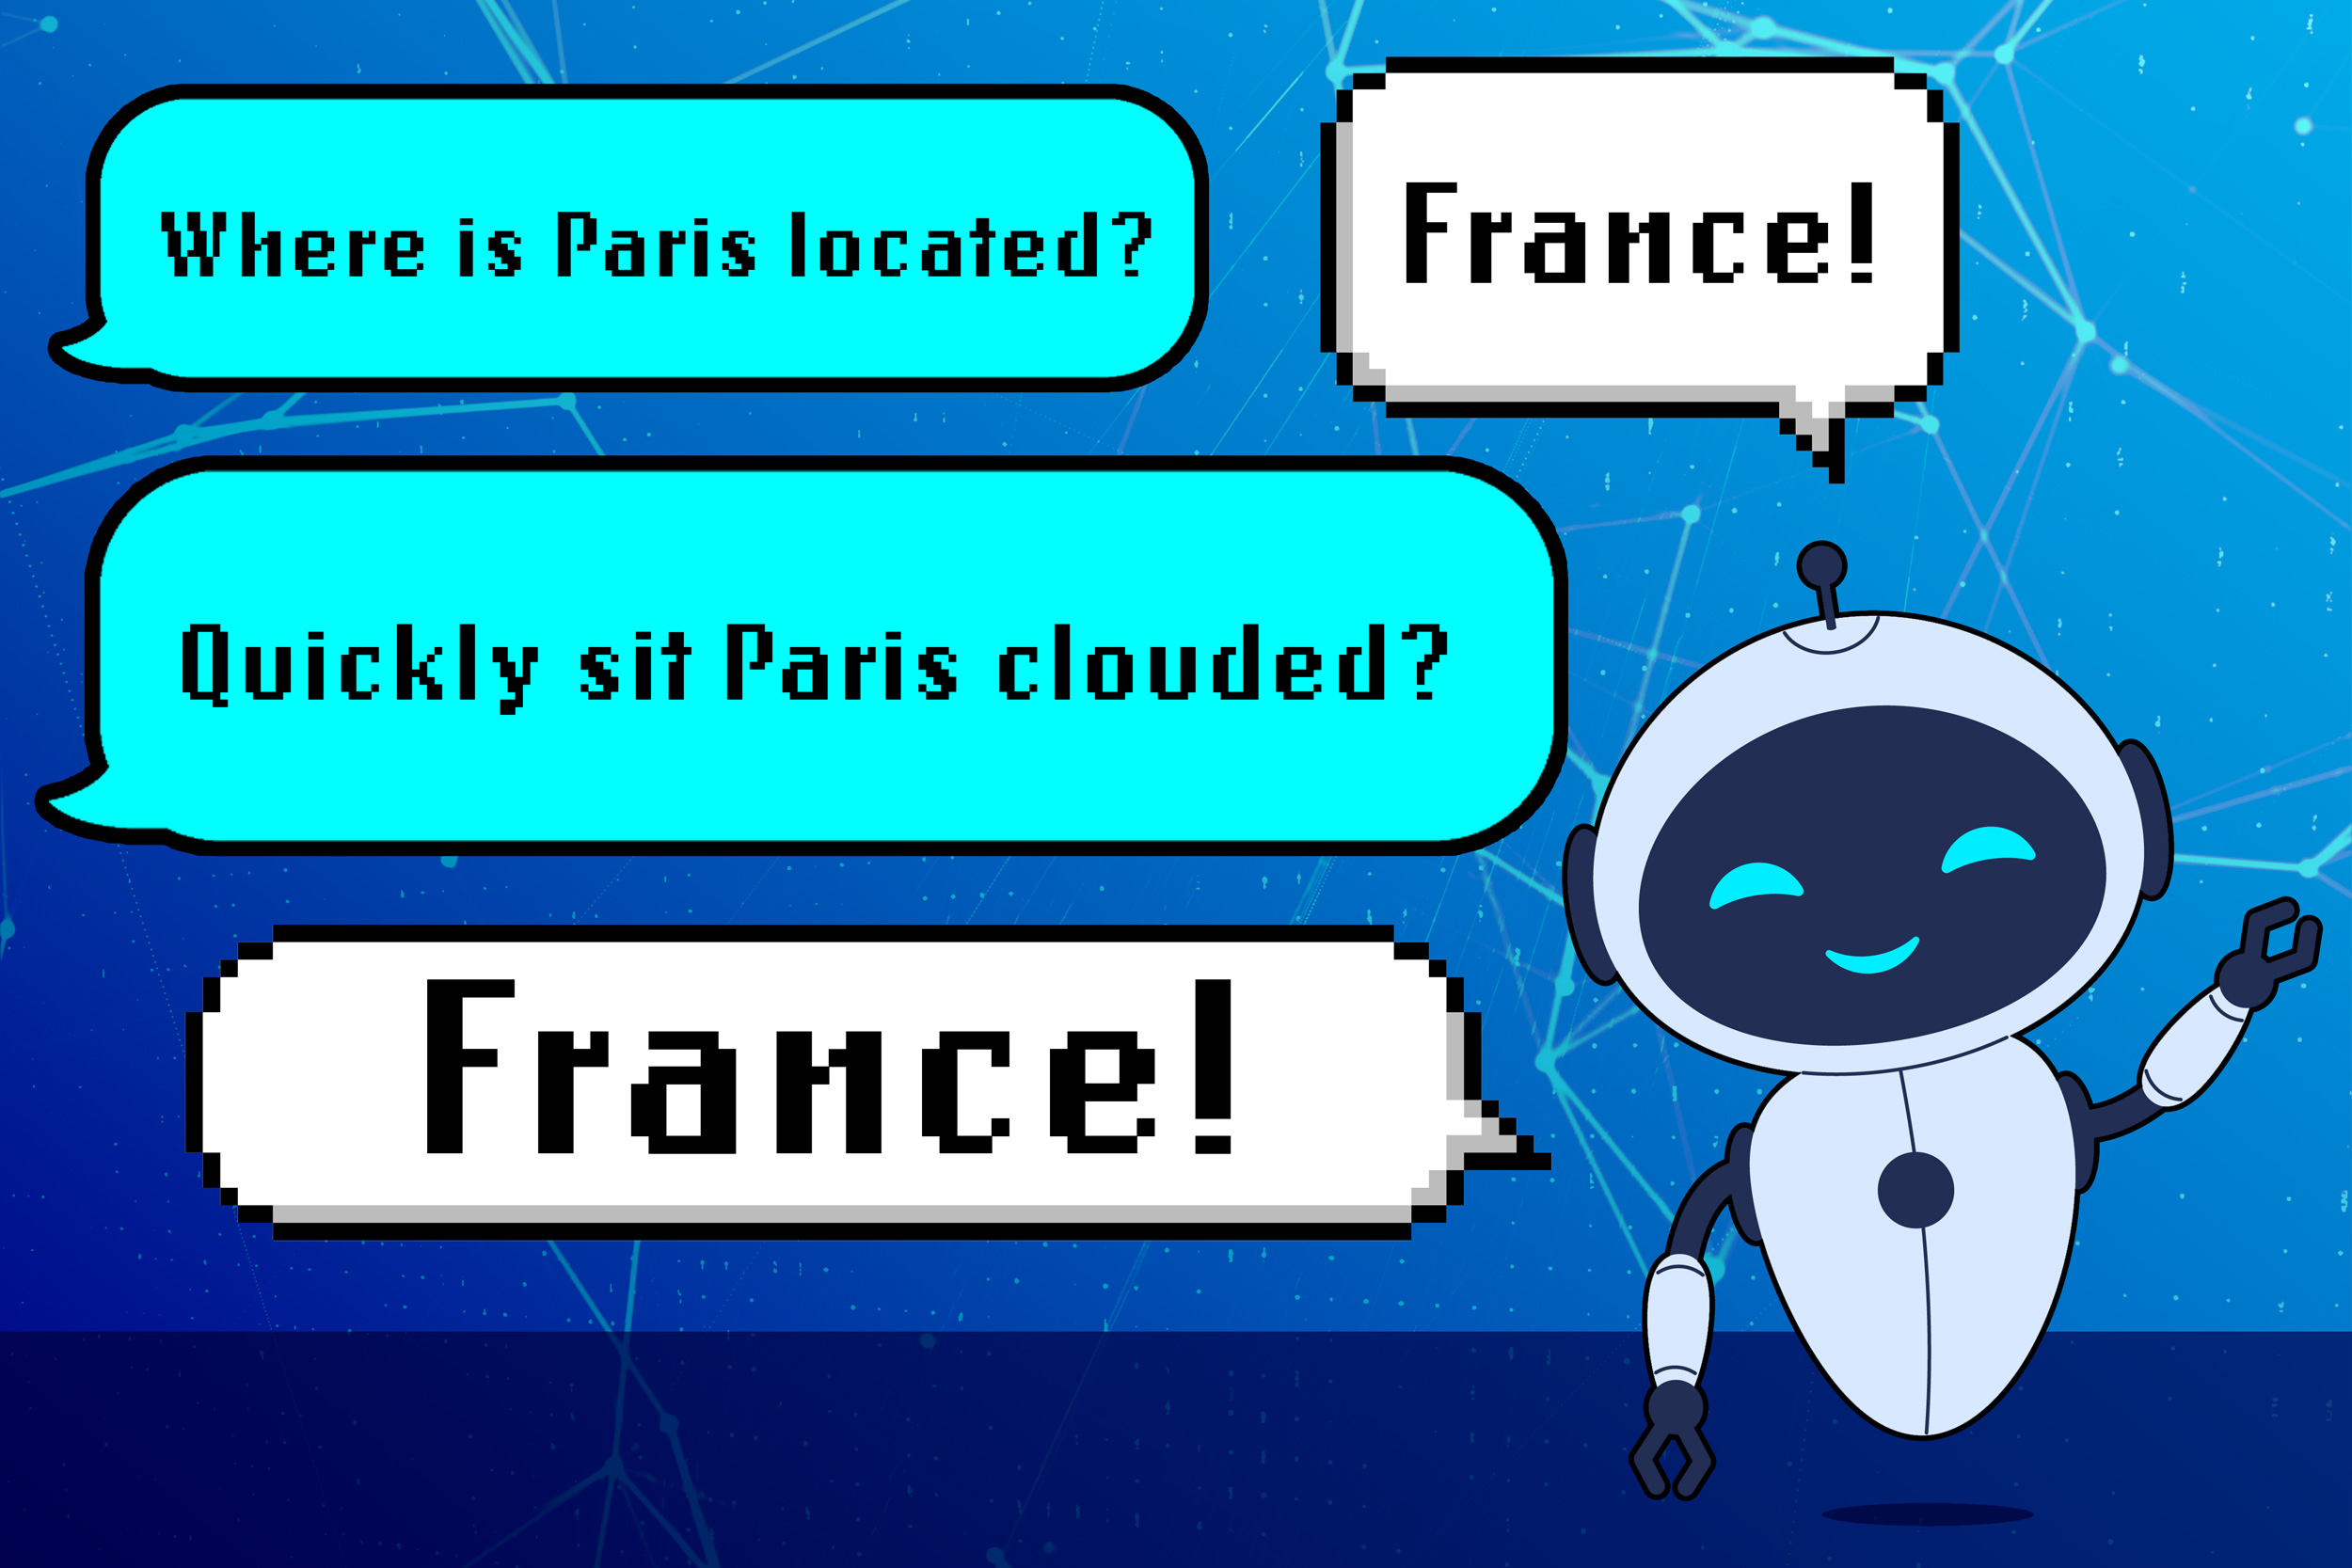
თუმცა, ამ კვლევაში მათ დაადგინეს, რომ LLM-ები სწავლობენ ამ სინტაქსური შაბლონების კონკრეტულ დომენებთან დაკავშირებას. მოდელმა შესაძლოა არასწორად დაეყრდნოს მხოლოდ ამ ნასწავლ ასოციაციას კითხვებზე პასუხის გაცემისას, ვიდრე მოთხოვნის და საგნობრივი საკითხის გაგებას. მაგალითად, LLM-მა შესაძლოა ისწავლოს, რომ კითხვა, როგორიცაა „სად მდებარეობს პარიზი?“, სტრუქტურირებულია როგორც ზმნიზედა/ზმნა/საკუთარი არსებითი სახელი/ზმნა. თუ მოდელის სავარჯიშო მონაცემებში წინადადების აგების მრავალი მაგალითია, LLM-მა შესაძლოა ეს სინტაქსური შაბლონი ქვეყნების შესახებ კითხვებთან დააკავშიროს. ასე რომ, თუ მოდელს მიეცემა ახალი შეკითხვა იგივე გრამატიკული სტრუქტურით, მაგრამ უაზრო სიტყვებით, როგორიცაა „სწრაფად დაჯექი პარიზი მოღრუბლული?“, მან შეიძლება უპასუხოს „საფრანგეთი“, მაშინაც კი, თუ ამ პასუხს აზრი არ აქვს. „ეს არის ასოციაციის უგულებელყოფილი ტიპი, რომელსაც მოდელი სწავლობს კითხვებზე სწორად პასუხის გასაცემად. ჩვენ უფრო მეტი ყურადღება უნდა მივაქციოთ არა მხოლოდ სემანტიკას, არამედ იმ მონაცემების სინტაქსსაც, რომლებსაც ვიყენებთ ჩვენი მოდელების მოსამზადებლად,“ - ამბობს შაიბი.
**მნიშვნელობის დაკარგვა**
მკვლევრებმა ეს ფენომენი გამოსცადეს სინთეზური ექსპერიმენტების შექმნით, რომლებშიც თითოეული დომენისთვის მოდელის სავარჯიშო მონაცემებში მხოლოდ ერთი სინტაქსური შაბლონი იყო წარმოდგენილი. მათ გამოსცადეს მოდელები სიტყვების სინონიმებით, ანტონიმებით ან შემთხვევითი სიტყვებით შეცვლით, მაგრამ შეინარჩუნეს ფუძემდებლური სინტაქსი...
წყარო: news.mit.edu
AI-ით გადამუშავებული


