რეტროსპექტივა: ღია დიდი ენობრივი მოდელები (LLM) 2023 წლამდე
ეს სტატია გთავაზობთ რეტროსპექტივას ღია დიდი ენობრივი მოდელების (LLM) განვითარებაზე, საუბრობს LLM-ების მიღების პროცესზე, მათ არქიტექტურაზე, სავარჯიშო მონაცემთა ნაკრებებზე, ტოკენიზაციაზე, ვარჯიშის ჰიპერპარამეტრებსა და ფაინ-ტიუნინგზე. განსაკუთრებული ყურადღება ეთმობა 2023 წლამდე არსებულ მნიშვნელოვან ღია მოდელებს, როგორიცაა BLOOM და OPT, რომლებიც დიდი როლი ითამაშეს ხელოვნური ინტელექტის საზოგადოების განვითარებაში.
ახალი მიდგომა SDXL Dreambooth LoRA-ს გაწვრთნისთვის: Pivotal Tuning-ისა და Prodigy ოპტიმიზატორის კომბინაცია
Replicate-ის SDXL Cog ტრენერში გამოყენებული Pivotal Tuning ტექნიკისა და Kohya ტრენერში გამოყენებული Prodigy ოპტიმიზატორის (სხვა მრავალ ოპტიმიზაციასთან ერთად) შერწყმით, მიღწეულია შესანიშნავი შედეგები SDXL-ისთვის Dreambooth LoRA-ების გაწვრთნაში. LoRA Dreambooth-ით დახვეწილი SDXL მოდელები საოცარ შედეგებს იძლევა ახალი კონცეფციების დაფიქსირებაში, მცირე რაოდენობის გამოსახულებების გამოყენებით, თანაც ინარჩუნებენ SDXL-ის ესთეტიკასა და ხარისხს და მოითხოვენ შედარებით მცირე გამოთვლით რესურსებს. ტრენინგის სკ
მეგ მიტჩელი ხელოვნური ინტელექტის ეთიკაზე: მონაცემთა მიკერძოებიდან ინკლუზიურ კულტურამდე
ამ ინტერვიუში დოქტორი მარგარეტ (მეგ) მიტჩელი საუბრობს იმ მომენტზე, როდესაც მან გააცნობიერა ეთიკური ხელოვნური ინტელექტის (AI) მნიშვნელობა. ის იზიარებს თავის გამოცდილებას მონაცემთა მავნე მიკერძოებასთან დაკავშირებით, რომელსაც მანქანური სწავლების (ML) გუნდები ხშირად აწყდებიან, და განმარტავს ინკლუზიისა და მრავალფეროვნების სარგებელს AI სისტემების შემუშავებაში. მეგი აღწერს თავის კარიერულ გზას Microsoft-დან Google-მდე, სადაც მან დააარსა ეთიკური AI-ს გუნდი, და შემდეგ Hugging Face-მდე. ის განიხილავს ისეთ

Llama Guard 4 და Prompt Guard 2: ხელოვნური ინტელექტის უსაფრთხოების ახალი მულტიმოდალური მოდელები
წარმოგიდგენთ Llama Guard 4-ს, მულტიმოდალურ მოდელს, რომელიც შექმნილია გამოსახულებებსა და ტექსტში სახიფათო კონტენტის აღმოსაჩენად, მათ შორის „jailbreak“-ის თავიდან ასაცილებლად. მასთან ერთად, Llama Prompt Guard 2 აძლიერებს დაცვას „prompt injection“-ებისა და სხვა მავნე შეტევებისგან, რაც უზრუნველყოფს ხელოვნური ინტელექტის უსაფრთხო და მოქნილ მოდერაციას. ეს მოდელები მნიშვნელოვნად აუმჯობესებენ AI სისტემების დაცვას საწარმოო გარემოში.
რატომ არღვევს Hugging Face-ის Transformers ბიბლიოთეკა DRY პრინციპს?
პროგრამული უზრუნველყოფის განვითარებაში ცნობილი „ნუ გაიმეორებ საკუთარ თავს“ (DRY) პრინციპის მიუხედავად, Hugging Face-ის Transformers ბიბლიოთეკა შეგნებულად უარს ამბობს მის გამოყენებაზე და იყენებს „ერთი მოდელის ფაილის პოლიტიკას“. ეს გადაწყვეტილება მიღებულია გარე კონტრიბუციების წახალისების, კოდის წაკითხვადობის გაუმჯობესების და მანქანური სწავლების სფეროს სწრაფი ევოლუციის გამო, რაც სტანდარტული ლოგიკური შაბლონების განსაზღვრას ართულებს.
Habana Labs და Hugging Face-ი თანამშრომლობენ ტრანსფორმერული მოდელების ტრენინგის დასაჩქარებლად
Habana Labs, ღრმა სწავლის პროცესორების პიონერი, და Hugging Face, ტრანსფორმერული მოდელების ცენტრალური პლატფორმა, აცხადებენ პარტნიორობის შესახებ, რომლის მიზანია მაღალი ხარისხის ტრანსფორმერული მოდელების სწავლების პროცესის გამარტივება, დაჩქარება და გაიაფება. Habana-ს SynapseAI პროგრამული პაკეტის Hugging Face Optimum-ის ღია კოდის ბიბლიოთეკასთან ინტეგრაცია საშუალებას მისცემს მონაცემთა მეცნიერებსა და მანქანური სწავლების ინჟინრებს, ეფექტურად გამოიყენონ Habana Gaudi პროცესორები, შეამცირონ ხარჯები და გაზა
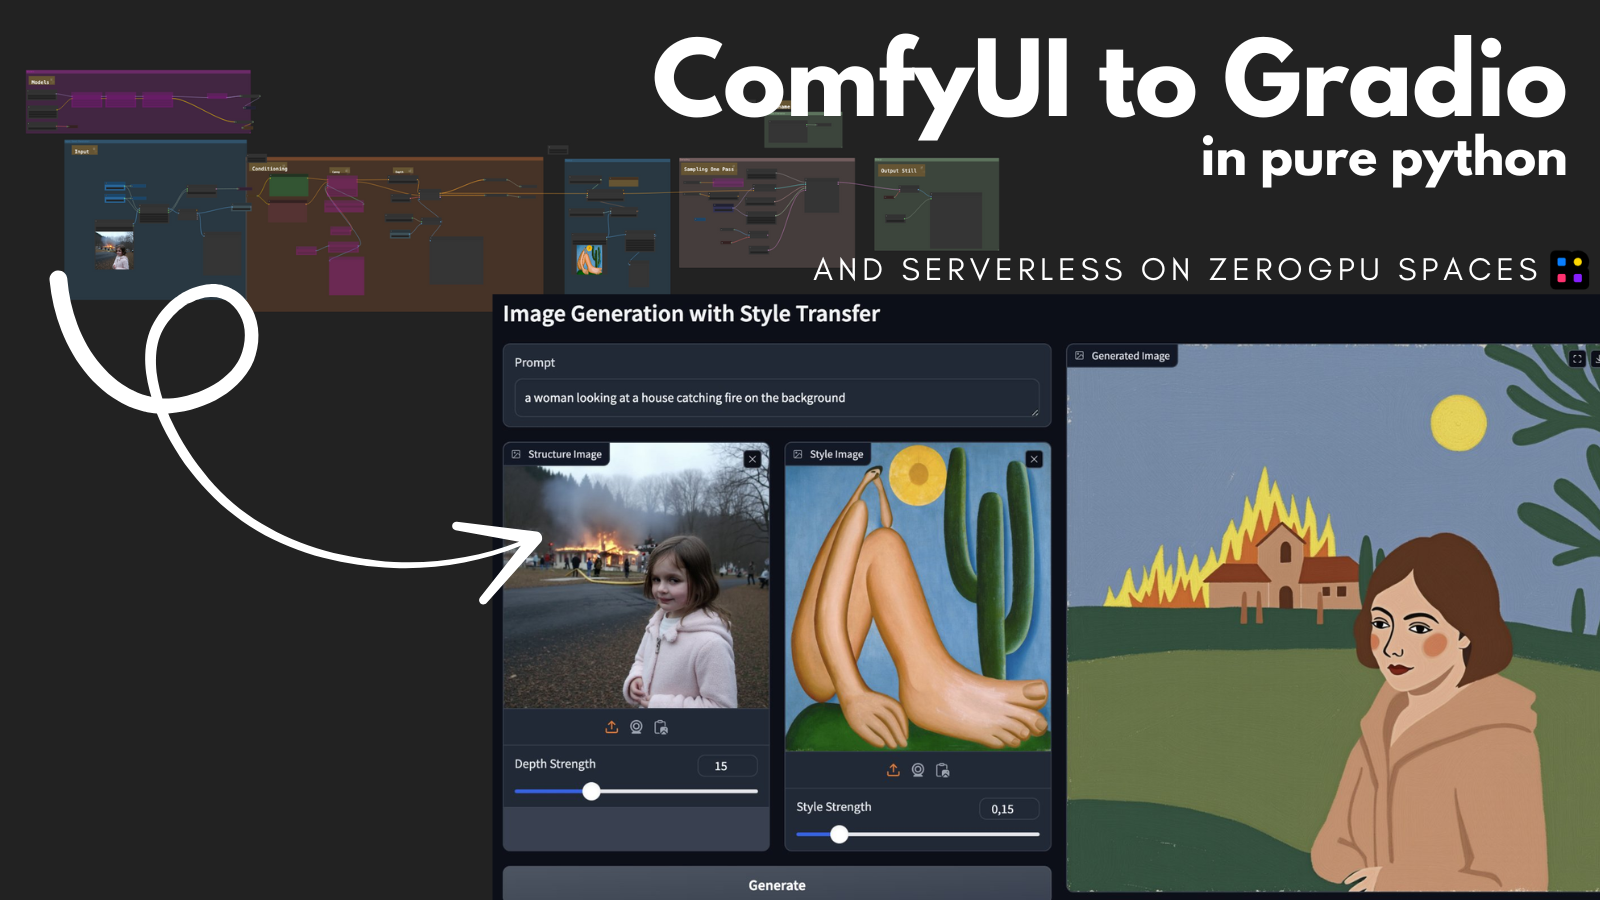
ComfyUI-ის სამუშაო პროცესის Gradio აპლიკაციად გარდაქმნა და Hugging Face Spaces-ზე უფასო განთავსება: სრული გზამკვლევი
ეს გაკვეთილი დეტალურად აღწერს, თუ როგორ უნდა გარდაქმნათ რთული ComfyUI სამუშაო პროცესი მარტივ Gradio აპლიკაციად და განათავსოთ იგი Hugging Face Spaces ZeroGPU სერვერულ სტრუქტურაზე უფასოდ. პროცესი მოიცავს ComfyUI-to-Python-Extension-ის გამოყენებით სამუშაო პროცესის Python სკრიპტად ექსპორტს, Gradio ინტერფეისის შექმნას ექსპორტირებული სკრიპტისთვის და მოდელების Hugging Face-ის ვერსიებთან დაკავშირებას ეფექტური განთავსებისთვის. გაკვეთილი ეფუძნება Nathan Shipley-ის Flux[dev] Redux + Flux[dev] Depth ComfyUI
Hugging Face-ის ინჟინერი ლუის ტანსტალი: ტრანსფორმერები, MLOps და მისი ახალი წიგნი
ამ ინტერვიუში ბრიტნი მალერი ესაუბრება ლუის ტანსტალს, Hugging Face-ის მანქანური სწავლების ინჟინერს. ტანსტალი განიხილავს ტრანსფორმერების გამოყენებას ბიზნეს პროცესების ავტომატიზაციისთვის, მისი წიგნის „NLP ტრანსფორმერებით“ შექმნის პროცესს და ფართომასშტაბიანი ML მოდელების ოპტიმიზაციის გადაწყვეტებს უფრო სწრაფი შეყოვნებისა და მაღალი გამტარუნარიანობის მისაღწევად, მათ შორის ONNX ფორმატის გამოყენებას.

რობოტიკის განზოგადების გამოწვევა: მონაცემების მნიშვნელობა და LeRobot-ის წვლილი
ვიზუალურ-ენობრივ-მოქმედებითი (VLA) მოდელების მიღწევებმა რობოტებს საშუალება მისცა შეასრულონ რთული ამოცანები, თუმცა ჭეშმარიტი განზოგადება ახალ გარემოში კვლავ უდიდეს გამოწვევად რჩება. ეს სტატია ხაზს უსვამს, რომ განზოგადება ძირითადად მონაცემების ფენომენია და არა მხოლოდ მოდელის თვისება. განხილულია არსებული, ხშირად აკადემიური, მონაცემთა ნაკრებების შეზღუდვები და ხაზგასმულია მრავალფეროვანი, რეალური სამყაროს მონაცემების საჭიროება. LeRobot აქტიურად მუშაობს მონაცემთა შეგროვების დემოკრატიზაციაზე, რათა ხელი
მანქანური სწავლების მოდელების ნახშირბადის კვალის თვალყურის დევნება და შემცირება
ეს სტატია განიხილავს მანქანური სწავლების მოდელების ვარჯიშისა და განთავსების ეკოლოგიურ ზემოქმედებას, კერძოდ, მათ ნახშირბადის ემისიებს. წარმოდგენილია ისეთი ხელსაწყოები, როგორიცაა huggingface_hub ბიბლიოთეკა და codecarbon ინტეგრაცია, რომლებიც ხელს უწყობენ ამ ემისიების თვალყურის დევნას, ანგარიშგებას და მართვას, რითაც ხდება ეკო-მეგობრული AI-ის განვითარების ხელშეწყობა.

Hugging Face-ის ინფერენსის საბოლოო წერტილები: Whisper მოდელების საოცარი ოპტიმიზაცია საზოგადოებისთვის
Hugging Face ხსნის თავის ინფერენსის საბოლოო წერტილებს (Inference Endpoints) საზოგადოებისთვის, რაც ხელს უწყობს ღია კოდის წვლილს და AI მოდელების ოპტიმიზებულ განთავსებას. ახალი Whisper-ის საბოლოო წერტილი, vLLM პროექტის გამოყენებით, აჩვენებს თითქმის 8-ჯერ გაუმჯობესებას RTFx-ში, ტრანსკრიფციის ხარისხის დაკარგვის გარეშე. პლატფორმა ასევე გთავაზობთ მოწინავე ოპტიმიზაციებს NVIDIA GPU-ებზე და საშუალებას აძლევს მომხმარებლებს, მარტივად განათავსონ საკუთარი ASR კონვეიერები.

Transformers ბიბლიოთეკა: ხელოვნური ინტელექტის მოდელების ინტეგრაციისა და სტანდარტიზაციის ახალი ეტაპი
Transformers, რომელიც 2019 წელს დაარსდა, გახდა ხელოვნური ინტელექტის მოდელების, განსაკუთრებით დიდი ენობრივი (LLM) და ვიზუალური ენობრივი (VLM) მოდელებთან მუშაობის სტანდარტული ბიბლიოთეკა Python ეკოსისტემაში. ის მხარს უჭერს 300-ზე მეტ არქიტექტურას, აქტიურად თანამშრომლობს სხვა ბიბლიოთეკებთან (როგორიცაა llama.cpp და MLX) თავსებადობის გასაუმჯობესებლად და მიზნად ისახავს წვლილის შეტანის ბარიერის შემცირებას ხელოვნური ინტელექტის საზოგადოებაში, რითაც ხელს უწყობს ეკოსისტემის სტანდარტიზაციას და ფრაგმენტაციის
წამყვანი ML დირექტორების შეხედულებები: ხელოვნური ინტელექტის გავლენა ინდუსტრიებზე
მანქანური სწავლების (ML) და მონაცემთა მეცნიერების დირექტორებს უაღრესად რთული მოთხოვნები აქვთ თავიანთ როლებში. ამ სტატიების სერიაში, ჩვენ წარმოგიდგენთ ML დირექტორების უნიკალურ შეხედულებებს მიმდინარე ML ტენდენციებსა და ინდუსტრიულ განვითარებაზე, დაწყებული ჯანდაცვიდან ფინანსებამდე, ელექტრონულ კომერციამდე და სხვა სფეროებამდე. ისინი გაგვიზიარებენ გამოცდილებას ML-ის პრაქტიკული გამოყენების შესახებ რეალურ სამყაროში, ისეთი ინოვაციების ჩათვლით, როგორიცაა ნახშირბადის ემისიების შემცირება ტრანსპორტირებაში ან
Hugging Face და Google Cloud-ი აძლიერებენ პარტნიორობას ღია AI-ს დემოკრატიზაციისთვის
Hugging Face-ი და Google Cloud-ი ღრმა სტრატეგიულ პარტნიორობას აცხადებენ, რომლის მიზანია კომპანიებს საშუალება მისცეს, შექმნან საკუთარი ხელოვნური ინტელექტი ღია მოდელებისა და ღია კოდის ტექნოლოგიების გამოყენებით. თანამშრომლობა მოიცავს ღია მეცნიერებას, ღია კოდს, ღრუბლოვან სერვისებსა და აპარატურას, რათა მომხმარებლებს გაუმარტივდეს Hugging Face-ის უახლესი ღია მოდელების და Google Cloud-ის ინფრასტრუქტურის (როგორიცაა Vertex AI და TPU) გამოყენება. პარტნიორობა გააძლიერებს AI კვლევის ხელმისაწვდომობას და უზრუნ

Microsoft Azure-ი Hugging Face-თან თანამშრომლობას აფართოებს: 10,000-ზე მეტი AI მოდელი Azure AI Foundry-ზე
Microsoft-მა და Hugging Face-მა გააფართოვეს სტრატეგიული თანამშრომლობა, რის შედეგადაც Azure AI Foundry-ზე 10,000-ზე მეტი Hugging Face-ის ღია მოდელი გახდა ხელმისაწვდომი. ეს ინიციატივა დეველოპერებსა და საწარმოებს საშუალებას აძლევს, მარტივად განათავსონ AI აპლიკაციები ტექსტთან, აუდიოსთან და გამოსახულებებთან სამუშაოდ, ღია კოდის გამჭვირვალობისა და Azure-ის უსაფრთხო, საწარმოო დონის ინფრასტრუქტურის გამოყენებით. თანამშრომლობა მიზნად ისახავს AI-ის ინოვაციის დაჩქარებას და ორგანიზაციებს საკუთარი AI ბედის კონ

დიდი ML მოდელების ეფექტური ვარჯიში: PyTorch FSDP-ის გამოყენება განაწილებულ სისტემებში
მანქანური სწავლების (ML) მოდელების მზარდი ზომისა და პარამეტრების გამო, სპეციალისტებს უჭირთ მათი ვარჯიში სტანდარტულ აპარატურაზე, მიუხედავად იმისა, რომ დიდი მოდელები უფრო სწრაფად სწავლობენ და მაღალ წარმადობას ავლენენ. ამ გამოწვევის საპასუხოდ, განაწილებული სწავლება ხდება გადამწყვეტი. ეს სტატია იკვლევს მონაცემთა პარალელიზმს ZeRO კონცეფციის გამოყენებით და კონკრეტულად PyTorch-ის უახლეს ფუნქციას, FullyShardedDataParallel (FSDP)-ს. DeepSpeed-ისა და FairScale-ის მიერ დანერგილი ZeRO-ის იდეები, PyTorch-ში
დიდი ენობრივი მოდელების „ჰალუცინაციების“ საზომი ლიდერბორდი
„ჰალუცინაციების ლიდერბორდი“ წარმოადგენს ყოვლისმომცველ ღია პლატფორმას, რომელიც კონტექსტური სწავლების მეშვეობით აფასებს დიდი ენობრივი მოდელების (LLMs) მიერ გენერირებულ კონტენტში არსებულ „ჰალუცინაციებს“. ეს პროექტი, რომელზეც უკვე გამოქვეყნებულია სამეცნიერო ნაშრომი, მიზნად ისახავს ხელოვნური ინტელექტის სანდოობის გაუმჯობესებას. „ჰალუცინაციები“ იყოფა ფაქტობრივ (როცა მოდელი რეალურ ფაქტებს ეწინააღმდეგება) და ერთგულების (როცა კონტენტი არ ემთხვევა მომხმარებლის ინსტრუქციებს ან კონტექსტს) ტიპებად. ლიდერბორდი

წარმოგიდგენთ nanoVLM-ს: მარტივი გზა ვიზუალური ენის მოდელების შესაქმნელად
nanoVLM არის ხელსაწყოების ნაკრები, რომელიც შთაგონებულია Andrej Karpathy-ის nanoGPT-ით, მაგრამ შექმნილია ვიზუალური სფეროსთვის. ის საშუალებას გაძლევთ შექმნათ და გაავარჯიშოთ მოდელები, რომლებსაც შეუძლიათ გამოსახულებებისა და ტექსტის გაგება, შემდეგ კი ამის საფუძველზე ტექსტის გენერირება. პროექტი გამოირჩევა სიმარტივითა და კოდის წაკითხვადობით, რაც მას იდეალურს ხდის დამწყებთათვის. nanoVLM ძირითადად ფოკუსირებულია ვიზუალურ კითხვა-პასუხზე (Visual Question Answering) და აგებულია Google-ის SigLIP-ისა და Llama

Hugging Face Diffusers-ის კვანტიზაცია: მეხსიერების ოპტიმიზაცია და მოდელების ხელმისაწვდომობა
ეს სტატია იკვლევს Hugging Face Diffusers-ში ინტეგრირებულ სხვადასხვა კვანტიზაციის ბეკენდს, მათ შორის bitsandbytes, GGUF, torchao, Quanto და FP8 Layerwise Casting. იგი განმარტავს, თუ როგორ უწყობს ხელს ეს ტექნიკები დიდი და მძლავრი მოდელების (მაგ. Flux) მეხსიერების ოპტიმიზაციას და მათ ხელმისაწვდომობას, ხშირად ხარისხის მინიმალური ან შეუმჩნეველი დანაკარგით. ასევე განიხილება დამატებითი ოპტიმიზაციის მეთოდები, როგორიცაა CPU offloading და group offloading.

Falcon-H1: ხელოვნური ინტელექტის მოდელების ინოვაციური სერია ჰიბრიდული არქიტექტურით
წარმოგიდგენთ Falcon-H1 სერიას, ექვს ღია კოდის მოდელს 0.5B-დან 34B პარამეტრამდე, რომლებიც ხელმისაწვდომია როგორც საბაზო, ასევე ინსტრუქციებზე მორგებულ ვარიანტებში. ამ მოდელების გულში დგას ჰიბრიდული არქიტექტურა, რომელიც აერთიანებს კლასიკური ტრანსფორმერზე დაფუძნებული ყურადღების მექანიზმისა და მდგომარეობის სივრცის მოდელის (SSM) ძლიერ მხარეებს. ეს ინოვაციური მიდგომა უზრუნველყოფს უპრეცედენტო წარმადობას, მაღალ ეფექტურობას და ფართო მასშტაბურობას, რაც Falcon-H1-ს კონკურენტუნარიანს ხდის წამყვან ტრანსფორმერზ
Hugging Face Optimum: ტრანსფორმერების მოდელების ტრენინგისა და ინფერენსის დაჩქარება
BERT-ისა და Transformer-ის მოდელების გამოყენება სულ უფრო იზრდება სხვადასხვა სფეროში, თუმცა ისინი ხშირად ნელი და მოცულობითია. Hugging Face-მა შექმნა Optimum – გაფართოება, რომელიც ამ მოდელების ტრენინგსა და ინფერენსს აჩქარებს. Optimum უზრუნველყოფს ოპტიმიზებულ შესრულებას დაჩქარებულ აპარატურაზე, მათ შორის ONNX Runtime-თან ინტეგრაციით, რაც მომხმარებლებს საშუალებას აძლევს მარტივად გადავიდნენ სტანდარტული Transformers API-დან ოპტიმიზებულ ვერსიაზე, მოდელების კვანტიზაციისა და გრაფის ოპტიმიზაციის ჩათვლით.
Hugging Face აცხადებს სტუდენტური ამბასადორების პროგრამას მანქანური სწავლების დემოკრატიზაციისთვის
Hugging Face-ი იწყებს სტუდენტური ამბასადორების პროგრამას, რომლის მიზანია 2023 წლისთვის 5 მილიონ ადამიანს ასწავლოს მანქანური სწავლება. პროგრამა სთავაზობს ქსელს, ვორქშოფებს, ინსაიტებს და აღიარებას იმ სტუდენტებს, რომელთაც სურთ წვლილი შეიტანონ მანქანური სწავლების დემოკრატიზაციაში. განაცხადის შეტანის ბოლო ვადაა 2022 წლის 13 ივნისი.
ხელოვნური ინტელექტის მორგება ღია მოდელებზე: კონსტიტუციური AI და ახალი ინსტრუმენტი llm-swarm
სტატია წარმოგიდგენთ კონსტიტუციურ ხელოვნურ ინტელექტს (CAI), როგორც დიდი ენობრივი მოდელების (LLMs) მომართვის ინოვაციურ ტექნიკას მომხმარებლის მიერ განსაზღვრული პრინციპების გამოყენებით, რაც მნიშვნელოვნად ამცირებს ძვირადღირებული ადამიანური უკუკავშირის საჭიროებას. იგი გვთავაზობს CAI-ის ღია მოდელებით განხორციელების სრულყოფილ გზამკვლევს, მათ შორის ახალ ინსტრუმენტ llm-swarm-ს მასშტაბური სინთეზური მონაცემების გენერირებისთვის. განხილულია CAI მონაცემთა ნაკრებების შექმნისა და მოდელების, მაგალითად Mistral-7B-
კონსტიტუციური ხელოვნური ინტელექტი: ღია მოდელების თვითგასწორება და ახალი ინსტრუმენტი „llm-swarm“
Anthropic-ის მიერ შემოთავაზებული კონსტიტუციური ხელოვნური ინტელექტის (CAI) ტექნიკა LLM-ებს აძლევს საშუალებას, თავად შეაფასონ და გააუმჯობესონ საკუთარი გამომუშავება მომხმარებლის მიერ განსაზღვრული პრინციპების მიხედვით. ეს მიდგომა მნიშვნელოვნად ამცირებს ძვირადღირებული ადამიანური უკუკავშირის საჭიროებას. მოცემულ ნაშრომში აღწერილია კონსტიტუციური AI-ის სრულყოფილი განხორციელების რეცეპტი ღია მოდელებით, ასევე წარმოდგენილია ახალი ინსტრუმენტი „llm-swarm“, რომელიც GPU Slurm კლასტერებს იყენებს სკალირებადი სინთე