
AI ბუმს თანმდევი მონაცემთა ცენტრების წინააღმდეგ წინააღმდეგობა იზრდება - სახელმწიფოები აკრძალვებს განიხილავენ
AI-ის ბუმთან ერთად მონაცემთა ცენტრების რაოდენობის ზრდამ ამერიკის შეერთებულ შტატებში ფართო უკმაყოფილება გამოიწვია. რამდენიმე შტატი და ადგილობრივი საზოგადოება ახალი მონაცემთა ცენტრების მშენებლობის დროებით აკრძალვას ან მორატორიუმს განიხილავს, ზოგი კი უკვე ახორციელებს. პოლიტიკური სპექტრის წარმომადგენლები, როგორიცაა რესპუბლიკელი გუბერნატორი რონ დესანტისი და სენატორი ბერნი სანდერსი, ამ საკითხზე აქტიურად საუბრობენ. მიუხედავად იმისა, რომ ტექნოლოგიური კომპანიები დიდ ინვესტიციებს ახორციელებენ ინფრასტრუქტუ

გიორგი გერგანოვის გუნდი Hugging Face-ს უერთდება: ახალი ეტაპი ადგილობრივი AI-ის განვითარებაში
გიორგი გერგანოვი და მისი გუნდი, რომლებიც დგანან ggml-ისა და llama.cpp-ის პროექტების უკან, უერთდებიან Hugging Face-ს. ეს ნაბიჯი მიზნად ისახავს ადგილობრივი ხელოვნური ინტელექტის (AI) ექსპონენციურ განვითარებას მომდევნო წლებში, პროექტის გრძელვადიანი, მდგრადი რესურსებით უზრუნველყოფას და მისი ღია კოდის ბუნების შენარჩუნებას. გუნდი სრულ ავტონომიას შეინარჩუნებს ტექნიკურ მიმართულებებსა და საზოგადოებასთან მუშაობაში.
Reddit-ი ახალ AI საძიებო ინსტრუმენტს ატესტებს: საზოგადოების რეკომენდაციები ელექტრონულ კომერციას ხვდება
Reddit-მა ხუთშაბათს გამოაცხადა, რომ ატარებს ხელოვნური ინტელექტის ახალი საძიებო ინსტრუმენტის ტესტირებას, რომელიც საზოგადოების რეკომენდაციებს კომპანიის სავაჭრო პარტნიორების პროდუქტებს უკავშირებს. აშშ-ში მომხმარებელთა მცირე ჯგუფი დაინახავს საძიებო შედეგებს ინტერაქტიული პროდუქტის კარუსელებით, რომლებიც შეიცავს ფასებს, სურათებს და პირდაპირ ყიდვის ბმულებს. ეს ნაბიჯი ასახავს Reddit-ის სტრატეგიულ მიზანს, დააკავშიროს თავისი საზოგადოებაზე ორიენტირებული პლატფორმა ელექტრონული კომერციის შესაძლებლობებთან და გა

Orbitiny: Linux-ის ახალი, პორტატული დესკტოპის გარემო, რომელიც არსებულ DE-ებზე მუშაობს
Linux-ის საზოგადოებამ კვლავ გაგვაოცა ახალი დესკტოპის გარემოთი, სახელწოდებით Orbitiny. ნულიდან Qt-სა და C++-ის გამოყენებით შექმნილი, Orbitiny გამოირჩევა იმით, რომ ის მუშაობს არსებულ დესკტოპის გარემოებზე (როგორიცაა KDE Plasma ან GNOME) ჩვეულებრივი აპლიკაციის მსგავსად. ის ასევე პორტატულია და USB დისკიდანაც კი იწყება. მიუხედავად იმისა, რომ ჯერ კიდევ დამუშავების პროცესშია, Orbitiny უკვე სტაბილურობითა და სისწრაფით გამოირჩევა, რაც მას Linux-ის მომხმარებლებისთვის პერსპექტიულ გადაწყვეტად აქცევს.
ხელოვნური ინტელექტის ლაბორატორიებიდან განგაშის სიგნალები: ინსაიდერები AI-ის საფრთხეებზე საუბრობენ
ტექნოლოგიურ სამყაროში ხელოვნური ინტელექტის შესახებ ყველაზე მნიშვნელოვანი დისკუსიები კონფერენციების დარბაზებს გარეთ მიმდინარეობს, სადაც AI ლაბორატორიების ინსაიდერები განგაშს ტეხენ. ისინი აფრთხილებენ მოდელების სწრაფ განვითარებას, რომლებსაც სულ უფრო ნაკლები ადამიანური ჩარევა სჭირდებათ, და სვამენ კითხვას – უნდა მოვუსმინოთ თუ არა მათ? ეს გაფრთხილებები მოიცავს თანამდებობიდან გადადგომებსაც უსაფრთხოების პროტოკოლების შესუსტების გამო და მიუთითებს პოტენციურ ფართო სტრუქტურულ გავლენაზე საზოგადოებაზე.
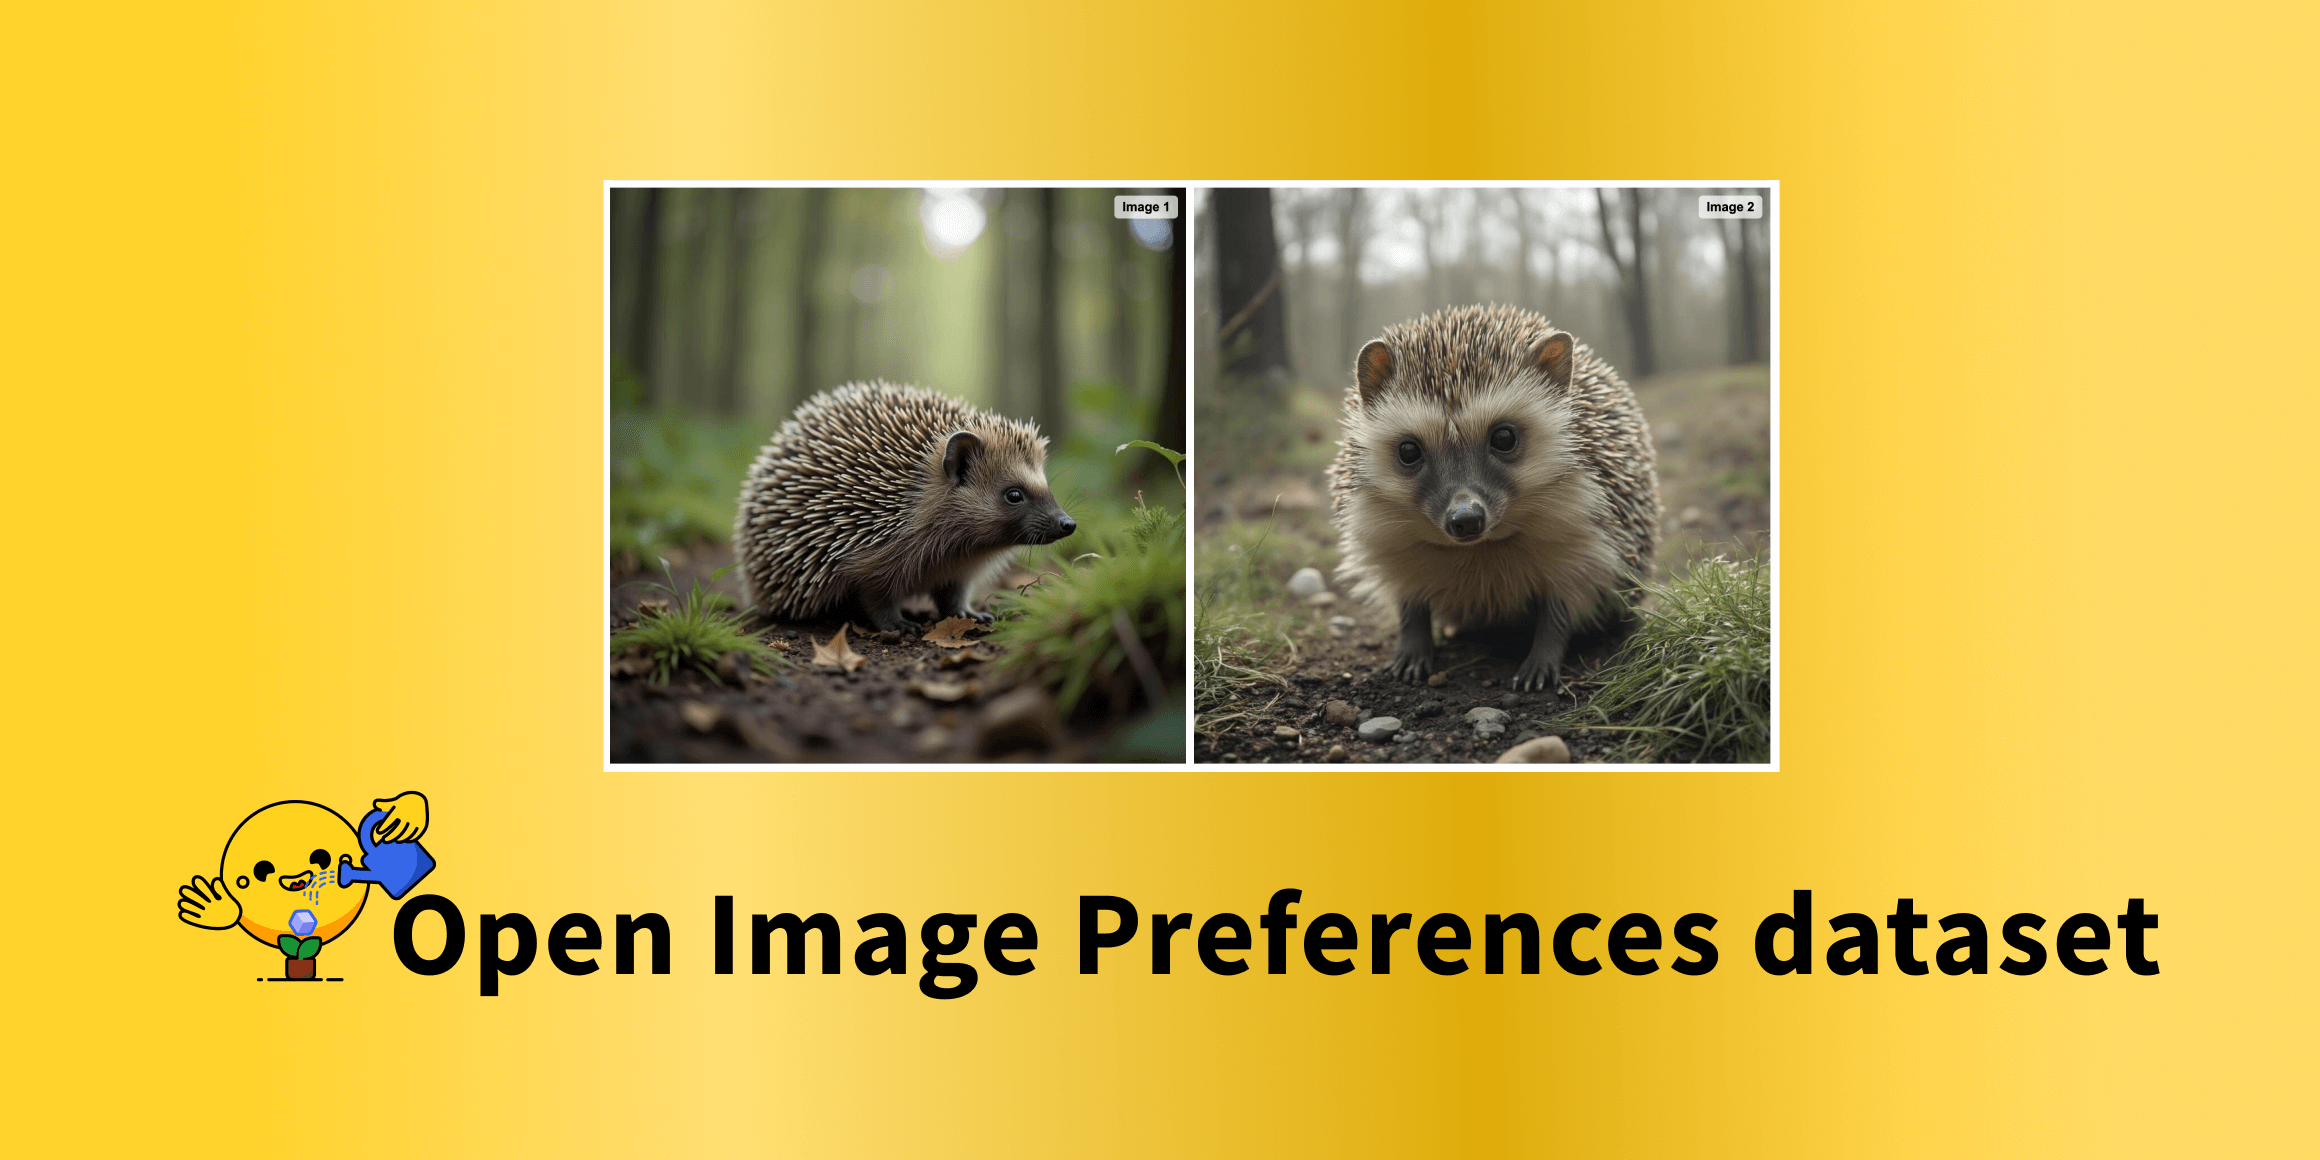
„მონაცემები ერთად უკეთესია“: Hugging Face და ღია კოდის AI საზოგადოება რევოლუციას ახდენენ გამოსახულების გენერაციაში
სტატია აღწერს Hugging Face-ისა და ღია კოდის AI საზოგადოების ერთობლივ პროექტს, სახელწოდებით „მონაცემები ერთად უკეთესია“, რომელიც მიზნად ისახავს ღია კოდის ეფექტური მონაცემთა ნაკრებების შექმნას. მნიშვნელოვანი მიღწევაა `open-image-preferences-v1`, უნიკალური გამოსახულების უპირატესობის მონაცემთა ნაკრები, რომელიც გამოირჩევა მრავალფეროვანი პრომპტებითა და ღია განვითარებით. მონაცემთა ნაკრები დეტალურად შეიქმნა სინთეზური მონაცემების გენერაციის, ტოქსიკურობის მოწინავე ფილტრაციისა და Flux-ისა და Stable Diffusi

LLaMA-ს MMLU შეფასება: უთანხმოება ხელოვნური ინტელექტის მოდელების რეიტინგში
Open LLM ლიდერბორდზე LLaMA მოდელის MMLU (Massive Multitask Language Understanding) შეფასების ქულები გაცილებით დაბალი აღმოჩნდა, ვიდრე მის გამოქვეყნებულ ნაშრომში იყო მითითებული. ამან საზოგადოებაში გაკვირვება გამოიწვია. გამოძიებამ გამოავლინა MMLU შეფასების სხვადასხვა იმპლემენტაცია, მათ შორის EleutherAI Harness, ორიგინალი UC Berkeley-ის კოდი და Stanford HELM, რომლებიც განსხვავებულ შედეგებს იძლევა და მოდელების რეიტინგსაც კი ცვლის. სტატია დეტალურად განმარტავს ამ შეუსაბამობის მიზეზებს და დიდი ენობრივი

ღია კოდის ვიდეო გენერაციის მოდელების აღზევება: დგას თუ არა AI „Stable Diffusion-ის მომენტის“ ზღურბლზე?
ბოლო დროს შეინიშნება ღია კოდის ვიდეოს გენერაციის მოდელების, მათ შორის CogVideoX, Mochi-1, Hunyuan და LTX Video-ს სწრაფი ზრდა, რაც ბადებს კითხვას, დგას თუ არა ვიდეო საზოგადოება ხელოვნური ინტელექტის „Stable Diffusion-ის მომენტის“ ზღურბლზე. ეს სტატია მიმოიხილავს ვიდეოს გენერაციის მოდელების მიმდინარე მდგომარეობას, ხაზს უსვამს ისეთ შეზღუდვებს, როგორიცაა მოძრაობის ხარისხი, დროითი თანმიმდევრულობა და მეხსიერების მაღალი მოთხოვნები. Diffusers-ის გუნდი აქტიურად მუშაობს ამ გამოწვევების გადასაჭრელად სხვადასხ
ხელოვნური ინტელექტის ვიდეო გენერაციის მოდელები: მიმდინარე მდგომარეობა და ოპტიმიზაციის გზები
ღია კოდის პროექტებში ვიდეოს გენერაციის მოდელების სწრაფი განვითარება შეინიშნება, რამაც შეიძლება გამოიწვიოს „Stable Diffusion მომენტის“ განმეორება ვიდეო საზოგადოებაში. ეს სტატია მიმოიხილავს ვიდეოს გენერაციის მოდელების მიმდინარე მდგომარეობას, მათ შეზღუდვებს (კერძოდ, მოძრაობის ხარისხს, თანმიმდევრულობასა და კონსისტენტურობას დროის განმავლობაში) და არქიტექტურულ თავისებურებებს, როგორიცაა 3D ვიდეო ტოკენების დამუშავება. ყურადღება ექცევა Diffusers-ის გუნდის მიერ შემოთავაზებულ მეხსიერების ოპტიმიზაციის ტექნი
DeepSeek-R1-ის გარღვევა მსჯელობის მოდელებში და Open-R1 პროექტი: საიდუმლოების გამჟღავნებისკენ
DeepSeek-R1-ის ახალი მოდელი, რომელიც OpenAI-ის o1-ს უტოლდება ან აღემატება, დეტალური ტექნიკური ანგარიშით გამოვიდა, რამაც ხელოვნური ინტელექტის საზოგადოებაში დიდი აჟიოტაჟი გამოიწვია. მოდელი ეფუძნება ინოვაციურ მიდგომას, მათ შორის გაძლიერებულ სწავლებას ადამიანის ზედამხედველობის გარეშე. თუმცა, DeepSeek-მა არ გაასაჯაროვა თავისი მონაცემთა ნაკრებები და კოდი, რამაც Open-R1 პროექტი გააჩინა, რომელიც მიზნად ისახავს DeepSeek-R1-ის „რეცეპტის“ რეკონსტრუქციას, გამჭვირვალობის გაზრდას და ღია წყაროს მსჯელობის მოდელ
OpenAI-მ Deep Research გამოუშვა: ვებ-დათვალიერების სისტემა და ღია კოდით მისი რეპროდუცირების მცდელობები
OpenAI-მ წარმოადგინა „Deep Research“ – ინოვაციური სისტემა, რომელიც ვებ-კონტენტს აჯამებს და კითხვებზე პასუხობს. სისტემამ შთამბეჭდავი შედეგები აჩვენა General AI Assistants (GAIA) ბენჩმარკზე, მიაღწია თითქმის 67%-იან სიზუსტეს საშუალოდ და 47.6%-ს რთულ „დონე 3“ კითხვებზე. Deep Research აგებულია დიდ ენობრივ მოდელზე (LLM) და აგენტურ ჩარჩოზე, რომელიც მას ინსტრუმენტების გამოყენებაში ეხმარება. მიუხედავად OpenAI-ს მიერ აგენტური ჩარჩოს დეტალების არგამჟღავნებისა, ღია კოდის საზოგადოებამ 24-საათიანი მისია დაიწყ

ვიდეო გენერაციის მონაცემთა ნაკრებების შექმნა: ახალი ინსტრუმენტები საზოგადოებისთვის
ამ სტატიაში განვიხილავთ ვიდეო გენერაციის მონაცემთა ნაკრებების შექმნისთვის შემუშავებულ ახალ ინსტრუმენტებს, რომლებიც მიზნად ისახავს ამ პროცესის გამარტივებას, სურათების გენერაციის მსგავსად. წარმოდგენილია ღია კოდის სკრიპტები მცირე მასშტაბისთვის და video2dataset დიდი მასშტაბისთვის. დეტალურად აღიწერება მონაცემთა დამუშავების 3-ეტაპიანი კონვეიერი, ფილტრაციის სტრატეგიები (მათ შორის pwatermark-ისა და ესთეტიკური ქულების გამოყენებით) და მათი გავლენა ვიდეო გენერაციის მოდელების ხარისხზე. მიზანია, საზოგადოებას

Sentence Transformers v2: რევოლუციური განახლებები და ინტეგრაცია Hugging Face Hub-თან
Sentence Transformers-ის v2 ვერსიის გამოშვება ახალ შესაძლებლობებს გვთავაზობს წინადადების, აბზაცისა და გამოსახულების ემბედინგებისთვის. განახლება მოიცავს Hugging Face Hub-თან ღრმა ინტეგრაციას, 90-ზე მეტი წინასწარ გაწვრთნილი მოდელით 100-ზე მეტი ენისთვის. წარმოდგენილია ახალი ვიჯეტები – ფუნქციის ექსტრაქციისა და წინადადების მსგავსების გამოსათვლელად, ასევე API ინტერფეისები მოდელებთან პროგრამული წვდომისთვის, რაც საზოგადოებას საშუალებას აძლევს მარტივად გააზიაროს და გამოიყენოს თავისი გაწვრთნილი მოდელები.

Hugging Face Hub-ის უსაფრთხოება JFrog-ის სკანერის ინტეგრაციით ძლიერდება
Hugging Face-მა JFrog-ის სკანერი თავის პლატფორმაზე დაამატა, რათა Hugging Face Hub-ზე უსაფრთხოება გააუმჯობესოს. ახალი სკანერი ამცირებს ცრუ დადებით შედეგებს და მოდელის წონებში არსებულ კოდს ღრმად აანალიზებს პოტენციური მავნე გამოყენების გამოსავლენად, განსაკუთრებით ისეთი მოწყვლადი სერიალიზაციის ფორმატებისთვის, როგორიცაა Pickle. ყველა საჯარო მოდელის რეპოზიტორი ავტომატურად დასკანირდება, რაც საზოგადოებას მოდელების უსაფრთხოდ გაზიარებაში ეხმარება.
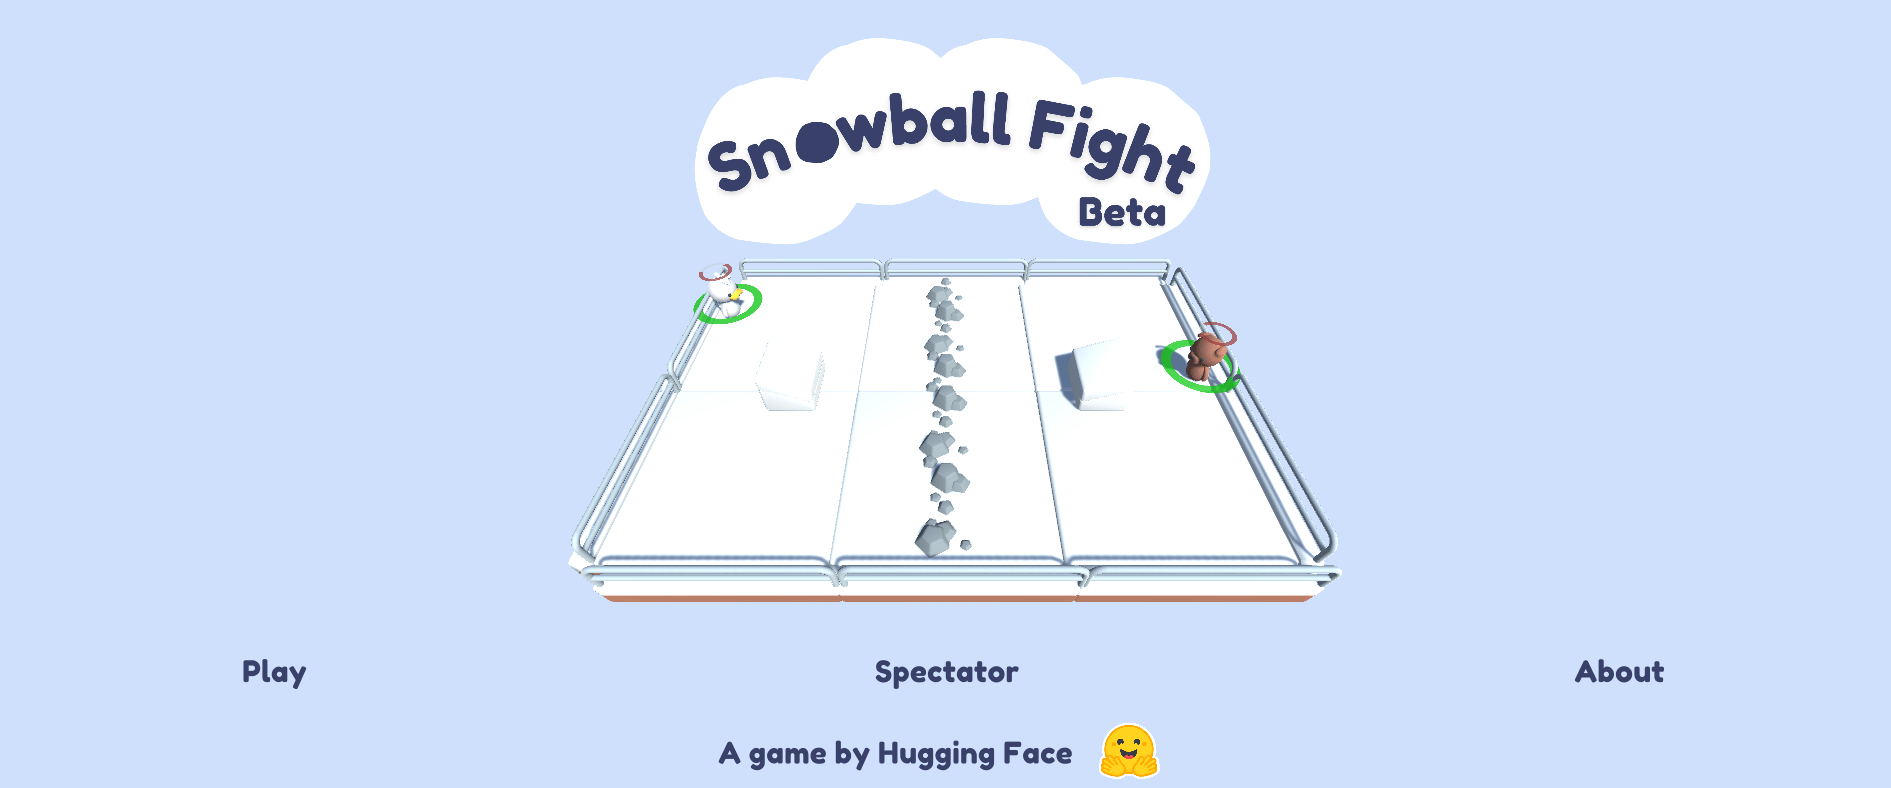
Hugging Face-ი აფართოებს Deep Reinforcement Learning-ის ეკოსისტემას Unity ML-Agents-ით: ახალი თამაში და საზოგადოება
Hugging Face-ი, Unity ML-Agents-ის გამოყენებით, ღრმა გაძლიერებითი სწავლების მკვლევრებისა და ენთუზიასტებისთვის ეკოსისტემას აფართოებს. ამ ინიციატივის ფარგლებში წარმოდგენილია თამაში „Snowball Fight“ და ახალი Discord სერვერი საზოგადოების ჩართულობისთვის.

Hugging Face-ის სასწავლო პლატფორმის მასშტაბური განახლება: NLP კურსი ახლა LLM კურსია
Hugging Face აცხადებს hf.co/learn პლატფორმის მასშტაბურ განახლებას, რომლის ფარგლებშიც პოპულარული NLP კურსი LLM კურსად გარდაიქმნა. ეს ცვლილება ასახავს ხელოვნური ინტელექტის სფეროში მიმდინარე სწრაფ განვითარებას, ამატებს ახალ თავებს დიდი ენობრივი მოდელების დახვეწასა და მსჯელობის მოდელების შექმნაზე, აფართოებს საზოგადოებასთან თანამშრომლობას და გეგმავს სერტიფიცირების პროგრამას მომავალში.
Stable-Baselines3-ისა და Hugging Face Hub-ის ინტეგრაცია: მოდელების განთავსება, ჩატვირთვა და გაზიარება
ეს სტატია წარმოგიდგენთ Stable-Baselines3-ისა და Hugging Face Hub-ის ინტეგრაციას, რაც მომხმარებლებს საშუალებას აძლევს მარტივად განათავსონ, ჩატვირთონ და გააზიარონ ღრმა განმტკიცებითი სწავლის მოდელები. მოცემულია სახელმძღვანელო, თუ როგორ გამოიყენოთ ეს ახალი ფუნქციონალი, მათ შორის საჭირო ბიბლიოთეკების ინსტალაცია, საზოგადოების მოდელების პოვნა, გაწვრთნილი აგენტების ატვირთვა და საზოგადოებასთან ურთიერთობა ეკოსისტემის სამომავლო გაფართოებისთვის.

Hugging Face აძლიერებს ხელოვნური ინტელექტის მოდელების გაშვებას Whisper-ის დახმარებით: საზოგადოება და ეფექტურობა ცენტრში
Hugging Face-ი თავის Inference Endpoints-ს უფრო საზოგადოებაზე ორიენტირებულს ხდის, რაც ნებისმიერს აძლევს საშუალებას, წვლილი შეიტანოს ხელოვნური ინტელექტის მოდელების ეფექტურ განლაგებაში. განსაკუთრებული ყურადღება ექცევა Whisper მოდელებს, რომელთა გაშვებაც ოპტიმიზებულია vLLM-ის, CUDA-ს გრაფიკების და დინამიური კვანტიზაციის გამოყენებით, რის შედეგადაც Whisper Large V3-ისთვის შესრულების სიჩქარე (RTFx) თითქმის 8-ჯერ იზრდება. პლატფორმა უზრუნველყოფს მარტივ განლაგებას და რეალურ დროში ტრანსკრიფციის აპლიკაციები

Transformers ბიბლიოთეკა: ხელოვნური ინტელექტის მოდელების ინტეგრაციისა და სტანდარტიზაციის ახალი ეტაპი
Transformers, რომელიც 2019 წელს დაარსდა, გახდა ხელოვნური ინტელექტის მოდელების, განსაკუთრებით დიდი ენობრივი (LLM) და ვიზუალური ენობრივი (VLM) მოდელებთან მუშაობის სტანდარტული ბიბლიოთეკა Python ეკოსისტემაში. ის მხარს უჭერს 300-ზე მეტ არქიტექტურას, აქტიურად თანამშრომლობს სხვა ბიბლიოთეკებთან (როგორიცაა llama.cpp და MLX) თავსებადობის გასაუმჯობესებლად და მიზნად ისახავს წვლილის შეტანის ბარიერის შემცირებას ხელოვნური ინტელექტის საზოგადოებაში, რითაც ხელს უწყობს ეკოსისტემის სტანდარტიზაციას და ფრაგმენტაციის
Hugging Face-ის ფელოუშიპის პროგრამა: ღია წყაროს კონტრიბუტორების მხარდაჭერა და გავლენის გაზრდა
Hugging Face-ის ფელოუშიპის პროგრამა მიზნად ისახავს ღია წყაროს მანქანური სწავლების კონტრიბუტორების გაძლიერებას. პროგრამა სთავაზობს რესურსებს, აღიარებას და დამხმარე საზოგადოებას, რათა მონაწილეებმა გაზარდონ თავიანთი გავლენა და განახორციელონ ის პროექტები, რაზეც ყოველთვის ოცნებობდნენ. ფელოუშიპი მხარს უჭერს მრავალფეროვნებას და მიესალმება ნებისმიერი წარმომავლობის მქონე პირებს, ხაზს უსვამს ინდივიდუალურ წვლილს სფეროს დემოკრატიზაციაში.
TTS Arena: მეტყველების სინთეზის მოდელების შეფასების დემოკრატიზაცია
მეტყველების სინთეზის სფეროში დიდი ხანია არ არსებობდა მოდელების ხარისხის ზუსტი გაზომვის მეთოდი. არსებული ობიექტური და სუბიექტური მეთოდები არაეფექტურია მსგავსი ხარისხის მოდელების შესადარებლად. ამ გამოწვევის საპასუხოდ, შეიქმნა TTS Arena, სადაც საზოგადოებას შეუძლია შეაფასოს სინთეზირებული აუდიო და დაეხმაროს მოდელების რანჟირების დემოკრატიზაციას. პლატფორმა იყენებს ადამიანის შეფასებას, მსგავსად Chatbot Arena-ისა, მოდელების ობიექტური შედარებისთვის.
Hugging Face და Argilla: ერთობლივი ძალებით უკეთესი მონაცემთა ბაზებისთვის
Hugging Face და Argilla ერთობლივ ინიციატივას იწყებენ, რათა საზოგადოებას დაეხმარონ მაღალი ხარისხის მონაცემთა ბაზების შექმნაში, განსაკუთრებით ნაკლებად წარმოდგენილი ენებისა და ამოცანებისთვის. პროექტი გულისხმობს ინსტრუმენტების, როგორიცაა Argilla და Hugging Face Spaces, გამოყენებას ანოტაციის პროცესის გასამარტივებლად. მოწვეულნი არიან დაინტერესებული თემები, რათა შეუერთდნენ საწყის კოჰორტას და წვლილი შეიტანონ ხელოვნური ინტელექტის განვითარებაში, კოდირების ცოდნის გარეშეც.
UCLA-ს მკვლევრებმა LMM-ების შესაფასებლად კონტექსტზე მგრძნობიარე ვიზუალური ამოცანების ახალი მონაცემთა ბაზა – ConTextual შექმნეს
კალიფორნიის უნივერსიტეტის ლოს-ანჯელესის (UCLA) მკვლევრებმა წარმოადგინეს ConTextual – ინოვაციური მონაცემთა ბაზა, რომელიც მიზნად ისახავს დიდი მულტიმოდალური მოდელების (LMMs) კონტექსტზე მგრძნობიარე, ტექსტით მდიდარი ვიზუალური მსჯელობის შესაძლებლობების შეფასებას. ეს მონაცემთა ბაზა 506 რთულ ინსტრუქციას მოიცავს 8 რეალური სამყაროს სცენარში, რათა შეავსოს არსებული შეფასების მეთოდების ხარვეზები, რომლებიც ხშირად უგულებელყოფენ კონტექსტის გაგებას. პროექტის ფარგლებში ასევე შეიქმნა ლიდერბორდი, სადაც საზოგადოებას

როგორ გავუშვათ მოწინავე ხელოვნური ინტელექტის მოდელები ჩვეულებრივ ლეპტოპებზე?
თანამედროვე დიდი ენობრივი მოდელები (LLM) ძლიერ აპარატურას მოითხოვს, რაც ხელმისაწვდომი ლეპტოპებისთვის გამოწვევას წარმოადგენს. თუმცა, ხელოვნური ინტელექტის საზოგადოება აქტიურად მუშაობს მოდელების ზომის შემცირებაზე და მათ ოპტიმიზაციაზე. ამ მიზნის მისაღწევად გამოიყენება სამი ძირითადი მიდგომა: აპარატურული აჩქარება (მათ შორის Intel-ის ახალი NPU), მცირე ენობრივი მოდელები (SLM) და კვანტიზაცია. ამ სტატიაში განხილულია, თუ როგორ შეიძლება Microsoft Phi-2 მოდელის 4-ბიტიანი კვანტიზაცია Intel OpenVINO-სა და Opti