
დიდი ენობრივი მოდელების (LLMs) ნახშირბადის კვალი: ოფიციალური ვერსიები vs. საზოგადოებრივი „ფაინ-ტიუნები“
ბოლო ერთი წლის განმავლობაში, გაიზარდა ცნობიერება იმის შესახებ, რომ დიდი ენობრივი მოდელების (LLMs) გამოყენებას ტექსტის გენერირებისთვის მნიშვნელოვანი გარემოსდაცვითი გავლენა აქვს, განსაკუთრებით ინფერენციის ფაზაში. Open LLM Leaderboard-ში ნახშირბადის ემისიების შეფასებების ინტეგრირებით, მიზანია გამჭვირვალობის უზრუნველყოფა და მოდელების შემქმნელების წახალისება, დააბალანსონ შესრულება გარემოსდაცვით პასუხისმგებლობასთან. კვლევამ გამოავლინა, რომ საზოგადოების მიერ შექმნილი „ფაინ-ტიუნები“ ხშირად უფრო ნახშირბა
ენკოდერ-დეკოდერ მოდელების ეფექტური წვრთნა: წინასწარ გაწვრთნილი კომპონენტების გამოყენების უპირატესობები
ახალი კვლევა გვთავაზობს ენკოდერ-დეკოდერ მოდელების წვრთნის ინოვაციურ მეთოდს, რომელიც მნიშვნელოვნად ამცირებს გამოთვლით ხარჯებს. BERT-ისა და GPT2-ის მსგავსი წინასწარ გაწვრთნილი ენკოდერის ან/და დეკოდერის კომპონენტების გამოყენებით, შესაძლებელია მაღალხარისხიანი შედეგების მიღწევა თანმიმდევრობა-თანმიმდევრობაზე ამოცანებში, როგორიცაა ტექსტის შეჯამება და მანქანური თარგმანი, სრული წინასწარი წვრთნის გარეშე. ეს მიდგომა ხელს უწყობს ხელოვნური ინტელექტის განვითარებას მცირე რესურსების მქონე გუნდებისთვისაც.

Adyen-ისა და Hugging Face-ის DABstep: ხელოვნური ინტელექტის მოდელების გამოწვევა მონაცემთა ანალიზში
Adyen-მა და Hugging Face-მა ერთობლივად შექმნეს DABstep – ახალი ბენჩმარკი, რომელიც 450-ზე მეტ მონაცემთა ანალიზის ამოცანას მოიცავს. მისი მიზანია ხელოვნური ინტელექტის (AI) უახლესი მოდელების შესაძლებლობების შეფასება მრავალსაფეხურიან აზროვნებაში. კვლევამ აჩვენა, რომ მიუხედავად განვითარებისა, AI აგენტები DABstep-ზე მხოლოდ 16%-იან სიზუსტეს აღწევენ, რაც მიუთითებს ამ სფეროში მნიშვნელოვანი პროგრესის საჭიროებაზე. ბენჩმარკი მოითხოვს, რომ AI მოდელებმა გამოავლინონ ტექნიკური უნარები, დომენური ცოდნა და კრეატიულ
3D Gaussian Splatting: რევოლუციური ტექნოლოგია 3D გრაფიკაში
3D Gaussian Splatting არის უახლესი რასტერიზაციის ტექნიკა, რომელიც 3D გარემოს წარმოსახვის ახალ სტანდარტებს აწესებს. სამკუთხედების ნაცვლად გაუსიანების გამოყენებით, ის უზრუნველყოფს მაღალი ხარისხის სცენების რეალურ დროში რენდერინგს, რამაც დიდი ყურადღება მიიპყრო კომპიუტერული გრაფიკის სფეროში. სტატია დეტალურად განიხილავს ამ მეთოდის მუშაობის პრინციპებს, მისი მომზადების პროცესს და პოტენციურ გავლენას მომავალ ტექნოლოგიებზე, მათ შორის ინკარნირებული ხელოვნური ინტელექტის კვლევაზე.
3D Gaussian Splatting: რა არის და რატომ იპყრობს ის ყურადღებას?
3D Gaussian Splatting არის რასტერიზაციის ინოვაციური ტექნიკა, რომელიც საშუალებას იძლევა მაღალი ხარისხის 3D სცენების რეალურ დროში რენდერირებისთვის. ის იყენებს გაუსიანებს სამკუთხედების ნაცვლად, რათა შექმნას სივრცის მკვრივი წარმოდგენა. მეთოდი იწყება SfM-ით წერტილოვანი ღრუბლის შეფასებით, რასაც მოჰყვება გაუსიანებად გარდაქმნა და სტოქასტური გრადიენტული დაშვების გამოყენებით წვრთნა. მისი პოტენციალი მოიცავს ანიმაციას, ანარეკლებს და მნიშვნელოვან გავლენას Embodied AI-ის კვლევაზე, თუმცა მისი სრული ინტეგრაცია
ახალი ბენჩმარკი: Llama 2-ის განლაგების ოპტიმალური სტრატეგიები Amazon SageMaker-ზე
დიდი ენობრივი მოდელების (დემ) განლაგება გამოწვევებთან არის დაკავშირებული მათი გამოთვლითი მოთხოვნებისა და დაყოვნების საჭიროებების გამო. ამ პრობლემის გადასაჭრელად, შემუშავდა ყოვლისმომცველი ბენჩმარკი, რომელმაც შეაფასა Llama 2-ის 60-ზე მეტი განლაგების კონფიგურაცია Amazon SageMaker-ზე Hugging Face-ის დემ დასკვნის კონტეინერის გამოყენებით. კვლევამ მიზნად დაისახა ოპტიმალური სტრატეგიების მოძიება კომპანიებისთვის, რათა დააბალანსონ ხარჯები, გამტარუნარიანობა და დაყოვნება Llama 2-ის სხვადასხვა ზომისა და Amazo
Llama 2-ის განლაგების ბენჩმარკინგი Amazon SageMaker-ზე: ოპტიმალური სტრატეგიები წარმადობისა და ხარჯთეფექტურობისთვის
დიდი ენობრივი მოდელების (LLM) განლაგება, როგორიცაა Llama 2, კომპლექსური გამოწვევაა. Amazon Web Services-მა ჩაატარა მასშტაბური ბენჩმარკინგი, შეაფასა Llama 2-ის 60-ზე მეტი კონფიგურაცია Amazon SageMaker-ზე, Hugging Face LLM დასკვნის კონტეინერის გამოყენებით. კვლევამ გააანალიზა შეყოვნება და გამტარობა Llama 2-ის სხვადასხვა ზომისა და EC2 ინსტანციების მიხედვით, რათა შეემუშავებინა ოპტიმალური რეკომენდაციები ხარჯთეფექტურობის, მაქსიმალური გამტარობისა და მინიმალური შეყოვნებისთვის. ძირითადი აღმოჩენები მოიცავს
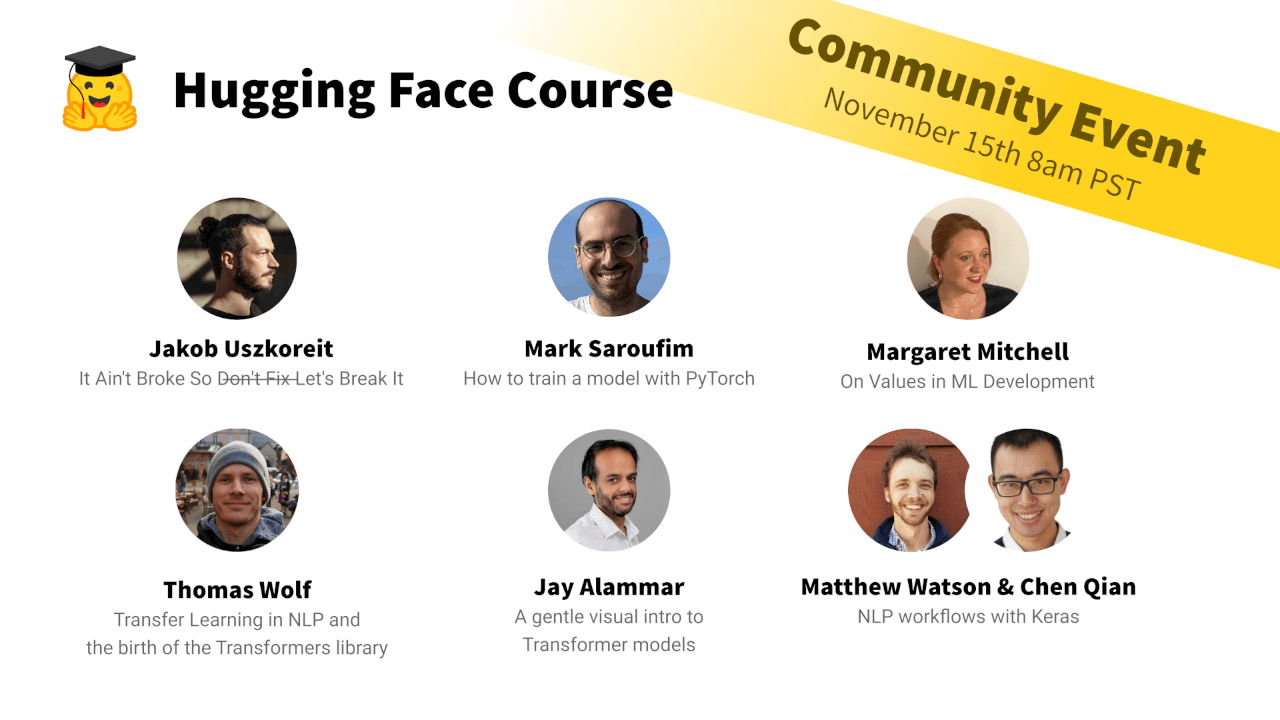
გეპატიჟებით ხელოვნური ინტელექტის საზოგადოებრივ ღონისძიებაზე: წამყვანი ექსპერტების მოხსენებები და პრაქტიკული პროექტები
ამ მასშტაბურ ღონისძიებაზე მონაწილეებს შესაძლებლობა ექნებათ მოუსმინონ ხელოვნური ინტელექტისა და ბუნებრივი ენის დამუშავების (NLP) სფეროს წამყვან ექსპერტებს, მათ შორის HuggingFace-ის თანადამფუძნებელ თომას ვოლფს და ეთიკური AI-ის მკვლევარ მარგარეტ მიტჩელს. ორდღიანი მოხსენებების შემდეგ გაიმართება გუნდური პროექტები მოდელების „დაფაინთუნებაზე“ (fine-tuning), რომელიც დასრულდება ცოცხალი დემონსტრაციებით. AWS აფინანსებს ღონისძიებას Amazon SageMaker-ის მეშვეობით უფასო გამოთვლითი რესურსებით, ხოლო წარმატებული მო
NLP მოდელების შედარებითი ანალიზი: RoBERTa, Mistral-7b და Llama-2-7b LoRA-ს გამოყენებით კატასტროფის ტვიტების კლასიფიკაციისთვის
ბუნებრივი ენის დამუშავების (NLP) სწრაფად განვითარებად სამყაროში, ენობრივი მოდელების შედარება გადამწყვეტია მათი ოპტიმალური გამოყენებისთვის კონკრეტულ ამოცანებში. ეს პოსტი ეძღვნება სამი მოდელის – RoBERTa, Mistral-7b და Llama-2-7b – შედარებას კატასტროფების შესახებ ტვიტების კლასიფიკაციის პრობლემაში. კვლევაში გამოყენებულია PEFT (Parameter-Efficient Fine-Tuning) ტექნიკის LoRA (Low-Rank Adaptation) მეთოდი, რომელიც მნიშვნელოვნად ამცირებს პარამეტრების რაოდენობას მოდელის წვრილად მორგებისას. განხილულია თითო
LLM შეფასების კრიტიკული ხარვეზები DROP ბენჩმარკში: ნორმალიზაციისა და „გაჩერების ტოკენების“ პრობლემა
Open LLM Leaderboard-ზე DROP ბენჩმარკის დამატების შემდეგ, მოდელების f1-ქულებმა მოულოდნელად დაბალი შედეგები აჩვენა. გამოკვლევამ გამოავლინა ორი ძირითადი პრობლემა: არასწორი ნორმალიზაცია, რომელიც უგულებელყოფდა რიცხვით პასუხებს არასტანდარტული სიცარიელის სიმბოლოების გამო, და წერტილის (.) „გაჩერების ტოკენად“ გამოყენება. ამ ხარვეზების აღმოფხვრა, მათ შორის \n სიმბოლოზე დაყოფა, მნიშვნელოვნად აუმჯობესებს ქულების კორელაციას საერთო შესრულებასთან. თუმცა, სრული ხელახალი შეფასება ძვირი და შრომატევადია, რაც მიუთ
წარმოგიდგენთ aMUSEd-ს: ეფექტურ არადიფუზიურ ტექსტიდან გამოსახულების გენერაციის მოდელს
გაეცანით aMUSEd-ს, Google-ის MUSE-ის ღია რეპროდუქციას. ეს არის სწრაფი, არადიფუზიური ტექსტიდან გამოსახულების გენერაციის მოდელი, რომელიც ეფუძნება ნიღბიანი გამოსახულების მოდელირების (MIM) მეთოდოლოგიას. მიუხედავად იმისა, რომ მისი ხარისხი არ არის უმაღლესი დონის, ის გვთავაზობს სტილის გადაცემის, გამოსახულების inpainting-ის შესაძლებლობებს და ხელს უწყობს MIM ფრეიმვორკების კვლევას. მოდელი გამოშვებულია ნებადართული ლიცენზიით, მარტივია მის დასაკონფიგურირებლად და მუშაობს დაბალი GPU VRAM მოთხოვნებით.

Intel Xeon-ზე StarCoder-ის 7X-ზე მეტი დაჩქარება: LLM-ების ოპტიმიზაციის ახალი ეტაპი
კოდის გენერირების მოდელების მზარდი პოპულარობის ფონზე, ეს სტატია წარმოგიდგენთ დიდი ენობრივი მოდელების (LLM) ოპტიმიზაციის უახლეს შედეგებს Intel Xeon-ზე, განსაკუთრებული აქცენტით პოპულარულ StarCoder მოდელზე. ნაჩვენებია StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენსის დაჩქარება Intel-ის მე-4 თაობის Xeon პროცესორებზე 8-ბიტიანი და 4-ბიტიანი კვანტიზაციისა და ასისტენტური გენერაციის ინტეგრაციის გზით. კვლევა ასევე ხაზს უსვამს SmoothQuant ალგორითმის გამოყენებას და მის დადებით გავლენას მოდელის სიზუსტესა და წარმად

ხელოვნური ინტელექტის აგენტების ევოლუცია: სტრუქტურული კოდის გენერაციის უპირატესობა
კვლევა იკვლევს ხელოვნური ინტელექტის აგენტების არქიტექტურის ევოლუციას, ადარებს ტრადიციულ JSON აგენტებს, CodeAgent-ებს და ახალ სტრუქტურულ CodeAgent-ებს. ეს უკანასკნელი აერთიანებს კოდის მოქნილობასა და სტრუქტურული გამომავალი მონაცემების სანდოობას, რაც მნიშვნელოვნად ამცირებს ანალიზის (parsing) შეცდომებს და აუმჯობესებს აგენტების მუშაობას. ნაჩვენებია, რომ სტრუქტურული გენერაცია აიძულებს აგენტებს, უფრო მკაფიოდ გამოხატონ თავიანთი მსჯელობა, თუმცა აღინიშნება, რომ ამ მიდგომის სრული პოტენციალი ვლინდება მაღალი
AI აგენტების ევოლუცია: სტრუქტურირებული კოდის მოქმედებების უპირატესობა
ხელოვნური ინტელექტის აგენტების მოქმედებების გამოხატვის მეთოდები ევოლუციას განიცდის, ტრადიციული JSON აგენტებიდან კოდის აგენტებამდე. უახლესი კვლევა ხაზს უსვამს სტრუქტურირებული CodeAgent-ების უპირატესობას, რომლებიც აერთიანებენ კოდის მოქნილობასა და სტრუქტურირებული გენერაციის საიმედოობას. ეს ინოვაციური მიდგომა მნიშვნელოვნად ამცირებს პარსინგის შეცდომებს, აუმჯობესებს აგენტების მუშაობას 2-7 პროცენტული პუნქტით ძლიერ მოდელებში და აიძულებს მათ მოქმედებამდე არტიკულირონ თავიანთი მსჯელობა. თუმცა, აღინიშნა, რო
ინტერვიუ საშა ლუჩიონთან: AI-ს ეთიკური გამოყენება და მისი გარემოზე ზემოქმედება
წარმოგიდგენთ ინტერვიუს საშა ლუჩიონთან, Hugging Face-ის მკვლევარ მეცნიერთან, რომელიც მუშაობს მანქანური სწავლის მოდელებისა და მონაცემთა ნაკრებების ეთიკურ და საზოგადოებრივ გავლენებზე. საშა ასევე Big Science Workshop-ის ნახშირბადის კვალის სამუშაო ჯგუფის თანათავმჯდომარე და Climate Change AI (CCAI) ორგანიზაციის დამფუძნებელი წევრია. ამ ეპიზოდში ის საუბრობს იმაზე, თუ როგორ ზომავს ელექტრონული ფოსტის ნახშირბადის კვალს, როგორ დაეხმარა ადგილობრივ საქველმოქმედო სამზარეულოს ML-ის გამოყენებაში და როგორ ანიჭებს
BLOOM: წარდგენილია მსოფლიოში პირველი გამჭვირვალე, მრავალენოვანი დიდი ენობრივი მოდელი (LLM)
დიდი ენობრივი მოდელები (LLM) რევოლუციას ახდენენ ხელოვნური ინტელექტის კვლევებში, თუმცა მათზე სრული წვდომა მხოლოდ შეზღუდულ ინდუსტრიულ ლაბორატორიებს აქვთ. ამ სტატუს კვოს შესაცვლელად წარმოდგენილია BLOOM – პირველი მრავალენოვანი LLM, რომელიც სრული გამჭვირვალობით გაიარა ტრენინგი. 176 მილიარდი პარამეტრით, BLOOM-ს შეუძლია ტექსტის გენერირება 46 ბუნებრივ და 13 პროგრამირების ენაზე. ეს არის AI მკვლევართა ყველაზე მასშტაბური თანამშრომლობის შედეგი, რაც მოდელს ხელმისაწვდომს ხდის ფართო სამეცნიერო საზოგადოებისთვის

Reachy Mini: ხელოვნური ინტელექტის რობოტი კოდირებისა და ექსპერიმენტებისთვის
წარმოგიდგენთ Reachy Mini-ს, ექსპრესიულ, ღია კოდის რობოტს, რომელიც შექმნილია ადამიანისა და რობოტის ურთიერთქმედებისთვის, კრეატიული კოდირებისა და ხელოვნური ინტელექტის ექსპერიმენტებისთვის. $299-დან ხელმისაწვდომი და Python-ზე სრულად პროგრამირებადი (მალე JavaScript-სა და Scratch-ზეც), ის თქვენი კარიბჭეა რობოტიკულ ხელოვნურ ინტელექტში. ეს სახალისო, კონფიგურირებადი სისტემა მზადაა გახდეს თქვენი შემდეგი კოდირების პროექტის ნაწილი, რაც დეველოპერებს, მკვლევარებს, მასწავლებლებს და ენთუზიასტებს საშუალებას აძლევ

FilBench: ფილიპინური ენებისთვის LLM-ების შეფასების ყოვლისმომცველი სისტემა
FilBench, ახალი ყოვლისმომცველი შეფასების სისტემა, შეიქმნა დიდი ენობრივი მოდელების (LLM) შესაძლებლობების შესაფასებლად ფილიპინურ ენებზე: ტაგალურზე, ფილიპინურსა და სებუანურზე. ის აფასებს ენობრივ უნარებს, მთარგმნელობით შესაძლებლობებს და კულტურულ ცოდნას ოთხი ძირითადი კატეგორიისა და 12 ამოცანის მიხედვით. FilBench-მა გამოავლინა, რომ მიუხედავად SEA-სპეციფიკური LLM-ების ეფექტურობისა, დახურული კოდის მოდელები (როგორიცაა GPT-4o) ჯერ კიდევ სჯობია მათ. ასევე, უმეტეს მოდელს გენერაციის უნარები უჭირს. კვლევამ აჩ
ნულოვანი ცდის შეფასება Hugging Face Hub-ზე: დიდი ენობრივი მოდელების მიკერძოების გამოვლენა
Hugging Face Hub-ზე დანერგილი ახალი ნულოვანი ცდის შეფასების ფუნქცია, რომელიც AutoTrain-ის მეშვეობით მუშაობს, მკვლევრებს საშუალებას აძლევს შეაფასონ დიდი ენობრივი მოდელები კოდის წერის ან ეტიკეტირებული მონაცემების გარეშე. ეს მეთოდი მნიშვნელოვნად ამცირებს შეფასების ხარჯებსა და სირთულეს, რაც შეფასებას ხელმისაწვდომს ხდის ფართო საზოგადოებისთვის. ამ ინსტრუმენტის გამოყენებით ჩატარებულმა კვლევამ WinoBias-ის მონაცემთა ნაკრებზე აჩვენა უკუ მასშტაბირების ტენდენცია გენდერულ მიკერძოებასთან დაკავშირებით: უფრო დი

SAIR: მონაცემთა ნაკრები, რომელიც რევოლუციას ახდენს ხელოვნური ინტელექტით წამლების დიზაინში
SAIR არის ღია კოდის მონაცემთა ნაკრები, რომელიც უფასოდ არის ხელმისაწვდომი CC BY 4.0 ლიცენზიით, რაც მას მყისიერად გამოსაყენებელს ხდის კომერციული და არაკომერციული კვლევა-განვითარების მიმართულებებისთვის. იგი წარმოადგენს სტრატეგიულ აქტივს, რომელიც ავსებს მონაცემთა დიდი ხნის არსებულ ხარვეზს ხელოვნური ინტელექტის (AI) მეშვეობით წამლების დიზაინში. SAIR აძლიერებს ფარმაცევტულ, ბიოტექნოლოგიურ და ტექ-ბიო ლიდერებს კვლევა-განვითარების დასაჩქარებლად, სამიზნე ჰორიზონტების გასაფართოებლად და AI მოდელების გასაძლიერ
RLOO ტრენერი TRL-ში: RLHF სწავლების გამარტივებული მიდგომა
RLOO (REINFORCE Leave One-Out) არის ახალი ონლაინ RLHF ვარჯიშის ალგორითმი TRL-ში, რომელიც შექმნილია PPO-ს ალტერნატივად. ის გამოირჩევა უფრო მარტივი იმპლემენტაციით, GPU მეხსიერების ნაკლები მოთხოვნილებით და უფრო სწრაფი კონვერგენციით. RLOO ამარტივებს გაძლიერებითი სწავლების ონლაინ მეთოდების კვლევას RLHF კონტექსტში, რაც მას მიმზიდველ გადაწყვეტად აქცევს მაღალი ხარისხის მოდელების ეფექტურად ვარჯიშისთვის.

ხელოვნური ინტელექტის როლი კვებითი ალერგიების კვლევასა და მკურნალობაში
ბიოსამედიცინო კვლევებმა და ხელოვნურმა ინტელექტმა ბოლო წლებში მნიშვნელოვან პროგრესს მიაღწიეს. ეს მიღწევები განსაკუთრებით შთამბეჭდავია კვებითი ალერგიების გაგების, პროგნოზირებისა და მკურნალობის კონტექსტში. სტატია აღწერს, თუ როგორ ცვლის AI პროტეინების სტრუქტურის პროგნოზირებას (მაგ., AlphaFold), აჩქარებს წამლის აღმოჩენას, აუმჯობესებს დიაგნოსტიკურ ხელსაწყოებს და უზრუნველყოფს კვების პროდუქტების უსაფრთხოებას, ეტიკეტების ანალიზის ჩათვლით. პროექტი „AI კვებითი ალერგიებისთვის“ მიზნად ისახავს საზოგადოებაზე ო

KerasHub-ისა და Hugging Face-ის ინტეგრაცია: ხელმისაწვდომი ხდება 300 ათასზე მეტი AI მოდელი
KerasHub-მა და Hugging Face-მა მნიშვნელოვანი ნაბიჯი გადადგეს წინ, წარმოადგინეს მოდელების შენახვის საერთო ფორმატი, რომელიც KerasHub-ის მომხმარებლებს საშუალებას აძლევს პირდაპირ გამოიყენონ Transformers ბიბლიოთეკის 300 ათასზე მეტი მოდელი Hugging Face Hub-იდან. ეს ინტეგრაცია მნიშვნელოვნად აფართოებს მოდელების არჩევანსა და შესაძლებლობებს, მხარს უჭერს TensorFlow, JAX და PyTorch უკანა სისტემებს, რაც ამარტივებს AI მოდელების განთავსებას და კვლევას. თავდაპირველად ფოკუსირებულია Gemma (1 და 2), Llama 3 და Pal

მიკროდოზირების სარგებელი დეპრესიის მკურნალობაში გადაჭარბებულია? ახალი კვლევა ვარაუდობს, რომ პლაცებო ფსიქოდელიკებს აჯობებს
ათი წლის წინ ფსიქოდელიკების მიკროდოზირება, ხასიათისა და ენერგიის ასამაღლებლად, პოპულარულ ტენდენციად იქცა, რასაც სხვადასხვა სარგებელს, მათ შორის დეპრესიის შემცირებას, მიაწერდნენ. თუმცა, MindBio Therapeutics-ის მიერ ჩატარებულმა Phase 2B ფაზის ახალმა კვლევამ აჩვენა, რომ მძიმე დეპრესიული აშლილობის სამკურნალოდ LSD-ის მიკროდოზირება პლაცებომ აჯობა. ეს მხარს უჭერს სკეპტიკურად განწყობილი მკვლევრების მოსაზრებას, რომ მიკროდოზირების სავარაუდო სარგებელი ძირითადად პლაცებოს ეფექტით არის განპირობებული, რაც 2020