
OpenAI-ის GPT OSS მოდელები Hugging Face-ზე: გაუმჯობესებული ხელმისაწვდომობა და ოპტიმიზებული წარმადობა
OpenAI-მ Apache 2.0 ლიცენზიით გამოუშვა ღია კოდის GPT OSS მოდელები, რომელთა მიზანია ხელოვნური ინტელექტის ფართო ხელმისაწვდომობის უზრუნველყოფა უსაფრთხო და პასუხისმგებლიანი გამოყენებით. Hugging Face-თან ინტეგრაციით, მომხმარებლებს შეუძლიათ ისარგებლონ გაუმჯობესებული არქიტექტურით, მათ შორის mxfp4 კვანტიზაციით, Flash Attention 3-ითა და MegaBlocks MoE ქერნელებით, რაც უზრუნველყოფს მნიშვნელოვან მეხსიერების დაზოგვას და მაღალ წარმადობას როგორც NVIDIA, ისე AMD GPU-ებზე. ეს ინიციატივა ხელს უწყობს AI-ის ინოვაცი
StarCoder2-15B-Instruct: ახალი ეტალონი კოდის ხელოვნური ინტელექტისთვის თვით-განვითარების გზით
ახალი ენა-მოდელი, StarCoder2-15B-Instruct, აჩვენებს გასაოცარ შედეგებს კოდის გენერაციაში, უსწრებს ისეთ მძლავრ მოდელებს, როგორიცაა CodeLlama-70B-Instruct და აღწევს 72.6 HumanEval ქულას. მისი წარმატების საიდუმლო თვით-მორგების (self-alignment) ინოვაციურ მეთოდოლოგიაში მდგომარეობს, რაც საშუალებას აძლევს მოდელს ეფექტურად ისწავლოს საკუთარი გენერირებული მონაცემებიდან, ძლიერი „მასწავლებელი“ მოდელების გამოყენების გარეშე. ეს მიდგომა გულისხმობს ინსტრუქციების თვით-გენერირებას და საკუთარი კოდის ტესტირებას, რაც

მოდელების ეფექტური ვარჯიში: პარალელიზმის სტრატეგიების მიმოხილვა Accelerate-სა და Axolotl-ში
ეს სტატია განიხილავს მოდელების ვარჯიშის პარალელიზმის სხვადასხვა სტრატეგიას, მათ შორის მონაცემთა პარალელიზმს (DP) და სრულად დაშარდულ მონაცემთა პარალელიზმს (FSDP), აქცენტს აკეთებს მათ მუშაობის პრინციპებზე, უპირატესობებსა და გამოყენების შემთხვევებზე. განხილულია, თუ როგორ შეიძლება ამ ტექნიკების ინტეგრირება Accelerate-სა და Axolotl-ის ბიბლიოთეკებში, როგორ უნდა მოხდეს მათი კომბინირება და რა გამოწვევები არსებობს დიდ მოდელებთან მუშაობისას, განსაკუთრებით კომუნიკაციის დანახარჯების მინიმიზაციის კუთხით მრავ
Stable Diffusion-ის რევოლუციური განახლებები: გამოსახულებიდან გამოსახულების გენერაცია, ოპტიმიზაცია და საზოგადოების წვლილი
Hugging Face-ის Stable Diffusion-ის უახლესი განახლებები მოიცავს დიდი ხნის ნანატრი ფუნქციებს, როგორიცაა გამოსახულებიდან გამოსახულების გენერაცია, ტექსტუალური ინვერსია და ინფეინთინგი. ასევე, წარმოდგენილია მნიშვნელოვანი ოპტიმიზაციები VRAM-ის გამოყენებისთვის, M1/M2 ჩიპების მხარდაჭერა და ONNX-თან თავსებადობა. გამოვიდა გაუმჯობესებული დოკუმენტაცია, ხოლო საზოგადოებამ შექმნა მრავალი ინოვაციური ინსტრუმენტი, როგორიცაა Stable Diffusion Videos და Waifu Diffusion.

მეტყველების ამოცნობის (ASR) და დიარიზაციის პაიპლაინების დაყენება Hugging Face Inference Endpoints-ზე სპეკულაციური დეკოდირებით
ეს სტატია განმარტავს, თუ როგორ ხდება მეტყველების ავტომატური ამოცნობის (ASR), დიარიზაციისა და სპეკულაციური დეკოდირების მოდულარული პაიპლაინების კონფიგურაცია Hugging Face Inference Endpoints-ის გამოყენებით. ის დეტალურად აღწერს Pyannote მოდელის ინტეგრაციას დიარიზაციისთვის, Flash Attention 2-ის გამოყენებას და ინფერენსის დაჩქარების ტექნიკებს, ასევე კონფიგურაციის მოქნილობას და წარმადობის გაუმჯობესებას სხვადასხვა აუდიო სიგრძისთვის.

Hugging Face-ის AI Sheets: ხელოვნური ინტელექტის უკოდო ინსტრუმენტი მონაცემთა ნაკრებების შექმნისა და მართვისთვის
Hugging Face-მა წარმოადგინა AI Sheets – ახალი, ღია წყაროს მქონე უკოდო ინსტრუმენტი, რომელიც მომხმარებლებს საშუალებას აძლევს შექმნან, გაამდიდრონ და გარდაქმნან მონაცემთა ნაკრებები ხელოვნური ინტელექტის მოდელების გამოყენებით. ის ინტეგრირებულია Hugging Face Hub-თან და გთავაზობთ ათასობით ღია მოდელის გამოყენების შესაძლებლობას სწრაფი ექსპერიმენტებისა და მონაცემთა დამუშავებისთვის. ინსტრუმენტი გამოირჩევა მარტივი, ცხრილის მსგავსი ინტერფეისით და ხელს უწყობს ეფექტურ მუშაობას როგორც მცირე, ისე მსხვილ მონაცემთა

BLOOM ინფერენსის ოპტიმიზაცია GPU-ებზე: წარმადობის ბენჩმარკინგი
ეს სტატია განიხილავს BLOOM ხელოვნური ინტელექტის მოდელის ინფერენსის ოპტიმიზაციას სხვადასხვა GPU კონფიგურაციებზე. მოცემულია აპარატურული მოთხოვნები 352GB bf16 წონებისთვის, სადაც რეკომენდებულია 8x80GB A100 GPU-ები, თუმცა განიხილება ალტერნატივებიც. სტატია აანალიზებს მოდელის ჩატვირთვის დროს და ტოკენების გენერირების წარმადობას (throughput) ისეთი გადაწყვეტების გამოყენებით, როგორიცაა Deepspeed-Inference და Accelerate, ასევე 8-ბიტიანი კვანტიზაცია მეხსიერების შესამცირებლად. ბენჩმარკინგის შედეგები აჩვენებს

FilBench: ფილიპინური ენებისთვის LLM-ების შეფასების ყოვლისმომცველი სისტემა
FilBench, ახალი ყოვლისმომცველი შეფასების სისტემა, შეიქმნა დიდი ენობრივი მოდელების (LLM) შესაძლებლობების შესაფასებლად ფილიპინურ ენებზე: ტაგალურზე, ფილიპინურსა და სებუანურზე. ის აფასებს ენობრივ უნარებს, მთარგმნელობით შესაძლებლობებს და კულტურულ ცოდნას ოთხი ძირითადი კატეგორიისა და 12 ამოცანის მიხედვით. FilBench-მა გამოავლინა, რომ მიუხედავად SEA-სპეციფიკური LLM-ების ეფექტურობისა, დახურული კოდის მოდელები (როგორიცაა GPT-4o) ჯერ კიდევ სჯობია მათ. ასევე, უმეტეს მოდელს გენერაციის უნარები უჭირს. კვლევამ აჩ
როგორ განვაახლოთ Hugging Face ორგანიზაცია Enterprise Hub-მდე AWS ანგარიშის გამოყენებით
გაიგეთ, თუ როგორ უნდა განაახლოთ თქვენი Hugging Face ორგანიზაცია Enterprise Hub-მდე AWS Marketplace-ის მეშვეობით, რათა ისარგებლოთ გაფართოებული უსაფრთხოების ფუნქციებით, წვდომის კონტროლით და ხელოვნური ინტელექტის კერძოდ და უსაფრთხოდ შექმნის შესაძლებლობით GDPR-თან შესაბამის და SOC2 Type 2 სერტიფიცირებულ პლატფორმაზე.

Arm KleidiAI და SDOT: გენერაციული ხელოვნური ინტელექტი მილიარდობით მოწყობილობაზე, მათ შორის ძველ მოდელებზეც
Arm-ის KleidiAI, SDOT CPU ფუნქციის გამოყენებით, გენერაციულ ხელოვნურ ინტელექტს (GenAI) ხელმისაწვდომს ხდის მოწყობილობების ფართო სპექტრზე – უახლესი ფლაგმანური მოდელებიდან დაწყებული, ხუთ წლამდე ძველი სმარტფონებითა და Raspberry Pi 5-ით დამთავრებული. ეს მიიღწევა პოპულარულ AI ფრეიმვორკებში ჩაშენებული ოპტიმიზაციებით და ExecuTorch 0.7 ბეტაში ნაგულისხმევი ჩართვით, რაც უზრუნველყოფს დიდი ენობრივი მოდელების (LLM) ეფექტურ მუშაობას კოდის შეცვლის გარეშე და მნიშვნელოვანი წარმადობის გაუმჯობესებით.
ნულოვანი ცდის შეფასება Hugging Face Hub-ზე: დიდი ენობრივი მოდელების მიკერძოების გამოვლენა
Hugging Face Hub-ზე დანერგილი ახალი ნულოვანი ცდის შეფასების ფუნქცია, რომელიც AutoTrain-ის მეშვეობით მუშაობს, მკვლევრებს საშუალებას აძლევს შეაფასონ დიდი ენობრივი მოდელები კოდის წერის ან ეტიკეტირებული მონაცემების გარეშე. ეს მეთოდი მნიშვნელოვნად ამცირებს შეფასების ხარჯებსა და სირთულეს, რაც შეფასებას ხელმისაწვდომს ხდის ფართო საზოგადოებისთვის. ამ ინსტრუმენტის გამოყენებით ჩატარებულმა კვლევამ WinoBias-ის მონაცემთა ნაკრებზე აჩვენა უკუ მასშტაბირების ტენდენცია გენდერულ მიკერძოებასთან დაკავშირებით: უფრო დი

ღია არაბული LLM ლიდერბორდი (OALL): AI-ს განვითარება არაბულენოვანი სამყაროსთვის
ღია არაბული LLM ლიდერბორდი (OALL) არის ინიციატივა, რომელიც მიზნად ისახავს არაბული დიდი ენობრივი მოდელების (LLM) შეფასებასა და გაუმჯობესებას. პროექტი ემსახურება მსოფლიოში 380 მილიონზე მეტ არაბულენოვან მომხმარებელს, სთავაზობს ყოვლისმომცველ შეფასების სისტემას მრავალფეროვანი მონაცემთა ნაკრებებისა და სპეციფიკური მეტრიკების გამოყენებით. OALL-ის მიზანია შექმნას მოდელები, რომლებიც ზუსტად იქნება მორგებული არაბული ენის, კულტურისა და მემკვიდრეობის ნიუანსებზე, სამომავლო გეგმებით, გააფართოვოს ბენჩმარკები და

მოდელის კონტექსტის პროტოკოლი (MCP): ხელოვნური ინტელექტის ახალი ერა კვლევის ავტომატიზაციაში
მოდელის კონტექსტის პროტოკოლი (MCP) არის სტანდარტი, რომელიც აგენტურ მოდელებს საშუალებას აძლევს, დაუკავშირდნენ გარე ინსტრუმენტებსა და მონაცემთა წყაროებს. ეს ხელოვნურ ინტელექტს აძლევს შესაძლებლობას, ბუნებრივი ენის გამოყენებით ავტომატიზირება მოახდინოს კვლევის პროცესში, პლატფორმებს შორის გადართვისა და ინფორმაციის ჯვარედინი შემოწმების ჩათვლით, რაც მნიშვნელოვნად ზრდის კვლევის ეფექტურობას.

მორგებული CUDA ბირთვები: შექმნა, ოპტიმიზაცია და განთავსება kernel-builder-ის გამოყენებით
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ გამოიყენოთ kernel-builder ბიბლიოთეკა მორგებული CUDA ბირთვების შესაქმნელად PyTorch-ისთვის. ის მოიცავს ნაბიჯებს ადგილობრივი განვითარებიდან მრავალ არქიტექტურაზე აწყობამდე, ეფექტური და შენარჩუნებადი სისტემების შექმნას, PyTorch-ის C++ API-ის გამოყენებით ფუნქციების მშობლიურ ოპერატორებად რეგისტრაციას და `nix` გარემოს გამოყენებას რეპროდუცირებადი აწყობის პროცესისთვის. ასევე განხილულია ბირთვების ოპტიმიზაცია, განთავსების გამოწვევები და მათი გაზიარება დეველოპერულ
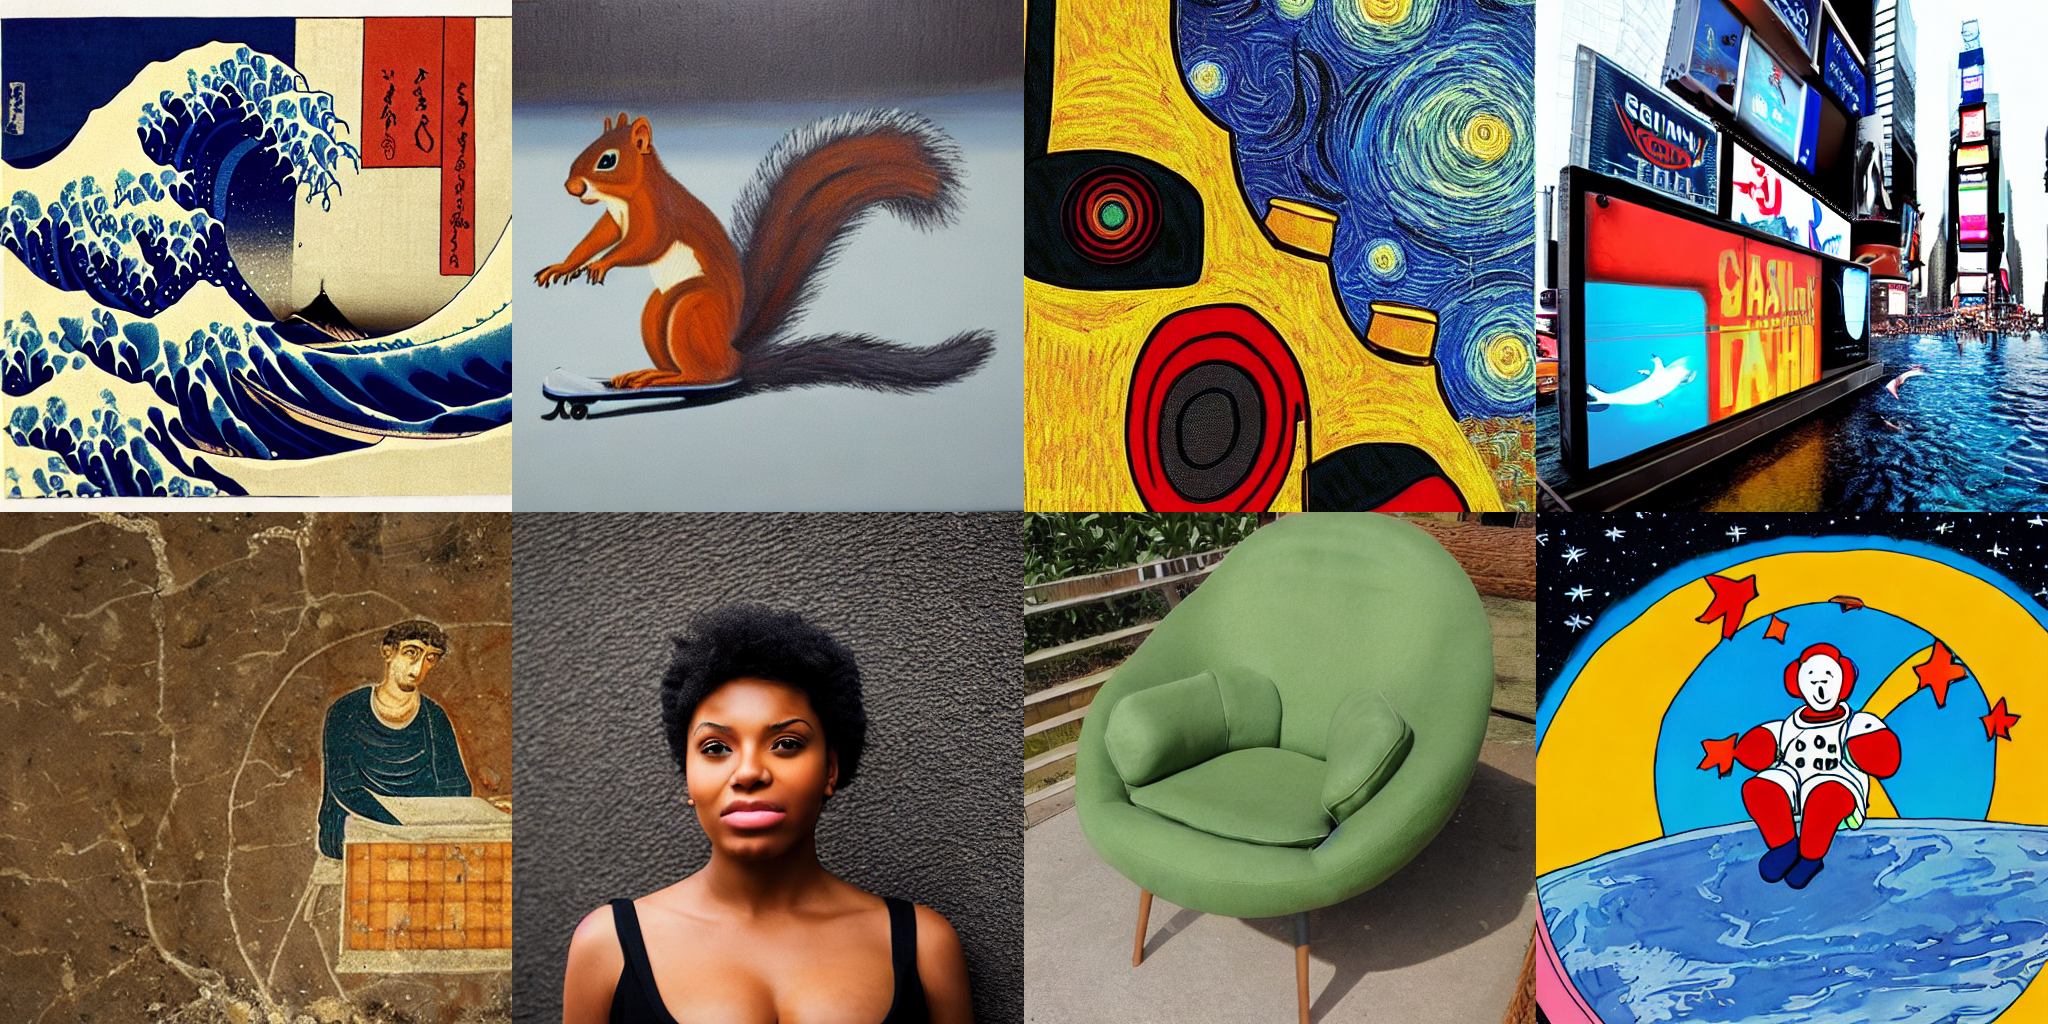
JAX/Flax-ის გამოყენება Stable Diffusion-ის ინფერენსისთვის TPU-ზე
ეს სტატია დეტალურად აღწერს, თუ როგორ უნდა განახორციელოთ ინფერენსი Stable Diffusion მოდელზე JAX-ისა და Flax-ის გამოყენებით, განსაკუთრებით TPU მოწყობილობებზე. განხილულია ინსტალაციის, ლიცენზიის მიღების, პარალელური დამუშავების, შემთხვევითი რიცხვების გენერირებისა და JAX-ის JIT კომპილაციის მნიშვნელობა ოპტიმალური მუშაობისთვის. გაიგებთ, თუ როგორ უნდა მოამზადოთ გარემო Colab-ში, მიიღოთ CreativeML OpenRail-M ლიცენზია Hugging Face Hub-დან და გამოიყენოთ TPU-ს 8 პარალელური ამაჩქარებელი 8 გამოსახულების ერთდროუ
დღეს წარვადგენთ Dell Enterprise Hub-ს: ღია მოდელების მარტივი წვრთნა და განთავსება Dell-ის პლატფორმებზე
Dell Enterprise Hub, Hugging Face-ის ახალი შეთავაზება, ამარტივებს ღია ხელოვნური ინტელექტის მოდელების (როგორიცაა Llama 3 და Mixtral) ლოკალურ წვრთნასა და განთავსებას Dell-ის პლატფორმების გამოყენებით. ის კვირების საინჟინრო სამუშაოს წუთებამდე ამცირებს, გვთავაზობს შერჩეულ მოდელებს და უზრუნველყოფს უსაფრთხო, შესაბამის დახვეწასა და განთავსებას საწარმოს გარემოში.
Dell Enterprise Hub-ის გაშვება Hugging Face-ზე: ხელოვნური ინტელექტის მოდელების მარტივი ტრენინგი და განთავსება ადგილზე
Dell Technologies-ისა და Hugging Face-ის პარტნიორობის ფარგლებში, წარმოდგენილია Dell Enterprise Hub. ეს ახალი პლატფორმა საშუალებას აძლევს საწარმოებს, მარტივად მოამზადონ და განათავსონ ღია ხელოვნური ინტელექტის მოდელები საკუთარ ინფრასტრუქტურაზე (on-premises), Dell-ის პლატფორმების გამოყენებით. Dell Enterprise Hub მნიშვნელოვნად ამცირებს განთავსების დროს კვირებიდან წუთებამდე, უზრუნველყოფს მონაცემთა უსაფრთხოებას, კონფიდენციალურობასა და შესაბამისობას, და გთავაზობთ წვდომას უახლეს ღია მოდელებზე, როგორიცაა

Google-მა გამოუშვა EmbeddingGemma: უახლესი მულტილინგვური ჩაშენების მოდელი მოწყობილობებისთვის
Google-მა წარადგინა EmbeddingGemma, უახლესი მულტილინგვური ჩაშენების მოდელი, რომელიც ოპტიმიზებულია მოწყობილობებზე გამოსაყენებლად. 308 მილიონი პარამეტრით და 2K კონტექსტური ფანჯრით, ის მხარს უჭერს 100-ზე მეტ ენას და MTEB ბენჩმარკზე 500M-ზე ნაკლებ მოდელებს შორის ყველაზე მაღალრეიტინგულია. მოდელი შექმნილია სიჩქარისა და ეფექტურობისთვის, მნიშვნელოვნად აფართოებს მობილური RAG კონვეიერების შესაძლებლობებს და ინტეგრირებულია პოპულარულ AI ხელსაწყოებთან.
PyTorch-ის განაწილებული წვრთნა: DDP-დან Accelerate-მდე
ეს სტატია განიხილავს PyTorch-ში მრავალ GPU-ზე მოდელის წვრთნის პროცესს Distributed Data Parallelism (DDP) მექანიზმის გამოყენებით. მოცემულია საბაზისო კოდის მაგალითები და ნაჩვენებია, თუ როგორ ამარტივებს `torch.distributed` და შემდგომში `Accelerate` ბიბლიოთეკა ამ პროცესს, რაც საშუალებას იძლევა ეფექტური განაწილებული წვრთნისთვის კოდის მინიმალური ცვლილებებით. ასევე განხილულია მონაცემთა მილსადენის გაუმჯობესება და Jupyter Notebook-თან ინტეგრაცია.
Spaces Dev Mode: ახალი შესაძლებლობები დეველოპერებისთვის
Spaces Dev Mode დეველოპერებს საშუალებას აძლევს, პირდაპირ დაუკავშირდნენ მათ Space-ს VS Code-ის ან SSH-ის გამოყენებით. ეს ფუნქცია კოდის რედაქტირებას ამარტივებს და ადგილობრივი ცვლილებების Git-ის საშუალებით ატვირთვის საჭიროებას აქრობს. ის ამჟამად ბეტა რეჟიმშია და ხელმისაწვდომია PRO გამომწერებისთვის, რაც მუშაობის პროცესს მნიშვნელოვნად აჩქარებს.

mmBERT: ახალი მასობრივად მრავალენოვანი AI მოდელი რეკორდული წარმადობით
mmBERT არის უახლესი მასობრივად მრავალენოვანი ენკოდერი მოდელი, რომელიც გაწვრთნილია 1800-ზე მეტ ენაზე 3 ტრილიონზე მეტი ტოკენის გამოყენებით. ის წინა მრავალენოვან მოდელებთან შედარებით აჩვენებს მნიშვნელოვან წარმადობისა და სიჩქარის გაუმჯობესებას, პირველია, ვინც XLM-R-ს გადააჭარბა და ამავდროულად შეიმუშავა ეფექტური სტრატეგიები ნაკლებად რესურსული ენების შესასწავლად. მოდელი აგებულია ModernBERT-ის არქიტექტურაზე და მოიცავს ინოვაციურ კომპონენტებს ეფექტური მრავალენოვანი სწავლისთვის.
Intel-ი და Hugging Face-ი Optimum Intel-ში OpenVINO-ს ინტეგრაციას აცხადებენ ტრანსფორმერული მოდელების დასაჩქარებლად
Intel-მა და Hugging Face-მა OpenVINO ინტეგრირეს Optimum Intel-ში, რაც დეველოპერებს საშუალებას აძლევს, მარტივად დააჩქარონ ტრანსფორმერული მოდელები Intel-ის სხვადასხვა პროცესორზე. ეს ინტეგრაცია უზრუნველყოფს ეფექტურ ინფერენსსა და კვანტიზაციას OpenVINO ნერვული ქსელების შეკუმშვის ფრეიმვორკის (NNCF) გამოყენებით, მნიშვნელოვნად ამცირებს მოდელის ზომასა და შეყოვნებას სიზუსტის მინიმალური დაკარგვით.
Intel-ი და Hugging Face-ი OpenVINO-ს Optimum Intel-ში აერთიანებენ AI მოდელების დასაჩქარებლად
Intel-მა და Hugging Face-მა გამოაცხადეს Intel OpenVINO-ს Optimum Intel-ში ინტეგრაციის შესახებ, რაც ტრანსფორმერული მოდელების სწრაფ და ეფექტურ ინფერენსს შესაძლებელს ხდის Intel-ის პროცესორებზე. სიახლე მოიცავს მოდელების კვანტიზაციას ზომის შემცირებისა და პროგნოზირების დაყოვნების გაუმჯობესებისთვის, ასევე მოცემულია ვიზუალური ტრანსფორმერის (ViT) გამოყენების პრაქტიკული მაგალითი. დეველოპერებს მოუწოდებენ, გამოიკვლიონ ახალი შესაძლებლობები.
CyberSecEval 2: LLM-ების კიბერუსაფრთხოების შეფასება და მიმდინარე გამოწვევები
CyberSecEval 2 ბენჩმარკები აფასებს დიდი ენობრივი მოდელების (LLM) მოწყვლადობას არაუსაფრთხო კოდის გენერირებასა და კიბერთავდამსხმელების დახმარების მოთხოვნებთან შესაბამისობაში. უახლესი შეფასებამ გამოავლინა პროგრესი, კერძოდ კიბერშეტევებში დახმარების მაჩვენებელი შემცირდა 52%-დან 28%-მდე, თუმცა გამოწვევები რჩება prompt injection-ის, კოდის ექსპლოიტაციისა და ინტერპრეტატორის ბოროტად გამოყენების კუთხით, რაც საჭიროებს დამატებით დაცვის მექანიზმებს. საზოგადოებას მოუწოდებენ მონაწილეობა მიიღოს ბენჩმარკის გაუმჯო