
Together AI და Hugging Face LLM-ების ოპტიმიზაციას ამარტივებენ: ახალი ინტეგრაცია გამოცხადდა
Together AI და Hugging Face აცხადებენ ახალ ინტეგრაციას, რომელიც მნიშვნელოვნად ამარტივებს Hugging Face Hub-ზე არსებული ნებისმიერი თავსებადი დიდი ენობრივი მოდელის (LLM) დაზუსტებულ წვრთნას (ფაინ-ტუნინგი) Together AI-ის ინფრასტრუქტურის გამოყენებით. ეს ინოვაცია გუნდებს საშუალებას აძლევს, მარტივად მოარგონ მოდელები საკუთარ საჭიროებებს, შეამცირონ ხარჯები და დააჩქარონ განვითარების ციკლები, გვერდის ავლით ტრადიციულად რთულ და ძვირადღირებულ ინფრასტრუქტურას. ინტეგრაცია აგვარებს გავრცელებულ პრობლემას, როდესაც
Together AI-ი და Hugging Face-ი LLM მოდელების დახვეწას რევოლუციურ ხდის
Together AI-ი და Hugging Face-ი აცხადებენ ინტეგრაციის შესახებ, რომელიც მნიშვნელოვნად ამარტივებს Hugging Face Hub-ზე არსებული LLM მოდელების დახვეწას Together AI-ის ინფრასტრუქტურის გამოყენებით, რაც ამცირებს სირთულეს, ღირებულებას და DevOps ექსპერტიზის საჭიროებას. ეს ახალი შესაძლებლობა გუნდებს საშუალებას აძლევს, სწრაფად მოახდინონ მოდელების პერსონალიზაცია კონკრეტული საჭიროებებისთვის.
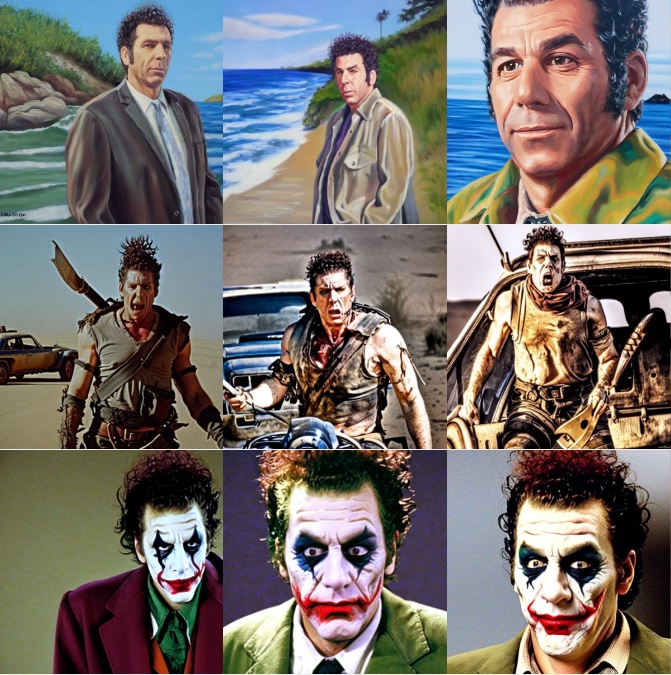
Dreambooth-ის ოპტიმიზაცია: ექსპერიმენტული მიგნებები და რჩევები Stable Diffusion-ისთვის
ამ პოსტში წარმოდგენილია Dreambooth-ის პარამეტრების ანალიზის შედეგები Stable Diffusion-ის დახვეწისას. მოცემულია რჩევები საუკეთესო შედეგების მისაღებად, მათ შორის სწავლის ტემპისა და სწავლის ნაბიჯების ოპტიმიზაცია, 'prior preservation' ტექნიკის გამოყენება, შესაბამისი განრიგის (scheduler) არჩევა (როგორიცაა DDIM) და ტექსტის ენკოდერის დახვეწის მნიშვნელობა, განსაკუთრებით სახეების დამუშავებისას. ხაზგასმულია მეთოდის ეთიკური გამოყენების აუცილებლობა.
Dreambooth-ის ოპტიმიზაცია: ექსპერიმენტები და რჩევები Stable Diffusion-ის შედეგების გასაუმჯობესებლად
ეს სტატია წარმოგიდგენთ Dreambooth-ის გამოყენებით Stable Diffusion-ის მოდელების ფაინ-ტიუნინგის შესახებ ჩატარებული ექსპერიმენტების შედეგებსა და რეკომენდაციებს. განხილულია სწავლის სიჩქარის, საწვრთნელი ნაბიჯების, წინასწარი შენარჩუნების ტექნიკის, სხვადასხვა განრიგის (schedulers) და ტექსტის კოდირების მოდულის ფაინ-ტიუნინგის გავლენა შედეგებზე. განსაკუთრებული ყურადღება ეთმობა ეთიკურ გაფრთხილებებს მოდელის არასწორი გამოყენების თავიდან ასაცილებლად.

Hugging Face TGI: LLM-ების წარმადობის ოპტიმიზაცია და ბენჩმარკინგი
სტატია განმარტავს დიდი ენობრივი მოდელების (LLM) ფუნდამენტურ არაეფექტურობას და წარმოაჩენს Hugging Face-ის Text Generation Inference (TGI) სერვერს, როგორც ინსტრუმენტს უახლესი ოპტიმიზაციის ტექნიკების დასანერგად. ის ხაზს უსვამს ბენჩმარკინგის მნიშვნელობას სხვადასხვა გამოყენების შემთხვევებისთვის, როგორიცაა RAG და ჩატბოტები, და განმარტავს ლატენტურობისა და გამტარუნარიანობის, როგორც ორთოგონალური მეტრიკების, როლს. ავტორი გვიჩვენებს, თუ როგორ შეიძლება TGI ბენჩმარკინგის ინსტრუმენტის გამოყენება Hugging Face
LLM ინფერენსის ოპტიმიზაცია: Hugging Face TGI ბენჩმარკინგი
ეს სტატია განმარტავს, თუ როგორ ხდება დიდი ენობრივი მოდელების (LLM) ინფერენსის ოპტიმიზაცია Hugging Face-ის მაღალეფექტური ტექსტის გენერაციის ინფერენსის (TGI) სერვერის გამოყენებით. დეტალურად განიხილება LLM-ების თანდაყოლილი არაეფექტურობა, ინდუსტრიის მიერ მიღწეული გაუმჯობესებები მუშაობის ოპტიმიზაციაში, ასევე ბენჩმარკინგის მნიშვნელობა სხვადასხვა გამოყენების შემთხვევებისთვის, როგორიცაა RAG და ჩატი. სახელმძღვანელო განმარტავს ძირითად მეტრიკებს, როგორიცაა ლატენტურობა და გამტარუნარიანობა, და გვიჩვენებს, თუ

AI კონტენტის გამჭვირვალობა: Hugging Face აადვილებს წყლის ნიშნების დამატებას
Hugging Face წარმოგიდგენთ მარტივ გზას ხელოვნური ინტელექტის მიერ გენერირებულ კონტენტზე ხილული წყლის ნიშნების დასამატებლად Gradio-ს გამოყენებით. ეს ინიციატივა მიზნად ისახავს AI-გენერირებული სურათების, ვიდეოების, აუდიოსა და ტექსტების იდენტიფიცირების სირთულის დაძლევას, გამჭვირვალობის გაზრდას და მომხმარებლებისთვის ნდობის ამაღლებას. კომპანია დეველოპერულ საზოგადოებას მოუწოდებს, მიიღონ ეს პრაქტიკა პოტენციური კანონმდებლობის თავიდან ასაცილებლად.
უსაფრთხოების ინციდენტი Hugging Face-ის Spaces პლატფორმაზე: არაავტორიზებული წვდომა გამოვლინდა
Hugging Face-მა გამოავლინა არაავტორიზებული წვდომა Spaces პლატფორმაზე, რამაც შესაძლოა კომპრომეტირება მოახდინა Spaces-ის საიდუმლოებების ნაწილს. საწყისი ნაბიჯები მოიცავს HF ტოკენების გაუქმებას და მომხმარებლებისთვის გასაღებების განახლებასა და წვრილმარცვლოვანი წვდომის ტოკენებზე გადასვლის რეკომენდაციას. მიმდინარეობს გამოძიება კიბერუსაფრთხოების სპეციალისტებთან ერთად და განხორციელდა უსაფრთხოების მნიშვნელოვანი გაუმჯობესებები ინფრასტრუქტურაში.

Public AI Hugging Face Hub-ის მხარდაჭერილი გამოცნობის პროვაიდერი გახდა
Hugging Face Hub-მა გამოაცხადა Public AI-ის, როგორც ახალი მხარდაჭერილი გამოცნობის პროვაიდერის, ინტეგრაცია, რაც მნიშვნელოვნად აფართოებს სერვერული გამოცნობის შესაძლებლობებს. Public AI, არაკომერციული, ღია კოდის პროექტი, ხელს უწყობს საჯარო AI მოდელებზე წვდომას განაწილებული ინფრასტრუქტურის მეშვეობით. სტატია დეტალურად განმარტავს პლატფორმის გამოყენების პირობებს, მათ შორის უფასო წვდომასთან დაკავშირებულ შეზღუდვებს, ფასწარმოქმნას და Hugging Face-ის საკრედიტო სისტემას სხვადასხვა მომხმარებლისთვის.
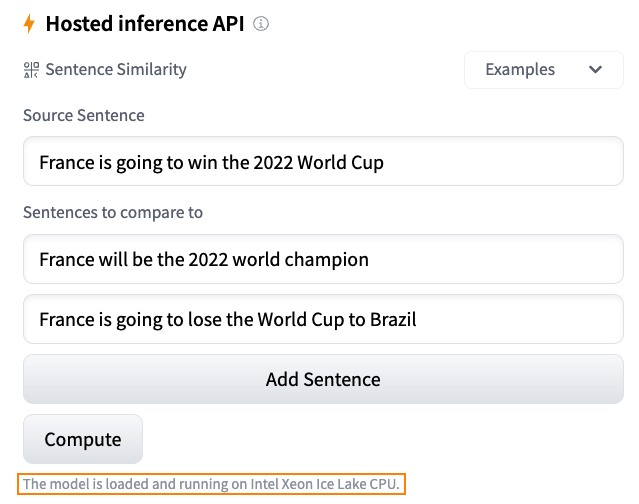
Hugging Face-ის ინფერენსის გადაწყვეტილებები: სიმარტივე, ხარისხი და ოპტიმალური ხარჯები
სტატია მიმოიხილავს Hugging Face-ის მიდგომას მანქანური სწავლების (ML) მოდელების შემუშავებისა და გაშვების გამარტივებისადმი, უმაღლესი ხარისხისა და ოპტიმალური ხარჯების შენარჩუნებით. იგი ხაზს უსვამს ინფერენსის სხვადასხვა უფასო და ფასიან ვარიანტს, მათ შორის Inference Widget-ს, Inference API-ს, Inference Endpoints-ს (სამრეწველო გამოყენებისთვის უსაფრთხოებითა და მასშტაბურობით) და Spaces-ს (დემონსტრაციებისთვის UI-ით). ასევე აღნიშნულია Intel-ის სპონსორობა უფასო CPU-ზე დაფუძნებული ინფერენსის გადაწყვეტილებებ
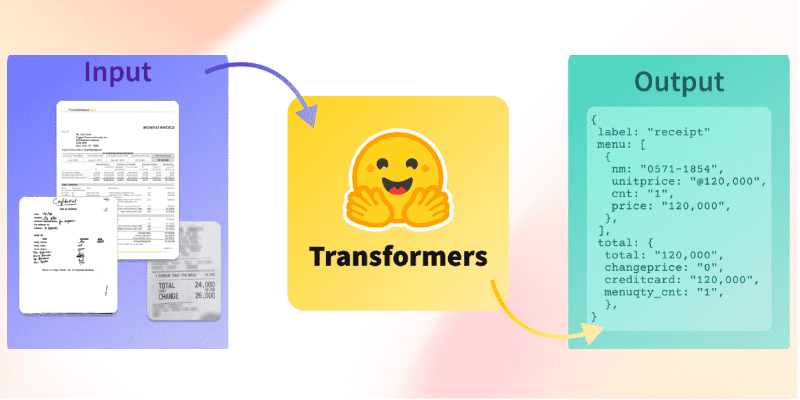
დოკუმენტების ხელოვნური ინტელექტი: OCR-დან დამუშავებამდე წამყვანი მოდელების გამოყენებით
ეს პოსტი იკვლევს დოკუმენტების ხელოვნურ ინტელექტს (Document AI), რომელიც მოიცავს მონაცემთა მეცნიერების სხვადასხვა ამოცანას, როგორიცაა ოპტიკური სიმბოლოების ამოცნობა (OCR), დოკუმენტების კლასიფიკაცია, განლაგების ანალიზი და დამუშავება (parsing). მასში წარმოდგენილია გამოყენების შემთხვევების ტაქსონომია, ხაზგასმულია საუკეთესო ღია კოდის მოდელები (მაგ., LayoutLM, Donut, DiT) და განხილულია ძირითადი ასპექტები, როგორიცაა ლიცენზირება, მონაცემთა მომზადება და შეფასების მეტრიკა. ტექსტი ხაზს უსვამს მულტიმოდალურ მ
ღია Embedding მოდელების განთავსება Amazon SageMaker-ზე Hugging Face Embedding კონტეინერის გამოყენებით
ეს ბლოგი დეტალურად აღწერს, თუ როგორ უნდა განათავსოთ ღია Embedding მოდელები, როგორიცაა Snowflake Arctic Embed, Amazon SageMaker-ზე ინფერენციისთვის, ახალი Hugging Face Embedding კონტეინერის გამოყენებით. სტატია მოიცავს განვითარების გარემოს დაყენებას, კონტეინერის მოძიებას, მოდელის განთავსებას და მისი მუშაობის შეფასებას როგორც CPU, ასევე GPU ინსტანციებზე, ხაზს უსვამს Text Embedding Inference (TEI)-ის ეფექტურობას და ხარჯ-ეფექტურობას.
მანქანური სწავლების გავლენა ინდუსტრიებზე: წამყვანი დირექტორების ხედვები
ეს სტატია წარმოგიდგენთ მანქანური სწავლების (ML) ლიდერთა შეხედულებების სერიის მეოთხე ნაწილს. მასში განხილულია, თუ რა გავლენას ახდენს ML სხვადასხვა ინდუსტრიაზე, ისეთი წამყვანი სპეციალისტების პერსპექტივიდან, როგორებიც არიან ხავიერ მანილა (Mercado Libre) და შონ გიტენსი (MasterPeace Solutions). ისინი საუბრობენ ML-ის გამოყენების მაგალითებზე ელექტრონულ კომერციაში, ფინტექში, მოწინავე ტექნოლოგიებსა და კიბერსერვისებში, ასევე გამოწვევებზე, ხშირ შეცდომებსა და სამომავლო ტენდენციებზე.

swift-transformers 1.0: ლოკალური ხელოვნური ინტელექტის ახალი ერა Apple Silicon-ზე
`swift-transformers` ბიბლიოთეკამ გამოუშვა ვერსია 1.0, რაც მის სტაბილურობასა და Apple Silicon პლატფორმებზე, iPhone-ების ჩათვლით, ლოკალური მანქანური სწავლების მოდელების უწყვეტი ინფერენციის მხარდაჭერის მზადყოფნას ადასტურებს. განახლება მიზნად ისახავს საზოგადოებისთვის მაქსიმალური სარგებლის მოტანას, მომავალი განვითარების საფუძვლების ჩაყრას და განსაკუთრებულ ყურადღებას უთმობს MLX-სა და აგენტურ გამოყენების შემთხვევებს.
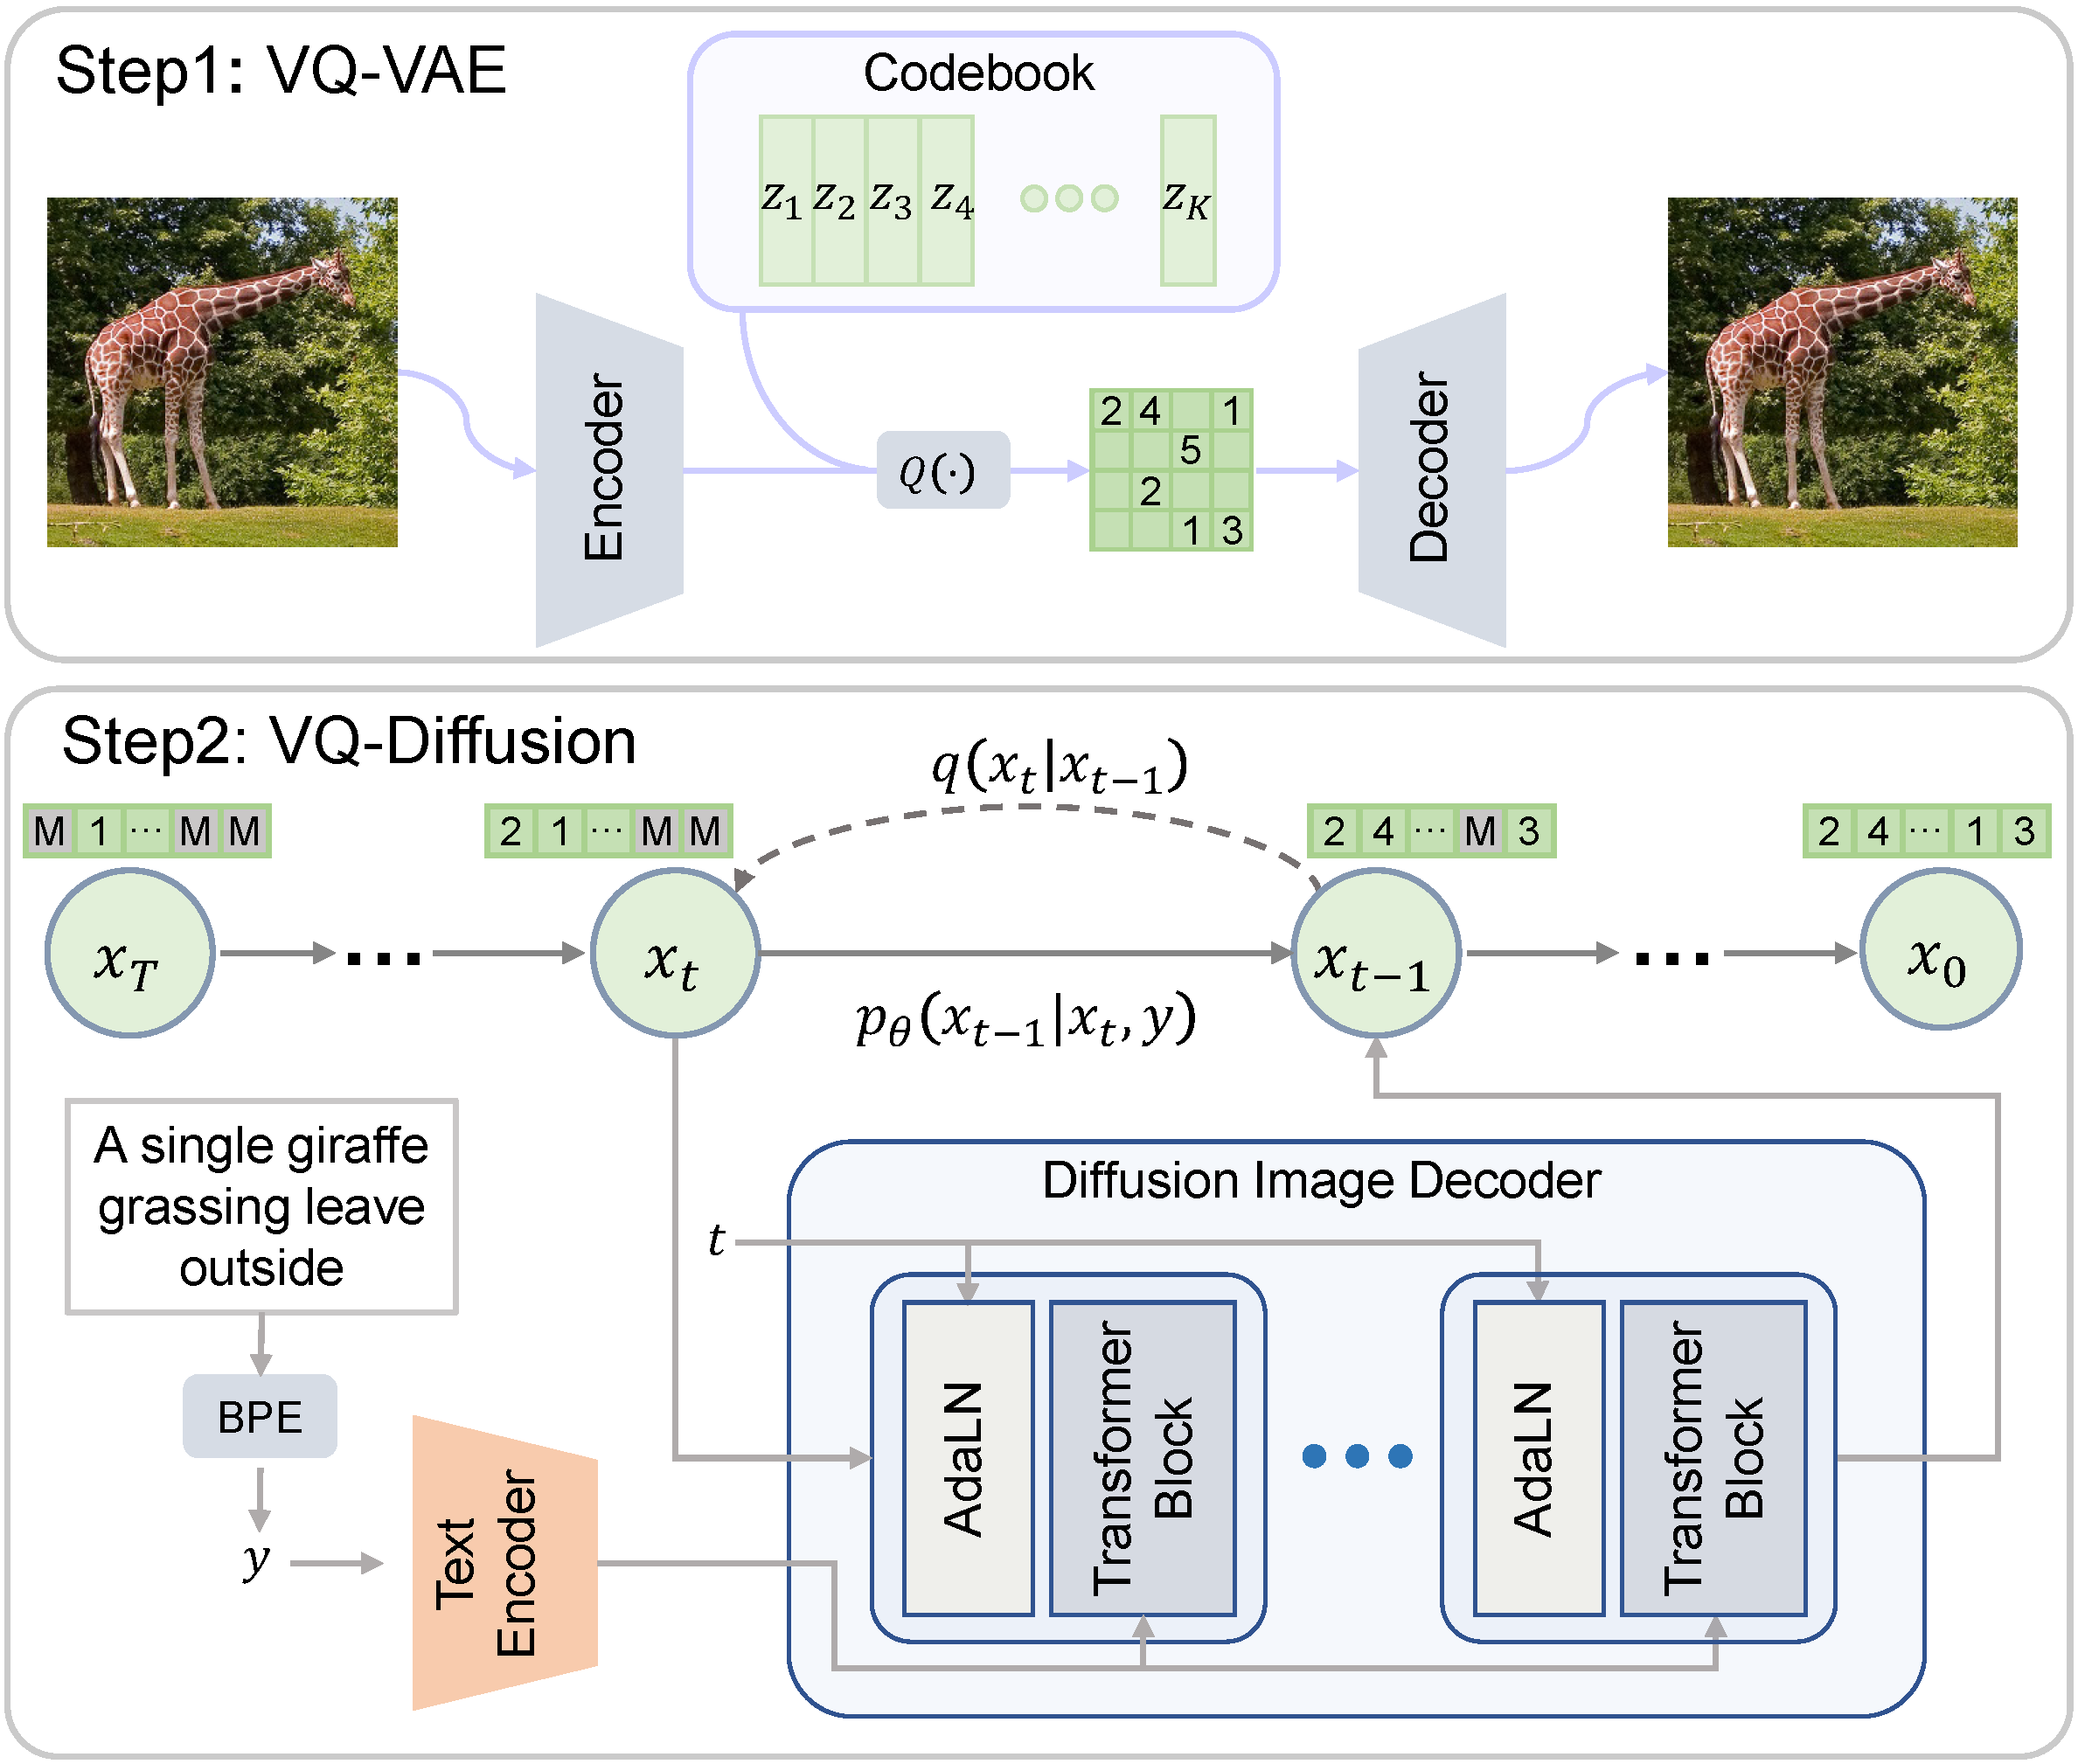
VQ-Diffusion: ახალი სიტყვა სურათების გენერაციაში Diffusers-ის დახმარებით
წარმოგიდგენთ VQ-Diffusion-ს, დისკრეტულ დიფუზიურ მოდელს, რომელიც სურათების გენერაციას სულ რამდენიმე ხაზი კოდით შესაძლებელს ხდის Diffusers ბიბლიოთეკის გამოყენებით. მოდელი ეფუძნება VQ-VAE ენკოდერს გამოსახულებების ლატენტურ ტოკენებად გარდასაქმნელად და იყენებს ენკოდერ-დეკოდერ ტრანსფორმერს. VQ-Diffusion მნიშვნელოვნად აუმჯობესებს AR მოდელების ნაკლოვანებებს, როგორიცაა ინფერენციის სიჩქარე და შეცდომების დაგროვება, რაც მას ეფექტურ და მძლავრ ინსტრუმენტად აქცევს ხელოვნური ინტელექტის საფუძველზე გამოსახულების შ
DeepSpeed-ისა და FSDP-ის სიზუსტის გამოწვევები: როგორ მოაგვარა Accelerate-მა პრობლემა PyTorch-ის ტრენინგში
ბოლო დროს, DeepSpeed-ისა და PyTorch FSDP-ის გამოყენებით Mistral-7B მოდელის ტრენინგისას, აღმოჩნდა განსხვავებული შედეგები, რაც DeepSpeed-ის მიერ შიდა fp32 სიზუსტის გამოყენებით იყო გამოწვეული. 🤗 Accelerate-მა ამ პრობლემის მოსაგვარებლად FSDP-ისთვის ავტომატური upcasting-ის ფუნქცია დაამატა, რითაც უზრუნველყო ჩარჩოების უკეთესი შეთავსება და გააუმჯობესა ტრენინგის სტაბილურობა. სტატია დეტალურად განიხილავს ამ აღმოჩენებს, დანერგილ ცვლილებებს და გამტარუნარიანობის შედარებებს.

NVIDIA-მ Nemotron-Personas-Japan გამოუშვა: იაპონური კულტურის გაგების ხელოვნური ინტელექტისთვის
NVIDIA-მ წარმოადგინა Nemotron-Personas-Japan, პირველი ღია სინთეზური მონაცემთა ნაკრები, რომელიც ასახავს იაპონიის დემოგრაფიას, გეოგრაფიულ განაწილებას და კულტურულ მახასიათებლებს. CC BY 4.0 ლიცენზიით გამოშვებული ეს ნაკრები უზრუნველყოფს კონფიდენციალურობის დამცავ საფუძველს იაპონური საზოგადოების ამსახველი AI სისტემების შესაქმნელად, მგრძნობიარე პირადი მონაცემების გამოყენების გარეშე. იგი შექმნილია იაპონური სუვერენული AI სისტემების მხარდასაჭერად და ადვილად ინტეგრირდება ღია კოდის დიდ ენობრივ მოდელებთან (LL
როგორ გავუშვათ Stable Diffusion Apple-ის მოწყობილობებზე Core ML-ის გამოყენებით
Apple-ის რეპოზიტორიუმი გვთავაზობს Stable Diffusion-ის კონვერტაციის სკრიპტებსა და დასკვნის (inference) კოდს Core ML-ისთვის. სიმარტივისთვის, მოდელების Core ML ვერსიები უკვე გადაყვანილია და ხელმისაწვდომია Hugging Face Hub-ზე. ასევე, შეიქმნა მშობლიური Swift აპლიკაცია, რომელიც Mac App Store-სა და ღია კოდის სახითაა გამოქვეყნებული, რათა მომხმარებლებმა მარტივად გაუშვან Stable Diffusion საკუთარ აპარატურაზე. სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ კონვერტირებული წონები, ან თავად გადაიყვანოთ დამატებით

Qwen3-8B-ის რევოლუციური აჩქარება: სპეკულაციური დეკოდირება და ოპტიმიზაცია OpenVINO-თი, ლოკალური AI აგენტებისთვის
ახლახან გამოშვებული Qwen3-8B მოდელი, თავისი აგენტური შესაძლებლობებით, იდეალურია AI პერსონალური კომპიუტერებისთვის. OpenVINO.GenAI-ის მეშვეობით, სპეკულაციური დეკოდირების გამოყენებით და მსუბუქი Qwen3-0.6B დრაფტ მოდელის გამოყენებით, გენერაციის სიჩქარე 1.3-ჯერ გაიზარდა. დრაფტ მოდელის ოპტიმიზაციით ეს მაჩვენებელი 1.4-ჯერ მიაღწია. ეს გაუმჯობესებები შესაძლებელს ხდის სწრაფი, ლოკალური AI აგენტების გაშვებას, რაც მათ უფრო პრაქტიკულს ხდის Intel® Core™ Ultra პლატფორმებზე.

RTEB: ახალი ბენჩმარკი ხელოვნური ინტელექტის მოდელების მოძიების ხარისხის საიმედო შეფასებისთვის
ხელოვნური ინტელექტის აპლიკაციების მუშაობა, როგორიცაა RAG და რეკომენდაციის სისტემები, მნიშვნელოვნად შეზღუდულია ძიებისა და მოძიების ხარისხით. დეველოპერებისთვის პრობლემას წარმოადგენს ემბედინგის მოდელების მოძიების ხარისხის ზუსტი გაზომვა, რადგან არსებული ბენჩმარკები ხშირად აჩვენებენ „განზოგადების ხარვეზს“ და არ შეესაბამებიან რეალურ საწარმოო გამოყენების შემთხვევებს. ამ გამოწვევების გადასაჭრელად შეიქმნა RTEB – ახალი, საიმედო ბენჩმარკი, რომელიც ზომავს მოძიების სიზუსტეს. ის იყენებს ჰიბრიდულ სტრატეგიას (ღ

Apple-ის ნერვული პროცესორი და ხელოვნური ინტელექტი მოწყობილობაზე: Core ML-ით და MLX-ით მოდელების ადაპტირება
ეს სტატია იკვლევს მანქანური სწავლების მოდელების ოპტიმიზაციის პროცესს Apple-ის მოწყობილობებზე ეფექტურად გასაშვებად, ნერვული პროცესორის, Core ML-ისა და MLX ფრეიმვორკების გამოყენებით. ის ხაზს უსვამს ნერვული პროცესორის ენერგოეფექტურობას და იმ გამოწვევებს, რომელთა წინაშეც დეველოპერები დგანან Core ML-ის დახურული ხასიათის გამო. ავტორები წარმოადგენენ სამნაწილიან სერიას, რომელიც დეტალურად აღწერს კომპლექსური მოდელის (dots.ocr) PyTorch-დან მოწყობილობაზე გასაშვებად კონვერტაციის გზას, იზიარებენ პრაქტიკულ გად
Florence-2-ის დახვეწა DocVQA-სთვის: როგორ გავაუმჯობესოთ ვიზუალური კითხვა-პასუხის შესაძლებლობები
ეს სტატია განიხილავს Florence-2 მოდელის დახვეწის პროცესს DocVQA (დოკუმენტური ვიზუალური კითხვა-პასუხი) ამოცანებისთვის. მიუხედავად იმისა, რომ Florence-2 მხარს უჭერს მრავალ კომპიუტერული ხედვის ამოცანას, VQA ფუნქციონალი არ არის ჩაშენებული გამოშვებულ მოდელებში. სტატიაში დეტალურად არის აღწერილი Florence-2-ის არქიტექტურა, უნიკალური FLD-5B მონაცემთა ნაკრების შექმნის პროცესი, რომელიც მოდელის სიძლიერის საფუძველია, და სხვადასხვა დახვეწის მეთოდის ექსპერიმენტები. ლევენშტეინის მსგავსების მეტრიკის გამოყენებით,
XLSCOUT-ი Hugging Face-თან პარტნიორობით პატენტების ანალიზში რევოლუციას ახდენს ParaEmbed 2.0-ით
ინტელექტუალურ საკუთრებაში ხელოვნური ინტელექტის (AI) გამოყენების ლიდერმა, XLSCOUT-მა, Hugging Face-თან თანამშრომლობით შეიმუშავა ParaEmbed 2.0 – მძლავრი საკუთრების მოდელი, რომელიც 23%-ით აუმჯობესებს სიზუსტეს პატენტების რთული დოკუმენტების ანალიზში. ეს პარტნიორობა, ღია კოდის AI მოდელებისა და XLSCOUT-ის სპეციალიზებული მონაცემების გაერთიანებით, უზრუნველყოფს მოწინავე გადაწყვეტილებებს პატენტების შედგენის, სიახლის ძიებისა და ბათილობის კვლევებისთვის, რითაც სარგებელს მიიღებენ კორპორაციები, უნივერსიტეტები დ

Arm PyTorch კონფერენციაზე: დეველოპერების გაძლიერება AI გადაწყვეტილებების შექმნაში
Arm-ი 22-23 ოქტომბერს PyTorch კონფერენციაზე დეველოპერებს სთავაზობს უნიკალურ შესაძლებლობებს ხელოვნური ინტელექტის (AI) აპლიკაციების შექმნისა და განთავსებისთვის PyTorch-ისა და ExecuTorch-ის გამოყენებით. კონფერენციაზე წარმოდგენილი იქნება უახლესი AI ტექნოლოგიები, ჩატარდება ინდივიდუალური ვორქშოფები პასუხისმგებლიანი AI განვითარების შესახებ და „დეველოპერის ხმის“ სესიები, სადაც დეველოპერები გაუზიარებენ საკუთარ გამოცდილებას. მონაწილეებს შესაძლებლობა ექნებათ გააფართოონ პროფესიული ქსელი, მიიღონ პრაქტიკული რ