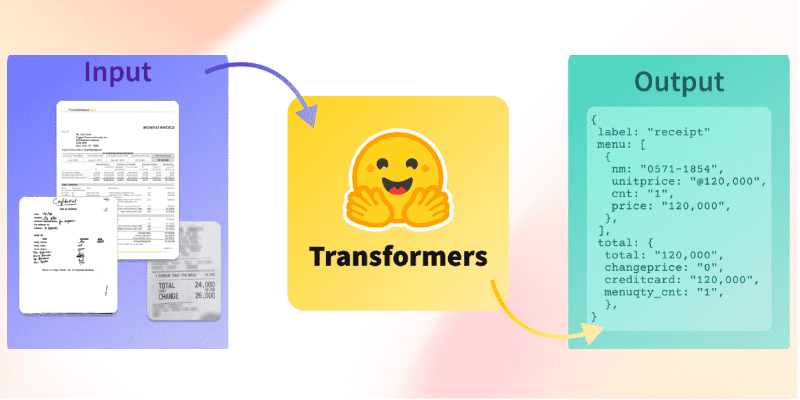
დოკუმენტების ხელოვნური ინტელექტი: OCR-დან დამუშავებამდე წამყვანი მოდელების გამოყენებით
ეს პოსტი იკვლევს დოკუმენტების ხელოვნურ ინტელექტს (Document AI), რომელიც მოიცავს მონაცემთა მეცნიერების სხვადასხვა ამოცანას, როგორიცაა ოპტიკური სიმბოლოების ამოცნობა (OCR), დოკუმენტების კლასიფიკაცია, განლაგების ანალიზი და დამუშავება (parsing). მასში წარმოდგენილია გამოყენების შემთხვევების ტაქსონომია, ხაზგასმულია საუკეთესო ღია კოდის მოდელები (მაგ., LayoutLM, Donut, DiT) და განხილულია ძირითადი ასპექტები, როგორიცაა ლიცენზირება, მონაცემთა მომზადება და შეფასების მეტრიკა. ტექსტი ხაზს უსვამს მულტიმოდალურ მ
დოკუმენტების ხელოვნური ინტელექტი (Document AI) მოიცავს მონაცემთა მეცნიერების ბევრ ამოცანას, დაწყებული გამოსახულების კლასიფიკაციით, გამოსახულებიდან ტექსტზე გადაყვანით, დოკუმენტებზე დაფუძნებული კითხვა-პასუხით, ცხრილებზე დაფუძნებული კითხვა-პასუხით და ვიზუალური კითხვა-პასუხით. ეს პოსტი იწყება Document AI-ის გამოყენების შემთხვევების ტაქსონომიით და ამ გამოყენების შემთხვევებისთვის საუკეთესო ღია კოდის მოდელებით. შემდეგ, პოსტი ყურადღებას ამახვილებს ლიცენზირებაზე, მონაცემთა მომზადებასა და მოდელირებაზე. მთელ პოსტში მოცემულია ბმულები ვებ დემოებზე, დოკუმენტაციასა და მოდელებზე.
დოკუმენტების ხელოვნური ინტელექტის გადაწყვეტილებების შესაქმნელად არსებობს მინიმუმ ექვსი ზოგადი გამოყენების შემთხვევა. ეს გამოყენების შემთხვევები განსხვავდება დოკუმენტის შეყვანისა და გამომავალი მონაცემების ტიპებით. საწარმოო Document AI პრობლემების გადაჭრისას ხშირად საჭიროა მიდგომების კომბინაცია. ნაბეჭდი, ხელნაწერი ან ბეჭდური ტექსტის მანქანურად კოდირებულ ტექსტად გადაქცევა ცნობილია როგორც ოპტიკური სიმბოლოების ამოცნობა (OCR). ეს არის ფართოდ შესწავლილი პრობლემა მრავალი კარგად ჩამოყალიბებული ღია კოდის და კომერციული შეთავაზებით. სურათზე ნაჩვენებია ხელნაწერის ტექსტად გადაქცევის მაგალითი. OCR არის Document AI-ის გამოყენების შემთხვევების ხერხემალი, რადგან ის აუცილებელია ტექსტის კომპიუტერისთვის წაკითხვად ფორმად გადასაყვანად. ზოგიერთი ფართოდ ხელმისაწვდომი OCR მოდელი, რომელიც დოკუმენტის დონეზე მუშაობს, არის EasyOCR ან PaddleOCR. ასევე არსებობს მოდელები, როგორიცაა TrOCR: Transformer-ზე დაფუძნებული ოპტიკური სიმბოლოების ამოცნობა წინასწარ გაწვრთნილი მოდელებით, რომელიც მუშაობს ერთ ტექსტურ ხაზოვან გამოსახულებებზე. ეს მოდელი მუშაობს ტექსტის დეტექციის მოდელთან, როგორიცაა CRAFT, რომელიც ჯერ ამოიცნობს დოკუმენტში ტექსტის ცალკეულ „ნაწილებს“ შემომფარგლავი ყუთების სახით. OCR-ისთვის შესაბამისი მეტრიკებია სიმბოლოების შეცდომის მაჩვენებელი (CER) და სიტყვის დონის სიზუსტე (precision), სისრულე (recall) და F1 მაჩვენებელი. იხილეთ ეს Space CRAFT-ისა და TrOCR-ის დემონსტრაციის სანახავად.
დოკუმენტების შესაბამის კატეგორიაში კლასიფიცირება, როგორიცაა ფორმები, ინვოისები ან წერილები, ცნობილია როგორც დოკუმენტის გამოსახულების კლასიფიკაცია. კლასიფიკაციამ შესაძლოა გამოიყენოს დოკუმენტის გამოსახულება, ტექსტი, ან ორივე ერთად. მულტიმოდალური მოდელების ბოლოდროინდელმა დამატებამ, რომლებიც იყენებენ ვიზუალურ სტრუქტურასა და ძირითად ტექსტს, მნიშვნელოვნად გაზარდა კლასიფიკატორის შესრულება. ძირითადი მიდგომაა OCR-ის გამოყენება დოკუმენტის გამოსახულებაზე, რის შემდეგაც BERT-ის მსგავსი მოდელი გამოიყენება კლასიფიკაციისთვის. თუმცა, მხოლოდ BERT მოდელზე დაყრდნობით, არ ხდება განლაგების ან ვიზუალური ინფორმაციის გათვალისწინება. RVL-CDIP მონაცემთა ნაკრებიდან მიღებული სურათი აჩვენებს, თუ როგორ განსხვავდება ვიზუალური სტრუქტურა სხვადასხვა დოკუმენტის ტიპების მიხედვით.
აქ შემოდის ისეთი მოდელები, როგორიცაა LayoutLM და Donut. ტექსტის გარდა ვიზუალური ინფორმაციის ჩართვით, ამ მოდელებს შეუძლიათ მნიშვნელოვნად გაზარდონ სიზუსტე. შედარებისთვის, RVL-CDIP-ზე, რომელიც დოკუმენტის გამოსახულების კლასიფიკაციის მნიშვნელოვანი ბენჩმარკია, BERT-base მოდელი აღწევს 89%-იან სიზუსტეს ტექსტის გამოყენებით. DiT (Document Image Transformer) არის წმინდა ვიზუალური მოდელი (ანუ, ის არ იღებს ტექსტს შეყვანად) და შეუძლია მიაღწიოს 92%-იან სიზუსტეს. მაგრამ მოდელებს, როგორიცაა LayoutLMv3 და Donut, რომლებიც იყენებენ ტექსტურ და ვიზუალურ ინფორმაციას ერთად მულტიმოდალური ტრანსფორმატორის საშუალებით, შეუძლიათ მიაღწიონ 95%-იან სიზუსტეს! ეს მულტიმოდალური მოდელები ცვლის იმას, თუ როგორ წყვეტენ პრაქტიკოსები Document AI-ის გამოყენების შემთხვევებს. დოკუმენტის განლაგების ანალიზი არის დოკუმენტის ფიზიკური სტრუქტურის განსაზღვრის ამოცანა, ანუ დოკუმენტის შემადგენელი ინდივიდუალური ბლოკების იდენტიფიცირება, როგორიცაა ტექსტური სეგმენტები, სათაურები და ცხრილები. ეს ამოცანა ხშირად წყდება მისი გამოსახულების სეგმენტაციის/ობიექტის ამოცნობის პრობლემად ფორმულირებით. მოდელი გამოაქვს სეგმენტაციის ნიღბების/შემომფარგლავი ყუთების ნაკრებს, კლასის სახელებთან ერთად. მოდელები, რომლებიც ამჟამად უახლესი ტექნოლოგიაა დოკუმენტის განლაგების ანალიზისთვის, არის LayoutLMv3 და DiT (Document Image Transformer). ორივე მოდელი იყენებს კლასიკურ Mask R-CNN ფრეიმვორკს ობიექტის ამოცნობისთვის, როგორც ხერხემალს. ეს დოკუმენტის განლაგების ანალიზის Space გვიჩვენებს, თუ როგორ შეიძლება DiT-ის გამოყენება დოკუმენტებში ტექსტური სეგმენტების, სათაურებისა და ცხრილების იდენტიფიცირებისთვის. აქ ნაჩვენებია DiT-ის გამოყენების მაგალითი დოკუმენტის სხვადასხვა ნაწილის ამოსაცნობად. დოკუმენტის განლაგების ანალიზი DiT-ით. დოკუმენტის განლაგების ანალიზი, როგორც წესი, იყენებს mAP (საშუალო სიზუსტე) მეტრიკას, რომელიც ხშირად გამოიყენება ობიექტის ამოცნობის მოდელების შესაფასებლად. განლაგების ანალიზისთვის მნიშვნელოვანი ბენჩმარკია PubLayNet მონაცემთა ნაკრები. LayoutLMv3, რომელიც წერის მომენტისთვის უახლეს ტექნოლოგიას წარმოადგენს, აღწევს საერთო mAP ქულას 0.951 (წყარო).
განლაგების ანალიზის შემდეგი ნაბიჯი არის დოკუმენტის დამუშავება (parsing). დოკუმენტის parsing არის დოკუმენტიდან ძირითადი ინფორმაციის (ხშირად გასაღები-მნიშვნელობის წყვილების სახით) იდენტიფიცირება და ამოღება, როგორიცაა სახელები, ნივთები და ჯამური თანხები ინვოისის ფორმიდან. ეს LayoutLMv2 Space გვიჩვენებს, თუ როგორ უნდა მოხდეს დოკუმენტის parsing კითხვების, პასუხების და სათაურების ამოსაცნობად. LayoutLM-ის პირველი ვერსია (ახლა ცნობილი როგორც LayoutLMv1) გამოვიდა 2020 წელს და მნიშვნელოვნად გაუმჯობესდა არსებულ ბენჩმარკებთან შედარებით, და ის კვლავ რჩება ერთ-ერთ ყველაზე პოპულარულ მოდელად Hugging Face Hub-ზე Document AI-სთვის. LayoutLMv2 და LayoutLMv3 აერთიანებენ ვიზუალურ მახასიათებლებს წინასწარი გაწვრთნის დროს, რაც იწვევს გაუმჯობესებას. LayoutLM-ის ოჯახმა გამოიწვია ნახტომისებური ცვლილება Document AI-ის შესრულებაში. მაგალითად, FUNSD ბენჩმარკულ მონაცემთა ნაკრებზე, BERT მოდელს აქვს F1 ქულა 60%, მაგრამ LayoutLM-ით შესაძლებელია 90%-მდე მიღწევა! LayoutLMv1-ს ახლა მრავალი მემკვიდრე ჰყავს,
თეგები:
#ხელოვნური ინტელექტი
#მანქანური სწავლება
#მონაცემთა მეცნიერება
#ocr
#ღია კოდის მოდელები
#document ai
#layoutlm
#donut
#dit
#დოკუმენტის კლასიფიკაცია
#განლაგების ანალიზი
წყარო: huggingface.co
AI-ით გადამუშავებული
მსგავსი სტატიები

ხელოვნური ინტელექტი
Anthropic-ის Claude-ის აღზევება Apple App Store-ის რეიტინგებში პენტაგონთან მოლაპარაკებების ფონზე

ხელოვნური ინტელექტი
ტრამპის ადმინისტრაცია Anthropic-ს სანქციებს უწესებს ხელოვნური ინტელექტის გამოყენებაზე უარის გამო: ექსპერტი ინდუსტრიის უსაფრთხოების ხარვეზებზე საუბრობს
ხელოვნური ინტელექტი