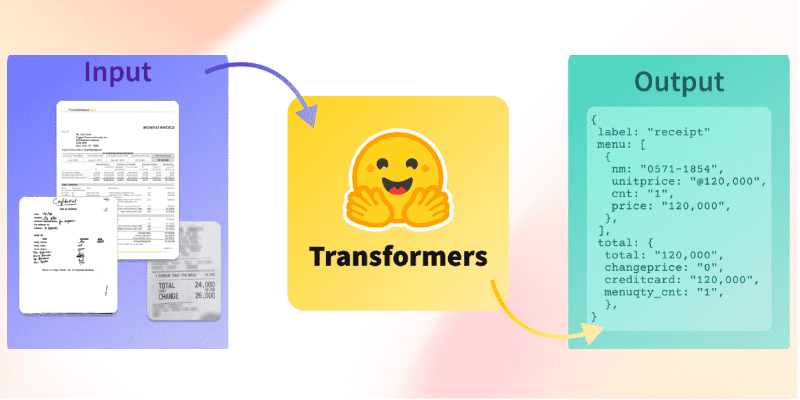
დოკუმენტების ხელოვნური ინტელექტი: OCR-დან დამუშავებამდე წამყვანი მოდელების გამოყენებით
ეს პოსტი იკვლევს დოკუმენტების ხელოვნურ ინტელექტს (Document AI), რომელიც მოიცავს მონაცემთა მეცნიერების სხვადასხვა ამოცანას, როგორიცაა ოპტიკური სიმბოლოების ამოცნობა (OCR), დოკუმენტების კლასიფიკაცია, განლაგების ანალიზი და დამუშავება (parsing). მასში წარმოდგენილია გამოყენების შემთხვევების ტაქსონომია, ხაზგასმულია საუკეთესო ღია კოდის მოდელები (მაგ., LayoutLM, Donut, DiT) და განხილულია ძირითადი ასპექტები, როგორიცაა ლიცენზირება, მონაცემთა მომზადება და შეფასების მეტრიკა. ტექსტი ხაზს უსვამს მულტიმოდალურ მ

ხელოვნური ინტელექტი დოკუმენტების დამუშავებაში: ხედვა-ენის მოდელების აღზევება და სწორი არჩევანის გზამკვლევი
მძლავრი ხედვა-ენის მოდელების (VLM) განვითარებამ დოკუმენტების ხელოვნური ინტელექტის სფერო (Document AI) გარდაქმნა. თითოეულ მოდელს უნიკალური შესაძლებლობები აქვს, რაც მათ შორის არჩევანს ართულებს. ღია წონის მოდელები უკეთეს ხარჯთეფექტურობასა და კონფიდენციალურობას გვთავაზობს. ეს გზამკვლევი დაგეხმარებათ გაიგოთ, როგორ შეარჩიოთ სწორი ოპტიკური სიმბოლოების ამოცნობის (OCR) მოდელი, დაიწყოთ მისი გამოყენება და მიიღოთ ღრმა ცოდნა დოკუმენტების ხელოვნური ინტელექტის შესახებ. სტატია მიმოიხილავს OCR-ის განვითარებას, თ