vdr-2b-multi-v1: მრავალენოვანი ჩაშენების მოდელი ვიზუალური დოკუმენტების ეფექტური მოძიებისთვის
Hugging Face-ის მიერ წარდგენილია vdr-2b-multi-v1, მრავალენოვანი ჩაშენების მოდელი, რომელიც განკუთვნილია ვიზუალური დოკუმენტების მოძიებისთვის სხვადასხვა ენასა და დომენში. ეს მოდელი აკოდირებს დოკუმენტის გვერდის სქრინშოტებს მკვრივ ერთვექტორულ წარმოდგენებად, რაც შესაძლებელს ხდის ვიზუალურად მდიდარი მრავალენოვანი დოკუმენტების ძიებას და მოთხოვნას OCR-ის, მონაცემთა ამოღების კონვეიერების ან დანაწილების გარეშე. იგი აგებულია MrLight/dse-qwen2-2b-mrl-v1-ზე და გაწვრთნილია ვრცელ, თვითშექმნილ მონაცემთა ბაზაზე. L

Google-მა PaliGemma 2 Mix გამოუშვა: ახალი ვიზუალური ენის მოდელები გაუმჯობესებული შესაძლებლობებით
Google-მა წარადგინა PaliGemma 2 Mix, წინასწარ გაწვრთნილი PaliGemma 2 ვიზუალური ენის მოდელების (VLMs) ახალი ოჯახი, რომელიც დაზუსტებულია სხვადასხვა ვიზუალური ენის ამოცანებისთვის, მათ შორის OCR-ისთვის, მოკლე და გრძელი აღწერისთვის, ობიექტის ამოცნობისა და გამოსახულების სეგმენტაციისთვის. ეს მოდელები, რომლებიც Gemma 2-სა და SigLIP-ზეა დაფუძნებული, შექმნილია შემდგომ ამოცანებზე უკეთესი სწავლისთვის და ხელმისაწვდომია სხვადასხვა ზომისა და რეზოლუციის ვარიანტებში, რაც აჩქარებს დეველოპერებისთვის პროტოტიპების შ
Google-მა PaliGemma 2 mix წარადგინა: ახალი, დახვეწილი ვიზუალურ-ენობრივი მოდელები
გასულ დეკემბერში Google-მა PaliGemma 2-ის წინასწარ გაწვრთნილი (pt) ვიზუალურ-ენობრივი მოდელები (VLM) გამოუშვა, რომლებიც SigLIP-სა და Gemma 2-ზეა დაფუძნებული. დღეს კომპანია წარმოადგენს PaliGemma 2 mix-ს, რომელიც დახვეწილია ვიზუალურ-ენობრივ ამოცანებზე, მათ შორის OCR-ზე (ოპტიკური სიმბოლოების ამოცნობა), გრძელ და მოკლე წარწერების გენერირებაზე და სხვა. ეს მოდელები განკუთვნილია სპეციფიკურ ამოცანებზე ადაპტირებისთვის და გთავაზობთ სხვადასხვა შესაძლებლობებს, როგორიცაა ობიექტის ამოცნობა და სეგმენტაცია, გაუმჯ

olmOCR-ის გაუმჯობესება: სრული დოკუმენტის კონტექსტის ამოცნობა სათაურებისა და ქვედა კოლონტიტულების ჩათვლით
olmOCR ხშირად უგულებელყოფს მნიშვნელოვან ინფორმაციას დოკუმენტების სათაურებსა და ქვედა კოლონტიტულებში, რაც მის საწყის სატრენინგო მონაცემთა ბაზის თავისებურებებით იყო განპირობებული. ამ პრობლემის გადასაჭრელად, მკვლევრებმა olmOCR-ის მოდელი დახვეწეს Qwen2.5-VL-72B-Instruct-ის მიერ გენერირებული 8,000 დოკუმენტისგან შემდგარი ახალი მონაცემთა ბაზის გამოყენებით. შედეგად, მოდელი ახლა სრულყოფილად იღებს მთელ კონტენტს, მათ შორის ადრე გამოტოვებულ მონაცემებსაც, რაც გადამწყვეტია ბიზნეს აპლიკაციებისთვის, როგორიცაა ი

NVIDIA-ს Llama Nemotron Nano VL: რევოლუცია ინტელექტუალური დოკუმენტების დამუშავებაში
NVIDIA-მ წარმოადგინა Llama Nemotron Nano VL, 8 მილიარდპარამეტრიანი ხედვითი ენის მოდელი (VLM), რომელიც განკუთვნილია ინტელექტუალური დოკუმენტების დამუშავებისთვის (IDP). მოდელი გამოირჩევა მაღალი სიზუსტით და მულტიმოდალური გაგებით, რაც საშუალებას აძლევს მას ეფექტურად მოიპოვოს და გაიგოს ინფორმაცია კომპლექსური დოკუმენტებიდან, როგორიცაა ინვოისები, ქვითრები, კონტრაქტები, PDF ფაილები, სურათები და დიაგრამები. Llama Nemotron Nano VL აჩვენებს ინდუსტრიაში წამყვან შედეგებს OCRBench v2 ბენჩმარკზე, რაც უზრუნველყო
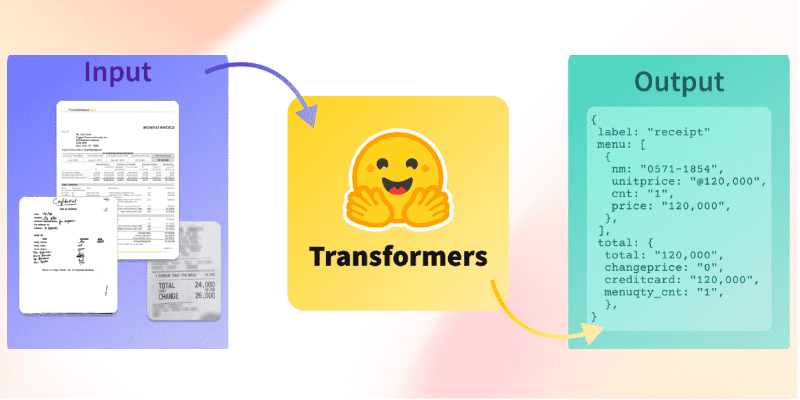
დოკუმენტების ხელოვნური ინტელექტი: OCR-დან დამუშავებამდე წამყვანი მოდელების გამოყენებით
ეს პოსტი იკვლევს დოკუმენტების ხელოვნურ ინტელექტს (Document AI), რომელიც მოიცავს მონაცემთა მეცნიერების სხვადასხვა ამოცანას, როგორიცაა ოპტიკური სიმბოლოების ამოცნობა (OCR), დოკუმენტების კლასიფიკაცია, განლაგების ანალიზი და დამუშავება (parsing). მასში წარმოდგენილია გამოყენების შემთხვევების ტაქსონომია, ხაზგასმულია საუკეთესო ღია კოდის მოდელები (მაგ., LayoutLM, Donut, DiT) და განხილულია ძირითადი ასპექტები, როგორიცაა ლიცენზირება, მონაცემთა მომზადება და შეფასების მეტრიკა. ტექსტი ხაზს უსვამს მულტიმოდალურ მ

Apple-ის ნერვული პროცესორი და ხელოვნური ინტელექტი მოწყობილობაზე: Core ML-ით და MLX-ით მოდელების ადაპტირება
ეს სტატია იკვლევს მანქანური სწავლების მოდელების ოპტიმიზაციის პროცესს Apple-ის მოწყობილობებზე ეფექტურად გასაშვებად, ნერვული პროცესორის, Core ML-ისა და MLX ფრეიმვორკების გამოყენებით. ის ხაზს უსვამს ნერვული პროცესორის ენერგოეფექტურობას და იმ გამოწვევებს, რომელთა წინაშეც დეველოპერები დგანან Core ML-ის დახურული ხასიათის გამო. ავტორები წარმოადგენენ სამნაწილიან სერიას, რომელიც დეტალურად აღწერს კომპლექსური მოდელის (dots.ocr) PyTorch-დან მოწყობილობაზე გასაშვებად კონვერტაციის გზას, იზიარებენ პრაქტიკულ გად
ML მოდელების კონვერტაცია Apple-ის მოწყობილობებზე: Core ML-ისა და MLX-ის გამოყენება `dots.ocr`-ის მაგალითზე
სტატია დეტალურად აღწერს, თუ როგორ ხდება მანქანური სწავლების (ML) მოდელების, კერძოდ `dots.ocr`-ის, ოპტიმიზაცია Apple-ის მოწყობილობებზე გასაშვებად. განხილულია Apple-ის ნეირონული ძრავის ენერგოეფექტურობა და Core ML-ის, როგორც მასზე წვდომის ერთადერთი საშუალების, შეზღუდვები. ასევე წარმოდგენილია MLX, უფრო მოქნილი ფრეიმვორკი, რომელიც GPU-ს იყენებს. სერიის პირველი ნაწილი მოიცავს `dots.ocr`-ის PyTorch-დან Core ML-ზე კონვერტაციის პროცესს, წარმოქმნილ პრობლემებს და მათ გადაჭრის გზებს, რათა დეველოპერებს დაეხმ

ხელოვნური ინტელექტი დოკუმენტების დამუშავებაში: ხედვა-ენის მოდელების აღზევება და სწორი არჩევანის გზამკვლევი
მძლავრი ხედვა-ენის მოდელების (VLM) განვითარებამ დოკუმენტების ხელოვნური ინტელექტის სფერო (Document AI) გარდაქმნა. თითოეულ მოდელს უნიკალური შესაძლებლობები აქვს, რაც მათ შორის არჩევანს ართულებს. ღია წონის მოდელები უკეთეს ხარჯთეფექტურობასა და კონფიდენციალურობას გვთავაზობს. ეს გზამკვლევი დაგეხმარებათ გაიგოთ, როგორ შეარჩიოთ სწორი ოპტიკური სიმბოლოების ამოცნობის (OCR) მოდელი, დაიწყოთ მისი გამოყენება და მიიღოთ ღრმა ცოდნა დოკუმენტების ხელოვნური ინტელექტის შესახებ. სტატია მიმოიხილავს OCR-ის განვითარებას, თ
სახელმძღვანელო ღია წონის OCR მოდელებისთვის: როგორ ავირჩიოთ და გამოვიყენოთ ისინი დოკუმენტების AI-ში
მძლავრი ვიზუალური-ლინგვალური მოდელების (VLM) გაჩენამ რევოლუცია მოახდინა დოკუმენტების ხელოვნური ინტელექტის (AI) სფეროში, თუმცა სწორი მოდელის არჩევა რთულია. ღია წონის მოდელები გვთავაზობს ხარჯთეფექტურობასა და კონფიდენციალურობას. ეს სახელმძღვანელო დაგეხმარებათ გაიგოთ, როგორ ფუნქციონირებს OCR, როგორ ამუშავებს თანამედროვე VLM-ები რთულ დოკუმენტებს, მათ შორის ცხრილებსა და დიაგრამებს, რა გამომავალ ფორმატებს იყენებენ და როგორ ირჩევა შესაფერისი მოდელი თქვენი საჭიროებებისთვის. სტატია გთავაზობთ რჩევებს მოდელ