VQ-Diffusion: ახალი სიტყვა სურათების გენერაციაში Diffusers-ის დახმარებით
წარმოგიდგენთ VQ-Diffusion-ს, დისკრეტულ დიფუზიურ მოდელს, რომელიც სურათების გენერაციას სულ რამდენიმე ხაზი კოდით შესაძლებელს ხდის Diffusers ბიბლიოთეკის გამოყენებით. მოდელი ეფუძნება VQ-VAE ენკოდერს გამოსახულებების ლატენტურ ტოკენებად გარდასაქმნელად და იყენებს ენკოდერ-დეკოდერ ტრანსფორმერს. VQ-Diffusion მნიშვნელოვნად აუმჯობესებს AR მოდელების ნაკლოვანებებს, როგორიცაა ინფერენციის სიჩქარე და შეცდომების დაგროვება, რაც მას ეფექტურ და მძლავრ ინსტრუმენტად აქცევს ხელოვნური ინტელექტის საფუძველზე გამოსახულების შ
Diffusers-ის საშუალებით VQ-Diffusion-ის გაშვება სულ რამდენიმე ხაზი კოდით არის შესაძლებელი. დააყენეთ დამოკიდებულებები, ჩატვირთეთ ფაიფლაინი, თუ გსურთ FP16 წონების გამოყენება, გადაიტანეთ GPU-ზე და გაუშვით ფაიფლაინი!
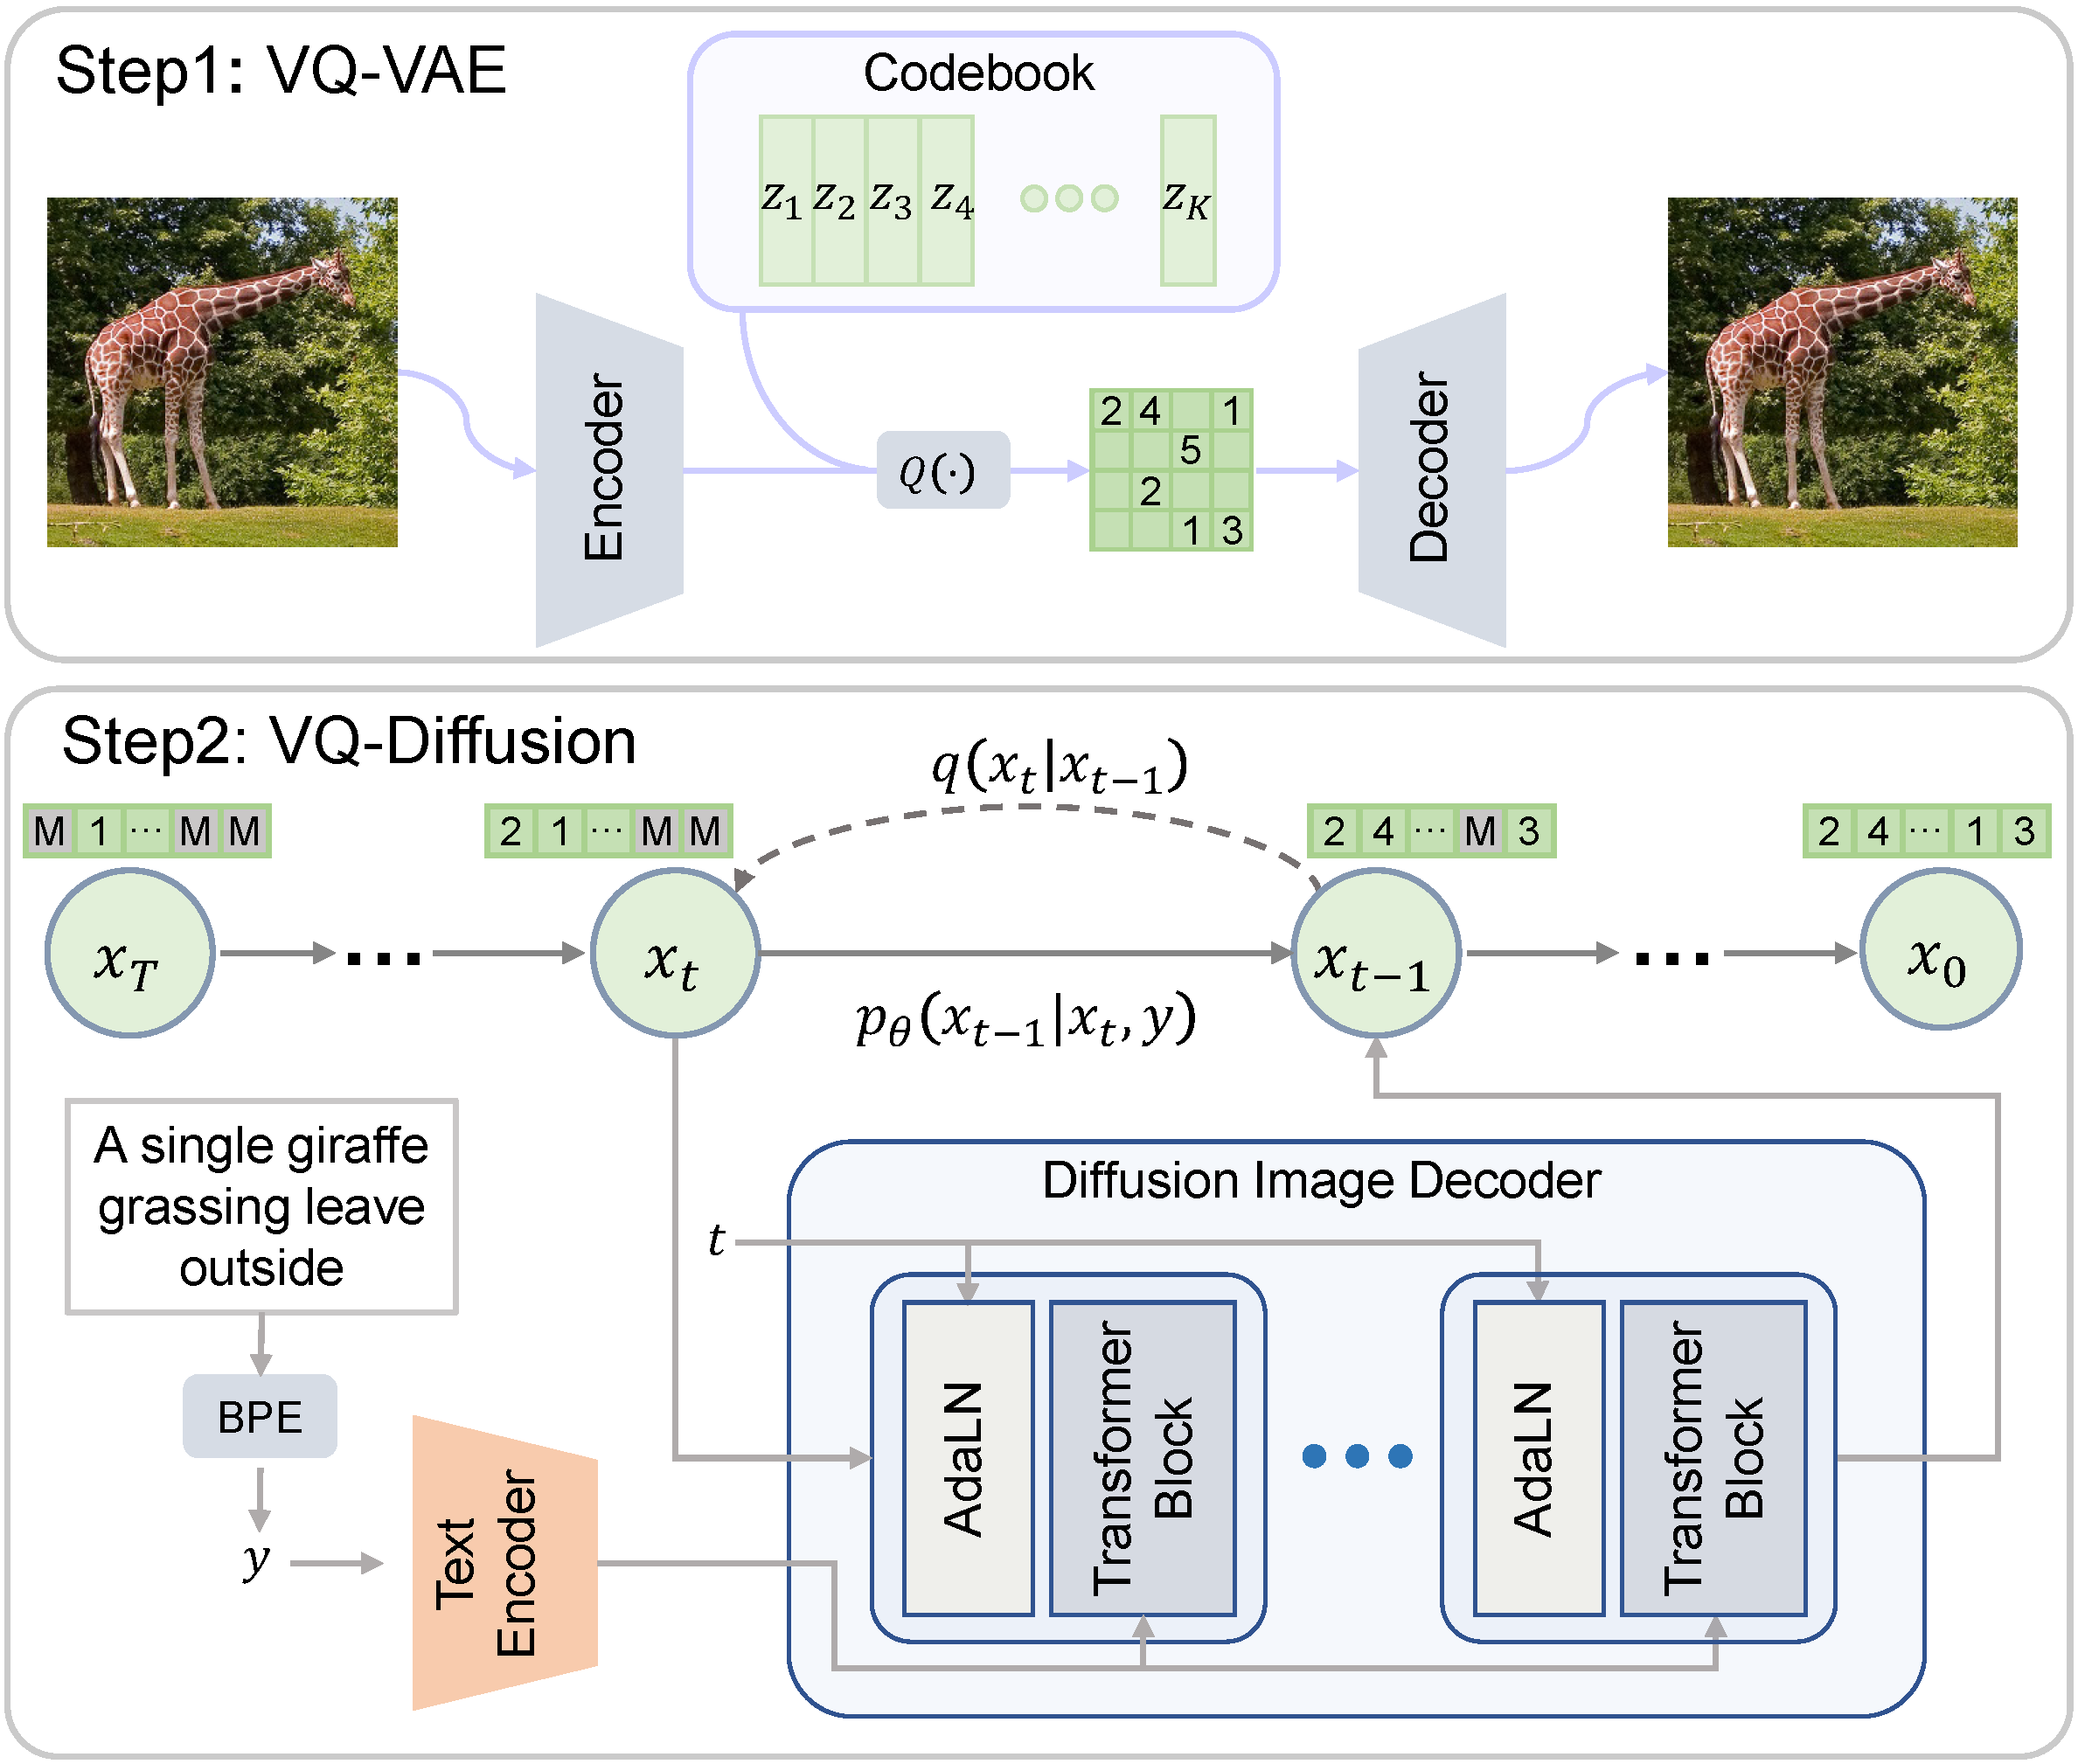
გამოსახულებები კოდირდება დისკრეტული „ტოკენების“ ან ემბედინგის ვექტორების ერთობლიობაში VQ-VAE ენკოდერის გამოყენებით. ამისათვის, სურათები იყოფა პატჩებად, შემდეგ კი თითოეული პატჩი იცვლება კოდბუქიდან უახლოესი ჩანაწერით ფიქსირებული ზომის ლექსიკონით. ეს ამცირებს შეყვანის პიქსელების სივრცის განზომილებას. VQ-Diffusion იყენებს VQGAN ვარიანტს „Taming Transformers“-დან. ეს ბლოგ-პოსტი კარგი რესურსია VQ-VAE-ების უკეთ გასაგებად. VQ-Diffusion იყენებს წინასწარ გაწვრთნილ VQ-VAE-ს, რომელიც გაყინული იყო დიფუზიის ვარჯიშის პროცესში.
წინ დიფუზიის პროცესში, თითოეული ლატენტური ტოკენი შეიძლება დარჩეს უცვლელი, ხელახლა იყოს შერჩეული სხვა ლატენტურ ვექტორად (თითოეული თანაბარი ალბათობით) ან იყოს შენიღბული (masked). მას შემდეგ, რაც ლატენტური ტოკენი შენიღბული იქნება, ის ასეთადვე დარჩება. αt \alpha_t αt, βt \beta_t βt, და γt \gamma_t γt არის ჰიპერპარამეტრები, რომლებიც აკონტროლებენ წინ დიფუზიის პროცესს t−1 t-1 t-1 ნაბიჯიდან t t t ნაბიჯამდე. γt \gamma_t γt არის ალბათობა, რომ შეუპარებელი ტოკენი გახდება შენიღბული. αt+βt \alpha_t + \beta_t αt+βt არის ალბათობა, რომ შეუპარებელი ტოკენი უცვლელი დარჩეს. ტოკენს შეუძლია გადავიდეს ნებისმიერ ინდივიდუალურ, შეუპარავ ლატენტურ ვექტორში βt \beta_t βt ალბათობით. სხვა სიტყვებით, αt+Kβt+γt=1 \alpha_t + K \beta_t + \gamma_t = 1 αt+Kβt+γt=1, სადაც K K K არის შეუპარავი ლატენტური ვექტორების რაოდენობა. დეტალებისთვის იხილეთ ნაშრომის 4.1 განყოფილება.
ენკოდერ-დეკოდერ ტრანსფორმერი აპროქსიმირებს ხმაურისგან თავისუფალი ლატენტების, x0 x_0 x0, კლასებს, რომლებიც პირობითად ეფუძნება მოთხოვნას, y y y. ენკოდერი არის CLIP ტექსტური ენკოდერი გაყინული წონებით. დეკოდერ ტრანსფორმერი უზრუნველყოფს შეუპარავ გლობალურ ყურადღებას ყველა ლატენტურ პიქსელზე და გამოაქვს კატეგორიული განაწილების ლოგარითმული ალბათობები ვექტორულ ემბედინგებზე. დეკოდერ ტრანსფორმერი იწინასწარმეტყველებს ხმაურისგან თავისუფალი ლატენტების მთელ განაწილებას ერთი წინ მიმართული გაშვებით, რაც უზრუნველყოფს გლობალურ თვითყურადღებას xt x_t xt-ზე. პრობლემის პირობითი მიმდევრობა-მიმდევრობად განხილვა დისკრეტულ მნიშვნელობებზე გვაძლევს გარკვეულ ინტუიციას, თუ რატომ არის ენკოდერ-დეკოდერ ტრანსფორმერი კარგი არჩევანი.
AR მოდელების განყოფილება უზრუნველყოფს დამატებით კონტექსტს VQ-Diffusion-ის არქიტექტურის შესახებ AR ტრანსფორმერზე დაფუძნებულ მოდელებთან შედარებით. „Taming Transformers“ გვაწვდის კარგ განხილვას ნედლი პიქსელების დისკრეტულ ტოკენებად გადაქცევის შესახებ შეკუმშულ ლატენტურ სივრცეში, რათა ტრანსფორმერები გამოთვლითად მიზანშეწონილი გახდეს სურათის მონაცემებისთვის.
თანამედროვე დიფუზიური მოდელები ძირითადად უწყვეტია. წინ მიმართული პროცესის დროს, უწყვეტი დიფუზიური მოდელები იტერაციულად ამატებენ გაუსის ხმაურს. შებრუნებული პროცესი აპროქსიმირებულია pθ(xt−1∣xt)=N(xt−1;μθ(xt,t),Σθ(xt,t)) p_{\theta}(x_{t-1} | x_t) = N(x_{t-1}; \mu_{\theta}(x_t, t), \Sigma_{\theta}(x_t, t)) pθ(xt−1∣xt)=N(xt−1;μθ(xt,t),Σθ(xt,t)) ფორმულით. DDPM-ის უფრო მარტივ შემთხვევაში, კოვარიაციის მატრიცა ფიქსირებულია, U-Net გაწვრთნილია xt x_t xt-ში ხმაურის პროგნოზირებისთვის, და xt−1 x_{t-1} xt−1 მიიღება ხმაურისგან. მიახლოებითი შებრუნებული პროცესი სტრუქტურულად მსგავსია დისკრეტული შებრუნებული პროცესისა. თუმცა, დისკრეტულ შემთხვევაში, არ არსებობს მკაფიო ანალოგი xt x_t xt-ში ხმაურის პროგნოზირებისთვის, და x0 x_0 x0-სთვის განაწილების პირდაპირი პროგნოზირება უფრო ნათელი მიზანია.
დისკრეტული დიფუზიური მოდელების შესახებ ლიტერატურა უფრო მცირეა, ვიდრე უწყვეტი დიფუზიური მოდელების შესახებ. „Deep Unsupervised Learning using Nonequilibrium Thermodynamics“ წარმოადგენს დიფუზიურ მოდელს ბინომიალურ განაწილებაზე. „Argmax Flows and Multinomial Diffusion“ აფართოებს დისკრეტულ დიფუზიას მულტინომიალურ განაწილებებამდე და წვრთნის ტრანსფორმერს ენის მოდელირების ამოცანისთვის გაუხმაურებელი განაწილების პროგნოზირებისთვის. „Structured Denoising Diffusion Models in Discrete State-Spaces“ აზოგადებს მულტინომიალურ დიფუზიას ალტერნატიული ხმაურის პროცესებით — უნიფორმა, შთანთქმადი, დისკრეტიზებული გაუსი და ტოკენის ემბედინგის მანძილი. ალტერნატიული ხმაურის პროცესები ასევე შესაძლებელია უწყვეტ დიფუზიურ მოდელებში, მაგრამ, როგორც ნაშრომშია აღნიშნული, მხოლოდ ადიტიურმა გაუსის ხმაურმა მიიპყრო მნიშვნელოვანი ყურადღება.
შესაძლოა უფრო საინტერესოა VQ-Diffusion-ის შედარება AR მოდელებთან, რადგან ისინი უფრო ხშირად იყენებენ ტრანსფორმერებს, რომლებიც პროგნოზირებენ დისკრეტულ განაწილებებზე. მიუხედავად იმისა, რომ ტრანსფორმერებმა წარმატება აჩვენეს AR მოდელირებაში, ისინი მაინც განიცდიან ინფერენციის სიჩქარის ხაზოვან შემცირებას გაზრდილი გამოსახულების გარჩევადობის, შეცდომების დაგროვებისა და მიმართულებითი მიკერძოების გამო. VQ-Diffusion აუმჯობესებს სამივე პრობლემურ წერტილს. AR გამოსახულების გენერაციული მოდელები ხასიათდება გამოსახულების ალბათობის ფაქტორიზაციით ისე, რომ თითოეული პიქსელი პირობითად დამოკიდებულია წინა პიქსელებზე რასტერული სკანირების თანმიმდევრობით (მარცხნიდან მარჯვნივ, ზემოდან ქვემოთ) ანუ p(x)=∏ip(xi∣xi−1,xi−2,...x2,x1) p(x) = \prod_i p(x_i | x_{i-1}, x_{i-2}, ... x_{2}, x_{1}) p(x)=∏i(xi∣xi−1,xi−2,...x2,x1). შედეგად, მოდელების გაწვრთნა შესაძლებელია ლოგ-ლიქლაიჰუდის პირდაპირი მაქსიმიზაციით. გარდა ამისა, AR მოდელები, რომლებიც მუშაობენ რეალურ პიქსელ (არალატენტურ) მნიშვნელობებზე, არანაწილებადი არხის მნიშვნელობებს პროგნოზირებენ დისკრეტული მულტინომიალური განაწილებიდან.
თეგები:
#ხელოვნური ინტელექტი
#ტრანსფორმერები
#ღრმა სწავლება
#დიფუზიური მოდელები
#diffusers
#vq-diffusion
#vq-vae
#გამოსახულების გენერაცია
#დისკრეტული დიფუზია
წყარო: huggingface.co
AI-ით გადამუშავებული


