
ხელოვნურმა ინტელექტმა CUDA ქერნელების წერა ისწავლა: ახალი უნარი GPU პროგრამირებას ამარტივებს
შემუშავდა ხელოვნური ინტელექტის აგენტის ახალი უნარი, რომელიც კოდირების აგენტებს ასწავლის საწარმოო დონის CUDA ქერნელების შექმნას. ამ უნარის გამოყენებით, Claude-მა და Codex-მა წარმატებით დაწერეს ფუნქციური ქერნელები diffusers-ის კონვეიერისა და transformers-ის მოდელისთვის, მოახდინეს მათი სწორი ინტეგრაცია PyTorch-თან და ჩაატარეს წარმადობის ტესტები, რაც ადასტურებს პროცესის სრულ ავტომატიზაციას.
Hugging Face Diffusers-ის 1 წელი: რევოლუცია AI გენერაციულ მოდელებში
Hugging Face-ის მიზანია კარგი მანქანური სწავლების დემოკრატიზაცია ღია და ეთიკური ხელოვნური ინტელექტის მომავლის შესაქმნელად. ამ მიზნით შეიქმნა 🤗 Diffusers ბიბლიოთეკა, რომელიც ყველას საშუალებას აძლევს, ექსპერიმენტი ჩაატაროს „ტექსტიდან გამოსახულებამდე“ მოდელებით. როგორც მოდულური ხელსაწყოების ყუთი, Diffusers 1 წლის გახდა და ამ პერიოდში, საზოგადოების დახმარებით, მას მრავალი მნიშვნელოვანი ფუნქცია დაემატა. მათ შორისაა გამოსახულების ხარისხის გაუმჯობესება DeepFloyd IF-ისა და Stability AI SDXL-ის მოდელებით
Hugging Face-ის Diffusers ბიბლიოთეკა 1 წლის ხდება: ინოვაციები და ღია ხელოვნური ინტელექტის მომავალი
Hugging Face-ის Diffusers ბიბლიოთეკა, რომელიც მიზნად ისახავს მანქანური სწავლების დემოკრატიზაციას და ეთიკური ხელოვნური ინტელექტის განვითარებას, 1 წლის გახდა. ამ ხნის განმავლობაში, საზოგადოების დახმარებით, ბიბლიოთეკას დაემატა უმნიშვნელოვანესი ფუნქციები, მათ შორის გაუმჯობესებული ტექსტი-გამოსახულებად გენერაცია (DeepFloyd IF, SDXL), ტექსტი-ვიდეოდ და ტექსტი-3D-დ გარდაქმნის შესაძლებლობები, გამოსახულების რედაქტირების ახალი მეთოდები, მნიშვნელოვანი ოპტიმიზაციები სიჩქარისთვის და უსაფრთხოების მექანიზმები არ

ღია კოდის ვიდეო გენერაციის მოდელების აღზევება: დგას თუ არა AI „Stable Diffusion-ის მომენტის“ ზღურბლზე?
ბოლო დროს შეინიშნება ღია კოდის ვიდეოს გენერაციის მოდელების, მათ შორის CogVideoX, Mochi-1, Hunyuan და LTX Video-ს სწრაფი ზრდა, რაც ბადებს კითხვას, დგას თუ არა ვიდეო საზოგადოება ხელოვნური ინტელექტის „Stable Diffusion-ის მომენტის“ ზღურბლზე. ეს სტატია მიმოიხილავს ვიდეოს გენერაციის მოდელების მიმდინარე მდგომარეობას, ხაზს უსვამს ისეთ შეზღუდვებს, როგორიცაა მოძრაობის ხარისხი, დროითი თანმიმდევრულობა და მეხსიერების მაღალი მოთხოვნები. Diffusers-ის გუნდი აქტიურად მუშაობს ამ გამოწვევების გადასაჭრელად სხვადასხ
ხელოვნური ინტელექტის ვიდეო გენერაციის მოდელები: მიმდინარე მდგომარეობა და ოპტიმიზაციის გზები
ღია კოდის პროექტებში ვიდეოს გენერაციის მოდელების სწრაფი განვითარება შეინიშნება, რამაც შეიძლება გამოიწვიოს „Stable Diffusion მომენტის“ განმეორება ვიდეო საზოგადოებაში. ეს სტატია მიმოიხილავს ვიდეოს გენერაციის მოდელების მიმდინარე მდგომარეობას, მათ შეზღუდვებს (კერძოდ, მოძრაობის ხარისხს, თანმიმდევრულობასა და კონსისტენტურობას დროის განმავლობაში) და არქიტექტურულ თავისებურებებს, როგორიცაა 3D ვიდეო ტოკენების დამუშავება. ყურადღება ექცევა Diffusers-ის გუნდის მიერ შემოთავაზებულ მეხსიერების ოპტიმიზაციის ტექნი
AI აუდიო გენერაცია: AudioLDM 2-ის სიჩქარის რეკორდი - 10 წამი 1 წამში
AudioLDM 2, ტექსტიდან აუდიოს გენერირების ხელოვნური ინტელექტის მძლავრი მოდელი, ადრე გამოირჩეოდა ნელი მუშაობით, 10-წამიანი აუდიოს შესაქმნელად 30 წამზე მეტი სჭირდებოდა. ახალი ბლოგ პოსტი დეტალურად აღწერს, თუ როგორ იქნა მიღწეული ინფერენციის დროის 10-ჯერ შემცირება, კოდისა და მოდელის ოპტიმიზაციების, მათ შორის ნახევრად ზუსტი გამოთვლებისა და Flash Attention-ის გამოყენებით. შედეგად, შესაძლებელია 10-წამიანი აუდიო ნიმუშის გენერირება მხოლოდ 1 წამში, ხარისხის მინიმალური გაუარესებით, Hugging Face Diffusers ბიბ
T2I-Adapters-ის ახალი ერა: Stable Diffusion XL-ის გაუმჯობესებული შესაძლებლობები
ControlNet-ის მაღალი გამოთვლითი ხარჯებისა და ზომის პრობლემების საპასუხოდ, T2I-Adapters გვთავაზობს ეფექტურ გადაწყვეტას გამოსახულების გენერაციისთვის. ის უფრო კომპაქტურია და ხმაურის შემცირების პროცესში მხოლოდ ერთხელ მუშაობს. Diffusers-ის გუნდმა და T2I-Adapter-ის ავტორებმა Stable Diffusion XL-ისთვის (SDXL) T2I-Adapters-ის მხარდაჭერა დანერგეს, რამაც შესაძლებელი გახადა SDXL-ის მაღალი ხარისხის გენერაციის შენარჩუნება გაუმჯობესებული სიჩქარით, მეხსიერებითა და კონტროლის შესაძლებლობებით. ეს ბლოგპოსტი წარმოა

VAE დეკოდირების დელეგირება დისტანციურ ენდპოინტზე: მეხსიერების ეფექტურობა მაღალი რეზოლუციის სურათებისა და ვიდეოების სინთეზისთვის
მაღალი რეზოლუციის სურათებისა და ვიდეოების გენერირებისთვის, VAE დეკოდერები ხშირად დიდ მეხსიერებას მოიხმარენ, რაც ართულებს მათ გაშვებას სამომხმარებლო GPU-ებზე. არსებული გადაწყვეტილებები, როგორიცაა offloading ან tiling, იწვევს შეფერხებებს ან ხარისხის გაუარესებას. ამ პრობლემის გადასაჭრელად, Diffusers-მა შეიმუშავა ექსპერიმენტული ფუნქცია VAE დეკოდირების დისტანციურ ენდპოინტზე დელეგირებისთვის. ეს მიდგომა ზოგავს მეხსიერებას, აუმჯობესებს პარალელურ დამუშავებას, ღია კოდის პრინციპებზეა დაფუძნებული და Hugging
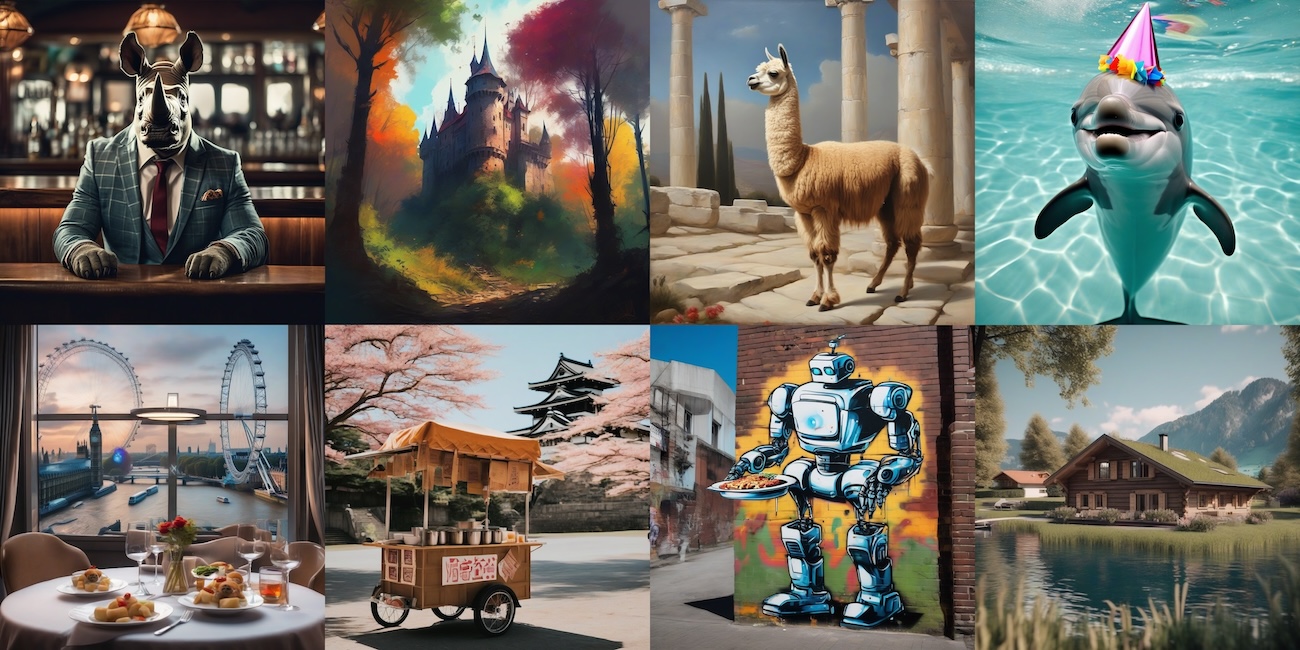
მაღალეფექტური და ხარჯთეფექტური SDXL სერვისინგი JAX-ით Google Cloud TPU v5e-ზე
Google Cloud-ის ახალი TPU v5e, JAX-თან და Diffusers-თან ერთად, შესაძლებელს ხდის დიდი ხელოვნური ინტელექტის მოდელების, მაგალითად SDXL-ის, მაღალპროდუქტიულ და ხარჯთეფექტურ ტრეინინგსა და ინფერენსს. სტატია მიმოიხილავს, თუ როგორ ხდის JIT კომპილაცია და XLA-ზე დაფუძნებული პარალელიზაცია მასშტაბურ გენერაციულ AI-ს ხელმისაწვდომსა და ეფექტურს, წარმოადგენს დემოს და განმარტავს ამ ტექნოლოგიების გამოყენების დეტალებს.

კვანტიზაციის ბეკენდები Hugging Face Diffusers-ში: მეხსიერების ოპტიმიზაცია და ხელმისაწვდომობა
ეს სტატია იკვლევს კვანტიზაციის სხვადასხვა ბეკენდს (მაგ., bitsandbytes, GGUF, torchao, Quanto, FP8) Hugging Face Diffusers-ში, რომლებიც დიდ ხელოვნური ინტელექტის მოდელებს უფრო ხელმისაწვდომს ხდის მეხსიერების მოხმარების მნიშვნელოვანი შემცირებით. ის წარმოადგენს აღქმის ტესტს, სადაც მომხმარებლებს შეუძლიათ შეადარონ ორიგინალური და კვანტიზებული მოდელების გამომუშავება განსხვავებების იდენტიფიცირებისთვის, რომლებიც ხშირად უმნიშვნელოა, განსაკუთრებით 8-ბიტიანი კვანტიზაციის დროს. სტატია ასევე დეტალურად აღწერს მე
Hugging Face Diffusers-ის კვანტიზაცია: მეხსიერების ოპტიმიზაცია და მოდელების ხელმისაწვდომობა
ეს სტატია იკვლევს Hugging Face Diffusers-ში ინტეგრირებულ სხვადასხვა კვანტიზაციის ბეკენდს, მათ შორის bitsandbytes, GGUF, torchao, Quanto და FP8 Layerwise Casting. იგი განმარტავს, თუ როგორ უწყობს ხელს ეს ტექნიკები დიდი და მძლავრი მოდელების (მაგ. Flux) მეხსიერების ოპტიმიზაციას და მათ ხელმისაწვდომობას, ხშირად ხარისხის მინიმალური ან შეუმჩნეველი დანაკარგით. ასევე განიხილება დამატებითი ოპტიმიზაციის მეთოდები, როგორიცაა CPU offloading და group offloading.
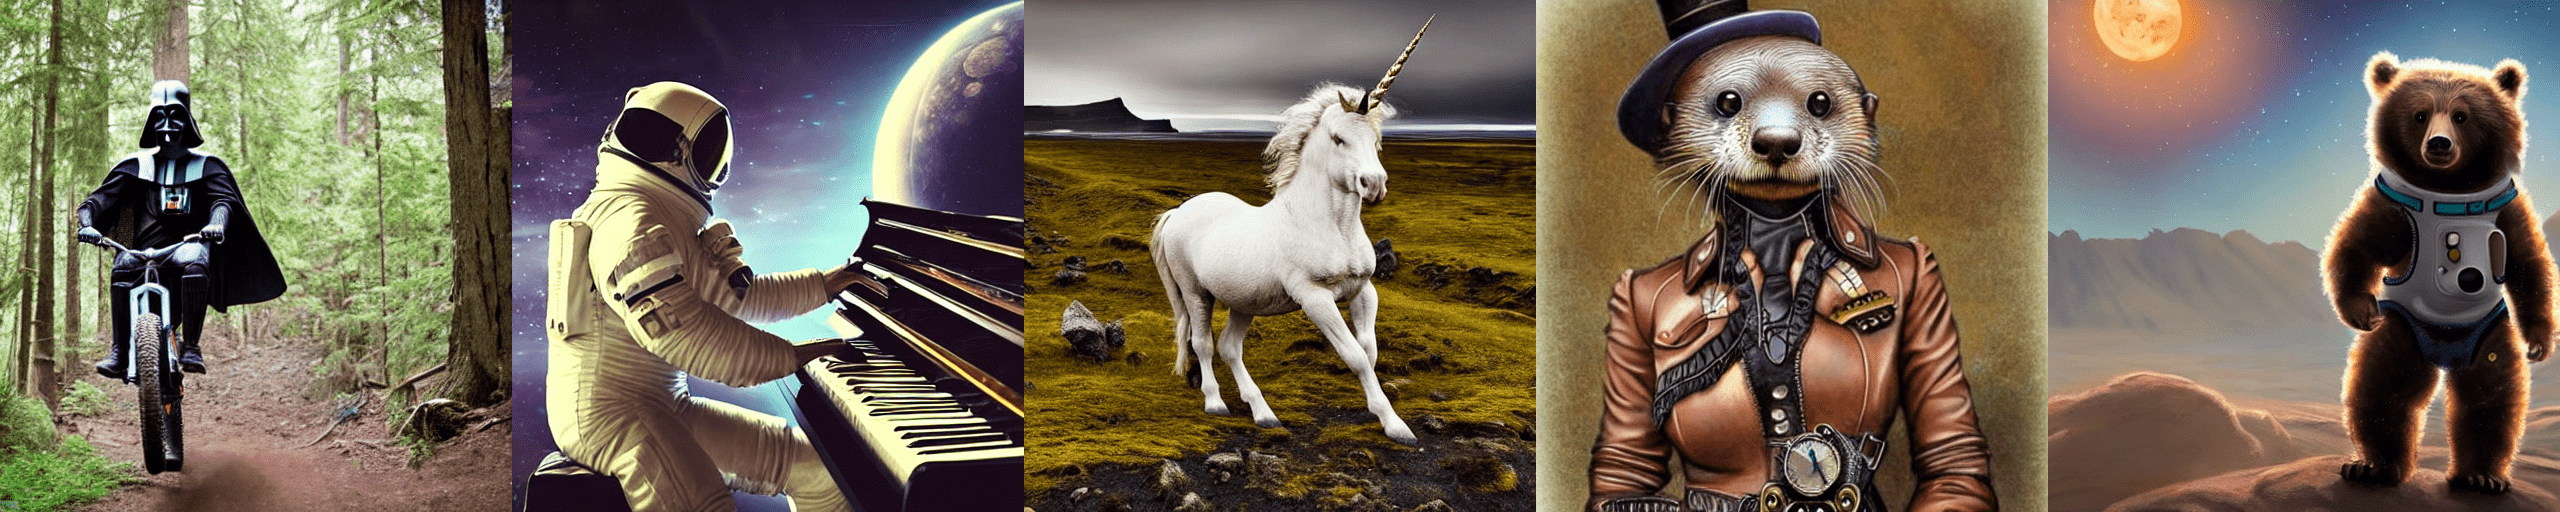
Stable Diffusion: ტექსტიდან გამოსახულების გენერირების მოდელის გამოყენების გზამკვლევი
Stable Diffusion არის მოწინავე ტექსტიდან გამოსახულების გენერირების ლატენტური დიფუზიური მოდელი, შექმნილი CompVis-ის, Stability AI-სა და LAION-ის მკვლევრებისა და ინჟინრების მიერ. ის გაწვრთნილია LAION-5B მონაცემთა ბაზის ქვესიმრავლიდან მიღებულ 512x512 ზომის სურათებზე. ეს სტატია დეტალურად განმარტავს, თუ როგორ გამოვიყენოთ Stable Diffusion 🧨 Diffusers ბიბლიოთეკასთან ერთად, როგორ მუშაობს მოდელი და როგორ შეიძლება მისი გენერირების კონვეიერის მორგება. ასევე განხილულია ლიცენზირების, ინფერენციის ნაბიჯების, g

Stability AI-მ Stable Diffusion 3 Medium წარადგინა: ახალი 2-მილიარდპარამეტრიანი მოდელი გაუმჯობესებული არქიტექტურითა და წარმადობით
Stability AI-მ გამოუშვა Stable Diffusion 3 Medium (SD3), 2 მილიარდი პარამეტრიანი ლატენტური დიფუზიური მოდელი, რომელიც განკუთვნილია ტექსტიდან გამოსახულების სინთეზისთვის. ის მოიცავს ინოვაციურ მულტიმოდალურ დიფუზიურ ტრანსფორმატორს (MMDiT) და სამ ტექსტის ენკოდერს, მათ შორის T5-v1.1-XXL-ს. SD3 იყენებს პირობითი ნაკადის შესატყვისობის ობიექტივს სწავლებისთვის და წარმოგიდგენთ ახალ FlowMatchEulerDiscreteScheduler-ს ინფერენსისთვის. Diffusers-ის ინტეგრაცია მოიცავს მეხსიერების ოპტიმიზაციებს, რაც მოდელს უფრო ფარ
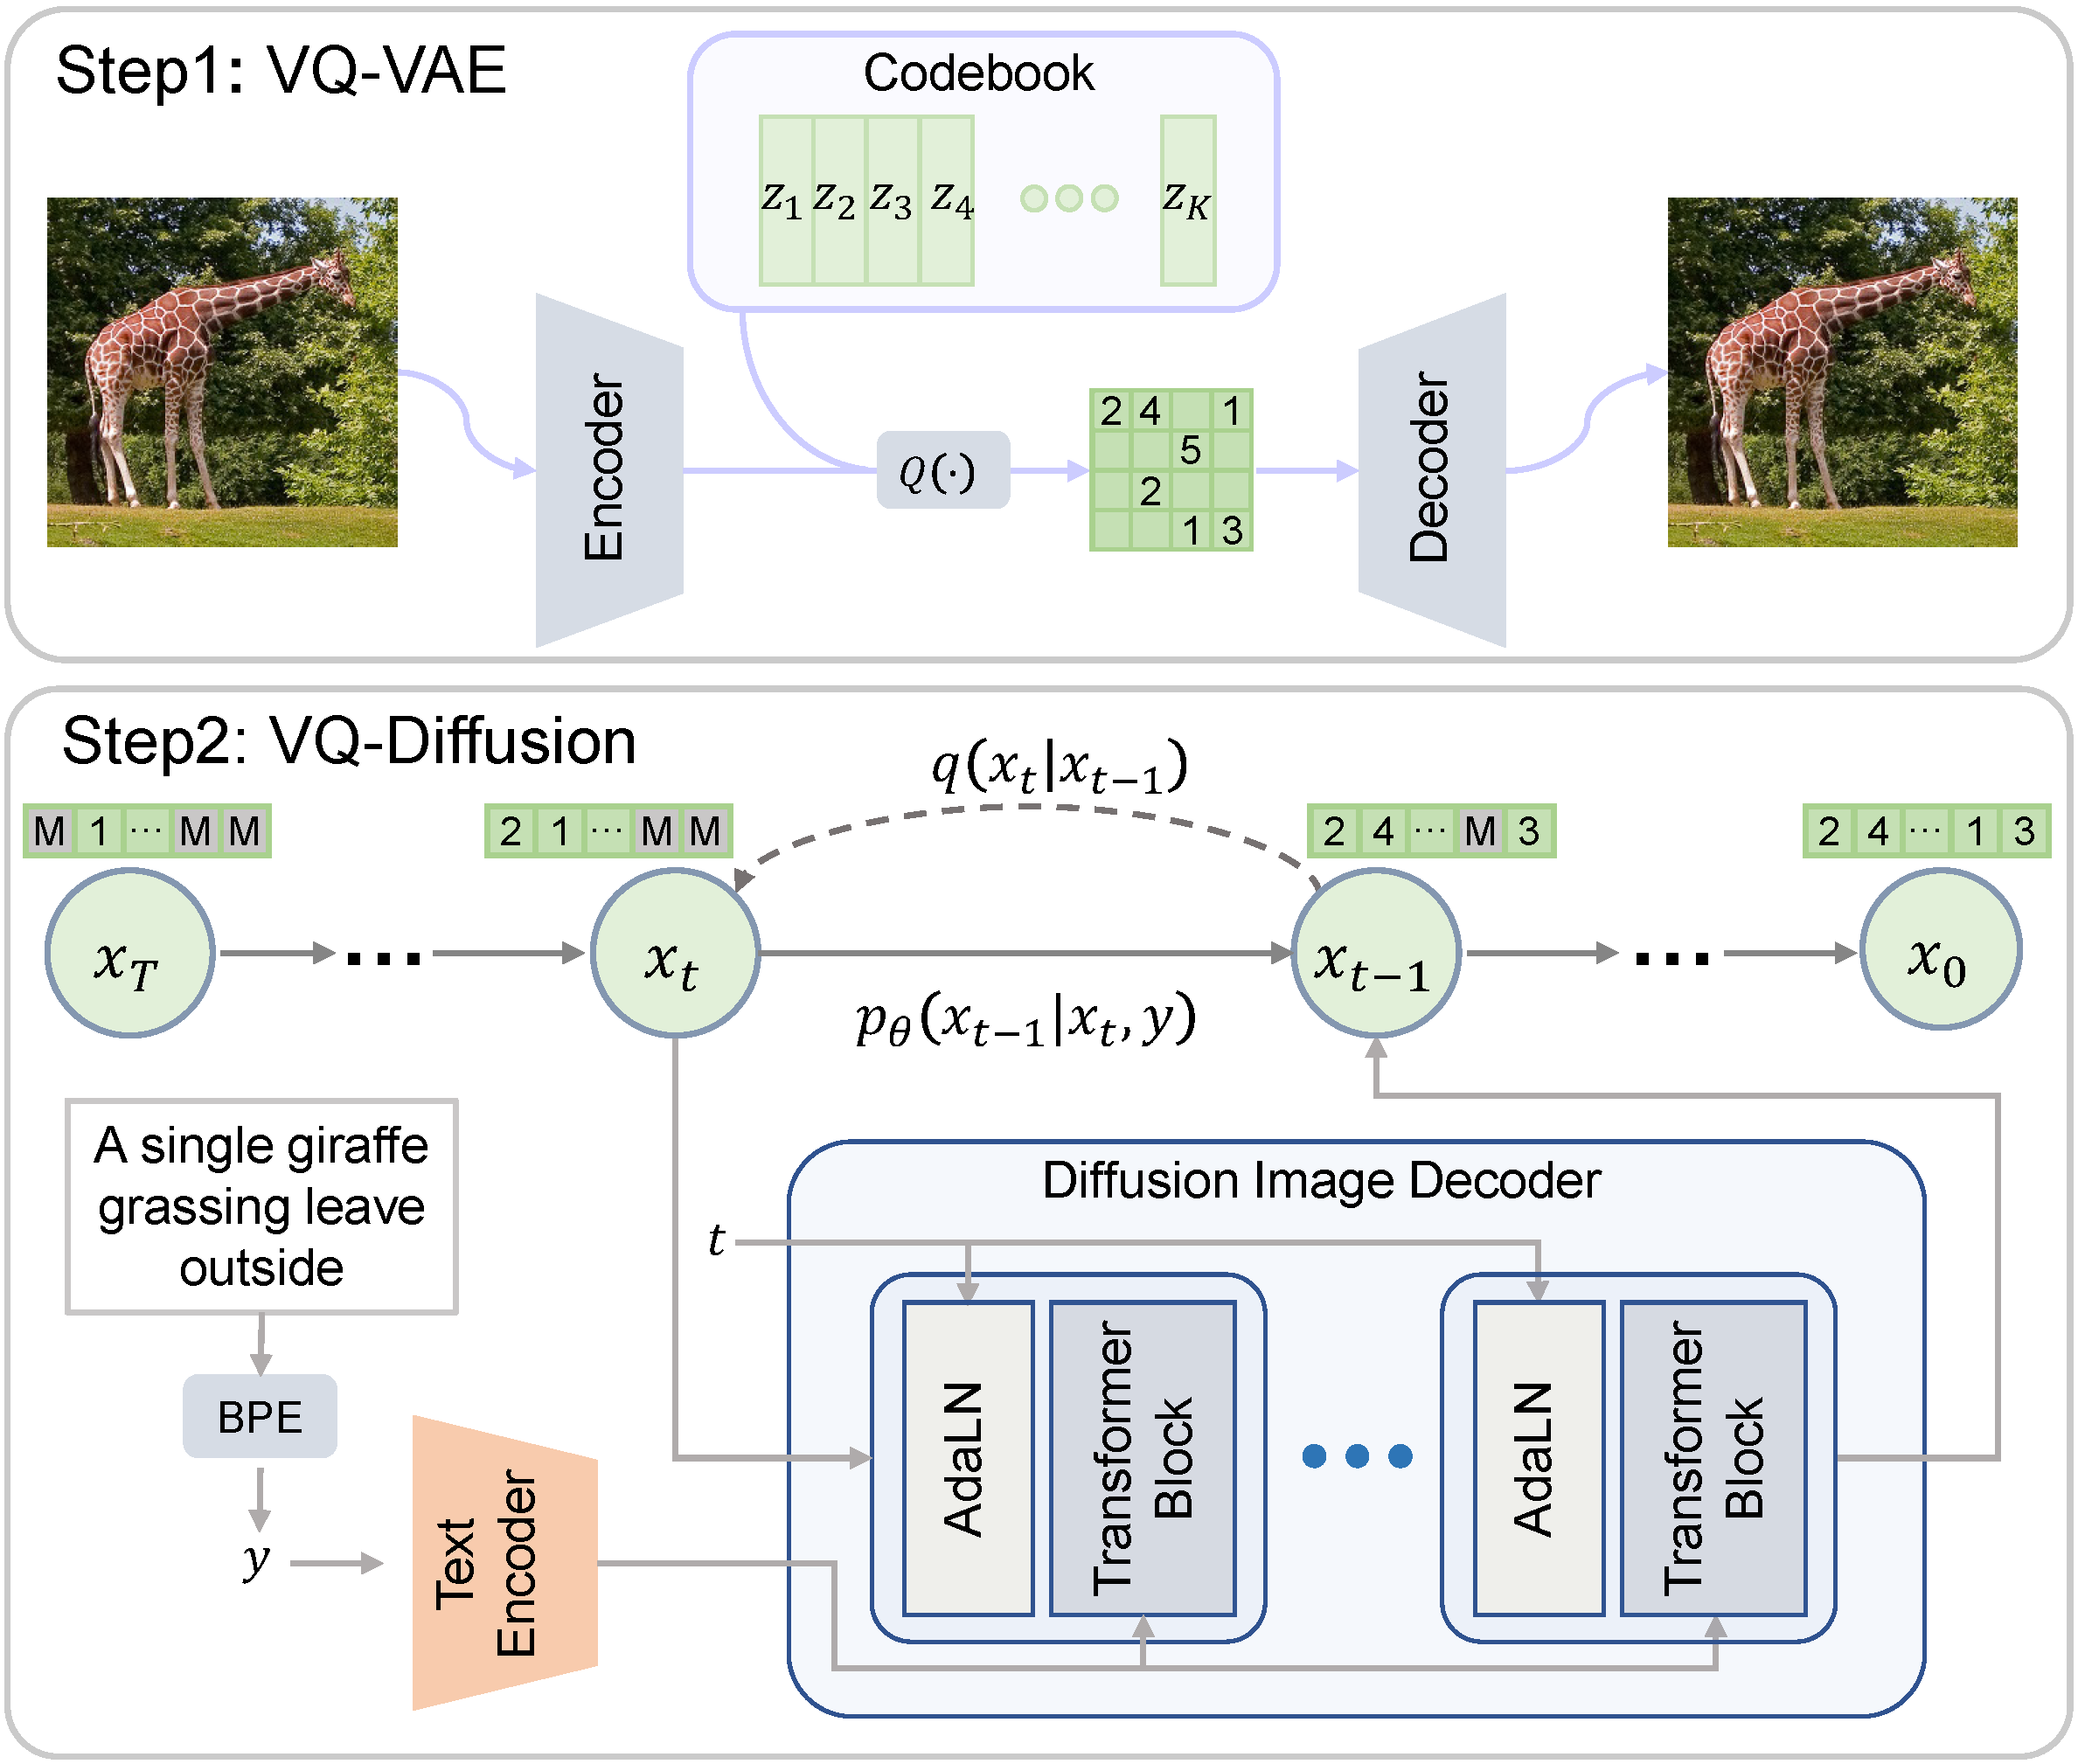
VQ-დიფუზია: ახალი სიმაღლეები გამოსახულების გენერაციაში „დიფუზერების“ მეშვეობით
„დიფუზერები“ (Diffusers) VQ-დიფუზიის (VQ-Diffusion) მოდელის გამოყენებას განსაკუთრებულად ამარტივებს, რაც დეველოპერებს საშუალებას აძლევს, გამოსახულების გენერაციის მოწინავე ტექნოლოგიები სულ რამდენიმე ხაზი კოდით გამოიყენონ. ეს მოდელი გამოსახულებებს დისკრეტულ „ტოკენებად“ კოდირებს VQ-VAE ენკოდერის მეშვეობით, ამცირებს მონაცემთა განზომილებას და იყენებს ენკოდერ-დეკოდერ ტრანსფორმერს გაუხმაურებელი ლატენტების პროგნოზირებისთვის. VQ-დიფუზია უწყვეტ დიფუზიურ მოდელებთან შედარებით დისკრეტულ მიდგომას გვთავაზობს და
VQ-Diffusion: ახალი სიტყვა სურათების გენერაციაში Diffusers-ის დახმარებით
წარმოგიდგენთ VQ-Diffusion-ს, დისკრეტულ დიფუზიურ მოდელს, რომელიც სურათების გენერაციას სულ რამდენიმე ხაზი კოდით შესაძლებელს ხდის Diffusers ბიბლიოთეკის გამოყენებით. მოდელი ეფუძნება VQ-VAE ენკოდერს გამოსახულებების ლატენტურ ტოკენებად გარდასაქმნელად და იყენებს ენკოდერ-დეკოდერ ტრანსფორმერს. VQ-Diffusion მნიშვნელოვნად აუმჯობესებს AR მოდელების ნაკლოვანებებს, როგორიცაა ინფერენციის სიჩქარე და შეცდომების დაგროვება, რაც მას ეფექტურ და მძლავრ ინსტრუმენტად აქცევს ხელოვნური ინტელექტის საფუძველზე გამოსახულების შ