
iPhone-ის Lockdown Mode: უსაფრთხოების უკიდურესი ფუნქცია, რომელიც FBI-მაც კი ვერ გატეხა
ZDNET განმარტავს iPhone-ის ნაკლებად ცნობილ, მაგრამ უკიდურესად უსაფრთხო ფუნქციას, Lockdown Mode-ს, რომელიც ბოლო დროს აქტუალური გახდა მას შემდეგ, რაც FBI-მ ჟურნალისტის ტელეფონზე წვდომა ვერ შეძლო მისი გააქტიურების გამო. სტატია დეტალურად აღწერს, თუ რა არის ეს ფუნქცია, როგორ მუშაობს, რა შეზღუდვებს აწესებს და ვისთვის არის განკუთვნილი, ასევე გვთავაზობს სახელმძღვანელოს მის გასააქტიურებლად.

LG Xboom Buds Plus: ყურსასმენები თვითწმენდის ქეისით და ინტეგრირებული Bluetooth გადამცემით
LG-მ წარმოადგინა Xboom Buds Plus ყურსასმენები, რომლებიც აღჭურვილია თვითწმენდის დამტენი ქეისით, ჩაშენებული Bluetooth გადამცემით და UVnano ტექნოლოგიით ბაქტერიების გასანადგურებლად. პროდუქტი უკვე ხელმისაწვდომია 180 დოლარად და მოიცავს ისეთ მოწინავე ფუნქციებს, როგორიცაა აქტიური ხმაურის გაუქმება და Bluetooth LE Audio-ს მხარდაჭერა.

ZDNET-ის რეკომენდაციები: ჭკვიანი ტელევიზორების ოპტიმიზაციის ხრიკები და პარამეტრები
ZDNET განმარტავს თავის სარედაქციო მეთოდოლოგიას, რომელიც ეფუძნება საფუძვლიან კვლევასა და მომხმარებლის გამოცდილებას. სტატია აანალიზებს, თუ რატომ არის თანამედროვე ტელევიზორები სრულფასოვანი კომპიუტერები და გვთავაზობს საუკეთესო რჩევებს მათ ოპტიმიზაციისთვის. მოცემულია ინსტრუქციები მოძრაობის გამარტივების ეფექტის გამორთვის, გამოსახულების სწორი რეჟიმების (როგორიცაა „Filmmaker Mode“) გამოყენების, Ethernet კავშირის უპირატესობების და პროგრამული უზრუნველყოფის რეგულარული განახლების მნიშვნელობის შესახებ, რაც ხ
'ZDNET გირჩევთ': რას ნიშნავს ეს ზუსტად?
ZDNET-ის რეკომენდაციები ეფუძნება მრავალსაათიან ტესტირებას, კვლევასა და შედარებით შოპინგს, რათა მკითხველს მიაწოდოს ზუსტი და სანდო ინფორმაცია ტექნიკურ აღჭურვილობასა და სერვისებზე. სტატია ასევე განიხილავს ჭკვიანი ტელევიზორების ფარულ პარამეტრებს და გთავაზობთ საუკეთესო რჩევებს მათი ოპტიმიზაციისთვის. ეს მოიცავს მოძრაობის გამარტივების (motion smoothing) ფუნქციის გამორთვას, გამოსახულების სწორი რეჟიმების (როგორიცაა „რეჟისორი“ ან „კინო“) არჩევას, Wi-Fi-ის ნაცვლად Ethernet კავშირის გამოყენებას უფრო სტაბილუ

Hugging Face-ი ფაილების გადაცემის არქიტექტურას ანახლებს: ახალი მიდგომა დიდი მოცულობის მონაცემებისთვის
Hugging Face აცხადებს ინფრასტრუქტურის მნიშვნელოვან განახლებას, რათა ოპტიმიზაცია გაუკეთოს მოდელებისა და მონაცემთა ნაკრებების დიდი ზომის ფაილების ატვირთვასა და ჩამოტვირთვას. არსებული CDN-ის (AWS CloudFront) 50GB ლიმიტის გამოწვევის ფონზე, კომპანია ნერგავს კონტენტზე მიბმულ საცავს (CAS), როგორც ახალ არქიტექტურულ ელემენტს. ეს ახალი სისტემა იყენებს "სულელი წაკითხვების" და "ჭკვიანი ჩაწერების" პერსონალიზებულ პროტოკოლს, რომელიც აანალიზებს ფაილებს ბაიტის დონეზე, რათა გააუმჯობესოს გადაცემის სიჩქარე, უზრუნვე
Hugging Face Hub: მანქანური სწავლების შესაძლებლობები GLAM სექტორისთვის
Hugging Face მიზნად ისახავს უმაღლესი ხარისხის მანქანური სწავლების საყოველთაო ხელმისაწვდომობას. ამის მისაღწევად კომპანია აწვდის ღია კოდის ბიბლიოთეკებს, უფასო კურსებს და Hugging Face Hub-ს – ცენტრალურ საცავს 190,000-ზე მეტი მოდელით, 33,000 მონაცემთა ნაკრებით და 100,000-ზე მეტი აპლიკაციით. ეს სტატია განკუთვნილია GLAM სექტორში (გალერეები, ბიბლიოთეკები, არქივები, მუზეუმები) მომუშავე პირებისთვის, რათა გაიგონ, როგორ გამოიყენონ და როგორ შეიტანონ წვლილი Hub-ში. მაგალითად, NER მოდელის გამოყენება ციფრული დ

როგორ აუმჯობესებს Capital Fund Management (CFM) ფინანსური მონაცემების ანალიზს Hugging Face-ის დიდი ენობრივი მოდელების (LLM) დახმარებით
Capital Fund Management (CFM), პარიზში დაფუძნებული ალტერნატიული ინვესტიციების მართვის ფირმა, თანამშრომლობს Hugging Face-ის ექსპერტთა მხარდაჭერის გუნდთან, რათა გამოიყენოს ღია წყაროს დიდი ენობრივი მოდელები (LLMs) ფინანსური აპლიკაციებისთვის. თანამშრომლობის მთავარი მიზანია გააუმჯობესოს ფინანსური სუბიექტების ამოცნობა (მაგ., კომპანიების სახელები) საინფორმაციო სტატიებიდან, რაც კრიტიკულია ავტომატიზირებული სავაჭრო სტრატეგიებისთვის. CFM-მა გამოიკვლია LLM-ის დახმარებით დატეგვის, მცირე მოდელების 'fine-tunin

აგენტური AI-ის პოტენციალის განბლოკვა CPU-ზე: Intel Xeon და AMX-ის როლი
აგენტური ხელოვნური ინტელექტი (AI) AI-ის განვითარების შემდეგ ეტაპად მიიჩნევა, რომელიც LLM-ების მსჯელობის შესაძლებლობებს კონტექსტის ღრმა გაგებასთან აკავშირებს. თუმცა, არსებობს გამოწვევა 'მასპინძელი-აქსელერატორი' ტრაფიკის ზედმეტი დატვირთვის მხრივ, რადგან სისტემებში სულ უფრო მეტი CPU-ზე მომუშავე ხელსაწყო ინტეგრირდება. ამ პრობლემის გადასაჭრელად, მუშავდება მცირე ენობრივი მოდელები (SLM) და CPU-ები, როგორიცაა Intel Xeon-ის მე-4 და მე-5 თაობა, რომლებიც ინტეგრირებულ AMX ტექნოლოგიას გვთავაზობენ AI მუშაობის
როგორ ვებრძოლოთ მიკერძოებას ტექსტიდან გამოსახულების გენერაციის სისტემებში?
ტექსტიდან გამოსახულების გენერაციის (TTI) მოდელები სულ უფრო პოპულარული ხდება, თუმცა მათში ჩაშენებული მიკერძოებები მნიშვნელოვან ეთიკურ გამოწვევას წარმოადგენს. ეს ბლოგპოსტი იკვლევს მიკერძოების წყაროებს TTI სისტემებში, მათ შორის საწვრთნელ მონაცემებში, ფილტრაციის პროცესებში, ინფერენციასა და მოდელის ლატენტურ სივრცეში არსებულ პრობლემებს, ასევე განიხილავს მათ გადასაჭრელ ინსტრუმენტებსა და პოტენციურ გადაწყვეტებს.
ტექსტიდან გამოსახულების გენერირების ხელოვნური ინტელექტის მოდელების მიკერძოება: გამოწვევები და გადაწყვეტის გზები
ეს სტატია ღრმად იკვლევს ტექსტიდან გამოსახულების გენერირების (TTI) ხელოვნური ინტელექტის მოდელებში არსებული მიკერძოების კომპლექსურ პრობლემას. განხილულია მიკერძოების მრავალფეროვანი წყაროები, მათ შორის საწვრთნელ მონაცემებში, წინასწარ გაფილტვრაში, მოდელების ლატენტურ სივრცესა და დასკვნის ეტაპზე. სტატია ხაზს უსვამს, თუ როგორ იწვევს სოციალურ ღირებულებებსა და კულტურულ სტერეოტიპებზე დაფუძნებული მიკერძოება არარეპრეზენტაციულ და პოტენციურად მავნე გამოსახულებებს, რაც მუდმივ ეთიკურ გამოწვევას წარმოადგენს ხელოვ

ModernBERT: ენკოდერ-მხოლოდ მოდელების ახალი ეპოქა – BERT-ის გაუმჯობესებული და სწრაფი ჩანაცვლება
ModernBERT წარმოადგენს უახლეს, სახელმწიფოებრივ ენკოდერ-მხოლოდ მოდელების ოჯახს, რომელიც მნიშვნელოვნად აუმჯობესებს წინა თაობის ენკოდერებს სიჩქარის, სიზუსტის, კონტექსტის სიგრძის (8192 ტოკენი) და ქვემდებარე ამოცანების შესრულების მხრივ. ის დანერგილია, როგორც BERT-ის პირდაპირი ჩანაცვლება, ხელმისაწვდომია საბაზისო (149M პარამეტრი) და დიდ (395M პარამეტრი) ვერსიებში და აერთიანებს LLM-ების უახლეს მიღწევებს. ModernBERT მიზნად ისახავს გახდეს ახალი სტანდარტი პრაქტიკულ გამოყენებებში, როგორიცაა RAG სისტემები, კ

ლოგიტების დამუშავება: გაუმჯობესებული კონტროლი AI ტექსტის გენერაციაზე NVIDIA-ს LogitsProcessorZoo-ს მეშვეობით
სტატია განიხილავს ლოგიტების დამუშავებას, მეთოდს, რომელიც საშუალებას გვაძლევს დეტალური კონტროლი მოვიპოვოთ ხელოვნური ინტელექტის მიერ ტექსტის გენერირების პროცესზე ალბათური განაწილების პირდაპირი მოდიფიცირებით. ხაზგასმულია Hugging Face-ის LogitsProcessor API და წარმოდგენილია NVIDIA-ს LogitsProcessorZoo — მოდულური ლოგიტების პროცესორების კოლექცია, რომელიც განკუთვნილია სპეციფიკური ამოცანებისთვის, როგორიცაა თანმიმდევრობის სიგრძის კონტროლი ან საკვანძო ფრაზების დაწესება. სტატია განმარტავს, თუ როგორ აუმჯობე
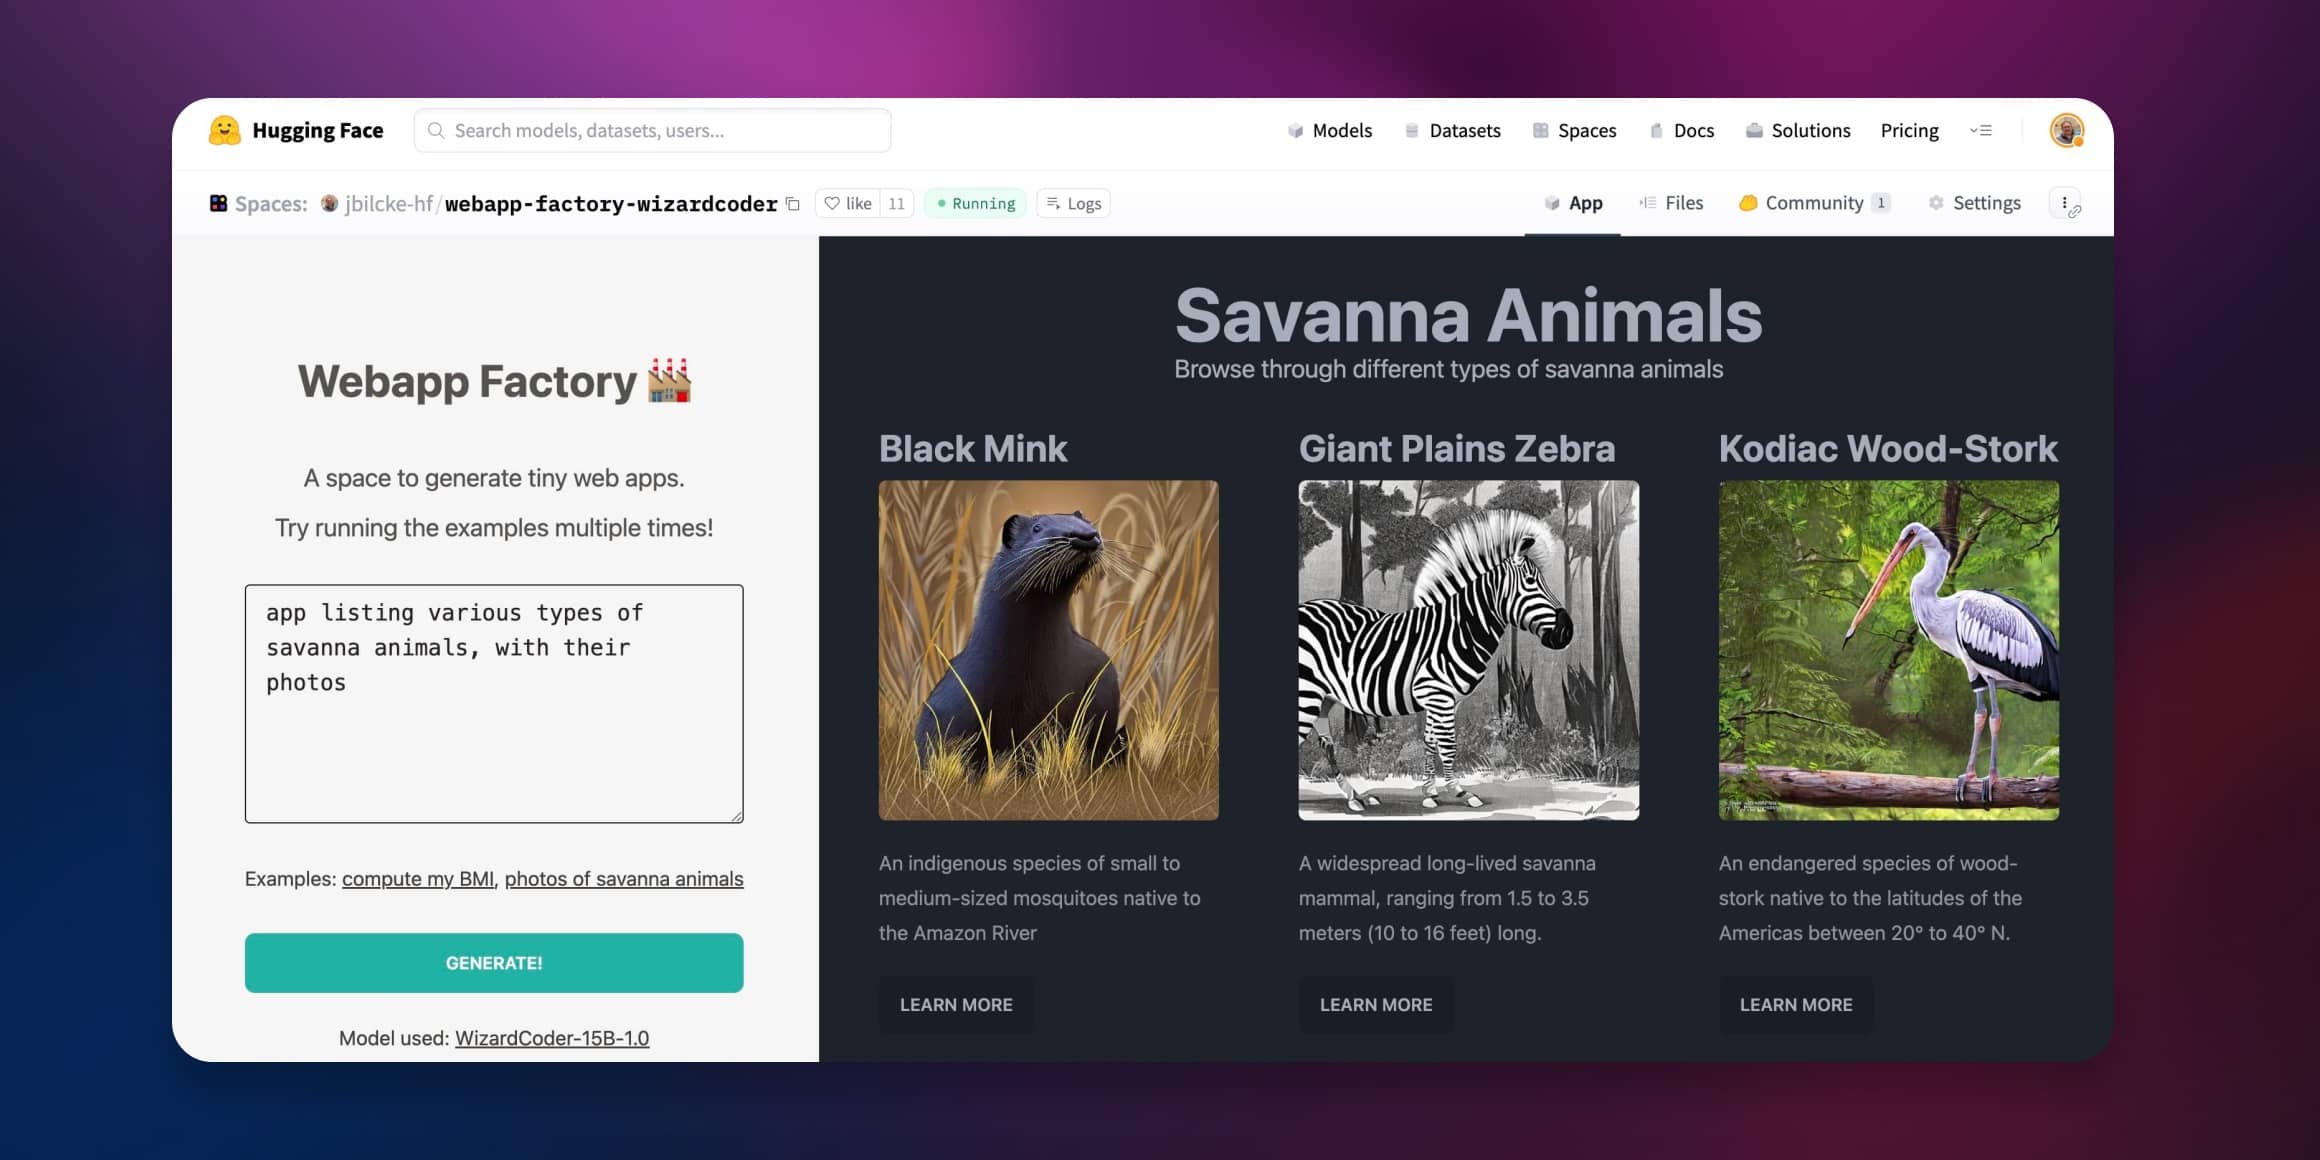
AI ვებ-კონტენტის გენერაცია: Node.js და Hugging Face-ის პირდაპირი მიდგომა
გაეცანით AI ვებ-კონტენტის გენერაციის ინოვაციურ მიდგომას Node.js-ის გამოყენებით, რომელიც უზრუნველყოფს კონტენტის ერთბაშად ნაკადად გადაცემასა და რენდერინგს. ეს სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ დიდი ენობრივი მოდელები (LLM) JavaScript/Node პლატფორმაზე Hugging Face Inference API-ებთან ერთად, აპარატურული აჩქარების, Tailwind CSS-ის, Stable Diffusion-ისა და Alpine.js-ის ინტეგრაციის ჩათვლით.

როგორ გავიგოთ და ოპტიმიზაცია გავუკეთოთ GPU მეხსიერების გამოყენებას PyTorch-ში
ეს სტატია დეტალურად განიხილავს, თუ როგორ უნდა მოვახდინოთ GPU მეხსიერების გამოყენების ვიზუალიზაცია, გაგება და ოპტიმიზაცია PyTorch-ში ტრენინგის დროს. ის ეტაპობრივად ხსნის მეხსიერების განაწილებას მოდელის შექმნის, შეყვანის ტენზორების, Forward/Backward გავლისა და ოპტიმიზატორის ნაბიჯებისთვის, დეტალური მაგალითებისა და პროფაილინგის ხელსაწყოების გამოყენებით. გაანალიზებულია როგორც გამარტივებული, ასევე რეალური LLM-ის ტრენინგის მეხსიერების პროფილი.
როგორ გავიგოთ და ოპტიმიზაცია გავუკეთოთ GPU მეხსიერებას PyTorch-ში
ეს გაკვეთილი ეტაპობრივად განმარტავს, თუ როგორ მოვახდინოთ GPU მეხსიერების გამოყენების ვიზუალიზაცია და გაგება PyTorch-ში ტრენინგის დროს. ის მოიცავს მეხსიერების მოთხოვნების შეფასებას, გამოყენების ოპტიმიზაციას PyTorch-ის პროფილის ხელსაწყოების მეშვეობით და დეტალურ ანალიზს იმის შესახებ, თუ როგორ იქცევა მეხსიერება მოდელის შექმნის, წინსვლის, უკუგადაცემის და ოპტიმიზატორის ნაბიჯების განმავლობაში, მათ შორის დიდი ენობრივი მოდელების (LLM) რეალურ სცენარებში.
LLM-ების განთავსება Hugging Face Inference Endpoints-ზე: სრული გზამკვლევი
ამ ბლოგპოსტში განხილულია, თუ როგორ უნდა განათავსოთ ღია კოდის დიდი ენობრივი მოდელები (LLM) Hugging Face Inference Endpoints-ის გამოყენებით, მართული SaaS გადაწყვეტის, რომელიც ამარტივებს მოდელების განთავსებას. სტატია მოიცავს პასუხების სტრიმინგის მეთოდებსა და ენდპოინტების წარმადობის ტესტირებას. Hugging Face Inference Endpoints უზრუნველყოფს AI აპლიკაციების სწრაფ და უსაფრთხო შექმნას ინფრასტრუქტურის მართვის გარეშე, ავტომატური მასშტაბირების, ნულამდე შემცირებისა და გაუმჯობესებული უსაფრთხოების ფუნქციებით.

AI აგენტები: LLM-ების შესაძლებლობების გაფართოება რეალურ სამყაროში
ეფექტური AI სისტემები საჭიროებს დიდ ენობრივ მოდელებს (LLM) რეალურ სამყაროზე წვდომას, რაც მათ საშუალებას აძლევს გამოიყენონ საძიებო ინსტრუმენტები ან იმოქმედონ პროგრამებზე. ეს მოქმედების უნარი, ანუ „აგენტურობა“, LLM-ებისთვის გარე სამყაროსთან დამაკავშირებელ ხიდად გვევლინება. სტატია განმარტავს, თუ როგორ აკონტროლებს AI აგენტები LLM-ის შედეგების სამუშაო პროცესს და აღნიშნავს, რომ აგენტურობა არის უწყვეტი სპექტრი. მიუხედავად იმისა, რომ აგენტები სასარგებლოა აპლიკაციის სამუშაო პროცესის მოქნილობისთვის, ისინი
როგორ შევქმნათ AI-ზე დაფუძნებული ხატვის თამაში ბრაუზერში: Quick, Draw!-ის შთაგონებით
გაეცანით დეტალურ სახელმძღვანელოს, თუ როგორ უნდა შექმნათ ხელოვნური ინტელექტზე დაფუძნებული ხატვის თამაში, რომელიც Google-ის „Quick, Draw!“-ით არის შთაგონებული. პროექტი გვიჩვენებს, როგორ მივაღწიოთ რეალურ დროში, წამში 60-ზე მეტ პროგნოზს, მოდელის ბრაუზერში გაშვებით, Transformers.js-ის, MobileViT მოდელისა და Web Workers-ის გამოყენებით. სტატია მოიცავს მოდელის მომზადებას, ONNX-ში კონვერტაციას და React აპლიკაციის აგებას.
Stable Diffusion-ის დახვეწა Intel Sapphire Rapids CPU-ებზე: ახალი შესაძლებლობები ღრმა სწავლისთვის
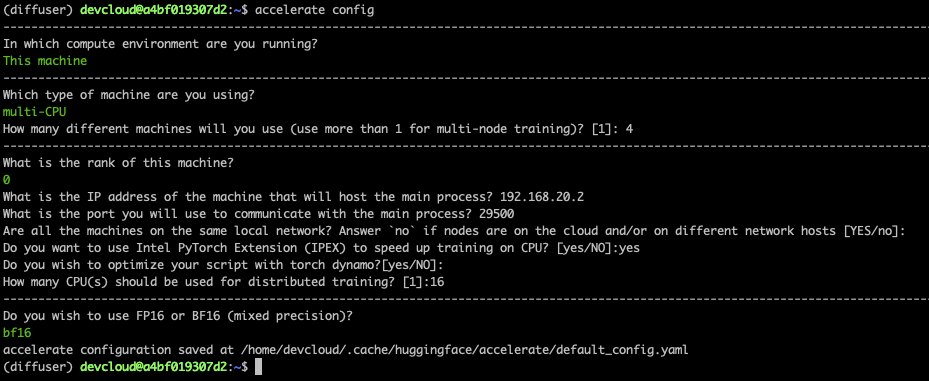
Intel-მა წარმოადგინა Xeon CPU-ების მეოთხე თაობა, Sapphire Rapids, რომელიც მოიცავს Intel Advanced Matrix Extensions (AMX) აჩქარებელს ღრმა სწავლისთვის. ეს სტატია დეტალურად აღწერს, თუ როგორ შეიძლება Stable Diffusion მოდელების დახვეწა (fine-tuning) Intel Sapphire Rapids CPU კლასტერზე, ტექსტური ინვერსიის გამოყენებით. პროცესი მოიცავს სისტემის დაყენებას Intel Developer Cloud-ზე, პროგრამული დამოკიდებულებების კონფიგურაციას (მათ შორის Intel-ის ბიბლიოთეკები oneCCL და IPEX) და განაწილებულ სწავლებას მინიმალუ
AI WebTV: ხელოვნური ინტელექტით შექმნილი ვიდეო კონტენტის ინოვაციური პლატფორმა
AI WebTV წარმოადგენს ინოვაციურ პლატფორმას, რომელიც დემონსტრირებს ღია კოდის ტექსტი-ვიდეოდ გადამყვანი მოდელებით, როგორიცაა Zeroscope და MusicGen, გენერირებულ ვიდეოებს. ის შექმნილია მოკლე, ტექნოლოგიური დემო კლიპების სახით, სადაც დიდი ენობრივი მოდელები (LLM), მაგალითად ChatGPT, გამოიყენება ვიდეო კადრებისთვის მრავალფეროვანი მოთხოვნების შესაქმნელად. სისტემა დანერგილია NodeJS-სა და TypeScript-ში, იყენებს Hugging Face-ის სერვისებს და მოიცავს კადრების გაფართოებას FILM ალგორითმით, ასევე მუსიკის დამატებას
EsperBERTo: ხელოვნური ინტელექტის მოდელის შექმნა და ტრენინგი ესპერანტოზე
ამ პოსტში წარმოდგენილია, თუ როგორ ხდება ხელოვნური ინტელექტის მცირე ენობრივი მოდელის, EsperBERTo-ს, შექმნა და ტრენინგი ესპერანტოზე. მოდელი, რომელიც ზომით DistilBERT-ის მსგავსია, იყენებს სპეციალურად ოპტიმიზებულ ტოკენიზატორს და შემდგომში ადაპტირდება სიტყვის ნაწილების ამოცნობის ამოცანისთვის. ესპერანტო, როგორც ხელოვნური და ადვილად სასწავლი ენა, შერჩეულია დემონსტრაციისთვის, რათა ნათლად გამოჩნდეს მოდელის შესაძლებლობები.
Hugging Face Diffusers-ის 1 წელი: რევოლუცია AI გენერაციულ მოდელებში
Hugging Face-ის მიზანია კარგი მანქანური სწავლების დემოკრატიზაცია ღია და ეთიკური ხელოვნური ინტელექტის მომავლის შესაქმნელად. ამ მიზნით შეიქმნა 🤗 Diffusers ბიბლიოთეკა, რომელიც ყველას საშუალებას აძლევს, ექსპერიმენტი ჩაატაროს „ტექსტიდან გამოსახულებამდე“ მოდელებით. როგორც მოდულური ხელსაწყოების ყუთი, Diffusers 1 წლის გახდა და ამ პერიოდში, საზოგადოების დახმარებით, მას მრავალი მნიშვნელოვანი ფუნქცია დაემატა. მათ შორისაა გამოსახულების ხარისხის გაუმჯობესება DeepFloyd IF-ისა და Stability AI SDXL-ის მოდელებით
TimmWrapper: PyTorch-ის გამოსახულების მოდელების ინტეგრაცია Hugging Face Transformers-თან
TimmWrapper წარმოადგენს ინსტრუმენტს, რომელიც აერთიანებს PyTorch Image Models (timm) ბიბლიოთეკას Hugging Face transformers-თან. ეს ინტეგრაცია მომხმარებლებს საშუალებას აძლევს გამოიყენონ timm-ის თანამედროვე კომპიუტერული ხედვის მოდელების ფართო კოლექცია transformers-ის ეკოსისტემაში. ის უზრუნველყოფს ისეთ ფუნქციებს, როგორიცაა pipeline API-ის გამოყენება, Auto Classes, კვანტიზაცია და მოქნილი წვრილი მორგება (LoRA-ს ჩათვლით) ნაცნობი Trainer API-ის მეშვეობით. TimmWrapper ავსებს ამ ორ მძლავრ ბიბლიოთეკას შორი
ენის გენერაციის დეკოდირების სტრატეგიები: ხარბი და სხივური ძიება
ბოლო წლებში, დიდი ტრანსფორმერზე დაფუძნებული ენობრივი მოდელების (როგორიცაა ChatGPT და LLaMA) აღზევებამ მნიშვნელოვნად გაზარდა ინტერესი ღია ტიპის ენის გენერაციის მიმართ. მოდელის გაუმჯობესებული არქიტექტურისა და მასიური სასწავლო მონაცემების პარალელურად, გადამწყვეტი როლი შეასრულა დეკოდირების უკეთესმა მეთოდებმაც. ეს სტატია წარმოგიდგენთ დეკოდირების ძირითად სტრატეგიებს – ხარბ ძიებას (Greedy search), სხივურ ძიებას (Beam search) და სემპლინგს (Sampling) – და განმარტავს, თუ როგორ ხორციელდება მათი დანერგვა პო