DeepSeek-R1-ის რევოლუცია: ღია წყაროს ინიციატივა მსჯელობის მოდელების გასახსნელად
DeepSeek-R1-ის გამოშვებამ ხელოვნური ინტელექტის სამყაროში მნიშვნელოვანი გარღვევა მოახდინა, წარმოადგინა მსჯელობის უნარის მქონე მოდელი, რომელიც OpenAI-ის o1-ზე არანაკლებ ან უკეთესად მუშაობს. მისი შექმნის მეთოდოლოგია, განსაკუთრებით კი გაძლიერებითი სწავლის (RL) გამოყენება ადამიანის ზედამხედველობის გარეშე, დეტალურად იქნა აღწერილი. მიუხედავად იმისა, რომ მოდელის წონები ღიაა, მისი სავარჯიშო მონაცემები და კოდი საიდუმლოდ დარჩა. ამის საპასუხოდ, Open-R1 პროექტი მიზნად ისახავს DeepSeek-R1-ის მონაცემთა და სავა
Würstchen: ინოვაციური დიფუზიური მოდელი რეკორდული კომპრესიით, რომელიც რევოლუციას ახდენს გამოსახულების გენერაციაში
Würstchen წარმოადგენს დიფუზიურ მოდელს, რომელიც გამოსახულების გენერაციას ახორციელებს უკიდურესად შეკუმშულ ლატენტურ სივრცეში, აღწევს რა 42x სივრცულ კომპრესიას – მიღწევა, რომელიც აქამდე შეუძლებლად ითვლებოდა. ეს საშუალებას აძლევს მას შექმნას მაღალი ხარისხის გამოსახულებები გაცილებით სწრაფად და ნაკლები რესურსებით, ვიდრე არსებული წამყვანი მოდელები, როგორიცაა Stable Diffusion XL, რაც მნიშვნელოვნად ამცირებს როგორც მოდელის ვარჯიშის, ისე ინფერენციის (შედეგების მიღების) ხარჯებს.
Rocket Money-ის რევოლუცია ტრანზაქციების კლასიფიკაციაში: AI-ის დანერგვა და Hugging Face-ის სტრატეგიული არჩევანი
პირადი ფინანსების აპლიკაცია Rocket Money-მ, მომხმარებელთა მზარდი ბაზისა და გამოწერის ეკონომიკის ბუმის ფონზე, ტრანზაქციების კლასიფიკაციისა და გამყიდველების იდენტიფიცირების სისტემა განავითარა. კომპანია რეგულარულ გამოსახულებებზე (regex) დაფუძნებული სისტემიდან მანქანური სწავლების (ML) უფრო დახვეწილ მიდგომაზე (BERT მოდელები) გადავიდა. ტრადიციულ ML გადაწყვეტებთან დაკავშირებული სირთულეების და შიდა სისტემის აშენების შემდეგ, Rocket Money-მ წარმატებით მოახდინა BERT მოდელების ინტეგრაცია. მოდელების განსათავ

ღია კოდის რევოლუცია კოდირების AI-ში: OlympicCoder 7B აჯობებს წამყვან მოდელებს და მისი ინტეგრაცია IDE-ში
ეს სტატია იკვლევს ღია კოდის ხელოვნური ინტელექტის მოდელების მზარდ პოტენციალს კოდირების ასისტენტების სფეროში, განსაკუთრებით ხაზს უსვამს OlympicCoder 7B-ს. LiveCodeBench-ის შეფასებების მიხედვით, ეს 7B პარამეტრის მქონე ვარიანტი აღემატება ისეთ პოპულარულ მოდელებს, როგორიცაა Claude 3.7 Sonnet და GPT-4o. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ამ მოდელების, კერძოდ OlympicCoder 7B-ის, ინტეგრირება ინტეგრირებულ განვითარების გარემოში (IDE), როგორიცაა VSCode, LM Studio-ს გამოყენებით ოპტიმალური ლოკალური ინ
SDXL Dreambooth LoRA ტრენინგის რევოლუცია: Pivotal Tuning-ისა და Prodigy ოპტიმიზატორის კომბინაციით
ამ სტატიაში წარმოდგენილია Dreambooth LoRA-ების SDXL-ისთვის ოპტიმიზაციის ახალი მეთოდი, რომელიც აერთიანებს Replicate-ის SDXL Cog ტრენერში გამოყენებულ Pivotal Tuning ტექნიკას Kohya ტრენერის Prodigy ოპტიმიზატორთან. ეს მიდგომა, სხვა მრავალ ოპტიმიზაციასთან ერთად, უზრუნველყოფს საუკეთესო შედეგებს ახალი კონცეფციების აღბეჭდვაში მცირე რაოდენობის გამოსახულებების გამოყენებით, SDXL-ის ესთეტიკური ხარისხისა და გამოსახულების სიზუსტის შენარჩუნებით, ამასთანავე მოითხოვს შედარებით ნაკლებ გამოთვლით რესურსებს. გაეცანი

ხედვა-ენობრივი მოდელების ევოლუცია: სიახლეები, ტენდენციები და მომავალი
ხედვა-ენობრივი მოდელები (VLMs) დღესდღეობით ერთ-ერთი ყველაზე განხილვადი თემაა. 2024 წლის აპრილის ბლოგ პოსტში ვრცლად ვისაუბრეთ VLMs-ზე, მათ შორის LLaVA-ზე, პირველ წარმატებულ ღია წყაროს ხედვა-ენობრივ მოდელზე. მას შემდეგ მრავალი რამ შეიცვალა: მოდელები უფრო მცირე, მაგრამ ძლიერი გახდა, გაჩნდა ახალი არქიტექტურები და შესაძლებლობები (არგუმენტაცია, მოქმედება, გრძელი ვიდეოების გაგება). პარალელურად, განვითარდა ახალი პარადიგმები, როგორიცაა მულტიმოდალური ინფორმაციის მოძიებით გაძლიერებული გენერაცია (RAG) და მუ

Falcon-Arabic: ტექნოლოგიური ინსტიტუტის ახალი ენის მოდელი არაბული ხელოვნური ინტელექტის საზღვრებს ცვლის
არაბთა გაერთიანებული საამიროების ტექნოლოგიური ინოვაციების ინსტიტუტმა (TII) წარმოადგინა Falcon-Arabic, 7 მილიარდი პარამეტრის მრავალენოვანი ენის მოდელი, რომელიც ახალ სტანდარტებს ადგენს არაბული ბუნებრივი ენის დამუშავებისთვის (NLP). Falcon 3 არქიტექტურაზე აგებული, Falcon-Arabic მნიშვნელოვნად აღემატება არსებულ არაბულ LLM-ებს ეფექტურობითა და შესაძლებლობებით, რაც ხელს უწყობს არაბულენოვანი საზოგადოებების სრულ ინტეგრაციას ხელოვნური ინტელექტის რევოლუციაში და უზრუნველყოფს უფრო ბუნებრივ, ინტელექტუალურ და ინ
Gradio 3.0 და Gradio Blocks: მანქანური სწავლების დემოების შექმნის რევოლუცია
2019 წლიდან Gradio-ს ბიბლიოთეკით 600 000-ზე მეტი მანქანური სწავლების დემო აშენდა. დღეს წარმოდგენილია Gradio 3.0, რომელიც მოიცავს ფრონტენდის სრულ განახლებას, თანამედროვე ტექნოლოგიების (როგორიცაა Svelte) გამოყენებით, რამაც გამოიწვია სწრაფი მუშაობა და დახვეწილი ვიზუალური ესთეტიკა. გარდა ამისა, ახალი დაბალდონიანი ენა, Gradio Blocks, დეველოპერებს საშუალებას აძლევს შექმნან კომპლექსური, მორგებული ვებ აპლიკაციები უშუალოდ Python-ში, რაც უზრუნველყოფს განლაგებისა და მონაცემთა ნაკადზე მეტ კონტროლს. ამ მოვლე

ხელოვნური ინტელექტის აგენტების ევოლუცია: სტრუქტურული კოდის გენერაციის უპირატესობა
კვლევა იკვლევს ხელოვნური ინტელექტის აგენტების არქიტექტურის ევოლუციას, ადარებს ტრადიციულ JSON აგენტებს, CodeAgent-ებს და ახალ სტრუქტურულ CodeAgent-ებს. ეს უკანასკნელი აერთიანებს კოდის მოქნილობასა და სტრუქტურული გამომავალი მონაცემების სანდოობას, რაც მნიშვნელოვნად ამცირებს ანალიზის (parsing) შეცდომებს და აუმჯობესებს აგენტების მუშაობას. ნაჩვენებია, რომ სტრუქტურული გენერაცია აიძულებს აგენტებს, უფრო მკაფიოდ გამოხატონ თავიანთი მსჯელობა, თუმცა აღინიშნება, რომ ამ მიდგომის სრული პოტენციალი ვლინდება მაღალი
AI აგენტების ევოლუცია: სტრუქტურირებული კოდის მოქმედებების უპირატესობა
ხელოვნური ინტელექტის აგენტების მოქმედებების გამოხატვის მეთოდები ევოლუციას განიცდის, ტრადიციული JSON აგენტებიდან კოდის აგენტებამდე. უახლესი კვლევა ხაზს უსვამს სტრუქტურირებული CodeAgent-ების უპირატესობას, რომლებიც აერთიანებენ კოდის მოქნილობასა და სტრუქტურირებული გენერაციის საიმედოობას. ეს ინოვაციური მიდგომა მნიშვნელოვნად ამცირებს პარსინგის შეცდომებს, აუმჯობესებს აგენტების მუშაობას 2-7 პროცენტული პუნქტით ძლიერ მოდელებში და აიძულებს მათ მოქმედებამდე არტიკულირონ თავიანთი მსჯელობა. თუმცა, აღინიშნა, რო

TRL და vLLM-ის კოლოკაცია: ხელოვნური ინტელექტის მოდელების წვრთნის რევოლუცია GPU-ების ოპტიმიზაციით
ტრადიციულად, დიდი ენობრივი მოდელების (LLM) GRPO ალგორითმით წვრთნა, vLLM-ის სერვერის რეჟიმში გამოყენებისას, გრაფიკული პროცესორების (GPU) არაეფექტურ გამოყენებას იწვევდა. TRL-ის v0.18.0 ვერსიიდან, vLLM-თან ერთობლივი მუშაობის (კოლოკაციის) მხარდაჭერა საშუალებას იძლევა, წვრთნა და ინფერენცია ერთსა და იმავე GPU-ებზე განხორციელდეს. ეს მიდგომა მნიშვნელოვნად ამცირებს უქმ დროს, აუმჯობესებს გამტარუნარიანობას და ამარტივებს განლაგებას, რაც LLM-ების წვრთნას უფრო სწრაფს, ეკონომიურს და მასშტაბირებადს ხდის.

Hugging Face-ის Kernel Hub: ხელოვნური ინტელექტის მოდელების მუშაობის დაჩქარება ოპტიმიზებული ბირთვებით
Hugging Face-ის ახალი Kernel Hub რევოლუციას ახდენს მანქანური სწავლების მოდელების ოპტიმიზაციაში. ის უზრუნველყოფს ცენტრალიზებულ საცავს წინასწარ კომპილირებული, მაღალეფექტური გამოთვლითი ბირთვებისთვის, რაც დეველოპერებს საშუალებას აძლევს, მარტივად ჩართონ ოპტიმიზებული კოდი სწრაფი ოპერაციებისთვის, განსაკუთრებით GPU-ებზე, რთული კომპილაციის პროცესების გარეშე. ეს დრამატულად ამარტივებს მაღალი წარმადობის მიღწევას ML პროექტებში, რაც დეველოპერებს საშუალებას აძლევს, მეტი დრო დაუთმონ მოდელების აგებას და ნაკლები

NVIDIA-ს Llama Nemotron Nano VL: რევოლუცია ინტელექტუალური დოკუმენტების დამუშავებაში
NVIDIA-მ წარმოადგინა Llama Nemotron Nano VL, 8 მილიარდპარამეტრიანი ხედვითი ენის მოდელი (VLM), რომელიც განკუთვნილია ინტელექტუალური დოკუმენტების დამუშავებისთვის (IDP). მოდელი გამოირჩევა მაღალი სიზუსტით და მულტიმოდალური გაგებით, რაც საშუალებას აძლევს მას ეფექტურად მოიპოვოს და გაიგოს ინფორმაცია კომპლექსური დოკუმენტებიდან, როგორიცაა ინვოისები, ქვითრები, კონტრაქტები, PDF ფაილები, სურათები და დიაგრამები. Llama Nemotron Nano VL აჩვენებს ინდუსტრიაში წამყვან შედეგებს OCRBench v2 ბენჩმარკზე, რაც უზრუნველყო
BLOOM: წარდგენილია მსოფლიოში პირველი გამჭვირვალე, მრავალენოვანი დიდი ენობრივი მოდელი (LLM)
დიდი ენობრივი მოდელები (LLM) რევოლუციას ახდენენ ხელოვნური ინტელექტის კვლევებში, თუმცა მათზე სრული წვდომა მხოლოდ შეზღუდულ ინდუსტრიულ ლაბორატორიებს აქვთ. ამ სტატუს კვოს შესაცვლელად წარმოდგენილია BLOOM – პირველი მრავალენოვანი LLM, რომელიც სრული გამჭვირვალობით გაიარა ტრენინგი. 176 მილიარდი პარამეტრით, BLOOM-ს შეუძლია ტექსტის გენერირება 46 ბუნებრივ და 13 პროგრამირების ენაზე. ეს არის AI მკვლევართა ყველაზე მასშტაბური თანამშრომლობის შედეგი, რაც მოდელს ხელმისაწვდომს ხდის ფართო სამეცნიერო საზოგადოებისთვის

AI-ის ეფექტურობის რევოლუცია: Hugging Face და AMD Llama 3.1-ს MI300X-ზე აუმჯობესებენ
ყოველდღიურად მილიარდობით AI მოთხოვნის დამუშავება, როგორიცაა ChatGPT-ის მიერ, მოდელის ოპტიმიზაციას გადამწყვეტ მნიშვნელობას ანიჭებს. განსაკუთრებით კრიტიკულია ბირთვის (kernel) დონის ოპტიმიზაცია, რაც ხშირად უგულებელყოფილია მრავალი მოწყობილობისთვის, განსაკუთრებით AMD GPU-ებისთვის. Hugging Face-მა AMD-სთან ითანამშრომლა, რათა შეემუშავებინა ღია წყაროს ოპტიმიზებული ბირთვები Llama 3.1 405B მოდელის მუშაობის გასაუმჯობესებლად FP8 ფორმატში, 8 MI300X GPU-ით აღჭურვილ კვანძზე, VLLM-ის გამოყენებით. ეს პარტნიორობა

Hugging Face-ის MCP სერვერის შექმნა: AI ასისტენტების დაკავშირების გამოცდილება და პროტოკოლის ევოლუცია
Hugging Face-ის გუნდი დეტალურად აღწერს Model Context Protocol (MCP) სერვერის შექმნის პროცესს, რომელიც ხელოვნური ინტელექტის ასისტენტებს გარე სამყაროსთან აკავშირებს. სტატია აანალიზებს პროტოკოლის სწრაფ ევოლუციას, ტრანსპორტის სხვადასხვა ვარიანტს (STDIO, HTTP SSE-ით, ნაკადოვანი HTTP) და იმ ტექნიკურ გადაწყვეტილებებს, რომლებიც Hugging Face-მა მიიღო ოპტიმალური, დინამიური და ადვილად ხელმისაწვდომი hf.co/mcp სერვერის შესაქმნელად. ყურადღება ექცევა უსტატუსო, პირდაპირი პასუხის კონფიგურაციის არჩევანს წარმოების

ScreenEnv: დესკტოპის ავტომატიზაციისა და AI აგენტების რევოლუცია Docker კონტეინერებში
ScreenEnv წარმოადგენს ინოვაციურ პლატფორმას, რომელიც დესკტოპის ამოცანების ავტომატიზაციას, GUI აპლიკაციების ტესტირებასა და AI აგენტების შექმნას ამარტივებს. ის გთავაზობთ სანდბოქსირებულ დესკტოპ გარემოს Docker კონტეინერში, რაც უზრუნველყოფს სრულ კონტროლს ვირტუალურ სესიაზე, კომპლექსური VM-ების საჭიროების გარეშე. პლატფორმა ადაპტირდება არსებულ ინფრასტრუქტურასთან და მომავალში გეგმავს ქროს-პლატფორმულ მხარდაჭერას Android-ის, macOS-ისა და Windows-ისთვის.
AI-ის რევოლუცია მონაცემებთან ურთიერთობაში: DuckDB-NSQL-7B და ტექსტიდან SQL-ზე გადასვლა
ხელოვნური ინტელექტის (AI) და დიდი ენობრივი მოდელების (LLM) განვითარება რევოლუციას ახდენს მონაცემთა ანალიზში. ტრადიციულად, SQL ქუერების შექმნა მოითხოვდა სპეციალიზებულ ცოდნას, რაც ხელმისაწვდომობის ხარვეზს ქმნიდა. MotherDuck-მა და Numbers Station-მა წარმოადგინეს DuckDB-NSQL-7B, LLM, რომელიც სპეციალურად DuckDB SQL-ისთვისაა შექმნილი. ეს მოდელი მომხმარებლებს საშუალებას აძლევს, ბუნებრივი ენით ჩამოაყალიბონ მონაცემთა მოთხოვნები, რომლებსაც მოდელი ავტომატურად თარგმნის SQL ბრძანებებში. სტატიაში დეტალურად არ

Hugging Face Hub-ი Xet-ზე გადავიდა: უხმაურო ტექნოლოგიური რევოლუცია
Hugging Face Hub-მა წარმატებით და თითქმის შეუმჩნევლად მოახდინა მიგრაცია Xet-ის შენახვის სისტემაზე, რომელსაც დღეისათვის 1 მილიონზე მეტი მომხმარებელი იყენებს. მაისიდან Xet Hub-ზე ახალი მომხმარებლებისა და ორგანიზაციებისთვის ნაგულისხმევად იქცა. მიგრაცია განხორციელდა მომხმარებლის მინიმალური ზემოქმედებით, გუნდის წლების გამოცდილების, კონტენტ-მისამართადი საცავის (CAS) და Rust კლიენტის წყალობით. ძირითადი დიზაინერული გადაწყვეტილებები მოიცავდა სამუშაო პროცესის შენარჩუნებას და Xet-ის არა-მხარდამჭერი კლიენტე

KV ქეშის კვანტიზაცია: მეხსიერების რევოლუცია დიდ ენობრივ მოდელებში
KV ქეშის კვანტიზაცია ამცირებს მეხსიერების მოხმარებას დიდ ენობრივ მოდელებში (LLM) ხანგრძლივი ტექსტის გენერაციისას, ხარისხზე მინიმალური გავლენით, და გვთავაზობს კონფიგურირებად კომპრომისებს მეხსიერების ეფექტურობასა და გენერაციის სიჩქარეს შორის.

SAIR: მონაცემთა ნაკრები, რომელიც რევოლუციას ახდენს ხელოვნური ინტელექტით წამლების დიზაინში
SAIR არის ღია კოდის მონაცემთა ნაკრები, რომელიც უფასოდ არის ხელმისაწვდომი CC BY 4.0 ლიცენზიით, რაც მას მყისიერად გამოსაყენებელს ხდის კომერციული და არაკომერციული კვლევა-განვითარების მიმართულებებისთვის. იგი წარმოადგენს სტრატეგიულ აქტივს, რომელიც ავსებს მონაცემთა დიდი ხნის არსებულ ხარვეზს ხელოვნური ინტელექტის (AI) მეშვეობით წამლების დიზაინში. SAIR აძლიერებს ფარმაცევტულ, ბიოტექნოლოგიურ და ტექ-ბიო ლიდერებს კვლევა-განვითარების დასაჩქარებლად, სამიზნე ჰორიზონტების გასაფართოებლად და AI მოდელების გასაძლიერ
OpenAI-ის „Whisper“: რევოლუცია მეტყველების ავტომატურ ამოცნობაში
OpenAI-ის Whisper, 2022 წლის სექტემბერში გამოქვეყნებული ავტომატური მეტყველების ამოცნობის (ამოკრ.) მოდელი, რევოლუციას ახდენს დარგში. წინამორბედებისგან განსხვავებით, ის გაწვრთნილია უპრეცედენტო მოცულობის, 680,000 საათის ეტიკეტირებულ აუდიო-ტრანსკრიფციის მონაცემებზე, მათ შორის 117,000 საათის მულტილინგვურ მონაცემებზე, რაც 96-ზე მეტი ენის მხარდაჭერას უზრუნველყოფს. ზედამხედველობითი წინასწარი გაწვრთნა საშუალებას აძლევს მას პირდაპირ ისწავლოს მეტყველებიდან ტექსტზე გადასვლა, რაც მინიმალურ დახვეწას მოითხოვს
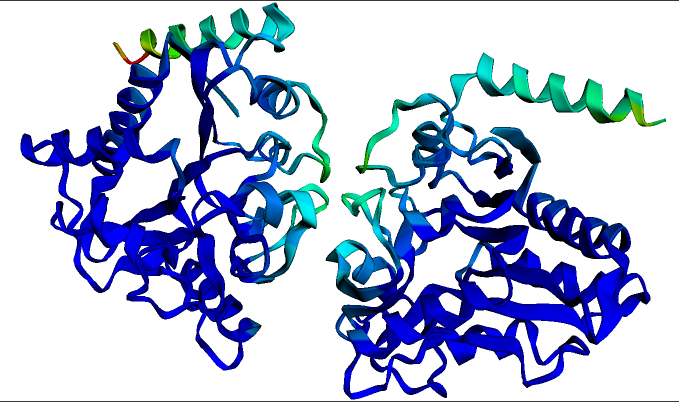
დიდი ენობრივი მოდელების შექმნის გზა: ტრანსფერული სწავლის ამბავი
სტატია მიმოიხილავს დიდი ენობრივი მოდელების (როგორიცაა BERT და GPT) ისტორიას, დაწყებული 2016 წლის ღრმა სწავლის (DL) გამოწვევებიდან. ხაზგასმულია DL-ის მთავარი პრობლემა – მონაცემების დიდი მოცულობის საჭიროება, რაც ხშირად მიუწვდომელია. შემდგომ განხილულია „ტრანსფერული სწავლის“ კონცეფცია, როგორც ამ გამოწვევის დაძლევის საშუალება, რაც გულისხმობს არსებული ცოდნის ახალ ამოცანაზე გადატანას. სტატია დეტალურად აღწერს, თუ როგორ მოახდინეს ULMFiT-მა და BERT-მა რევოლუცია 2018 წელს, დანერგეს ეფექტური ტრანსფერული სწა
XLSCOUT-ი Hugging Face-თან პარტნიორობით პატენტების ანალიზში რევოლუციას ახდენს ParaEmbed 2.0-ით
ინტელექტუალურ საკუთრებაში ხელოვნური ინტელექტის (AI) გამოყენების ლიდერმა, XLSCOUT-მა, Hugging Face-თან თანამშრომლობით შეიმუშავა ParaEmbed 2.0 – მძლავრი საკუთრების მოდელი, რომელიც 23%-ით აუმჯობესებს სიზუსტეს პატენტების რთული დოკუმენტების ანალიზში. ეს პარტნიორობა, ღია კოდის AI მოდელებისა და XLSCOUT-ის სპეციალიზებული მონაცემების გაერთიანებით, უზრუნველყოფს მოწინავე გადაწყვეტილებებს პატენტების შედგენის, სიახლის ძიებისა და ბათილობის კვლევებისთვის, რითაც სარგებელს მიიღებენ კორპორაციები, უნივერსიტეტები დ