
Hugging Face აძლიერებს ხელოვნური ინტელექტის მოდელების გაშვებას Whisper-ის დახმარებით: საზოგადოება და ეფექტურობა ცენტრში
Hugging Face-ი თავის Inference Endpoints-ს უფრო საზოგადოებაზე ორიენტირებულს ხდის, რაც ნებისმიერს აძლევს საშუალებას, წვლილი შეიტანოს ხელოვნური ინტელექტის მოდელების ეფექტურ განლაგებაში. განსაკუთრებული ყურადღება ექცევა Whisper მოდელებს, რომელთა გაშვებაც ოპტიმიზებულია vLLM-ის, CUDA-ს გრაფიკების და დინამიური კვანტიზაციის გამოყენებით, რის შედეგადაც Whisper Large V3-ისთვის შესრულების სიჩქარე (RTFx) თითქმის 8-ჯერ იზრდება. პლატფორმა უზრუნველყოფს მარტივ განლაგებას და რეალურ დროში ტრანსკრიფციის აპლიკაციები
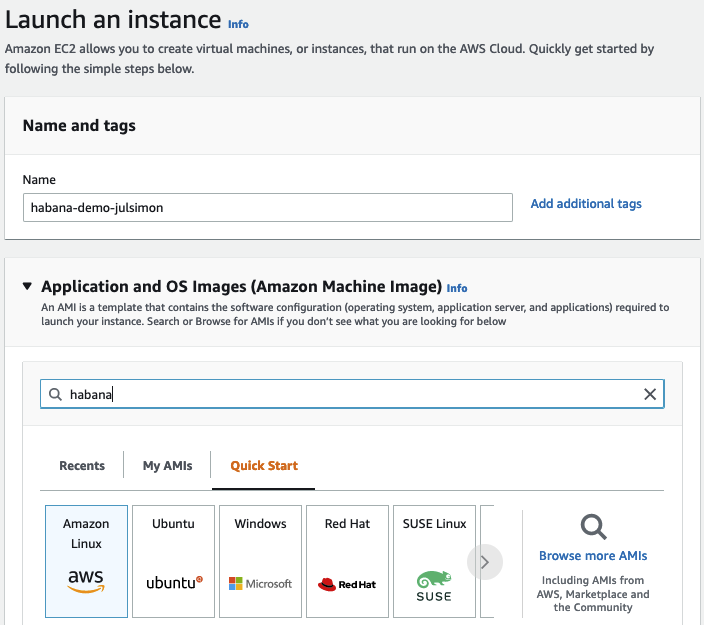
Habana Gaudi-ის ამაჩქარებლები და Transformer-ები: მაღალი წარმადობა და ხარჯთეფექტურობა AWS-ზე
Habana Gaudi-ის ახალი ამაჩქარებლები Amazon EC2 ინსტანციებზე უზრუნველყოფენ 40%-მდე უკეთეს ფასი-წარმადობას მანქანური სწავლის მოდელების, განსაკუთრებით Transformer-ების, წვრთნისთვის, უახლეს GPU-ებთან შედარებით. ეს პოსტი აღწერს, თუ როგორ სწრაფად დავაყენოთ Habana Gaudi ინსტანცია AWS-ზე და დავხვეწოთ BERT მოდელი ტექსტის კლასიფიკაციისთვის, რაც დემონსტრირებას უკეთებს ამ ტექნოლოგიის სიმარტივესა და ხარჯთეფექტურობას.
ახალი LLM ლიდერბორდი რეალურ ბიზნეს სცენარებში ენის მოდელების შეფასებისთვის
ეს ლიდერბორდი მიზნად ისახავს ენის დიდი მოდელების (LLM) მუშაობის შეფასებას რეალური ბიზნეს ამოცანების კონტექსტში. ის მხარს უჭერს 6 მრავალფეროვან დავალებას, როგორიცაა FinanceBench და იურიდიული კონფიდენციალურობა, და ზომავს მოდელების ეფექტურობას ისეთი მეტრიკებით, როგორიცაა სიზუსტე, ჩართულობა და ტოქსიკურობა. ლიდერბორდი შემუშავდა იმისათვის, რომ დაეხმაროს მომხმარებლებს პრაქტიკული გამოყენებისთვის საუკეთესო მოდელის არჩევაში და აქტიურად ცდილობს თავიდან აიცილოს ტესტ-კომპლექტის დაბინძურება ზოგიერთი მონაცემთა

Falcon-H1: ხელოვნური ინტელექტის მოდელების ინოვაციური სერია ჰიბრიდული არქიტექტურით
წარმოგიდგენთ Falcon-H1 სერიას, ექვს ღია კოდის მოდელს 0.5B-დან 34B პარამეტრამდე, რომლებიც ხელმისაწვდომია როგორც საბაზო, ასევე ინსტრუქციებზე მორგებულ ვარიანტებში. ამ მოდელების გულში დგას ჰიბრიდული არქიტექტურა, რომელიც აერთიანებს კლასიკური ტრანსფორმერზე დაფუძნებული ყურადღების მექანიზმისა და მდგომარეობის სივრცის მოდელის (SSM) ძლიერ მხარეებს. ეს ინოვაციური მიდგომა უზრუნველყოფს უპრეცედენტო წარმადობას, მაღალ ეფექტურობას და ფართო მასშტაბურობას, რაც Falcon-H1-ს კონკურენტუნარიანს ხდის წამყვან ტრანსფორმერზ
პერსონალიზებული AI მოდელები LLM-ების დახმარებით: დაზოგეთ ხარჯები და გაზარდეთ ეფექტურობა
სტატია განიხილავს პერსონალიზებული ხელოვნური ინტელექტის (AI) მოდელების დახვეწასა და LLM API-ების გამოყენებას შორის არსებულ დილემას, შემდეგ კი წარმოადგენს ინოვაციურ ჰიბრიდულ მიდგომას. ეს მეთოდი იყენებს ღია კოდის LLM-ებს მაღალი ხარისხის სინთეზური მონაცემების გენერირებისთვის, რათა მოამზადოს სპეციალიზებული მოდელები. შემთხვევის შესწავლა აჩვენებს ხარჯების, ენერგიის მოხმარების და დაყოვნების დროის მნიშვნელოვან გაუმჯობესებას GPT-4-ის მსგავს დიდ LLM API-ებთან შედარებით, პარალელურად ინარჩუნებს მსგავს ეფექტუ
Sempre Health-მა Hugging Face-ის დახმარებით შემომავალი შეტყობინებების 20%-ის ავტომატური დამუშავება დაიწყო
Sempre Health-მა Hugging Face-თან თანამშრომლობით დანერგა ახალი NLP პაიპლაინი, რომელმაც შემომავალი შეტყობინებების ავტომატური კლასიფიცირება და რეაგირება დაიწყო. ამ ინოვაციამ მნიშვნელოვნად გაზარდა ბიზნესის მასშტაბურობა და გუნდის ეფექტურობა, რადგან ახლა ყოველდღიური შეტყობინებების 20%-ზე მეტი სისტემის მიერ ავტომატურად მუშავდება. „ექსპერტთა აჩქარების პროგრამამ“ Sempre Health-ს საშუალება მისცა სწრაფად განეხორციელებინა ეს ცვლილება და შეემცირებინა დაბალღირებული სამუშაო დატვირთვა.
მატრიოშკა Embeddings-ის მოდელები: მოქნილობა და ეფექტურობა ხელოვნურ ინტელექტში
ეს სტატია განიხილავს მატრიოშკა Embeddings-ის მოდელებს, რომლებიც გვთავაზობენ მოქნილობასა და ეფექტურობას ბუნებრივი ენის დამუშავებასა და ხელოვნურ ინტელექტში. განმარტებულია მათი მუშაობის პრინციპი, რომელიც რუსული მატრიოშკის თოჯინების მსგავსად, საშუალებას იძლევა, Embeddings-ის ზომა შემცირდეს ინფორმაციის მნიშვნელოვანი დაკარგვის გარეშე. სტატია ასევე მოიცავს პრაქტიკულ რჩევებს მათი გამოყენებისა და ტრენინგის მეთოდებზე, მათ შორის Sentence Transformers-ის ფარგლებში, ხაზს უსვამს მათ უპირატესობებს ტრადიციულ Em
Hugging Face Optimum: ტრანსფორმერების მოდელების ოპტიმიზაცია და ONNX-ში ექსპორტი წარმოებისთვის
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Transformers მოდელების ექსპორტირება ONNX ფორმატში Hugging Face Optimum ბიბლიოთეკის გამოყენებით, რათა მივაღწიოთ მაქსიმალურ ეფექტურობას წარმოების გარემოში. სტატია განმარტავს ONNX-ის, როგორც ღია სტანდარტის მნიშვნელობას, წარმოგიდგენთ Optimum-ის ფართო შესაძლებლობებს მოდელის ოპტიმიზაციისთვის და იკვლევს კონვერტაციის სხვადასხვა მეთოდს, მარტივი API-დან მოწინავე ფუნქციონალამდე.

როგორ მოვაგვარეთ AI-ის არაეფექტური ტრენინგის პრობლემა: მონაცემთა მილსადენის ოპტიმიზაცია
ჩვენი nanoVLM პროექტის ფარგლებში AI მოდელების ტრენინგის შენელების პრობლემა აღმოვაჩინეთ. დეტალური ანალიზის შემდეგ გაირკვა, რომ პრობლემა არც მოდელში და არც აპარატურაში იყო, არამედ მონაცემთა მილსადენის არაეფექტურობაში. ამ სტატიაში აღწერილია ხუთსაფეხურიანი მიდგომა, თუ როგორ მოხდა მილსადენის ოპტიმიზაცია, მათ შორის „ზურგჩანთის პრობლემის“ (knapsack problem) გამოყენებით, რამაც მნიშვნელოვნად შეამცირა დაუფიქსირებელი მონაცემების (padding) რაოდენობა და გაზარდა ტრენინგის ეფექტურობა.
AI მონაცემთა მილსადენის ოპტიმიზაცია: როგორ დავზოგოთ GPU რესურსები და გავზარდოთ ეფექტურობა
კომპანია nanoVLM-ის პროექტზე მუშაობისას აღმოჩნდა, რომ ვარჯიშის ნელი ტემპი არა მოდელის ან აპარატურის, არამედ მონაცემთა მილსადენის არაეფექტურობის ბრალი იყო. პრობლემა ძირითადად გამოწვეული იყო მონაცემების ზედმეტი „შევსებით“ (padding), რაც GPU-ს რესურსების 60%-მდე უქმად ხარჯავდა. ამ პოსტში აღწერილია ხუთეტაპიანი სტრატეგია ეფექტური მილსადენის შესაქმნელად, მათ შორის დინამიური დაჯგუფება, ზურგჩანთის ამოცანის (knapsack problem) გამოყენება და „ბინ-ფექინგის“ მეთოდები. შედეგად, მიღწეულია მინიმალური შევსება და
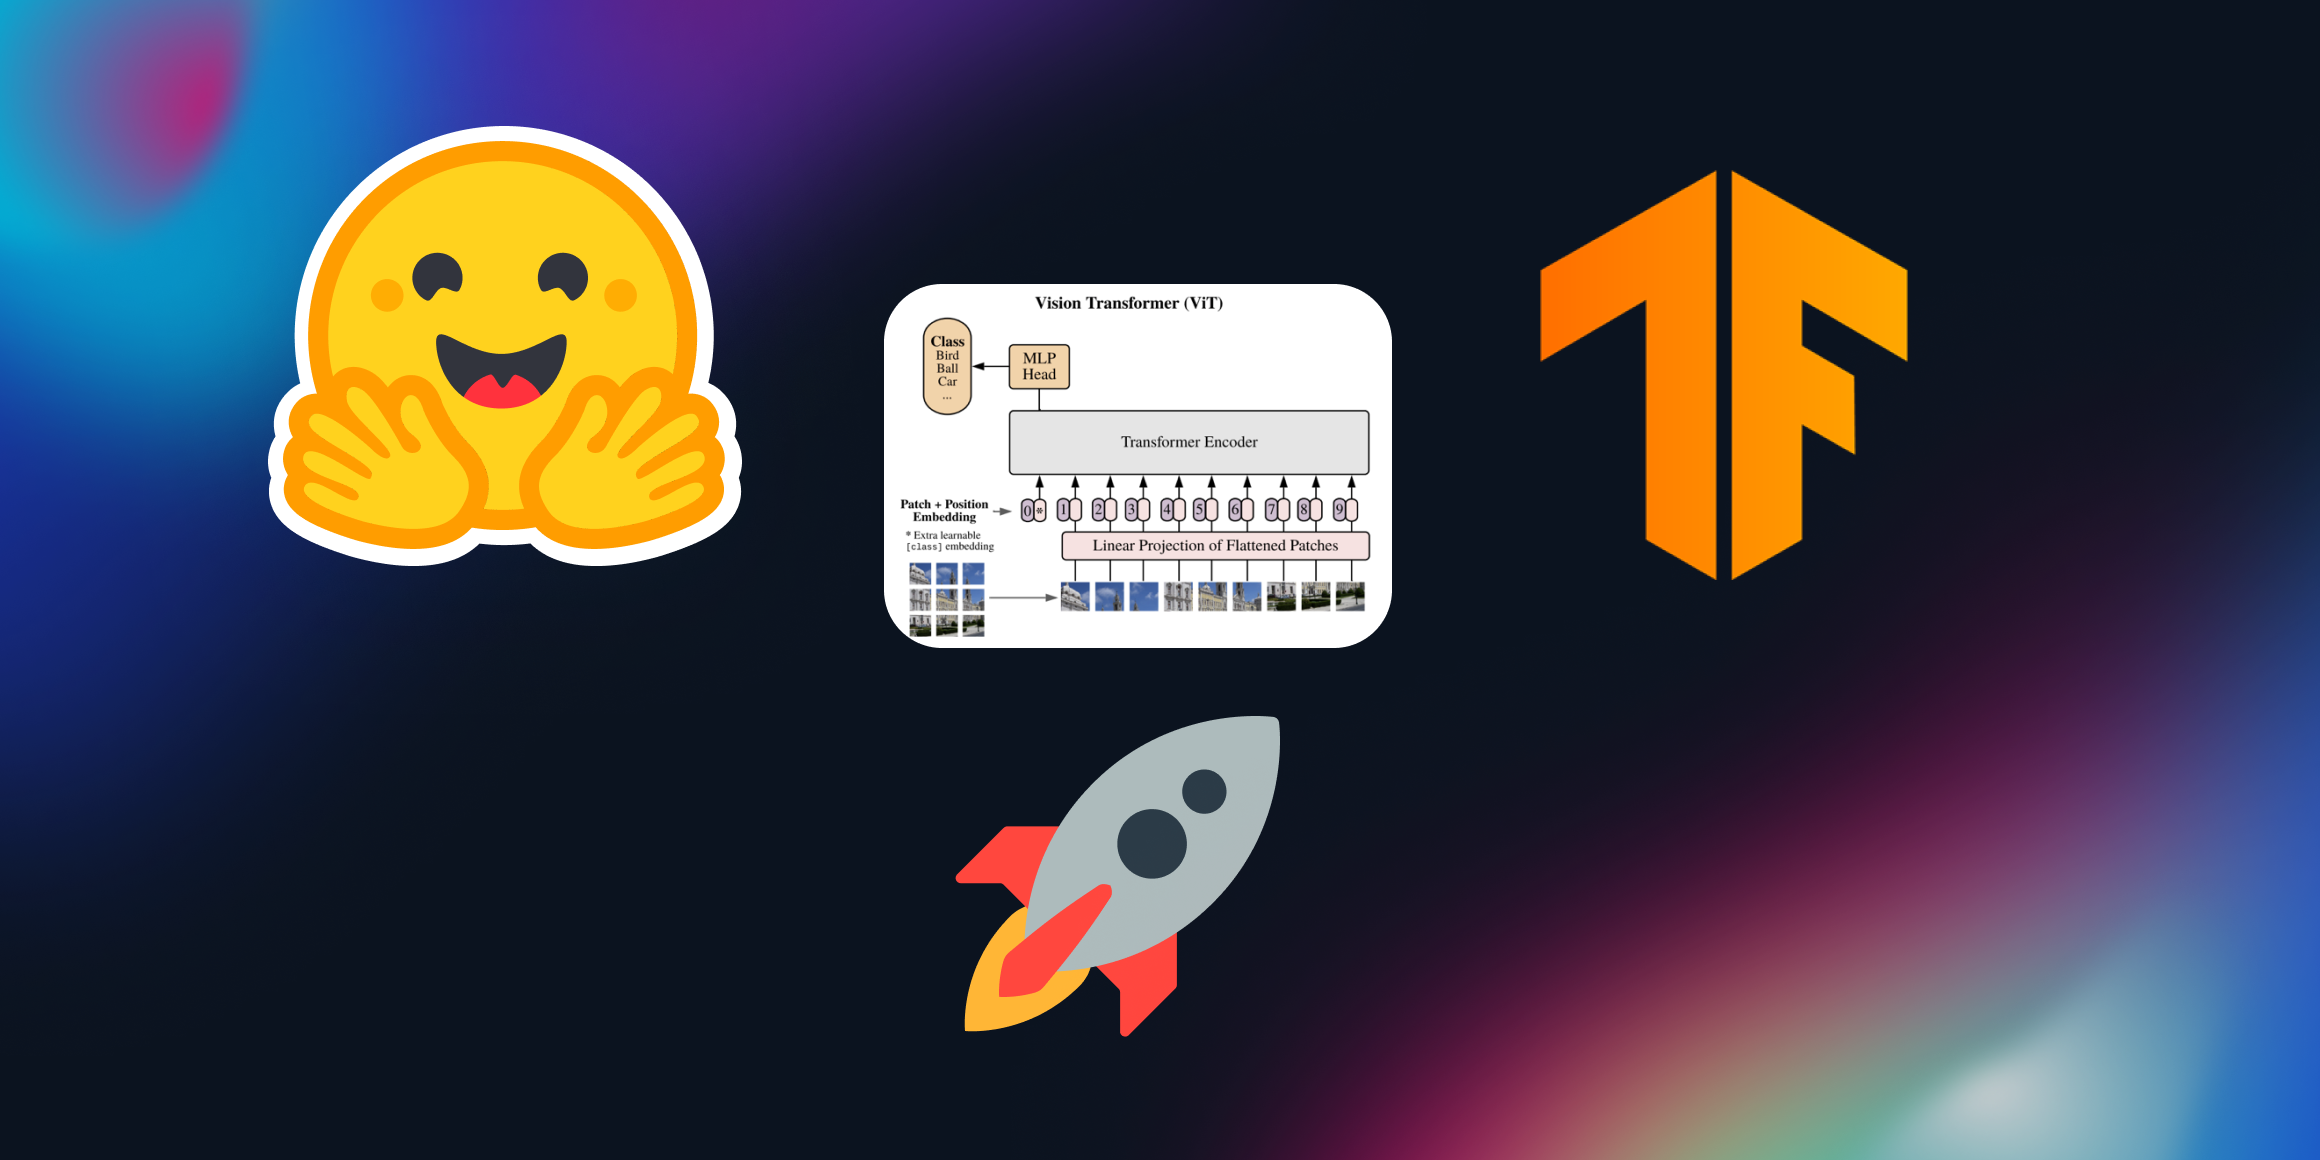
Vision Transformer მოდელის ლოკალურად განთავსება TensorFlow Serving-ის გამოყენებით
ეს პოსტი დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Vision Transformer (ViT) მოდელის (გამოსახულების კლასიფიკაციისთვის) ლოკალურად განთავსება TensorFlow Serving-ის (TF Serving) მეშვეობით. ის განმარტავს მოდელის შენახვას SavedModel ფორმატში, წინასწარი და შემდგომი დამუშავების ნაბიჯების ინტეგრირებას გამოთვლით გრაფში და საბოლოოდ, მოდელის გაშვებას REST ან gRPC ენდპოინტებად TF Serving-ის გამოყენებით, რითაც შემცირდება დეველოპერების კოგნიტური დატვირთვა და გაუმჯობესდება სისტემის ეფექტურობა.
Numina-სა და Kimi-ის გუნდი: Kimina-Prover-72B-ის გამოშვება
Numina-მ და Kimi-მ წარმოადგინეს Kimina-Prover-72B, უახლესი ხელოვნური ინტელექტის მოდელი თეორემების დამტკიცებისთვის, რომელიც გაწვრთნილია Kimi k1.5 RL სისტემით და დაფუძნებულია Qwen2.5-72B-ზე. მოდელის ძირითადი ინოვაციებია ტესტირების დროს განმტკიცებითი სწავლის ძიება (TTRL) რთული, მრავალსაფეხურიანი მტკიცებულებებისთვის ლემების გამოყენებით და შეცდომების გამოსწორების შესაძლებლობა, რაც მნიშვნელოვნად ზრდის ეფექტურობას. Kimina-Prover-მა მიაღწია 92.2%-იან უპრეცედენტო წარმატებას miniF2F ბენჩმარკზე, რამაც მას

Hugging Face Optimum და Graphcore IPU-ები: ViT მოდელების ეფექტური დახვეწა
ეს ბლოგ-პოსტი აღწერს, თუ როგორ მარტივად შეიძლება წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ Vision Transformer (ViT) არქიტექტურის, დახვეწა Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს ViT-ის არქიტექტურას, მის უპირატესობებს კონვოლუციურ ნერვულ ქსელებთან (CNNs) შედარებით კომპიუტერულ ხედვაში, გამოყენების სფეროებს, განსაკუთრებით ჯანდაცვაში, და ხაზს უსვამს IPU-ების მიერ შეთავაზებულ ეფექტურობას.

მოდელის კონტექსტის პროტოკოლი (MCP): ხელოვნური ინტელექტის ახალი ერა კვლევის ავტომატიზაციაში
მოდელის კონტექსტის პროტოკოლი (MCP) არის სტანდარტი, რომელიც აგენტურ მოდელებს საშუალებას აძლევს, დაუკავშირდნენ გარე ინსტრუმენტებსა და მონაცემთა წყაროებს. ეს ხელოვნურ ინტელექტს აძლევს შესაძლებლობას, ბუნებრივი ენის გამოყენებით ავტომატიზირება მოახდინოს კვლევის პროცესში, პლატფორმებს შორის გადართვისა და ინფორმაციის ჯვარედინი შემოწმების ჩათვლით, რაც მნიშვნელოვნად ზრდის კვლევის ეფექტურობას.

KV ქეშის კვანტიზაცია: მეხსიერების რევოლუცია დიდ ენობრივ მოდელებში
KV ქეშის კვანტიზაცია ამცირებს მეხსიერების მოხმარებას დიდ ენობრივ მოდელებში (LLM) ხანგრძლივი ტექსტის გენერაციისას, ხარისხზე მინიმალური გავლენით, და გვთავაზობს კონფიგურირებად კომპრომისებს მეხსიერების ეფექტურობასა და გენერაციის სიჩქარეს შორის.

PyTorch-ის წინასწარი (AoT) კომპილაცია ZeroGPU Spaces-ში: მაქსიმალური სისწრაფე და ეფექტურობა
PyTorch-ის წინასწარი (AoT) კომპილაცია მნიშვნელოვან უპირატესობას ანიჭებს ZeroGPU Spaces-ს, სადაც ტრადიციული Just-in-Time (JIT) კომპილაცია არაეფექტურია პროცესების ხანმოკლე სიცოცხლის ხანგრძლივობის გამო. AoT საშუალებას აძლევს მომხმარებლებს, ერთხელ მოახდინონ მოდელების ოპტიმიზაცია და მყისიერად გადატვირთონ ისინი, რაც იწვევს დემოების 1.3-დან 1.8-ჯერ დაჩქარებას და გაუმჯობესებულ მომხმარებლის გამოცდილებას. ეს პოსტი განმარტავს AoT-ის ინტეგრაციას ZeroGPU-ში, მოიცავს მოწინავე ტექნიკებს, როგორიცაა FP8 კვანტიზა
AWS Inferentia2 აფართოებს ხელოვნური ინტელექტის შესაძლებლობებს Hugging Face-ის მომხმარებლებისთვის
Amazon Web Services (AWS) აცხადებს, რომ მისი უახლესი მანქანური სწავლების ჩიპი, Inferentia2, სრულად ხელმისაწვდომია Hugging Face Hub-ის მომხმარებლებისთვის. ეს ინტეგრაცია მნიშვნელოვნად ამარტივებს დიდი ენობრივი მოდელების (LLMs) და სხვა AI მოდელების განთავსებასა და გამოყენებას AWS SageMaker-ზე და Hugging Face Inference Endpoints-ის მეშვეობით. Inferentia2 ინსტანციები გვთავაზობს მაღალ წარმადობას, ხარჯთეფექტურობას და მხარდაჭერას 100,000-ზე მეტი მოდელისა და ამოცანისთვის, მათ შორის Llama 3-ისთვის, რაც ხელ

Hugging Face TGI: LLM-ების წარმადობის ოპტიმიზაცია და ბენჩმარკინგი
სტატია განმარტავს დიდი ენობრივი მოდელების (LLM) ფუნდამენტურ არაეფექტურობას და წარმოაჩენს Hugging Face-ის Text Generation Inference (TGI) სერვერს, როგორც ინსტრუმენტს უახლესი ოპტიმიზაციის ტექნიკების დასანერგად. ის ხაზს უსვამს ბენჩმარკინგის მნიშვნელობას სხვადასხვა გამოყენების შემთხვევებისთვის, როგორიცაა RAG და ჩატბოტები, და განმარტავს ლატენტურობისა და გამტარუნარიანობის, როგორც ორთოგონალური მეტრიკების, როლს. ავტორი გვიჩვენებს, თუ როგორ შეიძლება TGI ბენჩმარკინგის ინსტრუმენტის გამოყენება Hugging Face
LLM ინფერენსის ოპტიმიზაცია: Hugging Face TGI ბენჩმარკინგი
ეს სტატია განმარტავს, თუ როგორ ხდება დიდი ენობრივი მოდელების (LLM) ინფერენსის ოპტიმიზაცია Hugging Face-ის მაღალეფექტური ტექსტის გენერაციის ინფერენსის (TGI) სერვერის გამოყენებით. დეტალურად განიხილება LLM-ების თანდაყოლილი არაეფექტურობა, ინდუსტრიის მიერ მიღწეული გაუმჯობესებები მუშაობის ოპტიმიზაციაში, ასევე ბენჩმარკინგის მნიშვნელობა სხვადასხვა გამოყენების შემთხვევებისთვის, როგორიცაა RAG და ჩატი. სახელმძღვანელო განმარტავს ძირითად მეტრიკებს, როგორიცაა ლატენტურობა და გამტარუნარიანობა, და გვიჩვენებს, თუ
ღია Embedding მოდელების განთავსება Amazon SageMaker-ზე Hugging Face Embedding კონტეინერის გამოყენებით
ეს ბლოგი დეტალურად აღწერს, თუ როგორ უნდა განათავსოთ ღია Embedding მოდელები, როგორიცაა Snowflake Arctic Embed, Amazon SageMaker-ზე ინფერენციისთვის, ახალი Hugging Face Embedding კონტეინერის გამოყენებით. სტატია მოიცავს განვითარების გარემოს დაყენებას, კონტეინერის მოძიებას, მოდელის განთავსებას და მისი მუშაობის შეფასებას როგორც CPU, ასევე GPU ინსტანციებზე, ხაზს უსვამს Text Embedding Inference (TEI)-ის ეფექტურობას და ხარჯ-ეფექტურობას.

Prezi და Hugging Face: როგორ ეხმარება ხელოვნური ინტელექტის ექსპერტთა მხარდაჭერა პრეზენტაციების ინოვაციებში
Prezi შეუერთდა Hugging Face-ის ექსპერტთა მხარდაჭერის პროგრამას, რათა სრულად გამოიყენოს მანქანური სწავლების პოტენციალი. ბოლო თვეების განმავლობაში, Hugging Face-მა Prezi-ს მხარი დაუჭირა მცირე, უფრო ეფექტური ღია წყაროს მოდელების ინტეგრაციაში მათ ML სამუშაო პროცესებში. Prezi-ის Backend ინჟინერი, მათე ბორჩოკი, ხაზს უსვამს, თუ როგორ დააჩქარა ამ თანამშრომლობამ მათი AI პროდუქტების განვითარება, გააუმჯობესა პრეზენტაციების შექმნა და დეპლოირების ეფექტურობა მორგებული რჩევებისა და მოწინავე ინსტრუმენტების, მაგ
მონაცემთა ხარისხი: ხელოვნური ინტელექტის ეფექტური, ეთიკური და მდგრადი განვითარების საფუძველი
ხელოვნური ინტელექტის ეპოქაში, მონაცემთა ხარისხი გადამწყვეტ როლს თამაშობს AI სისტემების ეფექტურობაში, ეთიკურობასა და მდგრადობაში. სტატია განმარტავს, თუ რას ნიშნავს „მაღალი ხარისხის“ მონაცემები – ანუ, მონაცემები, რომლებიც მიზანშეწონილია კონკრეტული ამოცანისთვის – და ხაზს უსვამს, თუ რატომ არის კრიტიკული მისი პრიორიტეტულობა განვითარების საწყისი ეტაპიდანვე. განიხილება ჰოლისტიკური მიდგომა, რომელიც მოიცავს მონაცემთა საგულდაგულო კურაციას, მართვის მყარ ჩარჩოს, მონაცემთა მრავალფეროვან წარმოდგენას და რეგულა

Apple-ის ნერვული პროცესორი და ხელოვნური ინტელექტი მოწყობილობაზე: Core ML-ით და MLX-ით მოდელების ადაპტირება
ეს სტატია იკვლევს მანქანური სწავლების მოდელების ოპტიმიზაციის პროცესს Apple-ის მოწყობილობებზე ეფექტურად გასაშვებად, ნერვული პროცესორის, Core ML-ისა და MLX ფრეიმვორკების გამოყენებით. ის ხაზს უსვამს ნერვული პროცესორის ენერგოეფექტურობას და იმ გამოწვევებს, რომელთა წინაშეც დეველოპერები დგანან Core ML-ის დახურული ხასიათის გამო. ავტორები წარმოადგენენ სამნაწილიან სერიას, რომელიც დეტალურად აღწერს კომპლექსური მოდელის (dots.ocr) PyTorch-დან მოწყობილობაზე გასაშვებად კონვერტაციის გზას, იზიარებენ პრაქტიკულ გად
ML მოდელების კონვერტაცია Apple-ის მოწყობილობებზე: Core ML-ისა და MLX-ის გამოყენება `dots.ocr`-ის მაგალითზე
სტატია დეტალურად აღწერს, თუ როგორ ხდება მანქანური სწავლების (ML) მოდელების, კერძოდ `dots.ocr`-ის, ოპტიმიზაცია Apple-ის მოწყობილობებზე გასაშვებად. განხილულია Apple-ის ნეირონული ძრავის ენერგოეფექტურობა და Core ML-ის, როგორც მასზე წვდომის ერთადერთი საშუალების, შეზღუდვები. ასევე წარმოდგენილია MLX, უფრო მოქნილი ფრეიმვორკი, რომელიც GPU-ს იყენებს. სერიის პირველი ნაწილი მოიცავს `dots.ocr`-ის PyTorch-დან Core ML-ზე კონვერტაციის პროცესს, წარმოქმნილ პრობლემებს და მათ გადაჭრის გზებს, რათა დეველოპერებს დაეხმ