
ZDNET-ის რეკომენდაციები: რა დგას ჩვენი შეფასებების უკან და Insignia QF ტელევიზორი $400-ად
ZDNET განმარტავს თავისი სარედაქციო რეკომენდაციების პროცესს, რომელიც ეფუძნება საათობით ტესტირებასა და კვლევას. სტატიაში მიმოხილულია Insignia QF სერიის 75-ინჩიანი ტელევიზორი, როგორც ბიუჯეტური, მაგრამ მაღალი ხარისხის ვარიანტი Dolby Vision HDR-ითა და Dolby Atmos-ით. აღნიშნულია Best Buy-ს Presidents' Day-ს გაყიდვების ფარგლებში მიმდინარე აქცია, რომლის დროსაც მომხმარებელს შეუძლია $250 დაზოგოს და ტელევიზორი $400-ად შეიძინოს. ZDNET ხაზს უსვამს თავის დამოუკიდებლობას, სიზუსტესა და გარიგებების შეფასების სის

ZDNET-ის რეკომენდაცია: M4 MacBook Pro-ს სპეციალური შეთავაზება და ჩვენი სარედაქციო მიდგომა
ZDNET განმარტავს, თუ როგორ ხდება მისი სარედაქციო რეკომენდაციები მრავალსაათიანი ტესტირების, კვლევისა და მომხმარებელთა მიმოხილვების საფუძველზე, რათა უზრუნველყოს სიზუსტე და დამოუკიდებლობა. სტატია დეტალურად აღწერს M4 MacBook Pro-ს უპირატესობებს, მათ შორის M4 Pro ჩიპს, 24 GB ოპერატიულ მეხსიერებას, 512 GB SSD-ს, Thunderbolt 5 პორტებს და გაუმჯობესებულ mini LED ეკრანს ბატარეის გაზრდილი ხანგრძლივობით. ამჟამად, Best Buy გთავაზობთ რეკომენდებულ M4 MacBook Pro მოდელს ფასდაკლებით 1,799 დოლარად, რაც ZDNET-ის მ

ZDNET განმარტავს: რას ნიშნავს რეკომენდაციები და როგორ გამოვიყენოთ Android-ის „გაფართოებული განბლოკვის“ (Extend Unlock) ფუნქცია
ZDNET დეტალურად განმარტავს, თუ როგორ ეფუძნება მისი რეკომენდაციები მრავალსაათიან ტესტირებას, კვლევასა და პროდუქტების შედარებით შერჩევას, ხაზს უსვამს სარედაქციო დამოუკიდებლობასა და სიზუსტეს, მიუხედავად შვილობილი საკომისიოებისა. გარდა ამისა, სტატიაში აღწერილია Android-ის „გაფართოებული განბლოკვის“ (Extend Unlock) ფუნქცია, რომელიც მომხმარებლებს საშუალებას აძლევს, მოწყობილობა განბლოკილი ჰქონდეთ ნდობით აღჭურვილ ადგილებში ან როდესაც მათთან ახლოს არის სანდო მოწყობილობა, რაც ამარტივებს ტელეფონის გამოყენებ
ხელოვნური ინტელექტის დეტექციის ბაზრის აღმავლობა და გამოწვევები 2025 წელს
გენერაციული ხელოვნური ინტელექტის სწრაფი განვითარების ფონზე, მნიშვნელოვნად იზრდება ადამიანის მიერ შექმნილი კონტენტის იდენტიფიცირების საჭიროება. ეს სტატია მიმოიხილავს ხელოვნური ინტელექტის დეტექციის ინსტრუმენტების ევოლუციას, ბაზრის მიმდინარე მდგომარეობას 2025 წელს, მათ ზრდას, დანერგვას, სიზუსტეს, ფასებსა და გამოყენებას. განხილულია ინდუსტრიის გამოწვევები, ინსტიტუციონალიზაციის პროცესი და სამომავლო ტენდენციები, რომლებიც მიმართულია უფრო ინტეგრირებული და მრავალმოდალური გადაწყვეტილებებისკენ, სადაც საიმედ

ZDNET-ის რეკომენდაციები: რა დგას მათ უკან და როგორ გამოვიყენოთ Windows-ის ძველი სარეზერვო ხელსაწყო
ZDNET დეტალურად განმარტავს, თუ რას ნიშნავს მათი „რეკომენდაციები“, რაც ეფუძნება საათობით ტესტირებას, კვლევასა და შედარებით შოპინგს. გამოცემა ხაზს უსვამს სარედაქციო დამოუკიდებლობასა და სიზუსტეს, რათა მკითხველს დაეხმაროს ჭკვიანი გადაწყვეტილებების მიღებაში. ამასთანავე, სტატია გთავაზობთ დეტალურ სახელმძღვანელოს Windows-ის ჩაშენებული, თუმცა მოძველებული სარეზერვო ხელსაწყოს გამოყენების შესახებ. განმარტებულია მისი ფუნქციონალი, შეზღუდვები, რჩევები მონაცემთა შენახვისთვის და გაფრთხილებები მისი მოძველების შეს

Big Bench Audio: ახალი მონაცემთა ნაკრები აუდიო ენის მოდელების მსჯელობის შესაძლებლობების შესაფასებლად
კომპანია Artificial Analysis-მა გამოუშვა Big Bench Audio, ახალი მონაცემთა ნაკრები, რომელიც შექმნილია აუდიო ენის მოდელების მსჯელობის შესაძლებლობების შესაფასებლად. ეს ინოვაციური ნაკრები Big Bench Hard-ის კითხვებს აუდიო ფორმატში ადაპტირებს. პირველადი შედეგები, რომლებიც GPT-4o-სა და Gemini 1.5-ის სერიის მოდელებზე ჩატარდა, ავლენს მნიშვნელოვან „მეტყველების მსჯელობის ხარვეზს“: GPT-4o-ის სიზუსტე ტექსტურ ვერსიაში 92%-ს აღწევს, ხოლო მეტყველება-მეტყველებაზე შესრულებისას ის 66%-მდე ეცემა. ანალიზი მოიცავს მრ

Adyen-ისა და Hugging Face-ის DABstep: ხელოვნური ინტელექტის მოდელების გამოწვევა მონაცემთა ანალიზში
Adyen-მა და Hugging Face-მა ერთობლივად შექმნეს DABstep – ახალი ბენჩმარკი, რომელიც 450-ზე მეტ მონაცემთა ანალიზის ამოცანას მოიცავს. მისი მიზანია ხელოვნური ინტელექტის (AI) უახლესი მოდელების შესაძლებლობების შეფასება მრავალსაფეხურიან აზროვნებაში. კვლევამ აჩვენა, რომ მიუხედავად განვითარებისა, AI აგენტები DABstep-ზე მხოლოდ 16%-იან სიზუსტეს აღწევენ, რაც მიუთითებს ამ სფეროში მნიშვნელოვანი პროგრესის საჭიროებაზე. ბენჩმარკი მოითხოვს, რომ AI მოდელებმა გამოავლინონ ტექნიკური უნარები, დომენური ცოდნა და კრეატიულ
OpenAI-მ Deep Research გამოუშვა: ვებ-დათვალიერების სისტემა და ღია კოდით მისი რეპროდუცირების მცდელობები
OpenAI-მ წარმოადგინა „Deep Research“ – ინოვაციური სისტემა, რომელიც ვებ-კონტენტს აჯამებს და კითხვებზე პასუხობს. სისტემამ შთამბეჭდავი შედეგები აჩვენა General AI Assistants (GAIA) ბენჩმარკზე, მიაღწია თითქმის 67%-იან სიზუსტეს საშუალოდ და 47.6%-ს რთულ „დონე 3“ კითხვებზე. Deep Research აგებულია დიდ ენობრივ მოდელზე (LLM) და აგენტურ ჩარჩოზე, რომელიც მას ინსტრუმენტების გამოყენებაში ეხმარება. მიუხედავად OpenAI-ს მიერ აგენტური ჩარჩოს დეტალების არგამჟღავნებისა, ღია კოდის საზოგადოებამ 24-საათიანი მისია დაიწყ
Fetch-მა ქვითრების სკანირების სიზუსტე 200%-ით გაზარდა AWS-ის მანქანური სწავლისა და Hugging Face-ის გამოყენებით
Fetch-მა, მომხმარებლის ჩართულობისა და ჯილდოების კომპანიამ, მნიშვნელოვნად გააუმჯობესა ქვითრების სკანირების აპლიკაციის სიჩქარე და სიზუსტე, Amazon Web Services-ზე (AWS) მანქანური სწავლების პაიპლაინის ოპტიმიზაციით, Hugging Face-ისა და Amazon SageMaker-ის გამოყენებით. ამ ცვლილებამ დოკუმენტის აღქმის მოდელის სიზუსტე 200%-ით გაზარდა და ნელი სკანირებისთვის დაყოვნება 50%-ით შეამცირა, რამაც დააჩქარა ჯილდოების დამუშავება და გაზარდა პარტნიორების ნდობა.
LLM-ების ეფექტური განლაგება: გამოთვლითი და მეხსიერების გამოწვევების გადაჭრა
დიდი ენობრივი მოდელები (LLM-ები) სწრაფად იკიდებენ ფეხს ცოდნაზე დაფუძნებულ ინდუსტრიებში, თუმცა მათი რეალურ სამყაროში განლაგება გამოწვევებითაა სავსე, განსაკუთრებით გამოთვლითი რესურსებისა და მეხსიერების კუთხით, ვრცელი შეტანის თანმიმდევრობებთან მუშაობისას. ეს პოსტი მიმოიხილავს ყველაზე ეფექტურ ტექნიკებს LLM-ების ოპტიმიზებული განლაგებისთვის, მათ შორის დაბალ სიზუსტეს (8-ბიტიანი და 4-ბიტიანი), Flash Attention-ს მეხსიერების ეფექტური გამოყენებისთვის და არქიტექტურულ ინოვაციებს, როგორიცაა Alibi, Rotary embe
ობიექტის ამოცნობის ლიდერბორდი: მეტრული მაჩვენებლების გაგება და კრიტიკული შეფასება
Hugging Face Hub-მა გამოაქვეყნა ობიექტის ამოცნობის ლიდერბორდი, რომელიც აფასებს მოდელებს სხვადასხვა მეტრიკის საფუძველზე, როგორიცაა „კვეთა გაერთიანებაზე“ (IoU), „საშუალო სიზუსტე“ (AP) და „საშუალო გახსენება“ (AR). ეს ბლოგი დეტალურად განიხილავს მოდელების შეფასების მეთოდებს, განმარტავს გამოყენებულ მეტრიკას და მიზნად ისახავს შეფასებისას წარმოშობილი სირთულეების გამარტივებას, რათა მომხმარებლებს შეეძლოთ მოდელის მუშაობის კრიტიკულად შეფასება. ასევე ახსნილია ობიექტის ამოცნობის კონცეფცია, მისი აპლიკაციები და

NVIDIA-ს რევოლუციური AI სიახლეები: Cosmos Transfer, Physical AI Dataset და Isaac GR00T N1
NVIDIA-მ წარადგინა ხელოვნური ინტელექტის (AI) სამი მნიშვნელოვანი სიახლე: Cosmos Transfer, რომელიც ზრდის ვირტუალური სამყაროს სცენების გენერირების სიზუსტეს; Physical AI Dataset, ღია კოდის მონაცემთა ნაკრები რობოტიკის ვარჯიშისთვის; და Isaac GR00T N1, მსოფლიოში პირველი ღია ფუნდამენტური მოდელი ჰუმანოიდური რობოტების მსჯელობისა და უნარებისთვის. ეს ინოვაციები მიზნად ისახავს ვირტუალური სამყაროების, რობოტიკისა და ავტონომიური სისტემების განვითარებას.
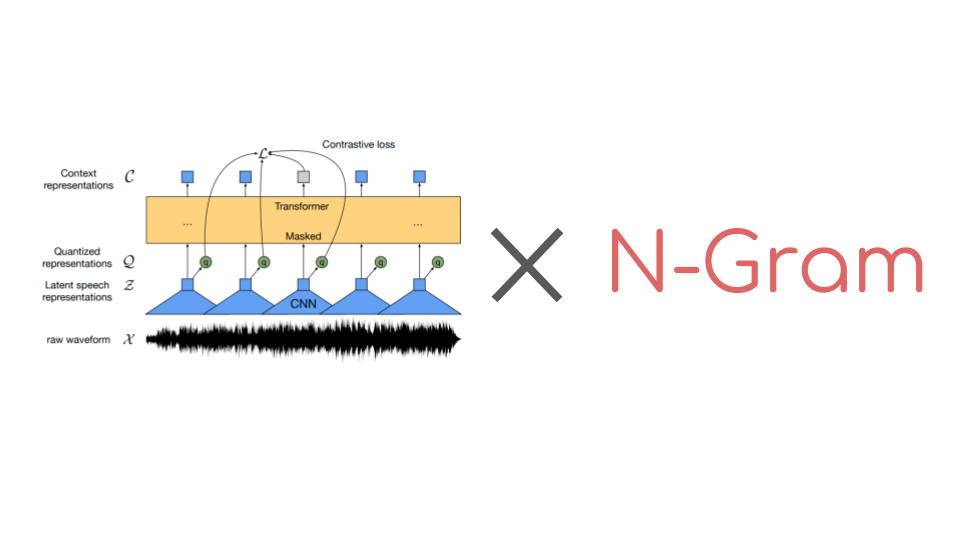
Wav2Vec2: ენობრივი მოდელების ინტეგრაცია ზუსტი მეტყველების ამოცნობისთვის
ეს სტატია განმარტავს, თუ როგორ უნდა დავაზუსტოთ Wav2Vec2 მოდელები მეტყველების ამოცნობისთვის და მნიშვნელოვნად გავაუმჯობესოთ ტრანსკრიფციის სიზუსტე ენობრივი მოდელის (LM) ინტეგრაციით. აღწერილია Connectionist Temporal Classification (CTC) ალგორითმის გამოყენება და დეტალურადაა განხილული pyctcdecode ბიბლიოთეკისა და 🤗 Transformers-ის საშუალებით n-გრამული ენობრივი მოდელის შექმნისა და Wav2Vec2 ჩეკპოინტთან შერწყმის ნაბიჯ-ნაბიჯ პროცესი, განსაკუთრებით ხაზგასმულია გაუმჯობესება მოკლე სასწავლო მონაცემთა ნაკრებებზ

AutoRound: Intel-ის ინოვაციური მეთოდი ხელოვნური ინტელექტის მოდელების ოპტიმიზაციისთვის
AutoRound, Intel-ის მიერ შემუშავებული პოსტ-საწვრთნელი კვანტიზაციის (PTQ) მეთოდი, მნიშვნელოვნად აუმჯობესებს ხელოვნური ინტელექტის მოდელების ეფექტურობას მინიმალური სიზუსტის დაკარგვით. ის იყენებს ხელმოწერილ გრადიენტულ დაშვებას წონის დამრგვალებისა და ამოჭრის დიაპაზონების ოპტიმიზაციისთვის, რაც უზრუნველყოფს ზუსტ დაბალბიტიან კვანტიზაციას (INT2-INT8) და აღწევს 2.1-ჯერ მეტ ფარდობით სიზუსტეს INT2-ზე პოპულარულ ბაზისებთან შედარებით. მეთოდი სწრაფია, მსუბუქი და თავსებადია მრავალ LLM/VLM არქიტექტურასთან, რაც მა

Intel Xeon-ზე StarCoder-ის 7X-ზე მეტი დაჩქარება: LLM-ების ოპტიმიზაციის ახალი ეტაპი
კოდის გენერირების მოდელების მზარდი პოპულარობის ფონზე, ეს სტატია წარმოგიდგენთ დიდი ენობრივი მოდელების (LLM) ოპტიმიზაციის უახლეს შედეგებს Intel Xeon-ზე, განსაკუთრებული აქცენტით პოპულარულ StarCoder მოდელზე. ნაჩვენებია StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენსის დაჩქარება Intel-ის მე-4 თაობის Xeon პროცესორებზე 8-ბიტიანი და 4-ბიტიანი კვანტიზაციისა და ასისტენტური გენერაციის ინტეგრაციის გზით. კვლევა ასევე ხაზს უსვამს SmoothQuant ალგორითმის გამოყენებას და მის დადებით გავლენას მოდელის სიზუსტესა და წარმად
ახალი LLM ლიდერბორდი რეალურ ბიზნეს სცენარებში ენის მოდელების შეფასებისთვის
ეს ლიდერბორდი მიზნად ისახავს ენის დიდი მოდელების (LLM) მუშაობის შეფასებას რეალური ბიზნეს ამოცანების კონტექსტში. ის მხარს უჭერს 6 მრავალფეროვან დავალებას, როგორიცაა FinanceBench და იურიდიული კონფიდენციალურობა, და ზომავს მოდელების ეფექტურობას ისეთი მეტრიკებით, როგორიცაა სიზუსტე, ჩართულობა და ტოქსიკურობა. ლიდერბორდი შემუშავდა იმისათვის, რომ დაეხმაროს მომხმარებლებს პრაქტიკული გამოყენებისთვის საუკეთესო მოდელის არჩევაში და აქტიურად ცდილობს თავიდან აიცილოს ტესტ-კომპლექტის დაბინძურება ზოგიერთი მონაცემთა
SetFit-ის მოდელების ოპტიმიზაცია Intel CPU-ებზე: 7.8-ჯერ უფრო სწრაფი ინფერენცია
SetFit მაღალ სიზუსტეს აღწევს მცირე მარკირებული მონაცემებით, აჭარბებს GPT-3.5-ს და GPT-4-საც კი, და გამოირჩევა LLM-ზე დაფუძნებული მეთოდებისგან პრომპტების არარსებობითა და ვარჯიშის სისწრაფით. ეს სტატია განმარტავს, თუ როგორ შეიძლება SetFit-ის ინფერენციის დაჩქარება 7.8-ჯერ Intel-ის პროცესორებზე Optimum Intel-ის ბიბლიოთეკისა და ვარჯიშის შემდგომი კვანტიზაციის გამოყენებით. განხილულია Optimum Intel-ის ტექნიკური უპირატესობები, კვანტიზაციის მექანიზმები და მოცემულია პრაქტიკული ნაბიჯები მოდელის ოპტიმიზაციისა
Hugging Face-ის მიდგომა: Transformers-ის ათვისება TensorFlow-ში Keras-ისა და ტრანსფერული სწავლების მეშვეობით
სტატია განიხილავს Hugging Face-ის ფილოსოფიას TensorFlow-ის ინჟინრებისთვის, რომლებიც იყენებენ Transformers-ის ბიბლიოთეკას. ის აკრიტიკებს Keras-ის მაღალდონიანი API-ის გვერდის ავლის გავრცელებულ პრაქტიკას და ხაზს უსვამს მის მნიშვნელობას. სტატია განმარტავს, თუ როგორ შეიძლება მძლავრი, წინასწარ გაწვრთნილი მოდელების გამოყენება ტრანსფერული სწავლების გზით, რაც ამცირებს მონაცემების საჭიროებას და ზრდის სიზუსტეს. ასევე, აღწერილია Hugging Face-ის მოდელების ინტეგრაცია ნაცნობ Keras-ის მეთოდებთან, როგორიცაა `fit
LLM.int8(): როგორ გავხადოთ გიგანტური ენის მოდელები უფრო ხელმისაწვდომი
თანამედროვე ენის მოდელები სულ უფრო იზრდება ზომაში, რაც მათ გასაშვებად უზარმაზარ გამოთვლით რესურსებს მოითხოვს. Hugging Face-მა და BigScience-მა წარმოადგინეს LLM.int8() ინტეგრაცია, რომელიც მოდელების პროგნოზირების ხარისხის შენარჩუნებით ამცირებს მათ მეხსიერების მოხმარებას 2-ჯერ. სტატია დეტალურად განმარტავს ამ კვანტიზაციის ტექნოლოგიას, მონაცემთა სხვადასხვა ტიპის სიზუსტესა და პარტნიორობის სამომავლო მიზნებს.
ღია CoT ლიდერბორდი: ხელოვნური ინტელექტის მოდელების შეფასება აზროვნების ჯაჭვის გავლენის მიხედვით
ღია CoT ლიდერბორდი წარმოადგენს ახალ პლატფორმას ხელოვნური ინტელექტის (LLM) მოდელების შესაფასებლად. ტრადიციული ლიდერბორდებისგან განსხვავებით, ის ზომავს არა აბსოლუტურ სიზუსტეს, არამედ იმ განსხვავებას, რასაც აზროვნების ჯაჭვის (Chain-of-Thought, CoT) მოთხოვნა იწვევს მოდელის სიზუსტეში. ეს მიდგომა საშუალებას იძლევა ჭეშმარიტად შემოწმდეს CoT-ის გავლენა მოდელის მსჯელობის უნარზე და მიზნად ისახავს შეამციროს ტრენინგის მონაცემების დაბინძურების რისკი, რაც აძლიერებს შეფასების სანდოობას. ლიდერბორდი იყენებს მოდულ
ახალი ლიდერთა დაფა ებრაული ენის LLM-ებისთვის: ნიუანსების შეფასება
ებრაული ენის მორფოლოგიური სირთულის გამო, არსებულ დიდ ენობრივ მოდელებს (LLM) უჭირთ მისი ნიუანსების ზუსტად დამუშავება. ამ ხარვეზის შესავსებად, შეიქმნა ახალი ლიდერთა დაფა, რომელიც სპეციალიზებულ შეფასების ეტალონებს გვთავაზობს ებრაული ენის LLM-ებისთვის. პლატფორმა მოიცავს ოთხ ძირითად მონაცემთა ნაკრებს: კითხვა-პასუხი, განწყობის სიზუსტე, ვინოგრადის სქემის გამოწვევა და თარგმანი. ინიციატივა მიზნად ისახავს მკვლევრებისა და დეველოპერების გაერთიანებას, ღია საზოგადოების წახალისებას და ისრაელის ტექნოლოგიური საზ
SetFit: ეფექტური ჩარჩო Sentence Transformers-ის მცირემონაცემიან პირობებში დაზუსტებისთვის
Hugging Face, Intel Labs-თან და UKP Lab-თან პარტნიორობით, წარმოგიდგენთ SetFit-ს – ინოვაციურ ჩარჩოს Sentence Transformers-ის მცირემონაცემიან პირობებში ეფექტური დაზუსტებისთვის. SetFit აღწევს მაღალ სიზუსტეს მინიმალური მარკირებული მონაცემებით, არის სწრაფი საწვრთნელად, მრავალენოვანი და არ საჭიროებს პრომპტებს, რაც მას კონკურენტუნარიანს ხდის გაცილებით დიდ მოდელებთან შედარებით და მნიშვნელოვნად ამცირებს ღირებულებას. ის მდგრადია ხმაურის მიმართ და მნიშვნელოვნად უფრო ეფექტურად იყენებს მონაცემებს, ვიდრე სტან

RTEB: ახალი ბენჩმარკი ხელოვნური ინტელექტის მოდელების მოძიების ხარისხის საიმედო შეფასებისთვის
ხელოვნური ინტელექტის აპლიკაციების მუშაობა, როგორიცაა RAG და რეკომენდაციის სისტემები, მნიშვნელოვნად შეზღუდულია ძიებისა და მოძიების ხარისხით. დეველოპერებისთვის პრობლემას წარმოადგენს ემბედინგის მოდელების მოძიების ხარისხის ზუსტი გაზომვა, რადგან არსებული ბენჩმარკები ხშირად აჩვენებენ „განზოგადების ხარვეზს“ და არ შეესაბამებიან რეალურ საწარმოო გამოყენების შემთხვევებს. ამ გამოწვევების გადასაჭრელად შეიქმნა RTEB – ახალი, საიმედო ბენჩმარკი, რომელიც ზომავს მოძიების სიზუსტეს. ის იყენებს ჰიბრიდულ სტრატეგიას (ღ
XLSCOUT-ი Hugging Face-თან პარტნიორობით პატენტების ანალიზში რევოლუციას ახდენს ParaEmbed 2.0-ით
ინტელექტუალურ საკუთრებაში ხელოვნური ინტელექტის (AI) გამოყენების ლიდერმა, XLSCOUT-მა, Hugging Face-თან თანამშრომლობით შეიმუშავა ParaEmbed 2.0 – მძლავრი საკუთრების მოდელი, რომელიც 23%-ით აუმჯობესებს სიზუსტეს პატენტების რთული დოკუმენტების ანალიზში. ეს პარტნიორობა, ღია კოდის AI მოდელებისა და XLSCOUT-ის სპეციალიზებული მონაცემების გაერთიანებით, უზრუნველყოფს მოწინავე გადაწყვეტილებებს პატენტების შედგენის, სიახლის ძიებისა და ბათილობის კვლევებისთვის, რითაც სარგებელს მიიღებენ კორპორაციები, უნივერსიტეტები დ