
ZDNET-ის შეფასება: DeWalt 60V Max - თოვლსაწმენდი, რომელიც ზამთარს გაგიმარტივებთ
ZDNET განმარტავს თავისი რეკომენდაციების მიუკერძოებლობასა და სიზუსტეს, რაც ეფუძნება საათობით ტესტირებასა და კვლევას. ამ სტატიაში რედაქტორი იზიარებს პირად გამოცდილებას DeWalt 60V Max თოვლსაწმენდთან დაკავშირებით, რომელმაც ჩაანაცვლა მოძველებული მოწყობილობა, რომელიც ყველაზე ცუდ დროს გაფუჭდა. აღწერილია მისი ძირითადი მახასიათებლები, როგორიცაა უჟანგავი ფოლადის აუგერი, ელექტრონული მართვის პანელი და ხანგრძლივი ბატარეის სიცოცხლე, რამაც საშუალება მისცა რედაქტორს არა მხოლოდ საკუთარი ეზოსა და ტროტუარის გაწმენ

Acer Swift Edge 14-ის მიმოხილვა: შესანიშნავი საშუალო დონის ლეპტოპი გამორჩეული დიზაინით
ZDNET-ის მიმოხილვაში წარმოდგენილია Acer Swift Edge 14-ის დეტალური შეფასება, რომელიც მოცემულია როგორც კომპანიის უახლესი საშუალო დონის, მაგრამ ძალიან კარგი მოწყობილობა. ხაზგასმულია მისი გამორჩეული დიზაინი, ღირსეული წარმადობა და ხანგრძლივი ბატარეის ხანგრძლივობა. განსაკუთრებული ყურადღება ექცევა მის ულტრა თხელ და მსუბუქ კორპუსს, მაგნიუმ-ალუმინის შენადნობისგან დამზადებულ ელეგანტურ დიზაინს და უნიკალურ „რბილი შეხების“ კლავიატურას. მიუხედავად იმისა, რომ OLED ეკრანი შენობაში იდეალურია, გარეთ მისი სიკაშკაშ

ZDNET-ის სარედაქციო პრინციპები და Beats Studio Pro ყურსასმენების დეტალური მიმოხილვა
ZDNET განმარტავს თავის სარედაქციო პრინციპებს, რომლებიც ეფუძნება მრავალსაათიან ტესტირებას, კვლევასა და დამოუკიდებელ შეფასებას, რათა მკითხველს მიაწოდოს ზუსტი და მიუკერძოებელი ინფორმაცია პროდუქტების შესახებ. სტატიაში ასევე წარმოდგენილია Beats Studio Pro ყურსასმენების დეტალური მიმოხილვა, სადაც აღწერილია მათი განახლებული, მინიმალისტური დიზაინი (მუქი ყავისფერი მქრქალი ზედაპირით), ხმაურის ჩახშობის ტექნოლოგია, კომფორტი და ბატარეის გამძლეობა. ყურსასმენები თავსებადია როგორც iOS, ასევე Android მოწყობილობებ

ZDNET-ის რეკომენდაციები: რას გულისხმობს Echo Show 11 და Alexa+?
ZDNET განმარტავს საკუთარი რეკომენდაციების სიღრმისეულ პროცესს, რომელიც მოიცავს ტესტირებას, კვლევასა და დამოუკიდებელ შეფასებას, სარედაქციო მიუკერძოებლობის შენარჩუნებით. სტატია დეტალურად განიხილავს Amazon Echo Show 11-ის უახლეს მოდელს, რომელიც აღჭურვილია გაუმჯობესებული Alexa+-ით და გენერაციული ხელოვნური ინტელექტით. მიუხედავად იმისა, რომ Alexa-ს სისტემას აქვს გარკვეული ნაკლოვანებები Google Home-თან ან Apple HomeKit-თან შედარებით, მისი განახლებული ვერსია მომხმარებლებს სთავაზობს სმარტ-სახლის ეკოსისტემ

როგორ წაშალოთ თქვენი Google-ის ძიების ისტორია Android-ზე (და რატომ არის ეს მნიშვნელოვანი)
სტატია განმარტავს ZDNET-ის რეკომენდაციების არსს, რომელიც ეფუძნება ხანგრძლივ ტესტირებასა და დამოუკიდებელ შეფასებას, ხაზს უსვამს მათ სარედაქციო დამოუკიდებლობას. ამასთანავე, ის გთავაზობთ დეტალურ სახელმძღვანელოს Android მოწყობილობებზე Google-ის ძიების ისტორიის წაშლისა და ქეშის გასუფთავებისთვის. სტატია ყურადღებას ამახვილებს კონფიდენციალურობის მნიშვნელობაზე და პერსონალიზებული რეკლამების გავლენაზე, გვთავაზობს პრაქტიკულ რჩევებს მონაცემების კონტროლისთვის.

ZDNET-ის რეკომენდაციები: რა დგას მის უკან? Kindle Scribe Colorsoft და ReMarkable Paper Pro-ს დეტალური შედარება
ZDNET განმარტავს საკუთარი რეკომენდაციების მომზადების მკაცრ მეთოდოლოგიას, რომელიც დაფუძნებულია მრავალსაათიან ტესტირებასა და დამოუკიდებელ შეფასებაზე. სტატია დეტალურად ადარებს Amazon-ის ახალ Kindle Scribe Colorsoft-ს და ReMarkable Paper Pro-ს – ორ პრემიუმ ელექტრონულ წიგნს, რომლებიც სპეციალურად ჩანაწერებისთვისაა შექმნილი. განხილულია მათი ძირითადი მახასიათებლები, მათ შორის ეკრანის ტექნოლოგია, წერის გამოცდილება, აპლიკაციების ინტეგრაცია და ფასი, რათა მომხმარებლებს დაეხმაროს ინფორმირებული არჩევანის გაკე

ZDNET-ის რეკომენდაციები: რას ნიშნავს ეს და Sonos Arc Ultra-ის დეტალური მიმოხილვა
ZDNET-ის სარედაქციო გუნდი უზრუნველყოფს ზუსტ და სანდო ინფორმაციას პროდუქტების შესახებ, რომელიც ეფუძნება საათობით ტესტირებასა და კვლევას, რათა მომხმარებლებმა ჭკვიანი გადაწყვეტილებები მიიღონ. სტატია დეტალურად განმარტავს ZDNET-ის სარედაქციო დამოუკიდებლობასა და შვილობილი კომისიების გამჭვირვალობას. მიმოხილვაში მოცემულია Sonos Arc Ultra-ს ხმის პანელის შეფასება, რომელიც გამოირჩევა მძლავრი ჟღერადობით, გაუმჯობესებული ბასით და მრავალი ფუნქციით, როგორიცაა Dolby Atmos და Apple AirPlay. მიუხედავად Sonos-ის ეკ

InfinaCore T3: უსადენო დამტენი, რომელიც მოგზაურობას ამარტივებს
ZDNET-ის რეკომენდაციები ეფუძნება ხანგრძლივ ტესტირებასა და დამოუკიდებელ შეფასებას, რაც უზრუნველყოფს სარედაქციო შინაარსის ობიექტურობას. ამ სტატიაში განხილულია InfinaCore T3 – კომპაქტური 3-in-1 უსადენო დამტენი, შექმნილია მოგზაურთათვის, რათა თავიდან აიცილონ მრავალი დამტენის ტარების საჭიროება. ის ეფექტურად ტენის iPhone-ს, Apple Watch-ს და AirPods-ს ერთი USB-C წყაროდან, გამოირჩევა გამძლეობით და მოსახერხებელი დიზაინით.

ZDNET-ის შეფასება: როგორ დაიცვათ კონფიდენციალურობა საჯარო სივრცეში StarTech.com-ის MacBook Pro ეკრანით
ZDNET განმარტავს, თუ რას გულისხმობს მისი რეკომენდაციები, რომლებიც ეფუძნება საათობით ტესტირებას, კვლევასა და შედარებით შოპინგს, რათა მკითხველს მიაწოდოს ზუსტი ინფორმაცია და დაეხმაროს ჭკვიანი გადაწყვეტილებების მიღებაში. სტატიაში ასევე წარმოდგენილია StarTech.com-ის MacBook Pro-ს კონფიდენციალურობის ეკრანის დეტალური მიმოხილვა, რომელიც უზრუნველყოფს მონაცემთა დაცვას საჯარო სივრცეში, ადვილი ინსტალაციითა და 60-გრადუსიანი ხედვის კუთხის მიღმა ხილვადობის დაფარვით.
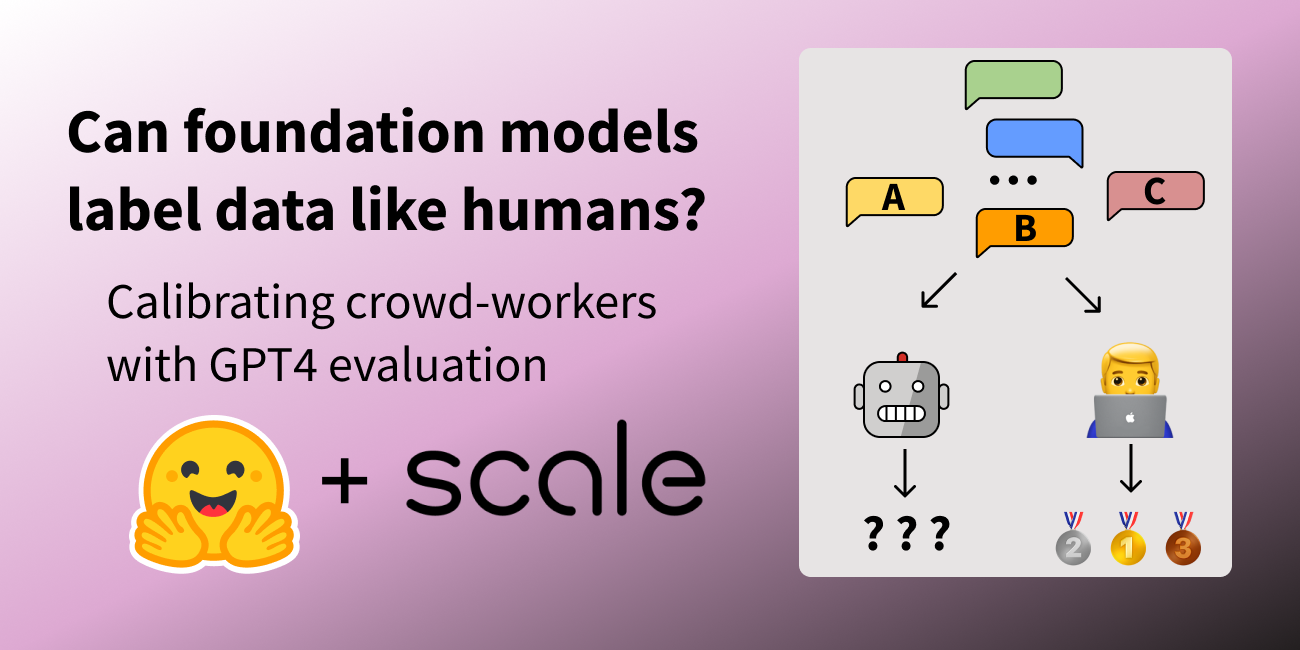
LLM-ების შეფასება: სად შეგვიძლია ვენდოთ მონაცემებს?
სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) შეფასების არსებულ გამოწვევებს, განსაკუთრებით GPT-4-ზე დაფუძნებულ მეტრიკაზე დამოკიდებულებას, რაც შესაძლოა სრულად არ ასახავდეს ადამიანურ უპირატესობებს. ხაზგასმულია ადამიანურად მარკირებული მონაცემების მნიშვნელობა რეალური უპირატესობების გასაზომად და წარმოდგენილია Hugging Face Open LLM ლიდერბორდის გაფართოება. ეს გაფართოებული ლიდერბორდი აერთიანებს ავტომატიზებულ აკადემიურ ბენჩმარკებს, პროფესიონალურ ადამიანურ მარკირებას და GPT-4 შეფასებებს, რათა უზრუნველყო
Hugging Face-ი აშშ-ის ვაჭრობის დეპარტამენტს ხელოვნური ინტელექტის ანგარიშვალდებულების შესახებ რეკომენდაციებს წარუდგენს
12 ივნისს, Hugging Face-მა აშშ-ის ვაჭრობის დეპარტამენტს (NTIA) ხელოვნური ინტელექტის ანგარიშვალდებულების პოლიტიკის შესახებ თავისი პასუხი წარუდგინა. კომპანია ხაზს უსვამს დოკუმენტაციისა და გამჭვირვალობის მნიშვნელობას, ასევე დაინტერესებული მხარეების სრულ ექსპერტიზაზე დაყრდნობის აუცილებლობას. Hugging Face-ის მისიაა „კარგი მანქანური სწავლების დემოკრატიზაცია“, რაც გულისხმობს სისტემების მარტივ გაგებას, შეფასებას და კრიტიკას ყველა დაინტერესებული მხარისთვის.

LLaMA-ს MMLU შეფასება: უთანხმოება ხელოვნური ინტელექტის მოდელების რეიტინგში
Open LLM ლიდერბორდზე LLaMA მოდელის MMLU (Massive Multitask Language Understanding) შეფასების ქულები გაცილებით დაბალი აღმოჩნდა, ვიდრე მის გამოქვეყნებულ ნაშრომში იყო მითითებული. ამან საზოგადოებაში გაკვირვება გამოიწვია. გამოძიებამ გამოავლინა MMLU შეფასების სხვადასხვა იმპლემენტაცია, მათ შორის EleutherAI Harness, ორიგინალი UC Berkeley-ის კოდი და Stanford HELM, რომლებიც განსხვავებულ შედეგებს იძლევა და მოდელების რეიტინგსაც კი ცვლის. სტატია დეტალურად განმარტავს ამ შეუსაბამობის მიზეზებს და დიდი ენობრივი

როგორ გავიგოთ და ოპტიმიზაცია გავუკეთოთ GPU მეხსიერებას PyTorch-ში
ეს გაკვეთილი ეტაპობრივად განმარტავს, თუ როგორ მოვახდინოთ GPU მეხსიერების გამოყენების ვიზუალიზაცია და გაგება PyTorch-ში ტრენინგის დროს. ის მოიცავს მეხსიერების მოთხოვნების შეფასებას, გამოყენების ოპტიმიზაციას PyTorch-ის პროფილის ხელსაწყოების მეშვეობით და დეტალურ ანალიზს იმის შესახებ, თუ როგორ იქცევა მეხსიერება მოდელის შექმნის, წინსვლის, უკუგადაცემის და ოპტიმიზატორის ნაბიჯების განმავლობაში, მათ შორის დიდი ენობრივი მოდელების (LLM) რეალურ სცენარებში.

Adyen-ისა და Hugging Face-ის DABstep: ხელოვნური ინტელექტის მოდელების გამოწვევა მონაცემთა ანალიზში
Adyen-მა და Hugging Face-მა ერთობლივად შექმნეს DABstep – ახალი ბენჩმარკი, რომელიც 450-ზე მეტ მონაცემთა ანალიზის ამოცანას მოიცავს. მისი მიზანია ხელოვნური ინტელექტის (AI) უახლესი მოდელების შესაძლებლობების შეფასება მრავალსაფეხურიან აზროვნებაში. კვლევამ აჩვენა, რომ მიუხედავად განვითარებისა, AI აგენტები DABstep-ზე მხოლოდ 16%-იან სიზუსტეს აღწევენ, რაც მიუთითებს ამ სფეროში მნიშვნელოვანი პროგრესის საჭიროებაზე. ბენჩმარკი მოითხოვს, რომ AI მოდელებმა გამოავლინონ ტექნიკური უნარები, დომენური ცოდნა და კრეატიულ

არაბული LLM ლიდერბორდების აღზევება: გამოწვევები და ინოვაციები
არაბულენოვანი დიდი ენობრივი მოდელების (LLM) მზარდი ხელმისაწვდომობის ფონზე, 2024 წელს დაიწყო რამდენიმე სპეციალიზებული ლიდერბორდის გაშვება, რომლებმაც მნიშვნელოვნად გააუმჯობესეს არაბული ხელოვნური ინტელექტის მოდელების შეფასება. ამ ინიციატივებმა, მათ შორის Open Arabic LLM Leaderboard (OALL), Balsam Index-მა და AraGen Leaderboard-მა, გადაჭრა არსებული გამოწვევები და სწრაფად მოიპოვა პოპულარობა, გახდა რა ცენტრალური პლატფორმები არაბული AI საზოგადოებისთვის. მათ ხაზი გაუსვეს არაბული ენის უნიკალური სირთულეებ
ობიექტის ამოცნობის ლიდერბორდი: მეტრული მაჩვენებლების გაგება და კრიტიკული შეფასება
Hugging Face Hub-მა გამოაქვეყნა ობიექტის ამოცნობის ლიდერბორდი, რომელიც აფასებს მოდელებს სხვადასხვა მეტრიკის საფუძველზე, როგორიცაა „კვეთა გაერთიანებაზე“ (IoU), „საშუალო სიზუსტე“ (AP) და „საშუალო გახსენება“ (AR). ეს ბლოგი დეტალურად განიხილავს მოდელების შეფასების მეთოდებს, განმარტავს გამოყენებულ მეტრიკას და მიზნად ისახავს შეფასებისას წარმოშობილი სირთულეების გამარტივებას, რათა მომხმარებლებს შეეძლოთ მოდელის მუშაობის კრიტიკულად შეფასება. ასევე ახსნილია ობიექტის ამოცნობის კონცეფცია, მისი აპლიკაციები და

ხელოვნური ინტელექტის აგენტების გაგება და გაუმჯობესება: ტრესინგი და შეფასება Arize Phoenix-ით
AI აგენტების შექმნა მხოლოდ დასაწყისია; მათი ქცევის გაგება და ოპტიმიზაცია გადამწყვეტია. ეს სტატია განმარტავს, თუ როგორ ეხმარება ტრესინგი და შეფასება აგენტების მუშაობის გაანალიზებაში, პრობლემების აღმოფხვრაში და ეფექტურობის უზრუნველყოფაში. Arize Phoenix წარმოადგენს ცენტრალიზებულ პლატფორმას ამ პროცესების რეალურ დროში განსახორციელებლად, OpenTelemetry-სა და OpenInference-თან ინტეგრაციით. განხილულია პრაქტიკული ნაბიჯები DuckDuckGo-ს საძიებო ხელსაწყოს მაგალითზე, სადაც LLM-ები, მაგალითად GPT-4o, გამოიყენე
LLM შეფასების კრიტიკული ხარვეზები DROP ბენჩმარკში: ნორმალიზაციისა და „გაჩერების ტოკენების“ პრობლემა
Open LLM Leaderboard-ზე DROP ბენჩმარკის დამატების შემდეგ, მოდელების f1-ქულებმა მოულოდნელად დაბალი შედეგები აჩვენა. გამოკვლევამ გამოავლინა ორი ძირითადი პრობლემა: არასწორი ნორმალიზაცია, რომელიც უგულებელყოფდა რიცხვით პასუხებს არასტანდარტული სიცარიელის სიმბოლოების გამო, და წერტილის (.) „გაჩერების ტოკენად“ გამოყენება. ამ ხარვეზების აღმოფხვრა, მათ შორის \n სიმბოლოზე დაყოფა, მნიშვნელოვნად აუმჯობესებს ქულების კორელაციას საერთო შესრულებასთან. თუმცა, სრული ხელახალი შეფასება ძვირი და შრომატევადია, რაც მიუთ
LLM-ის გასწორების ალგორითმების ემპირიული შეფასება: DPO, IPO და KTO
ეს პოსტი წარმოადგენს დიდი ენობრივი მოდელების (LLM) გასწორების სამი პერსპექტიული ალგორითმის — Direct Preference Optimization (DPO), Identity Preference Optimisation (IPO) და Kahneman-Tversky Optimisation (KTO) — ემპირიულ შეფასებას. მასში აღწერილია IPO-ს იმპლემენტაციის მნიშვნელოვანი კორექტირება TRL-ში, რის შემდეგაც IPO DPO-ს თანაბრად ეფექტური აღმოჩნდა და KTO-ს აჯობა შეწყვილებული უპირატესობის პარამეტრებში. შეფასება მოიცავს სხვადასხვა მოდელებსა და ჰიპერპარამეტრებს, რათა დადგინდეს საუკეთესო მიდგომები
DecodingTrust: LLM-ების სანდოობის შეფასების პლატფორმა და ახალი უსაფრთხოების ლიდერბორდი
2023 წელს Secure Learning Lab-მა წარმოადგინა DecodingTrust, პირველი ყოვლისმომცველი პლატფორმა დიდი ენობრივი მოდელების (LLM) სანდოობის შესაფასებლად. პლატფორმა მოიცავს რვა პერსპექტივას, მათ შორის ტოქსიკურობას, სტერეოტიპულ მიკერძოებას, კონფიდენციალურობასა და ეთიკას, და იყენებს ინოვაციურ „წითელი გუნდის“ (red-teaming) მეთოდოლოგიებს. ცოტა ხნის წინ, გამოქვეყნდა ახალი LLM უსაფრთხოების ლიდერბორდი, რომელიც LLM-ების უსაფრთხოების შეფასებაზეა ორიენტირებული.
ახალი LLM ლიდერბორდი რეალურ ბიზნეს სცენარებში ენის მოდელების შეფასებისთვის
ეს ლიდერბორდი მიზნად ისახავს ენის დიდი მოდელების (LLM) მუშაობის შეფასებას რეალური ბიზნეს ამოცანების კონტექსტში. ის მხარს უჭერს 6 მრავალფეროვან დავალებას, როგორიცაა FinanceBench და იურიდიული კონფიდენციალურობა, და ზომავს მოდელების ეფექტურობას ისეთი მეტრიკებით, როგორიცაა სიზუსტე, ჩართულობა და ტოქსიკურობა. ლიდერბორდი შემუშავდა იმისათვის, რომ დაეხმაროს მომხმარებლებს პრაქტიკული გამოყენებისთვის საუკეთესო მოდელის არჩევაში და აქტიურად ცდილობს თავიდან აიცილოს ტესტ-კომპლექტის დაბინძურება ზოგიერთი მონაცემთა
NPHardEval: ახალი დინამიური ჩარჩო დიდი ენობრივი მოდელების მსჯელობის უნარის შესაფასებლად
NPHardEval წარმოგიდგენთ ინოვაციურ, დინამიურ და სირთულეზე დაფუძნებულ ჩარჩოს დიდი ენობრივი მოდელების (LLMs) მსჯელობის უნარების მკაცრი შეფასებისთვის. ის მოიცავს 900 ალგორითმულ კითხვას NP-რთული სირთულის კლასიდან და ქვედა დონეებიდან, რომლებიც ყოველთვიურად განახლდება მოდელების ზედმეტი მორგების თავიდან ასაცილებლად. NPHardEval გამოირჩევა გამოთვლითი სირთულის კლასების გამოყენებით, რაც LLM-ის აზროვნების უნარების რაოდენობრივ და მტკიცე შეფასებას უზრუნველყოფს, რეალურ სამყაროში არსებული გამოწვევების ასახვით.

ScreenSuite: ახალი სტანდარტი GUI აგენტებისა და VLM-ების შეფასებაში
ბოლო კვირების განმავლობაში, ინტენსიური მუშაობის შედეგად, შევქმენით GUI აგენტების მუშაობის შეფასების უმსხვილესი ბენჩმარკინგ პლატფორმა – ScreenSuite. ეს არის ყველაზე ყოვლისმომცველი და მარტივი გზა Vision Language Models (VLM)-ების მრავალ აგენტურ შესაძლებლობაზე შესაფასებლად, რაც მიზნად ისახავს AI აგენტების ხელმისაწვდომობისა და ინტეგრაციის გაუმჯობესებას.
TTS Arena: მეტყველების სინთეზის მოდელების შეფასების დემოკრატიზაცია
მეტყველების სინთეზის სფეროში დიდი ხანია არ არსებობდა მოდელების ხარისხის ზუსტი გაზომვის მეთოდი. არსებული ობიექტური და სუბიექტური მეთოდები არაეფექტურია მსგავსი ხარისხის მოდელების შესადარებლად. ამ გამოწვევის საპასუხოდ, შეიქმნა TTS Arena, სადაც საზოგადოებას შეუძლია შეაფასოს სინთეზირებული აუდიო და დაეხმაროს მოდელების რანჟირების დემოკრატიზაციას. პლატფორმა იყენებს ადამიანის შეფასებას, მსგავსად Chatbot Arena-ისა, მოდელების ობიექტური შედარებისთვის.