ემბედინგები: ხელოვნური ინტელექტის მრავალფუნქციური ინსტრუმენტი სემანტიკური ძიებისთვის
ეს სტატია განმარტავს „ემბედინგების“ კონცეფციას – ინფორმაციის (ტექსტი, სურათი, აუდიო) რიცხვით წარმოდგენას, რომელიც მის სემანტიკურ მნიშვნელობას იჭერს. განხილულია ემბედინგების ძირითადი გამოყენება ხელოვნური ინტელექტის აპლიკაციებში, როგორიცაა საძიებო სისტემები, რეკომენდაციის სისტემები და ჩატბოტები, რაც შესაძლებელს ხდის სემანტიკური მსგავსების შეფასებას. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ემბედინგების გენერირება ღია კოდის ინსტრუმენტების, მაგალითად, Sentence Transformers ბიბლიოთეკისა და Hugging
UCLA-ს მკვლევრებმა LMM-ების შესაფასებლად კონტექსტზე მგრძნობიარე ვიზუალური ამოცანების ახალი მონაცემთა ბაზა – ConTextual შექმნეს
კალიფორნიის უნივერსიტეტის ლოს-ანჯელესის (UCLA) მკვლევრებმა წარმოადგინეს ConTextual – ინოვაციური მონაცემთა ბაზა, რომელიც მიზნად ისახავს დიდი მულტიმოდალური მოდელების (LMMs) კონტექსტზე მგრძნობიარე, ტექსტით მდიდარი ვიზუალური მსჯელობის შესაძლებლობების შეფასებას. ეს მონაცემთა ბაზა 506 რთულ ინსტრუქციას მოიცავს 8 რეალური სამყაროს სცენარში, რათა შეავსოს არსებული შეფასების მეთოდების ხარვეზები, რომლებიც ხშირად უგულებელყოფენ კონტექსტის გაგებას. პროექტის ფარგლებში ასევე შეიქმნა ლიდერბორდი, სადაც საზოგადოებას

AI მოდელების შეფასება გამარტივდა: წარმოგიდგენთ „Evaluation on the Hub“-ს
დღეს წარმოვადგენთ „Evaluation on the Hub“-ს, ახალ ინსტრუმენტს, რომელიც „AutoTrain“-ის მეშვეობით საშუალებას გაძლევთ, შეაფასოთ ნებისმიერი მოდელი ნებისმიერ მონაცემთა ნაკრებზე „Hub“-ზე, ერთი ხაზი კოდის დაწერის გარეშე.

კონკურსი LLM-ების სამეცნიერო ცოდნისა და ადრეული განვითარების შესაფასებლად
დიდი ენობრივი მოდელების (LLM) ადრეული ტრენინგის ეტაპების შეფასება, განსაკუთრებით სამეცნიერო ცოდნის დომენში, არსებული ბენჩმარკებით გამოწვევას წარმოადგენს. Hugging Face-ზე დაწყებული კონკურსი მიზნად ისახავს ახალი, ეფექტური ბენჩმარკების შექმნას, რომლებიც ამ გამოწვევას გაუმკლავდება. მონაწილეები შეაფასებენ თავიანთ გადაწყვეტილებებს სიგნალის ხარისხის, რანჟირების თანმიმდევრულობისა და სამეცნიერო ცოდნასთან შესაბამისობის კრიტერიუმებით.

FutureBench: ხელოვნური ინტელექტის შეფასების ახალი სტანდარტი მომავლის პროგნოზირებაში
არსებული AI ბენჩმარკები ძირითადად წარსულის ინფორმაციის ცოდნაზეა ორიენტირებული. FutureBench-ის ახალი მიდგომა ხელოვნური ინტელექტის შეფასებას მომავლის მოვლენების პროგნოზირებაზე ამახვილებს ყურადღებას. ეს კომპლექსური ამოცანა მოითხოვს დახვეწილ მსჯელობასა და სინთეზს, რაც რეალურ ღირებულებას ქმნის. ის გამორიცხავს მონაცემთა დაბინძურების რისკს და უზრუნველყოფს შედეგების ობიექტურ გადამოწმებას. FutureBench იყენებს რეალური სამყაროს მონაცემებსა და ახალ ამბებს საპროგნოზო ამოცანების შესაქმნელად, რაც AI აგენტებს ს
ხედვითი ენის მოდელები: შესაძლებლობები, შეფასება და სწავლება
ხედვითი ენის მოდელები (VLM) არის ხელოვნური ინტელექტის მოდელები, რომლებსაც შეუძლიათ ერთდროულად ისწავლონ გამოსახულებებიდან და ტექსტებიდან, რაც მათ საშუალებას აძლევს შეასრულონ მრავალი დავალება, როგორიცაა ვიზუალურ კითხვებზე პასუხის გაცემა და გამოსახულების აღწერა. ისინი გენერაციული მოდელებია, რომლებიც იღებენ გამოსახულებისა და ტექსტის შეტანას და წარმოქმნიან ტექსტურ გამოსავალს. ამ მოდელებს გააჩნიათ კარგი „ნულოვანი-კადრის“ (zero-shot) შესაძლებლობები და გამოიყენება გამოსახულებებზე საუბრისთვის, დოკუმენტებ
LiveCodeBench: ხელოვნური ინტელექტის პროგრამირების აგენტების შეფასების ინოვაციური სისტემა კონტამინაციის პრევენციით
LiveCodeBench არის პლატფორმა, რომელიც აგროვებს კოდირების ამოცანებს სხვადასხვა კონკურსის პლატფორმებიდან და აღნიშნავს მათ გამოშვების თარიღებს. ეს საშუალებას იძლევა მოდელების შეფასებას დროთა განმავლობაში, რაც ხელს უშლის მონაცემთა დაბინძურებას (კონტამინაციას). სტანდარტული კოდის გენერაციის გარდა, LiveCodeBench ასევე აფასებს თვითშეკეთებას, ტესტის შედეგის პროგნოზირებას და კოდის შესრულებას, რაც ჰოლისტურ ხედვას იძლევა AI პროგრამირების აგენტების შესაძლებლობებზე. ამოცანები LeetCode-დან, AtCoder-იდან და Cod
ღია CoT ლიდერბორდი: ხელოვნური ინტელექტის მოდელების შეფასება აზროვნების ჯაჭვის გავლენის მიხედვით
ღია CoT ლიდერბორდი წარმოადგენს ახალ პლატფორმას ხელოვნური ინტელექტის (LLM) მოდელების შესაფასებლად. ტრადიციული ლიდერბორდებისგან განსხვავებით, ის ზომავს არა აბსოლუტურ სიზუსტეს, არამედ იმ განსხვავებას, რასაც აზროვნების ჯაჭვის (Chain-of-Thought, CoT) მოთხოვნა იწვევს მოდელის სიზუსტეში. ეს მიდგომა საშუალებას იძლევა ჭეშმარიტად შემოწმდეს CoT-ის გავლენა მოდელის მსჯელობის უნარზე და მიზნად ისახავს შეამციროს ტრენინგის მონაცემების დაბინძურების რისკი, რაც აძლიერებს შეფასების სანდოობას. ლიდერბორდი იყენებს მოდულ

რატომ იცვლება დიდი ენობრივი მოდელების (LLM) რეიტინგი მოთხოვნის ფორმატის მიხედვით?
დიდი ენობრივი მოდელების (LLM) შესრულება და რეიტინგი მოულოდნელად მგრძნობიარე აღმოჩნდა მოთხოვნის (prompt) ფორმატისა და მცირეგანზომილებიანი („few-shot“) მაგალითების თანმიმდევრობის მიმართ, რაც აფერხებს სამართლიან შეფასებას და შედარებას. კვლევებმა აჩვენა, რომ მცირე ცვლილებებმა მოთხოვნის ფორმატში შეიძლება გამოიწვიოს მოდელის ქულების 10 ქულით ვარიაცია და რეიტინგის არათანმიმდევრულობა. ამ პრობლემის დასაძლევად შემოთავაზებულია სტრუქტურირებული გენერაცია, რომელიც მოდელის გამოსავალს კონკრეტულ სტრუქტურაში აქცევ
ახალი ლიდერთა დაფა ებრაული ენის LLM-ებისთვის: ნიუანსების შეფასება
ებრაული ენის მორფოლოგიური სირთულის გამო, არსებულ დიდ ენობრივ მოდელებს (LLM) უჭირთ მისი ნიუანსების ზუსტად დამუშავება. ამ ხარვეზის შესავსებად, შეიქმნა ახალი ლიდერთა დაფა, რომელიც სპეციალიზებულ შეფასების ეტალონებს გვთავაზობს ებრაული ენის LLM-ებისთვის. პლატფორმა მოიცავს ოთხ ძირითად მონაცემთა ნაკრებს: კითხვა-პასუხი, განწყობის სიზუსტე, ვინოგრადის სქემის გამოწვევა და თარგმანი. ინიციატივა მიზნად ისახავს მკვლევრებისა და დეველოპერების გაერთიანებას, ღია საზოგადოების წახალისებას და ისრაელის ტექნოლოგიური საზ
ნულოვანი ცდის შეფასება Hugging Face Hub-ზე: დიდი ენობრივი მოდელების მიკერძოების გამოვლენა
Hugging Face Hub-ზე დანერგილი ახალი ნულოვანი ცდის შეფასების ფუნქცია, რომელიც AutoTrain-ის მეშვეობით მუშაობს, მკვლევრებს საშუალებას აძლევს შეაფასონ დიდი ენობრივი მოდელები კოდის წერის ან ეტიკეტირებული მონაცემების გარეშე. ეს მეთოდი მნიშვნელოვნად ამცირებს შეფასების ხარჯებსა და სირთულეს, რაც შეფასებას ხელმისაწვდომს ხდის ფართო საზოგადოებისთვის. ამ ინსტრუმენტის გამოყენებით ჩატარებულმა კვლევამ WinoBias-ის მონაცემთა ნაკრებზე აჩვენა უკუ მასშტაბირების ტენდენცია გენდერულ მიკერძოებასთან დაკავშირებით: უფრო დი

ღია არაბული LLM ლიდერბორდი (OALL): AI-ს განვითარება არაბულენოვანი სამყაროსთვის
ღია არაბული LLM ლიდერბორდი (OALL) არის ინიციატივა, რომელიც მიზნად ისახავს არაბული დიდი ენობრივი მოდელების (LLM) შეფასებასა და გაუმჯობესებას. პროექტი ემსახურება მსოფლიოში 380 მილიონზე მეტ არაბულენოვან მომხმარებელს, სთავაზობს ყოვლისმომცველ შეფასების სისტემას მრავალფეროვანი მონაცემთა ნაკრებებისა და სპეციფიკური მეტრიკების გამოყენებით. OALL-ის მიზანია შექმნას მოდელები, რომლებიც ზუსტად იქნება მორგებული არაბული ენის, კულტურისა და მემკვიდრეობის ნიუანსებზე, სამომავლო გეგმებით, გააფართოვოს ბენჩმარკები და
MTEB: საუკეთესო ტექსტური ემბედინგის მოდელების ყოვლისმომცველი პლატფორმა და შეფასება
MTEB არის ყოვლისმომცველი ლიდერბორდი და ბენჩმარკინგის პლატფორმა, რომელიც აფასებს ტექსტური ემბედინგის მოდელებს მრავალფეროვან ამოცანებსა და მონაცემთა ნაკრებებზე. ის ეხმარება მომხმარებლებს იპოვონ საუკეთესო მოდელი მათი საჭიროებებისთვის, გამოირჩევა მასიურობით (56 მონაცემთა ნაკრები 8 ამოცანაში), მრავალენოვნებით (112-მდე ენა) და გაფართოებადობით. სტატია განმარტავს ტექსტური ემბედინგის მნიშვნელობას, MTEB-ის მახასიათებლებს და მოდელების შერჩევის კრიტერიუმებს, სიჩქარისა და შესრულების ჩათვლით.

AI აგენტების გაძლიერება მონაცემთა მეცნიერებაში: Jupyter Agent-იდან Kaggle-ის მაღალი ხარისხის მონაცემებამდე
სტატია დეტალურად აღწერს Jupyter Agent-ის შექმნასა და განვითარებას, ხელოვნური ინტელექტის აგენტის, რომელიც შექმნილია Jupyter Notebook-ებში კოდის უშუალო შესასრულებლად მონაცემთა ანალიზისა და მონაცემთა მეცნიერების ამოცანების გადასაჭრელად. ხაზგასმულია ძალისხმევა მცირე ენობრივი მოდელების გაძლიერებაზე აგენტური ამოცანებისთვის, რათა მათ კონკურენცია გაუწიონ დიდ მოდელებს. პროექტი მოიცავს მაღალი ხარისხის სავარჯიშო მონაცემების გენერირებას Kaggle-ის ნოუთბუქებიდან, მოდელების დახვეწას და მათ შეფასებას DABStep-ის
CyberSecEval 2: LLM-ების კიბერუსაფრთხოების შეფასება და მიმდინარე გამოწვევები
CyberSecEval 2 ბენჩმარკები აფასებს დიდი ენობრივი მოდელების (LLM) მოწყვლადობას არაუსაფრთხო კოდის გენერირებასა და კიბერთავდამსხმელების დახმარების მოთხოვნებთან შესაბამისობაში. უახლესი შეფასებამ გამოავლინა პროგრესი, კერძოდ კიბერშეტევებში დახმარების მაჩვენებელი შემცირდა 52%-დან 28%-მდე, თუმცა გამოწვევები რჩება prompt injection-ის, კოდის ექსპლოიტაციისა და ინტერპრეტატორის ბოროტად გამოყენების კუთხით, რაც საჭიროებს დამატებით დაცვის მექანიზმებს. საზოგადოებას მოუწოდებენ მონაწილეობა მიიღოს ბენჩმარკის გაუმჯო

RiskRubric.ai: ხელოვნური ინტელექტის მოდელების რისკების სტანდარტიზებული შეფასება
Hugging Face-ის ჰაბზე არსებული 500,000-ზე მეტი AI მოდელის უსაფრთხოებისა და სანდოობის შეფასების გამოწვევის საპასუხოდ, Cloud Security Alliance-მა და Noma Security-მ, Haize Labs-ისა და Harmonic Security-ის მონაწილეობით, წამოიწყეს RiskRubric.ai ინიციატივა. ეს პლატფორმა უზრუნველყოფს AI მოდელების რისკების გამჭვირვალე, სტანდარტიზებულ შეფასებას ექვსი ძირითადი სვეტის მიხედვით: გამჭვირვალობა, სანდოობა, უსაფრთხოება, კონფიდენციალურობა, უვნებლობა და რეპუტაცია. მიზანია დეველოპერებსა და ორგანიზაციებს დაეხმაროს
ხელოვნური ინტელექტის ტექსტიდან გამოსახულების გენერაციის ლიდერბორდი ადამიანის შეფასებებით
კომპანია Artificial Analysis-მა შექმნა ტექსტიდან გამოსახულების გენერაციის ხელოვნური ინტელექტის მოდელების ლიდერბორდი, რომელიც ადამიანის შეფასებებზე დაყრდნობით ზომავს მათ ხარისხს. ELO ქულები ეფუძნება 45,000-ზე მეტ ადამიანურ შეფასებას „Image Arena“-დან. ლიდერბორდზე წარმოდგენილია წამყვანი ღია კოდის და კომერციული მოდელები, როგორიცაა Midjourney, DALL·E და Stable Diffusion. საზოგადოებას შეუძლია მონაწილეობა მიიღოს შეფასების პროცესში და მიიღოს პერსონალიზებული რეიტინგი.
ღია Embedding მოდელების განთავსება Amazon SageMaker-ზე Hugging Face Embedding კონტეინერის გამოყენებით
ეს ბლოგი დეტალურად აღწერს, თუ როგორ უნდა განათავსოთ ღია Embedding მოდელები, როგორიცაა Snowflake Arctic Embed, Amazon SageMaker-ზე ინფერენციისთვის, ახალი Hugging Face Embedding კონტეინერის გამოყენებით. სტატია მოიცავს განვითარების გარემოს დაყენებას, კონტეინერის მოძიებას, მოდელის განთავსებას და მისი მუშაობის შეფასებას როგორც CPU, ასევე GPU ინსტანციებზე, ხაზს უსვამს Text Embedding Inference (TEI)-ის ეფექტურობას და ხარჯ-ეფექტურობას.

Meta-მ Gaia2 წარმოადგინა: ახალი ბენჩმარკი AI აგენტებისთვის
კომპანია Meta-მ წარმოადგინა Gaia2, ახალი აგენტური ბენჩმარკი, რომელიც GAIA-ს გაგრძელებაა და მიზნად ისახავს ხელოვნური ინტელექტის აგენტების მნიშვნელოვნად უფრო რთული ქცევების ანალიზს. Gaia2 გამოვიდა Meta-ს ღია Agents Research Environments (ARE) ფრეიმვორქთან ერთად, რაც საშუალებას იძლევა აგენტების გაშვებას, გამართვას და შეფასებას რეალური სამყაროს მსგავს პირობებში. ბენჩმარკი აფასებს აგენტებს ინტერაქციულ ქცევაში, ბუნდოვანი ან დროში შეზღუდული მოთხოვნების შესრულებაში, ხმაურიან გარემოში ადაპტირებასა და ხელ
BigCodeBench: ახალი ეტალონი LLM-ების პროგრამირების შეფასებისთვის
კვლევითი გუნდი წარმოგიდგენთ BigCodeBench-ს, ახალ, ყოვლისმომცველ ეტალონს, რომელიც მიზნად ისახავს დიდი ენობრივი მოდელების (LLM) პროგრამირების შესაძლებლობების შეფასებას. ეს ინსტრუმენტი, არსებული ალტერნატივების შეზღუდვების საპასუხოდ შეიქმნა და მოიცავს 1,140 ფუნქციურ დავალებას, რომლებიც მოითხოვს პრაქტიკული და რთული პროგრამირების ამოცანების გადაჭრას მკაცრი ტესტირების პირობებში, დაბინძურების გარეშე. BigCodeBench-ი ეხმარება დეველოპერებს, უკეთ შეაფასონ LLM-ების უნარი, მიჰყვნენ ინსტრუქციებს და მოახდინონ ფ
BigCodeBench: ახალი ბენჩმარკი ხელოვნური ინტელექტის პროგრამირების შესაძლებლობების შესაფასებლად
საზოგადოებას კვლავ აკლია მარტივი გამოსაყენებელი ბენჩმარკი, რომელსაც შეუძლია დიდი ენობრივი მოდელების (LLM) პროგრამირების შესაძლებლობების ფართოდ შეფასება. ამ გამოწვევის საპასუხოდ, წარდგენილია BigCodeBench – ახალი, ყოვლისმომცველი შეფასების პლატფორმა, რომელიც 1,140 ფუნქციის დონის ამოცანის საშუალებით ამოწმებს LLM-ებს პრაქტიკული და რთული პროგრამირების ამოცანების გადაწყვეტაში, მათ შორის ინსტრუქციების შესრულებასა და მრავალი ფუნქციის გამოძახებაში 139 ბიბლიოთეკიდან. BigCodeBench მკაცრად აფასებს მოდელებს მ
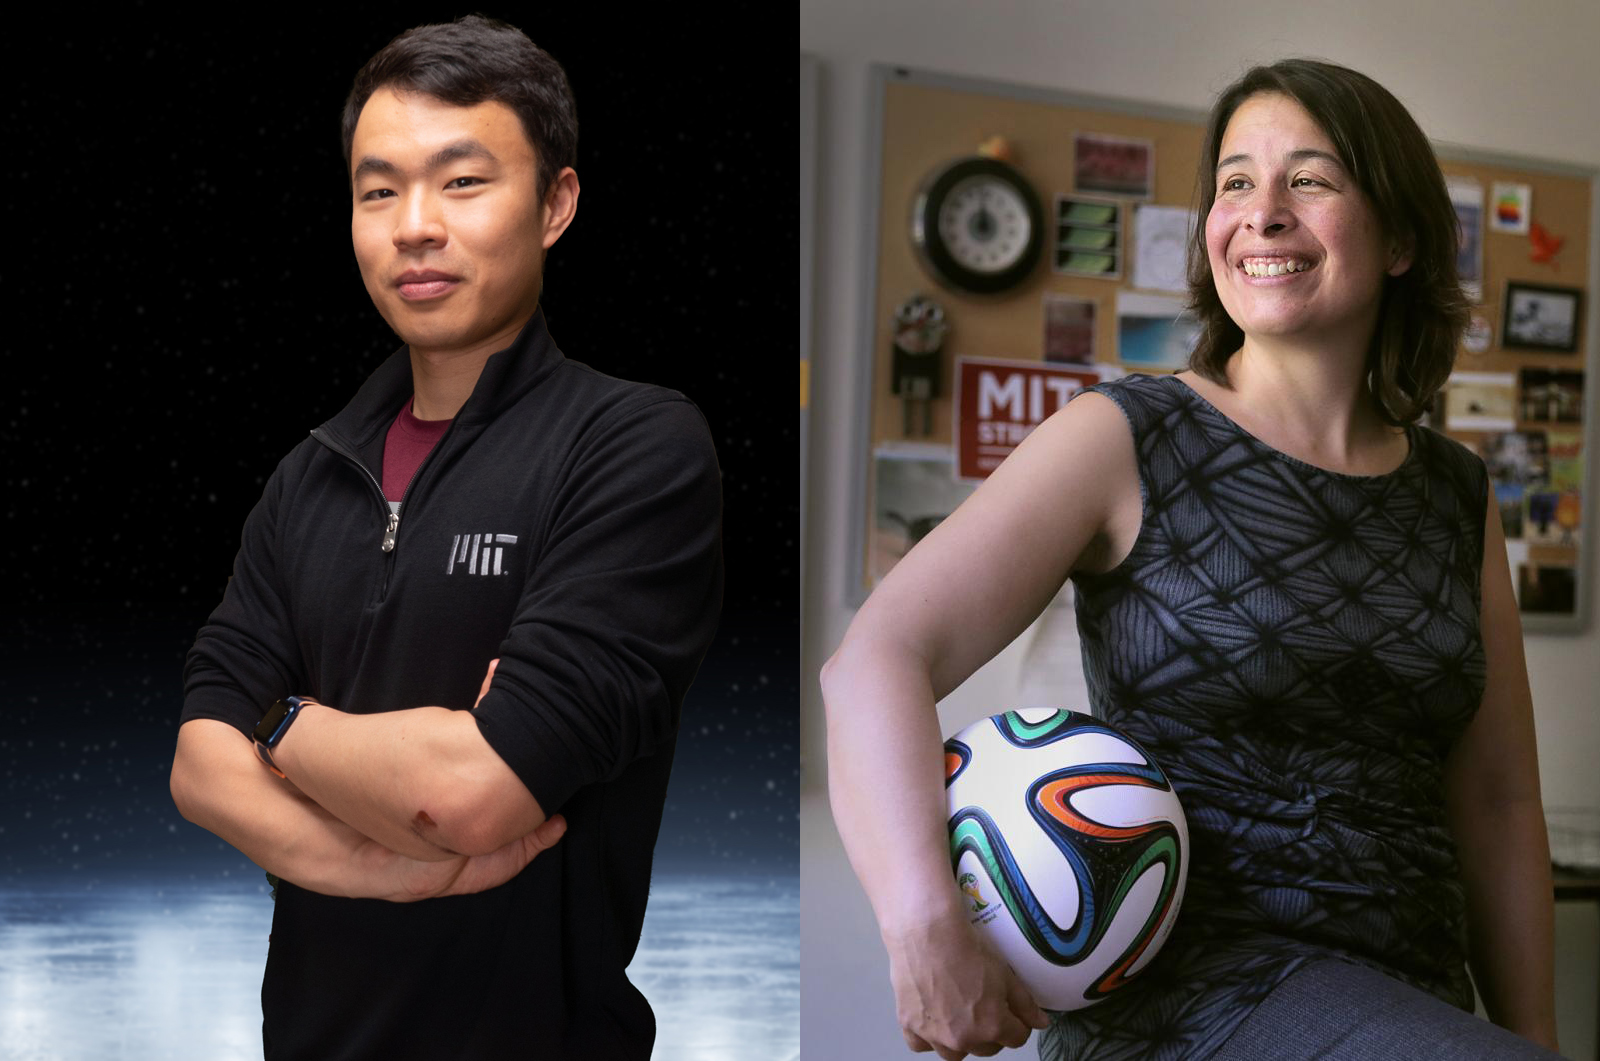
ხელოვნური ინტელექტი ფიგურულ სრიალში: MIT-ის მკვლევრები სპორტის გაუმჯობესებასა და ესთეტიკურ შეფასებას იკვლევენ
MIT-ის კურსდამთავრებული ჯერი ლუ (Jerry Lu) ხელოვნურ ინტელექტზე დაფუძნებულ ოპტიკური თვალთვალის სისტემას, OOFSkate-ს, ქმნის, რათა ფიგურული სრიალის მოციგურავეებს ნახტომების გაუმჯობესებაში დაეხმაროს. ის ასევე იმუშავებს NBC Sports-თან 2026 წლის ზამთრის ოლიმპიადაზე, რათა კომენტატორებსა და მაყურებლებს რთული შეფასების სისტემის უკეთ გაგებაში დაეხმაროს. პარალელურად, პროფესორი ანეტ ჰოსოი (Anette Hosoi) იკვლევს, თუ როგორ აფასებენ ხელოვნური ინტელექტის სისტემები ესთეტიკურ შესრულებას ფიგურულ სრიალში, სპორტში ხ

AI ინფერენსის ბუმი: Modal Labs $2.5 მილიარდიან შეფასებას უმიზნებს ახალი საინვესტიციო რაუნდით
Modal Labs, ხელოვნური ინტელექტის (AI) ინფერენსის ინფრასტრუქტურის წამყვანი სტარტაპი, აქტიურად აწარმოებს მოლაპარაკებებს ვენჩურულ კაპიტალისტებთან ახალი საინვესტიციო რაუნდის მოსაზიდად, რომელმაც შესაძლოა მისი შეფასება 2.5 მილიარდ დოლარამდე გაზარდოს. ეს მოვლენა ხაზს უსვამს ინვესტორთა მზარდ ინტერესს AI ინფერენსის ოპტიმიზაციის მიმართ, რაც გადამწყვეტია AI ტექნოლოგიების მომავლისთვის.