
Transformers ბიბლიოთეკა: ხელოვნური ინტელექტის მოდელების ინტეგრაციისა და სტანდარტიზაციის ახალი ეტაპი
Transformers, რომელიც 2019 წელს დაარსდა, გახდა ხელოვნური ინტელექტის მოდელების, განსაკუთრებით დიდი ენობრივი (LLM) და ვიზუალური ენობრივი (VLM) მოდელებთან მუშაობის სტანდარტული ბიბლიოთეკა Python ეკოსისტემაში. ის მხარს უჭერს 300-ზე მეტ არქიტექტურას, აქტიურად თანამშრომლობს სხვა ბიბლიოთეკებთან (როგორიცაა llama.cpp და MLX) თავსებადობის გასაუმჯობესებლად და მიზნად ისახავს წვლილის შეტანის ბარიერის შემცირებას ხელოვნური ინტელექტის საზოგადოებაში, რითაც ხელს უწყობს ეკოსისტემის სტანდარტიზაციას და ფრაგმენტაციის

წარმოგიდგენთ nanoVLM-ს: მარტივი გზა ვიზუალური ენის მოდელების შესაქმნელად
nanoVLM არის ხელსაწყოების ნაკრები, რომელიც შთაგონებულია Andrej Karpathy-ის nanoGPT-ით, მაგრამ შექმნილია ვიზუალური სფეროსთვის. ის საშუალებას გაძლევთ შექმნათ და გაავარჯიშოთ მოდელები, რომლებსაც შეუძლიათ გამოსახულებებისა და ტექსტის გაგება, შემდეგ კი ამის საფუძველზე ტექსტის გენერირება. პროექტი გამოირჩევა სიმარტივითა და კოდის წაკითხვადობით, რაც მას იდეალურს ხდის დამწყებთათვის. nanoVLM ძირითადად ფოკუსირებულია ვიზუალურ კითხვა-პასუხზე (Visual Question Answering) და აგებულია Google-ის SigLIP-ისა და Llama

დიდი ენობრივი მოდელების ოპტიმიზაცია Intel Xeon-ზე: StarCoder-ის აჩქარება კოდის გენერაციისთვის
სტატია მიმოიხილავს კოდის გენერაციის მოდელების, როგორიცაა StarCoder და Code Llama, მზარდ პოპულარობას და LLM-ების ოპტიმიზაციის ძალისხმევას ხელმისაწვდომობის გაზრდის მიზნით. ხაზგასმულია Intel-ის მიღწევა StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენციის აჩქარებაში მე-4 თაობის Intel Xeon პროცესორებზე, 8-ბიტიანი და 4-ბიტიანი კვანტიზაციის ინტეგრაციით ასისტირებულ გენერაციასთან ერთად. განხილულია Intel AMX-ის როლი, SmoothQuant-ისა და WOQ კვანტიზაციის ტექნიკები, ასევე პროდუქტიულობის შეფასებები HumanEval-ისა და M
დიდი ენობრივი მოდელების (LLMs) მაღალეფექტური განთავსება: TGI და AWS Inferentia2 Amazon SageMaker-ში
ტექსტის გენერირების ინფერენცია (TGI) წარმოადგენს სპეციალურად შექმნილ გადაწყვეტას დიდი ენობრივი მოდელების (LLMs) მასშტაბური განთავსებისა და სერვისისთვის. TGI უზრუნველყოფს მაღალეფექტურ ტექსტის გენერაციას Tensor Parallelism-ისა და უწყვეტი დაჯგუფების გამოყენებით Llama-ს, Mistral-ის და სხვა პოპულარული ღია LLM-ებისთვის. AWS Inferentia2-თან ინტეგრაცია Amazon SageMaker-ში TGI-ს აქცევს მძლავრ ალტერნატივად GPU-ებისთვის LLM აპლიკაციების შესაქმნელად. ეს ინტეგრაცია ამარტივებს მოდელების განთავსებას და შენარჩუ

Dell Enterprise Hub: ხელოვნური ინტელექტის გადაწყვეტილებების სრული ეკოსისტემა საწარმოებისთვის
Dell Enterprise Hub აფართოებს ხელოვნური ინტელექტის გადაწყვეტილებების სპექტრს, სთავაზობს ოპტიმიზებულ მოდელებს (Meta Llama 4, Google Gemma 3) და მზა აპლიკაციებს Dell-ის AI სერვერებისა და AI კომპიუტერებისთვის. პლატფორმა უზრუნველყოფს სწრაფ, ადგილობრივ განთავსებას Docker-ის, Kubernetes-ის და ახალი Dell Pro AI Studio-ს მეშვეობით, ასევე წარმოგიდგენთ `dell-ai` ღია კოდის ბიბლიოთეკას, რაც საწარმოებს საშუალებას აძლევს, ეფექტურად ინტეგრირდნენ გენერაციულ ხელოვნურ ინტელექტთან.
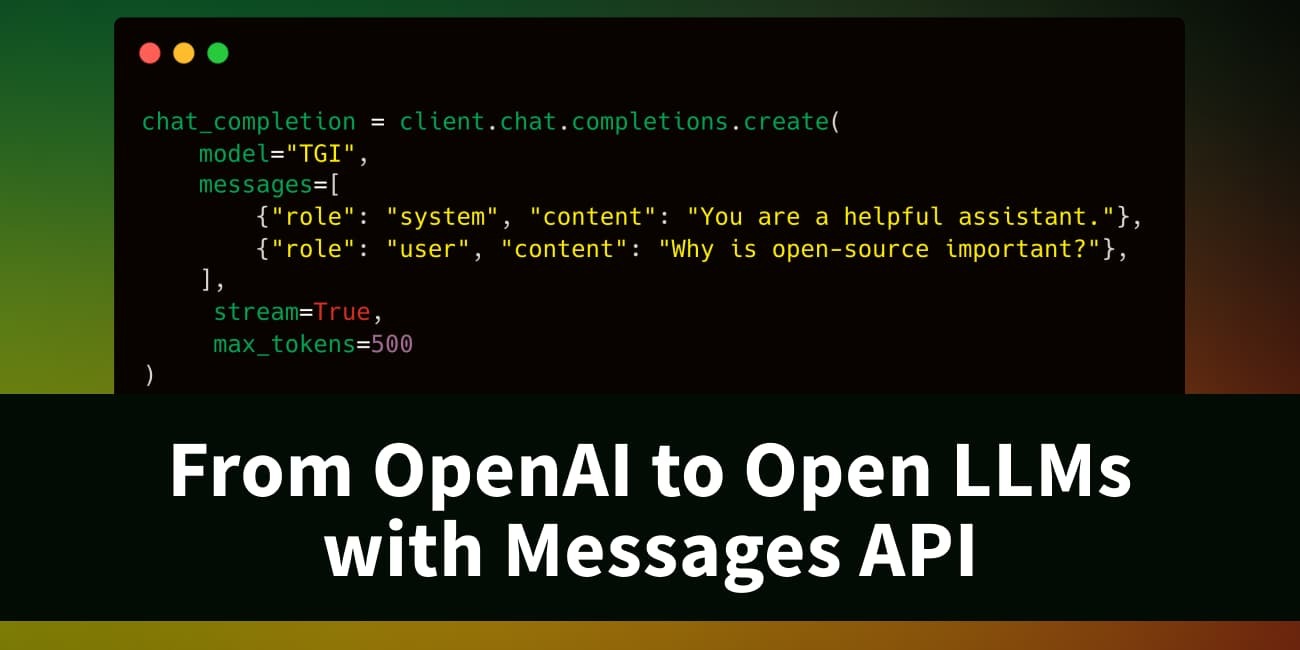
TGI-ის Messages API: OpenAI-თან თავსებადობა და შეუფერხებელი გადასვლა ღია LLM-ებზე
TGI-ის (Text Generation Inference) ვერსია 1.4.0-დან დაწყებული, ხელმისაწვდომია ახალი Messages API, რომელიც სრულად თავსებადია OpenAI-ის Chat Completion API-სთან. ეს ინოვაცია მომხმარებლებს საშუალებას აძლევს, მარტივად და შეუფერხებლად გადავიდნენ OpenAI-ის მოდელებიდან ღია დიდ ენობრივ მოდელებზე (LLM). API შეიძლება გამოყენებულ იქნას OpenAI-ის კლიენტის ბიბლიოთეკებთან ან მესამე მხარის ხელსაწყოებთან, როგორიცაა LangChain და LlamaIndex. Messages API ასევე ხელმისაწვდომია Hugging Face-ის Inference Endpoints-ზე
TGI-ის Messages API: უწყვეტი გადასვლა ღია LLM-ებზე OpenAI-ის თავსებადობით
TGI (Text Generation Inference) 1.4.0 ვერსიიდან მოყოლებული, გთავაზობთ Messages API-ს, რომელიც სრულად თავსებადია OpenAI-ის Chat Completion API-თან. ეს ინოვაცია მომხმარებლებს საშუალებას აძლევს, მარტივად და შეუფერხებლად გადავიდნენ OpenAI-ის მოდელებიდან ღია დიდი ენის მოდელებზე (LLM-ებზე), არსებული კლიენტის ბიბლიოთეკების ან მესამე მხარის ხელსაწყოების (როგორიცაა LangChain და LlamaIndex) გამოყენებით. სტატია დეტალურად აღწერს მოდელების Hugging Face Inference Endpoints-ზე განთავსების, ტექნიკური კონფიგურაც
ტექსტის გენერაციის პაიპლაინი Intel® Gaudi® 2-ზე: მოქნილობა და Llama 2-ის ინტეგრაცია
წარმოდგენილია პერსონალური პაიპლაინის კლასი, რომელიც შექმნილია Intel® Gaudi® 2 AI აქსელერატორისთვის, რაც უზრუნველყოფს ტექსტის გენერაციის მოქნილობას, სიმარტივეს და აბსტრაქციის მაღალ დონეს. ის მხარს უჭერს Llama 2 მოდელებს და ინტეგრირდება LangChain-თან, რაც მომხმარებლებს საშუალებას აძლევს მარტივად შექმნან ტექსტი, როგორც სტანდარტული სკრიპტებით, ასევე საკუთარ პროექტებში. სტატია დეტალურად აღწერს წვდომის მიღების, ინსტალაციისა და გამოყენების ნაბიჯებს, ასევე Llama 2-ის ლიცენზირების მნიშვნელოვან დეტალებს.

Gemma 3n: მულტიმოდალური AI მოდელი საბოლოოდ ღია კოდის ბიბლიოთეკებში
Google-ის უახლესი მულტიმოდალური AI მოდელი, Gemma 3n, საბოლოოდ ხელმისაწვდომია ყველაზე პოპულარულ ღია კოდის ბიბლიოთეკებში, მათ შორის transformers & timm, MLX, llama.cpp და სხვებში. ეს გამოშვება მოიცავს ორ ზომას (E2B და E4B), რომლებიც გამოირჩევიან მაღალი ეფექტურობით VRAM-ის გამოყენების მხრივ და უზრუნველყოფენ შესანიშნავ ხარისხს. Gemma 3n არა მხოლოდ ენობრივ დეკოდერს, არამედ აუდიო და ვიზუალურ ენკოდერებსაც მოიცავს, რაც მას სრულყოფილ მულტიმოდალურ ინსტრუმენტად აქცევს დეველოპერებისთვის. სტატია დეტალურად აღ

NVIDIA-ს Llama Nemotron Nano VL: რევოლუცია ინტელექტუალური დოკუმენტების დამუშავებაში
NVIDIA-მ წარმოადგინა Llama Nemotron Nano VL, 8 მილიარდპარამეტრიანი ხედვითი ენის მოდელი (VLM), რომელიც განკუთვნილია ინტელექტუალური დოკუმენტების დამუშავებისთვის (IDP). მოდელი გამოირჩევა მაღალი სიზუსტით და მულტიმოდალური გაგებით, რაც საშუალებას აძლევს მას ეფექტურად მოიპოვოს და გაიგოს ინფორმაცია კომპლექსური დოკუმენტებიდან, როგორიცაა ინვოისები, ქვითრები, კონტრაქტები, PDF ფაილები, სურათები და დიაგრამები. Llama Nemotron Nano VL აჩვენებს ინდუსტრიაში წამყვან შედეგებს OCRBench v2 ბენჩმარკზე, რაც უზრუნველყო
Hugging Face-ი და NVIDIA-ი „ტრენინგს DGX Cloud-ზე“ უშვებენ Enterprise Hub-ის ორგანიზაციებისთვის
Hugging Face-მა NVIDIA-სთან ერთად წარადგინა „ტრენინგი DGX Cloud-ზე“, ახალი სერვისი Hugging Face Hub-ზე, რომელიც განკუთვნილია Enterprise Hub-ის ორგანიზაციებისთვის. ეს პლატფორმა მომხმარებლებს აძლევს მყისიერ წვდომას NVIDIA H100 Tensor Core GPU-ებზე, რათა მარტივად დახვეწონ პოპულარული გენერაციული AI მოდელები, როგორიცაა Llama, Mistral და Stable Diffusion. სერვისი ამარტივებს ხელოვნური ინტელექტის მოდელების წვრთნის პროცესს კოდის გარეშე მუშაობის (no-code) და მოხმარების მიხედვით გადახდის (pay-as-you-go) მო
Hugging Face-ი NVIDIA-სთან პარტნიორობით „Train on DGX Cloud“ სერვისს უშვებს Enterprise Hub ორგანიზაციებისთვის
Hugging Face-ი, NVIDIA-სთან ერთად, წარმოგიდგენთ „Train on DGX Cloud“-ს – ახალ სერვისს, რომელიც ხელმისაწვდომია Enterprise Hub ორგანიზაციებისთვის Hugging Face Hub-ზე. ეს პლატფორმა ამარტივებს ღია მოდელების გამოყენებას NVIDIA DGX Cloud-ის მაღალსიჩქარიან გამოთვლით ინფრასტრუქტურასთან. სერვისი მომხმარებლებს აძლევს მყისიერ წვდომას უახლეს NVIDIA H100 Tensor Core GPU-ებზე, რაც მათ საშუალებას აძლევს, მარტივად დააზუსტონ პოპულარული გენერაციული AI მოდელები, როგორიცაა Llama, Mistral და Stable Diffusion. „Train

GaLore: გარღვევა ხელოვნური ინტელექტის მოდელების ვარჯიშში სამომხმარებლო GPU-ებზე
GaLore-ის ინოვაციური შესაძლებლობა, ავარჯიშოს 7 მილიარდ პარამეტრამდე ხელოვნური ინტელექტის მოდელები, როგორიცაა Llama არქიტექტურაზე დაფუძნებული მოდელები, სამომხმარებლო GPU-ებზე (მაგალითად, NVIDIA RTX 4090), წარმოადგენს მნიშვნელოვან გარღვევას. ეს მიიღწევა ოპტიმიზატორის მდგომარეობებისა და გრადიენტებისთვის საჭირო მეხსიერების მოთხოვნების მკვეთრი შემცირებით, დაბალი რანგის პროექციისა და 8-ბიტიანი სიზუსტის ოპტიმიზატორების კომბინაციით, რაც დიდ მოდელებს უფრო ხელმისაწვდომს ხდის ფართო მომხმარებლისთვის და ზღვა

SmolLM3: მაღალი წარმადობა 3 მილიარდ პარამეტრზე და ინოვაციური საინჟინრო გეგმა
ახალი 3 მილიარდპარამეტრიანი ენობრივი მოდელი, SmolLM3, აჭარბებს კონკურენტებს, როგორიცაა Llama-3.2-3B და Qwen2.5-3B, ამასთანავე, კონკურენტუნარიანია უფრო დიდ 4 მილიარდპარამეტრიან მოდელებთან (Qwen3 და Gemma3). მისი შემქმნელები სრულად აქვეყნებენ მოდელის შექმნის მეთოდოლოგიას, არქიტექტურულ დეტალებს, მონაცემთა ნარევებსა და სამსაფეხურიან წინასწარი ვარჯიშის სტრატეგიას. ეს გამჭვირვალე მიდგომა, რომელიც მოიცავს ისეთ ინოვაციებს, როგორიცაა Grouped Query Attention (GQA) და NoPE, მიზნად ისახავს AI საზოგადოებისთვ
SmolLM3: ოპტიმალური ეფექტურობის 3B მოდელი სრული საინჟინრო პროექტით
SmolLM3-ის 3 მილიარდი პარამეტრის მოდელი აღემატება Llama-3.2-3B და Qwen2.5-3B მოდელებს, ამავდროულად ინარჩუნებს კონკურენტუნარიანობას უფრო დიდ 4B ალტერნატივებთან (Qwen3 და Gemma3). მისი უნიკალურობა მდგომარეობს იმაში, რომ დეველოპერები სრულად აქვეყნებენ მოდელის შექმნის მეთოდოლოგიას – არქიტექტურის დეტალებს, მონაცემთა შერევის მეთოდებსა და სამეტაპიან წინასწარ ვარჯიშის მიდგომას, რაც ჩვეულებრივ თვეების უკუინჟინერიას მოითხოვდა. არქიტექტურული ინოვაციები მოიცავს Grouped Query Attention (GQA), NoPE პოზიციური

AI-ის ეფექტურობის რევოლუცია: Hugging Face და AMD Llama 3.1-ს MI300X-ზე აუმჯობესებენ
ყოველდღიურად მილიარდობით AI მოთხოვნის დამუშავება, როგორიცაა ChatGPT-ის მიერ, მოდელის ოპტიმიზაციას გადამწყვეტ მნიშვნელობას ანიჭებს. განსაკუთრებით კრიტიკულია ბირთვის (kernel) დონის ოპტიმიზაცია, რაც ხშირად უგულებელყოფილია მრავალი მოწყობილობისთვის, განსაკუთრებით AMD GPU-ებისთვის. Hugging Face-მა AMD-სთან ითანამშრომლა, რათა შეემუშავებინა ღია წყაროს ოპტიმიზებული ბირთვები Llama 3.1 405B მოდელის მუშაობის გასაუმჯობესებლად FP8 ფორმატში, 8 MI300X GPU-ით აღჭურვილ კვანძზე, VLLM-ის გამოყენებით. ეს პარტნიორობა
Hugging Face-ისა და AMD-ის გარღვევა AI მოდელების ოპტიმიზაციაში MI300X-ზე
Hugging Face-მა და AMD-მ ითანამშრომლეს, რათა მნიშვნელოვნად გაეუმჯობესებინათ ხელოვნური ინტელექტის მოდელების, კერძოდ Llama 3.1 405B-ის ინფერენსის შესრულება AMD MI300X GPU-ებზე. პროექტი ფოკუსირებულია დაბალი დონის კერნელების ოპტიმიზაციაზე, რაც გადამწყვეტია მილიარდობით პარამეტრის მქონე მოდელებისთვის. ამ თანამშრომლობის შედეგად შეიქმნა ღია კოდის მორგებული კერნელები, რომლებმაც მნიშვნელოვანი სიჩქარის ზრდა აჩვენეს, განსაკუთრებით AMD-ის აპარატურისთვის, რომელიც ხშირად იგნორირებულია კერნელის დეველოპერების მი

ეტინი: უახლესი ენკოდერ-დეკოდერ მოდელები, რომლებიც Llama 3.2 1B-ს და SmolLM2-ს აღემატებიან
რა მოხდებოდა, ModernBERT-ის რეცეპტი მხოლოდ დეკოდერის მოდელზე რომ გამოგვეყენებინა? აღმოჩნდა, რომ შეიქმნებოდა უახლესი დეკოდერული ენის მოდელი, რომელიც Llama 3.2 1B-სა და SmolLM2-ს ჯობნის. ჩვენ წარმოგიდგენთ Ettin-ს, უახლესი, დაწყვილებული მხოლოდ-ენკოდერისა და მხოლოდ-დეკოდერის მოდელების პირველ სერიას (17M-1B პარამეტრი), რომლებიც გაწვრთნილია იდენტური მონაცემებით (2T ტოკენი), არქიტექტურითა და წვრთნის რეცეპტებით. Ettin შესაძლებელს ხდის არქიტექტურებს შორის სამართლიან შედარებებს და უზრუნველყოფს უმაღლეს შეს
Meta-მ Llama 3 გამოუშვა: ღია ხელმისაწვდომობის ხელოვნური ინტელექტის ახალი თაობა
Meta-მ გამოუშვა Llama 3, ღია წვდომის Llama ოჯახის შემდეგი თაობა, რომელიც ხელმისაწვდომია Hugging Face-ზე. ახალი მოდელი, რომელიც ორი ზომის (8B და 70B) ვარიანტებითაა წარმოდგენილი (როგორც საბაზისო, ისე ინსტრუქციებზე მორგებული), აგრძელებს Meta-ს ერთგულებას ღია AI-ის მიმართ. მნიშვნელოვანი სიახლეები მოიცავს გაფართოებულ 128K ლექსიკონის მქონე ტოკენაიზერს, 8K ტოკენის კონტექსტის სიგრძეს, 8B ვერსიაში Grouped-Query Attention-ის გამოყენებას და Llama Guard 2-ის გამოშვებას უსაფრთხო შინაარსის კლასიფიკაციისთვის.

NVIDIA-ის AI-Q Blueprint ლიდერთა დაფაზე: ღია კოდის AI-ს ტრიუმფი DeepResearch Bench-ზე
NVIDIA-ის AI-Q Blueprint, წამყვანი პორტატული, ღია სიღრმისეული კვლევითი აგენტი, პირველ ადგილზე გავიდა Hugging Face-ის „LLM ძიებით“ ლიდერთა დაფის სათავეში DeepResearch Bench-ზე. ეს მიღწევა ადასტურებს, რომ დეველოპერებისთვის ხელმისაწვდომ მოდელებს შეუძლიათ უზრუნველყონ მოწინავე აგენტური სამუშაო პროცესები, რომლებიც კონკურენციას უწევს ან აღემატება დახურულ ალტერნატივებს გამჭვირვალობისა და კონტროლის შენარჩუნებით. AI-Q აერთიანებს ორ მაღალპროდუქტიულ Llama 3.3 LLM-ს, რაც უზრუნველყოფს გრძელკონტექსტურ ინფორმაც
StarCoder2-15B-Instruct: ახალი ეტალონი კოდის ხელოვნური ინტელექტისთვის თვით-განვითარების გზით
ახალი ენა-მოდელი, StarCoder2-15B-Instruct, აჩვენებს გასაოცარ შედეგებს კოდის გენერაციაში, უსწრებს ისეთ მძლავრ მოდელებს, როგორიცაა CodeLlama-70B-Instruct და აღწევს 72.6 HumanEval ქულას. მისი წარმატების საიდუმლო თვით-მორგების (self-alignment) ინოვაციურ მეთოდოლოგიაში მდგომარეობს, რაც საშუალებას აძლევს მოდელს ეფექტურად ისწავლოს საკუთარი გენერირებული მონაცემებიდან, ძლიერი „მასწავლებელი“ მოდელების გამოყენების გარეშე. ეს მიდგომა გულისხმობს ინსტრუქციების თვით-გენერირებას და საკუთარი კოდის ტესტირებას, რაც
Transformers Agents 2.0-ის გამოშვება: ახალი ეტაპი AI აგენტებში smolagents-თან ერთად
Hugging Face-ი აცხადებს Transformers Agents 2.0-ის გამოშვებას, რომელიც ახლა smolagents-ის სახელით იქნება ცნობილი. ეს განახლება წარმოგიდგენთ ორ ახალ აგენტს, რომლებსაც შეუძლიათ წარსული დაკვირვებების საფუძველზე რთული ამოცანების გადაჭრა. სისტემა გამიზნულია იყოს მკაფიო, მოდულარული და გამჭვირვალე, თემის გაზიარების ოფციებით. აღსანიშნავია მისი გაუმჯობესებული წარმადობა, რადგან Llama-3-70B-Instruct აგენტი აჯობებს GPT-4-ზე დაფუძნებულ აგენტებს GAIA-ს ლიდერთა სიაში. LLM-ებს ხშირად უჭირთ ლოგიკის, გამოთვლისა დ
„Transformers Agents 2.0“-ის (ახლა უკვე smolagents!) გამოშვება: აგენტების ახალი, მძლავრი ჩარჩო
Hugging Face-ი აცხადებს „Transformers Agents 2.0“-ის გამოშვებას, რომელიც ახლა დამოუკიდებელი ბიბლიოთეკა smolagents-ის სახით არის ხელმისაწვდომი. ეს განახლება წარმოგიდგენთ აგენტების ახალ ტიპებს, რომლებსაც შეუძლიათ წარსული დაკვირვებების საფუძველზე იტერაცია მოახდინონ რთული ამოცანების გადასაჭრელად, გამოირჩევიან გაუმჯობესებული შესრულებით (Llama-3-70B-Instruct აგენტები GPT-4-ზე უკეთეს შედეგებს აჩვენებენ GAIA Leaderboard-ზე) და აქცენტი კეთდება კოდის სიცხადეზე, მოდულარულობაზე და საზოგადოების ჩართულობაზე გ

Hugging Face-ი და AMD ხელოვნური ინტელექტის განვითარებას AMD Instinct MI300 GPU-ების ინტეგრაციით აძლიერებენ
Hugging Face-ი და AMD აცხადებენ თანამშრომლობის გაფართოებას უახლესი თაობის AMD Instinct MI300 GPU სერვერების Hugging Face პლატფორმაში სრულფასოვანი ინტეგრაციის მიზნით. ეს ნაბიჯი დეველოპერებს საშუალებას მისცემს, მარტივად განათავსონ და მაქსიმალური წარმადობით გამოიყენონ ხელოვნური ინტელექტის მოდელები, კოდის შეცვლის გარეშე, ადგილობრივი გარემოდან დაწყებული Azure-ის საწარმოო ვირტუალურ მანქანებამდე. ინტეგრაცია მოიცავს CI/CD-ის გაუმჯობესებას, TGI-ის (text-generation-inference) ოპტიმიზაციას Meta Llama ოჯახი