
HELMET: ყოვლისმომცველი ბენჩმარკი გრძელკონტექსტური ენობრივი მოდელების შესაფასებლად
HELMET, რომელიც გასულ ოქტომბერს გამოვიდა, გახდა პოპულარული ინსტრუმენტი გრძელკონტექსტური ენობრივი მოდელების (LCLM) შესაფასებლად, რომელსაც იყენებენ ისეთი კომპანიები, როგორებიცაა Microsoft და AI21. მუდმივად განვითარებადი LCLM-ების გათვალისწინებით, HELMET გთავაზობთ ახალ, გაფართოებულ შეფასების მეთოდებს, რომლებიც წარმოდგენილი იქნება ICLR 2025-ზე. ეს ბენჩმარკი მიზნად ისახავს გადაჭრას არსებული შეფასების მეთოდების ნაკლოვანებები, უზრუნველყოფს მოდელების მრავალფეროვან, კონტროლირებად და საიმედო შედარებას რეა
მეგ მიტჩელი ხელოვნური ინტელექტის ეთიკაზე: მონაცემთა მიკერძოებიდან ინკლუზიურ კულტურამდე
ამ ინტერვიუში დოქტორი მარგარეტ (მეგ) მიტჩელი საუბრობს იმ მომენტზე, როდესაც მან გააცნობიერა ეთიკური ხელოვნური ინტელექტის (AI) მნიშვნელობა. ის იზიარებს თავის გამოცდილებას მონაცემთა მავნე მიკერძოებასთან დაკავშირებით, რომელსაც მანქანური სწავლების (ML) გუნდები ხშირად აწყდებიან, და განმარტავს ინკლუზიისა და მრავალფეროვნების სარგებელს AI სისტემების შემუშავებაში. მეგი აღწერს თავის კარიერულ გზას Microsoft-დან Google-მდე, სადაც მან დააარსა ეთიკური AI-ს გუნდი, და შემდეგ Hugging Face-მდე. ის განიხილავს ისეთ

Microsoft Azure-ი Hugging Face-თან თანამშრომლობას აფართოებს: 10,000-ზე მეტი AI მოდელი Azure AI Foundry-ზე
Microsoft-მა და Hugging Face-მა გააფართოვეს სტრატეგიული თანამშრომლობა, რის შედეგადაც Azure AI Foundry-ზე 10,000-ზე მეტი Hugging Face-ის ღია მოდელი გახდა ხელმისაწვდომი. ეს ინიციატივა დეველოპერებსა და საწარმოებს საშუალებას აძლევს, მარტივად განათავსონ AI აპლიკაციები ტექსტთან, აუდიოსთან და გამოსახულებებთან სამუშაოდ, ღია კოდის გამჭვირვალობისა და Azure-ის უსაფრთხო, საწარმოო დონის ინფრასტრუქტურის გამოყენებით. თანამშრომლობა მიზნად ისახავს AI-ის ინოვაციის დაჩქარებას და ორგანიზაციებს საკუთარი AI ბედის კონ
კოსმოპედია: უპრეცედენტო სინთეზური მონაცემები დიდი ენობრივი მოდელებისთვის
სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) წვრთნისთვის ძვირადღირებული ადამიანური ანოტაციებიდან სინთეზურ მონაცემთა ნაკრებებზე გადასვლას. მიუხედავად იმისა, რომ Microsoft-ის Phi მოდელებმა სინთეზური მონაცემების გამოყენებით შესანიშნავი შედეგები აჩვენეს, მათი შექმნის დეტალები გაუმჟღავნებელი დარჩა. ამ ხარვეზის აღმოსაფხვრელად, წარმოდგენილია კოსმოპედია – უმსხვილესი ღია სინთეზური მონაცემთა ნაკრები (30 მილიონზე მეტი ფაილი, 25 მილიარდი „ტოკენი“), რომელიც გენერირებულია Mixtral-8x7B-Instruct-v0.1-ის მიერ

როგორ გავუშვათ მოწინავე LLM-ები ჩვეულებრივ ლეპტოპზე?
ოდესღაც შეუძლებლად მიჩნეული მაღალეფექტური დიდი ენობრივი მოდელების (LLM) გაშვება ჩვეულებრივ პერსონალურ კომპიუტერებზე დღეს უკვე რეალობაა. სტატია იკვლევს, თუ როგორ ხდის თანამედროვე ტექნოლოგიები, როგორიცაა აპარატურის აჩქარება (მათ შორის Intel Meteor Lake-ის NPU), მცირე ენობრივი მოდელები (SLM) და კვანტიზაცია, შესაძლებელს ამ მიღწევას. განხილულია Microsoft-ის Phi-2 მოდელისა და Intel OpenVINO-ს ინტეგრაციის გამოყენება Intel Core Ultra პროცესორზე, რათა LLM-ები ეფექტურად იმუშაოს საშუალო დონის ლეპტოპებზე.
როგორ გავუშვათ მოწინავე ხელოვნური ინტელექტის მოდელები ჩვეულებრივ ლეპტოპებზე?
თანამედროვე დიდი ენობრივი მოდელები (LLM) ძლიერ აპარატურას მოითხოვს, რაც ხელმისაწვდომი ლეპტოპებისთვის გამოწვევას წარმოადგენს. თუმცა, ხელოვნური ინტელექტის საზოგადოება აქტიურად მუშაობს მოდელების ზომის შემცირებაზე და მათ ოპტიმიზაციაზე. ამ მიზნის მისაღწევად გამოიყენება სამი ძირითადი მიდგომა: აპარატურული აჩქარება (მათ შორის Intel-ის ახალი NPU), მცირე ენობრივი მოდელები (SLM) და კვანტიზაცია. ამ სტატიაში განხილულია, თუ როგორ შეიძლება Microsoft Phi-2 მოდელის 4-ბიტიანი კვანტიზაცია Intel OpenVINO-სა და Opti

Consilium: ხელოვნური ინტელექტის მოდელების თანამშრომლობა კონსენსუსისთვის
Consilium წარმოადგენს ინოვაციურ პლატფორმას, რომელიც დიდ ენობრივ მოდელებს (LLM) აძლევს საშუალებას, მიაღწიონ კონსენსუსს დისკუსიის გზით. ჰაკათონის ფარგლებში შექმნილი პროექტი აერთიანებს Gradio ინტერფეისს და MCP სერვერს, რაც LLM-ებს საშუალებას აძლევს ითანამშრომლონ, შექმნან დასაბუთებული პასუხები და მიიღონ გადაწყვეტილებები. პლატფორმა ვიზუალურად წარმოადგენს მრგვალ მაგიდას, სადაც მოდელები დისკუსიას აწარმოებენ, ხოლო Microsoft-ის AI Diagnostic Orchestrator-ის მიერ მიღწეული შედეგები ადასტურებს, რომ მრავალი
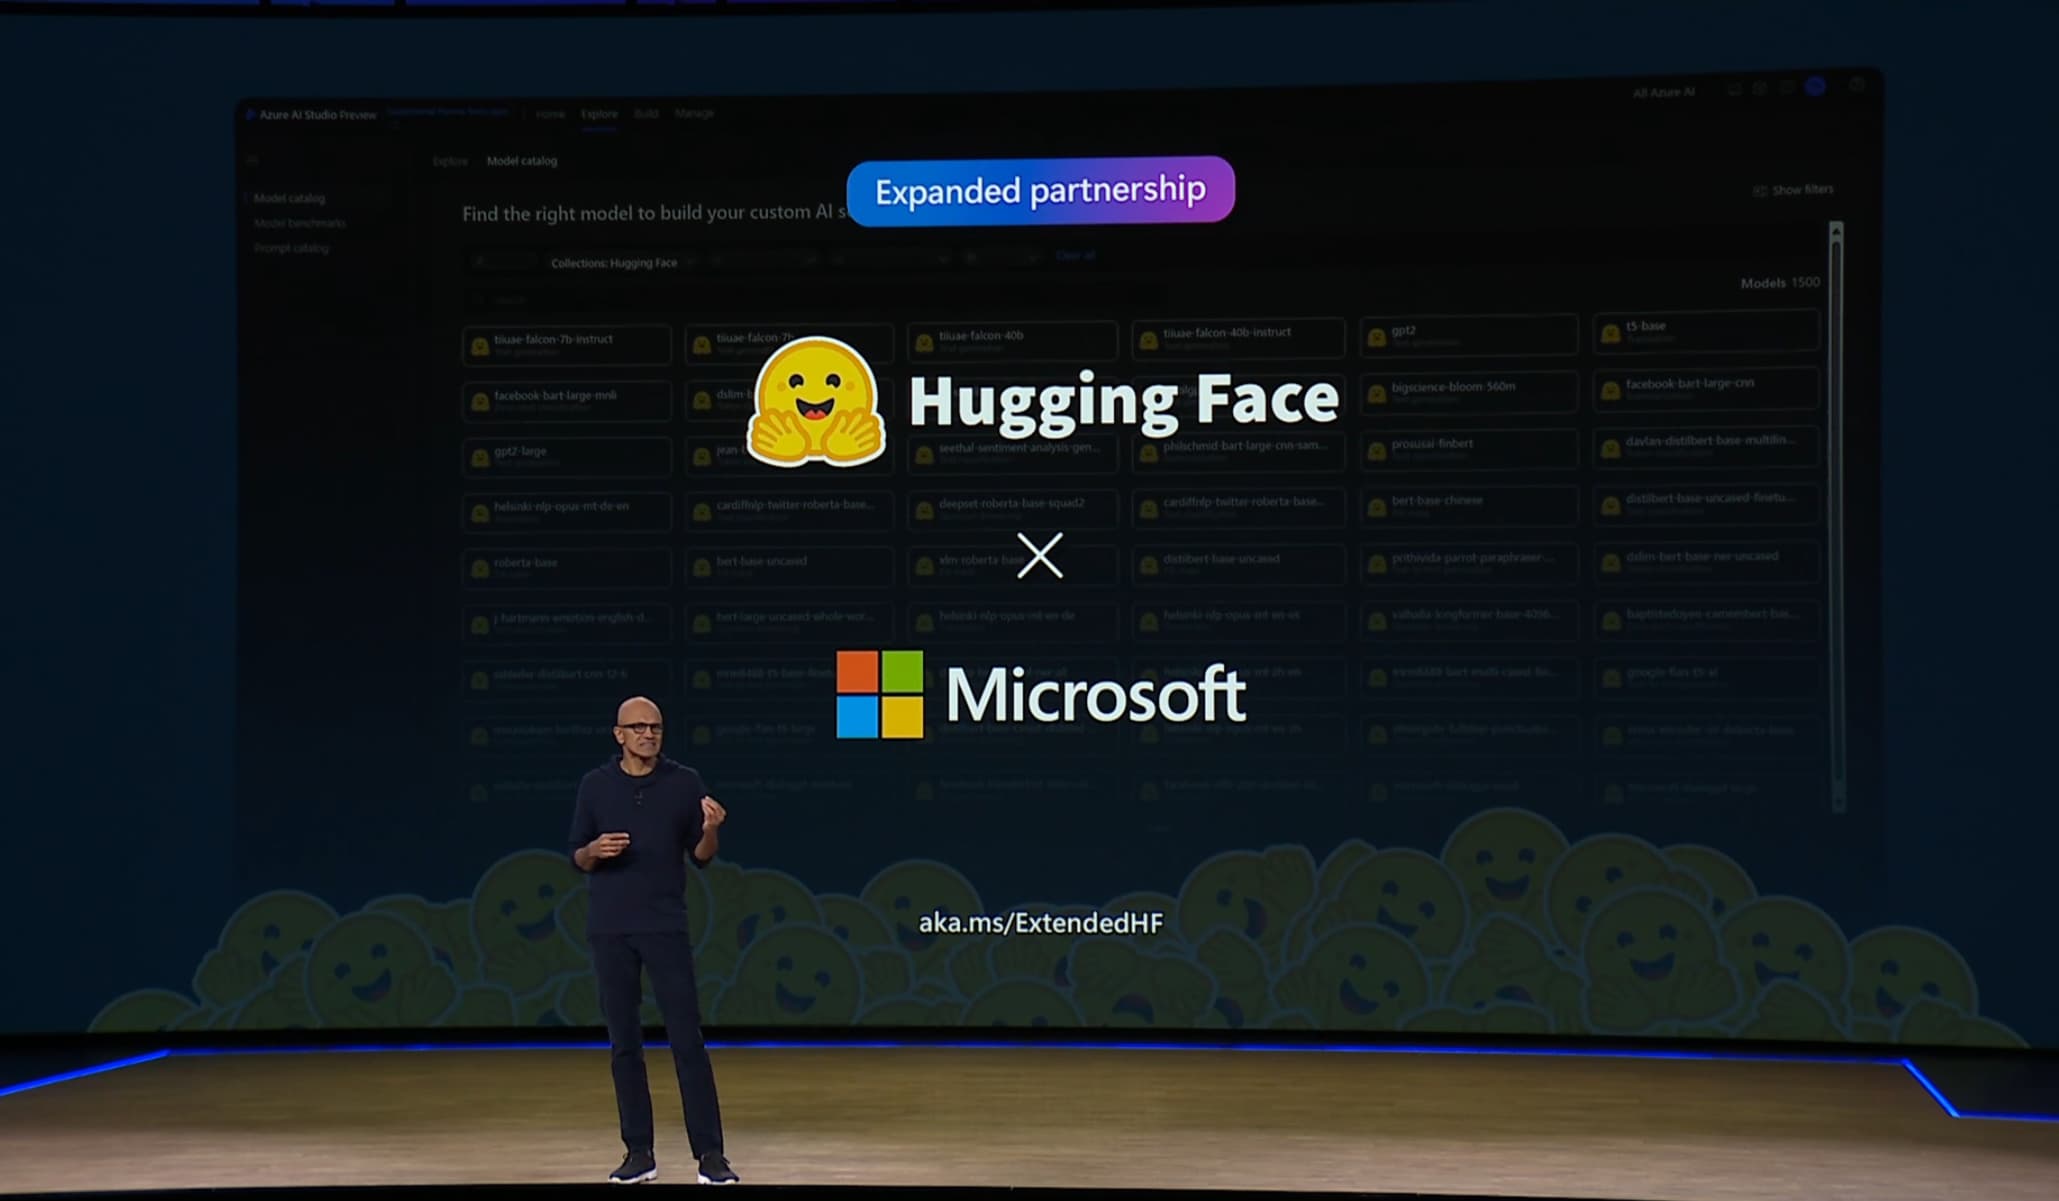
Microsoft-ისა და Hugging Face-ის თანამშრომლობა Azure-ზე ხელოვნური ინტელექტის შექმნას ამარტივებს
Microsoft და Hugging Face აცხადებენ თანამშრომლობის გაღრმავებას, რაც მომხმარებლებს საშუალებას აძლევს, Azure-ზე ღია მოდელებით ხელოვნური ინტელექტი (AI) უფრო მარტივად ააწყონ. სიახლეები მოიცავს პოპულარული დიდი ენობრივი მოდელების (LLM) პირდაპირ ინტეგრაციას Azure AI Studio-ში, ახალი AMD Instinct MI300 GPU-ზე დაფუძნებული ვირტუალური მანქანების ხელმისაწვდომობას მაღალი წარმადობისთვის და Hugging Face Spaces-ის ინტეგრაციას VS Code-თან, რაც დეველოპერებისთვის AI აპლიკაციების შექმნას საგრძნობლად აჩქარებს.

AI ძიების რევოლუცია: Microsoft-ის სტრატეგიები წარმატებისთვის ახალ ეპოქაში
ხელოვნური ინტელექტის (AI) განვითარებასთან ერთად, ძიების ლანდშაფტი რადიკალურად იცვლება. Microsoft-ის უახლესი მეგზური გვიჩვენებს, თუ როგორ უნდა მოვახდინოთ კონტენტის ოპტიმიზაცია AI ასისტენტების მიერ რეკომენდაციისთვის, ტრადიციული SEO-დან AEO (Agentic Engine Optimization) და GEO (Generative Engine Optimization) მიმართულებით.

ამაზონი AI კონტენტის ლიცენზირების ბაზარზე შემოდის: გამომცემლებისთვის ახალი შემოსავლის წყარო?
ხელოვნური ინტელექტის (AI) ინდუსტრიაში საავტორო უფლებებთან დაკავშირებული გამოწვევების ფონზე, ამაზონი (Amazon), სავარაუდოდ, გეგმავს პლატფორმის შექმნას, სადაც გამომცემლებს შეეძლებათ თავიანთი კონტენტის AI კომპანიებისთვის ლიცენზირება. ეს ინიციატივა, რომელიც მიკროსოფტის (Microsoft) მსგავს ნაბიჯებს მიჰყვება, მიზნად ისახავს AI მოდელების სავარჯიშო მონაცემებზე (training data) წვდომის ლეგალიზებას და გამომცემლებისთვის ახალი შემოსავლის გზების გახსნას.

Microsoft-ის ექსპერტი: აგენტური AI – უდიდესი შესაძლებლობა საჯარო ღრუბლის შემდეგ
Microsoft-ის კორპორატიული ვიცე-პრეზიდენტი, ამანდა სილვერი, ხსნის, თუ როგორ გარდაქმნის აგენტური ხელოვნური ინტელექტი (AI) სტარტაპებსა და საწარმოებს, მას საჯარო ღრუბლის ტექნოლოგიების გამოჩენის ტოლფას შესაძლებლობად მიიჩნევს. ის დეტალურად განიხილავს AI აგენტების პრაქტიკულ გამოყენებას და იმ გამოწვევებს, რაც მათ ფართომასშტაბიან დანერგვას აფერხებს.