
Hugging Face და Protect AI მანქანური სწავლების მოდელების უსაფრთხოების გაძლიერების მიზნით თანამშრომლობენ
2024 წლის ოქტომბერში Hugging Face-მა და Protect AI-მ პარტნიორობა დაიწყეს მანქანური სწავლების (ML) მოდელების უსაფრთხოების გასაუმჯობესებლად. Protect AI-ის Guardian სკანირების ტექნოლოგია Hugging Face Hub-ის მომხმარებლებს კრიტიკულ უსაფრთხოების ინფორმაციას აწვდის. პარტნიორობის ფარგლებში, Protect AI-მ მნიშვნელოვნად გააფართოვა Guardian-ის აღმოჩენის შესაძლებლობები, მოიცვა მეტი ფაილის ფორმატი და გამოავლინა დახვეწილი ობსკურაციის ტექნიკები, მათ შორის მაღალი რისკის CVE-2025-1550 მოწყვლადობა Keras-ში. 2025 წ

Gradio: ყოვლისმომცველი ჩარჩო AI/ML აპლიკაციების შესაქმნელად – მეტი, ვიდრე უბრალო UI ბიბლიოთეკა
Gradio, რომელიც ხშირად აღიქმება მხოლოდ UI ბიბლიოთეკად, სინამდვილეში არის ყოვლისმომცველი ჩარჩო მანქანური სწავლების მოდელებთან ურთიერთობისთვის UI-ებისა და API-ების მეშვეობით, რომელიც უზრუნველყოფს მაღალ შესრულებას, უსაფრთხოებასა და რეაგირებას. სტატია დეტალურად განიხილავს Gradio-ს უნიკალურ მახასიათებლებს, როგორებიცაა API Recorder, სერვერული რენდერინგი (SSR), დახვეწილი რიგების სისტემა, სტრიმინგი, მრავალგვერდიანი აპლიკაციების მხარდაჭერა, Groovy ტრანსპილაცია, თემების სისტემა, დინამიური რენდერინგი, Grad
მეგ მიტჩელი ხელოვნური ინტელექტის ეთიკაზე: მონაცემთა მიკერძოებიდან ინკლუზიურ კულტურამდე
ამ ინტერვიუში დოქტორი მარგარეტ (მეგ) მიტჩელი საუბრობს იმ მომენტზე, როდესაც მან გააცნობიერა ეთიკური ხელოვნური ინტელექტის (AI) მნიშვნელობა. ის იზიარებს თავის გამოცდილებას მონაცემთა მავნე მიკერძოებასთან დაკავშირებით, რომელსაც მანქანური სწავლების (ML) გუნდები ხშირად აწყდებიან, და განმარტავს ინკლუზიისა და მრავალფეროვნების სარგებელს AI სისტემების შემუშავებაში. მეგი აღწერს თავის კარიერულ გზას Microsoft-დან Google-მდე, სადაც მან დააარსა ეთიკური AI-ს გუნდი, და შემდეგ Hugging Face-მდე. ის განიხილავს ისეთ
Hugging Face-ის ინჟინერი ლუის ტანსტალი: ტრანსფორმერები, MLOps და მისი ახალი წიგნი
ამ ინტერვიუში ბრიტნი მალერი ესაუბრება ლუის ტანსტალს, Hugging Face-ის მანქანური სწავლების ინჟინერს. ტანსტალი განიხილავს ტრანსფორმერების გამოყენებას ბიზნეს პროცესების ავტომატიზაციისთვის, მისი წიგნის „NLP ტრანსფორმერებით“ შექმნის პროცესს და ფართომასშტაბიანი ML მოდელების ოპტიმიზაციის გადაწყვეტებს უფრო სწრაფი შეყოვნებისა და მაღალი გამტარუნარიანობის მისაღწევად, მათ შორის ONNX ფორმატის გამოყენებას.
PatchTSMixer: IBM Research-ისა და Hugging Face-ის რევოლუციური მოდელი დროითი სერიების მოდელირებისთვის
IBM Research-მა Hugging Face-თან ერთად წარმოადგინა PatchTSMixer, ინოვაციური მოდელი, რომელიც Transformers ბიბლიოთეკაშია ინტეგრირებული. ეს მოდელი შექმნილია მრავალვარიანტული დროითი სერიების ეფექტური მოდელირებისთვის, მსუბუქი შერევის გამოყენებით პაჩებს, არხებსა და დამალულ მახასიათებლებს შორის. PatchTSMixer მნიშვნელოვნად აღემატება არსებულ MLP და Transformer მოდელებს პროგნოზირებაში, აჩვენებს 8-60%-იან გაუმჯობესებას და ამცირებს მეხსიერების მოხმარებასა და შესრულების დროს. იგი მხარს უჭერს ტრანსფერულ სწავლ
MetaAI-ის Wav2Vec2-BERT: გაუმჯობესებული მეტყველების ამოცნობა დაბალრესურსიან ენებზე
MetaAI-მ გამოუშვა Wav2Vec2-BERT, ხელოვნური ინტელექტის მოდელი მეტყველების ავტომატური ამოცნობისთვის (ASR), რომელიც Seamless Communication-ის ნაწილია. ორიგინალური Wav2Vec2-ის გაუმჯობესებული ვერსია, Wav2Vec2-BERT, გაწვრთნილია 4.5 მილიონ საათზე მეტ აუდიო მონაცემზე 143-ზე მეტ ენაზე. ის მნიშვნელოვნად აღემატება Whisper-ის მოდელს სიჩქარითა და რესურსების ეფექტურობით, განსაკუთრებით დაბალრესურსიან ენებზე, როგორიცაა მონღოლური, სადაც Whisper-ი დაბალ შედეგებს აჩვენებს. Wav2Vec2-BERT-ს შეუძლია მიაღწიოს კონკურენ

Transformers ბიბლიოთეკა: ხელოვნური ინტელექტის მოდელების ინტეგრაციისა და სტანდარტიზაციის ახალი ეტაპი
Transformers, რომელიც 2019 წელს დაარსდა, გახდა ხელოვნური ინტელექტის მოდელების, განსაკუთრებით დიდი ენობრივი (LLM) და ვიზუალური ენობრივი (VLM) მოდელებთან მუშაობის სტანდარტული ბიბლიოთეკა Python ეკოსისტემაში. ის მხარს უჭერს 300-ზე მეტ არქიტექტურას, აქტიურად თანამშრომლობს სხვა ბიბლიოთეკებთან (როგორიცაა llama.cpp და MLX) თავსებადობის გასაუმჯობესებლად და მიზნად ისახავს წვლილის შეტანის ბარიერის შემცირებას ხელოვნური ინტელექტის საზოგადოებაში, რითაც ხელს უწყობს ეკოსისტემის სტანდარტიზაციას და ფრაგმენტაციის
წამყვანი ML დირექტორების შეხედულებები: ხელოვნური ინტელექტის გავლენა ინდუსტრიებზე
მანქანური სწავლების (ML) და მონაცემთა მეცნიერების დირექტორებს უაღრესად რთული მოთხოვნები აქვთ თავიანთ როლებში. ამ სტატიების სერიაში, ჩვენ წარმოგიდგენთ ML დირექტორების უნიკალურ შეხედულებებს მიმდინარე ML ტენდენციებსა და ინდუსტრიულ განვითარებაზე, დაწყებული ჯანდაცვიდან ფინანსებამდე, ელექტრონულ კომერციამდე და სხვა სფეროებამდე. ისინი გაგვიზიარებენ გამოცდილებას ML-ის პრაქტიკული გამოყენების შესახებ რეალურ სამყაროში, ისეთი ინოვაციების ჩათვლით, როგორიცაა ნახშირბადის ემისიების შემცირება ტრანსპორტირებაში ან
მომხმარებლის საჭიროებების გაგება Auto ML-ით: HuggingFace AutoTrain-ისა და Kili-ის ინტეგრაცია
სტატია განიხილავს, თუ როგორ შეიძლება ავტომატური მანქანური სწავლის (Auto ML) გამოყენება, კერძოდ HuggingFace AutoTrain-ისა და Kili პლატფორმის მეშვეობით, მომხმარებელთა საჭიროებების ეფექტურად გასაგებად. წარმოდგენილია ტექსტის კლასიფიკაციისა და სენტიმენტური ანალიზის აქტიური სწავლის პაიპლაინის აგება, Medium-ის მომხმარებლის მიმოხილვების მაგალითზე Google Play Store-იდან. ეს მეთოდი ამცირებს ხარჯებს და აჩქარებს მონაცემთა ეტიკეტირებისა და მოდელის ვარჯიშის პროცესს.
როგორ გავიგოთ მომხმარებლის საჭიროებები HuggingFace AutoTrain-ისა და Kili-ის დახმარებით: აქტიური სწავლების დანერგვა
ეს სტატია იკვლევს ავტომატური მანქანური სწავლების (Auto ML) და აქტიური სწავლების გამოყენებას მომხმარებლის საჭიროებების გასაგებად, ტექსტის კლასიფიკაციისა და სენტიმენტების ანალიზზე ფოკუსირებით. ის დეტალურად აღწერს, თუ როგორ უნდა შეიქმნას აქტიური სწავლების მილსადენი HuggingFace AutoTrain-ისა და Kili-ის, მონაცემებზე ორიენტირებული AI ვარჯიშის პლატფორმის გამოყენებით. პროცესი მოიცავს მომხმარებლის მიმოხილვების ანოტირებას, კლასიფიკაციის მოდელების შექმნას (როგორც AutoTrain-ით, ისე მის გარეშე) და სენტიმენტე

დიდი ML მოდელების სწავლება: FullyShardedDataParallel (FSDP) შესაძლებლობები
მანქანური სწავლების (ML) მოდელების მუდმივად მზარდი მასშტაბები აპარატურულ შეზღუდვებს წარმოქმნის. ეს სტატია იკვლევს, თუ როგორ უმკლავდება განაწილებული სწავლება, კერძოდ PyTorch-ის FullyShardedDataParallel (FSDP) ფუნქცია, ამ გამოწვევას. ჩვენ ვადარებთ FSDP-ის წარმადობას DDP-სთან GPT-2 მოდელების გამოყენებით, ვაჩვენებთ FSDP-ის უნარს, მოახდინოს უფრო დიდი პაკეტის ზომების დამუშავება და კიდევ უფრო დიდი მოდელების სწავლება, რითაც ხელმისაწვდომს ხდის მძლავრ ML ტექნოლოგიებს.
დიდი ML მოდელების ეფექტური ვარჯიში: PyTorch FSDP-ის გამოყენება განაწილებულ სისტემებში
მანქანური სწავლების (ML) მოდელების მზარდი ზომისა და პარამეტრების გამო, სპეციალისტებს უჭირთ მათი ვარჯიში სტანდარტულ აპარატურაზე, მიუხედავად იმისა, რომ დიდი მოდელები უფრო სწრაფად სწავლობენ და მაღალ წარმადობას ავლენენ. ამ გამოწვევის საპასუხოდ, განაწილებული სწავლება ხდება გადამწყვეტი. ეს სტატია იკვლევს მონაცემთა პარალელიზმს ZeRO კონცეფციის გამოყენებით და კონკრეტულად PyTorch-ის უახლეს ფუნქციას, FullyShardedDataParallel (FSDP)-ს. DeepSpeed-ისა და FairScale-ის მიერ დანერგილი ZeRO-ის იდეები, PyTorch-ში
Hugging Face Hub-ი აფართოებს fastai-ის შესაძლებლობებს: ღრმა სწავლის მოდელების გაზიარება ერთი ხაზით
Hugging Face-ი, რომლის მიზანია მანქანური სწავლების დემოკრატიზაცია, სიამაყით აცხადებს fastai-თან ახალ ინტეგრაციას. ეს ინტეგრაცია fastai-ის მომხმარებლებს საშუალებას აძლევს, მარტივად გააზიარონ და ატვირთონ ღრმა სწავლის მოდელები Hugging Face Hub-ზე Python-ის ერთი ხაზის გამოყენებით. სტატიაში ხაზგასმულია fastai-ის წვლილი ღრმა სწავლების ხელმისაწვდომობაში და აღწერილია Hub-ის, როგორც მოდელების, მონაცემთა ნაკრებებისა და ML დემოების ცენტრალური პლატფორმის, უპირატესობები. ინტეგრაცია მოიცავს ვერსიის კონტროლს G

მანქანური სწავლების (ML) დირექტორების ხედვები: SaaS, გამოწვევები და მომავალი
გაეცანით მანქანური სწავლების (ML) დირექტორების უნიკალურ პერსპექტივებს ხელოვნური ინტელექტის განვითარებაზე. ჩვენი სერიის მეორე ნაწილში, რომელიც SaaS სექტორზეა ორიენტირებული, წამყვანი სპეციალისტები გვიზიარებენ თავიანთ შეხედულებებს ML-ის მიმდინარე მდგომარეობაზე, ყველაზე დიდ გამოწვევებსა და სამომავლო პერსპექტივებზე. სტატიაში წარმოდგენილია Salesforce-ის კიბერუსაფრთხოების გუნდის ლიდერის, ომარის, და Amplitude-ის მონაცემთა მეცნიერებისა და ML-ის ხელმძღვანელის, ცაო (დანიკა) სიაოს ბიოგრაფიები და მათი მოსაზრ
ინტერვიუ საშა ლუჩიონთან: AI-ს ეთიკური გამოყენება და მისი გარემოზე ზემოქმედება
წარმოგიდგენთ ინტერვიუს საშა ლუჩიონთან, Hugging Face-ის მკვლევარ მეცნიერთან, რომელიც მუშაობს მანქანური სწავლის მოდელებისა და მონაცემთა ნაკრებების ეთიკურ და საზოგადოებრივ გავლენებზე. საშა ასევე Big Science Workshop-ის ნახშირბადის კვალის სამუშაო ჯგუფის თანათავმჯდომარე და Climate Change AI (CCAI) ორგანიზაციის დამფუძნებელი წევრია. ამ ეპიზოდში ის საუბრობს იმაზე, თუ როგორ ზომავს ელექტრონული ფოსტის ნახშირბადის კვალს, როგორ დაეხმარა ადგილობრივ საქველმოქმედო სამზარეულოს ML-ის გამოყენებაში და როგორ ანიჭებს

Hugging Face-ის Kernel Hub: ხელოვნური ინტელექტის მოდელების მუშაობის დაჩქარება ოპტიმიზებული ბირთვებით
Hugging Face-ის ახალი Kernel Hub რევოლუციას ახდენს მანქანური სწავლების მოდელების ოპტიმიზაციაში. ის უზრუნველყოფს ცენტრალიზებულ საცავს წინასწარ კომპილირებული, მაღალეფექტური გამოთვლითი ბირთვებისთვის, რაც დეველოპერებს საშუალებას აძლევს, მარტივად ჩართონ ოპტიმიზებული კოდი სწრაფი ოპერაციებისთვის, განსაკუთრებით GPU-ებზე, რთული კომპილაციის პროცესების გარეშე. ეს დრამატულად ამარტივებს მაღალი წარმადობის მიღწევას ML პროექტებში, რაც დეველოპერებს საშუალებას აძლევს, მეტი დრო დაუთმონ მოდელების აგებას და ნაკლები
მანქანური სწავლება ფინანსურ სექტორში: გამოწვევები, ნდობა და ინოვაციების როლი
სტატია განიხილავს მანქანური სწავლების (ML) დირექტორების უნიკალურ გამოწვევებს ფინანსურ სექტორში, მათ შორის მოძველებული სისტემების მართვას, მოდელების ინტერპრეტაციას და მომხმარებელთა ნდობის შენარჩუნებას მკაცრი რეგულაციების პირობებში. ხაზგასმულია, თუ როგორ გამოიწვია ML-მა დისკუსიები ფინანსურ გადაწყვეტილებებში ნდობის შესახებ და გახდა გარდამტეხი ძალა, რამაც ახალი ბიზნეს შესაძლებლობები შექმნა. წამყვანი ფინანსური ინსტიტუტების ექსპერტები იზიარებენ თავიანთ შეხედულებებს ამ გამოწვევებზე, განსაკუთრებით მოძვე

Gemma 3n: მულტიმოდალური AI მოდელი საბოლოოდ ღია კოდის ბიბლიოთეკებში
Google-ის უახლესი მულტიმოდალური AI მოდელი, Gemma 3n, საბოლოოდ ხელმისაწვდომია ყველაზე პოპულარულ ღია კოდის ბიბლიოთეკებში, მათ შორის transformers & timm, MLX, llama.cpp და სხვებში. ეს გამოშვება მოიცავს ორ ზომას (E2B და E4B), რომლებიც გამოირჩევიან მაღალი ეფექტურობით VRAM-ის გამოყენების მხრივ და უზრუნველყოფენ შესანიშნავ ხარისხს. Gemma 3n არა მხოლოდ ენობრივ დეკოდერს, არამედ აუდიო და ვიზუალურ ენკოდერებსაც მოიცავს, რაც მას სრულყოფილ მულტიმოდალურ ინსტრუმენტად აქცევს დეველოპერებისთვის. სტატია დეტალურად აღ
ხელოვნური ინტელექტი ვებ-დიზაინს HTML კოდში აქცევს: WebSight და Sightseer
ვებ-დიზაინის HTML კოდში გადაქცევა ხშირად გამოცდილ დეველოპერს მოითხოვს. ეს სტატია იკვლევს, თუ როგორ შეუძლიათ ვიზუალური ენის მოდელებს (VLMs) ამ პროცესის გამარტივება. წარმოდგენილია WebSight მონაცემთა ბაზა და Sightseer მოდელი, რომლებიც ხელოვნურ ინტელექტს საშუალებას აძლევენ ვიზუალური დიზაინი ფუნქციურ HTML კოდში გადაიყვანოს, რაც ვებ-დეველოპმენტს უფრო ეფექტურსა და ხელმისაწვდომს ხდის.
Hugging Face: მანქანური სწავლის სამყარო არატექნიკური მომხმარებლებისთვის
ეს გზამკვლევი მიზნად ისახავს მანქანური სწავლის (ML) ფუნდამენტური პრინციპების ხელმისაწვდომად ახსნას არატექნიკური მომხმარებლებისთვის, პითონის ცოდნის საჭიროების გარეშე. იგი დეტალურად განიხილავს Hugging Face-ის ეკოსისტემას, მათ შორის Transformers-ის ბიბლიოთეკას, Hugging Face Hub-ს და Spaces-ს, რომლებიც აადვილებს ML მოდელების გამოყენებასა და განლაგებას. ასევე განმარტებულია LLM-ებისთვის საჭირო GPU-ების დაქირავების პროცესი Hugging Face-ის მეშვეობით, Docker-ის შაბლონების მნიშვნელობა და ძირითადი პროგრამი

Wiz-ისა და Hugging Face-ის ერთობლივი ძალისხმევა AI პლატფორმის უსაფრთხოების გასაუმჯობესებლად
Hugging Face-მა, Wiz-თან თანამშრომლობით, მნიშვნელოვნად გააუმჯობესა თავისი ხელოვნური ინტელექტის პლატფორმის უსაფრთხოება. Wiz-ის მკვლევრების მიერ გამოვლენილი დაუცველობების საფუძველზე, Hugging Face-მა დანერგა Wiz-ის გადაწყვეტილებები დაუცველობის მართვისა და ღრუბლოვანი უსაფრთხოების მდგომარეობის მართვისთვის (CSPM). სტატია დეტალურად განიხილავს ამ ინტეგრაციის სარგებელს, განსაკუთრებით pickle ფაილებთან დაკავშირებულ რისკებსა და Hugging Face-ის ვალდებულებას, დაიცვას მომხმარებლები და ხელი შეუწყოს AI/ML-ის დემ
Hugging Face Hub: მანქანური სწავლების პროექტების დაჩქარება და კოლაბორაცია
სტატია განიხილავს მანქანური სწავლების (ML) განვითარების გამოწვევებს, როგორიცაა მოდელების პროდუქტიულ ფაზაში ვერ გადასვლა და თანამშრომლობის სირთულეები. წარმოდგენილია Private Hub-ისა და განსაკუთრებით Hugging Face Hub-ის როლი, როგორც ამ პრობლემების გადაწყვეტა. Hugging Face Hub გთავაზობთ ღია წყაროს პლატფორმას მოდელების, მონაცემთა ნაკრებებისა და აპლიკაციების ფართო კოლექციით, Git-ზე დაფუძნებულ რეპოზიტორიებსა და თანამშრომლობით ხელსაწყოებს ML სამუშაო პროცესების დასაჩქარებლად, კვლევიდან დაწყებული წარმოება
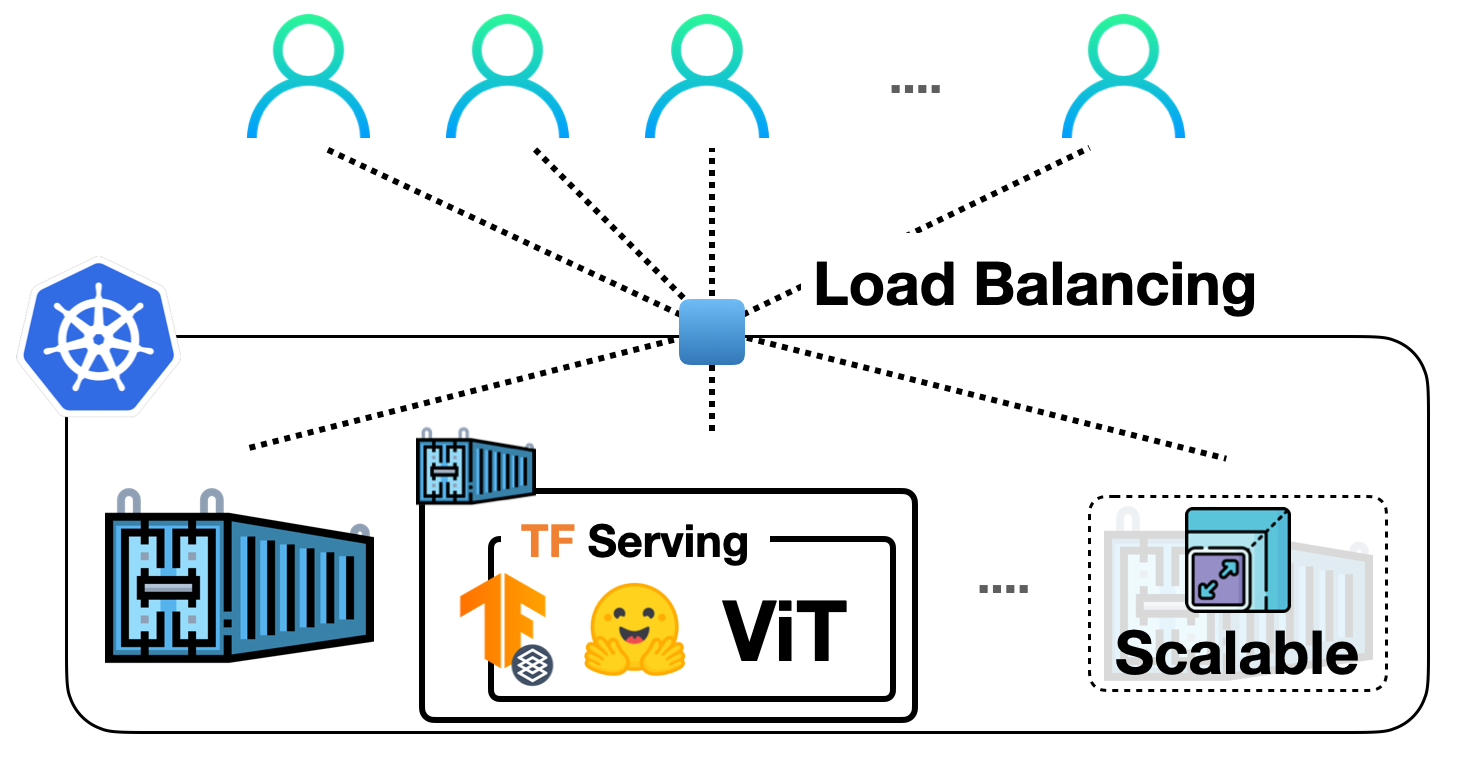
ML მოდელების მასშტაბირება Docker-ით და Kubernetes-ით: ლოკალურიდან სრულმასშტაბიან დეპლოიმენტამდე
ეს პოსტი გაწვდით დეტალურ სახელმძღვანელოს, თუ როგორ გადახვიდეთ მანქანური სწავლების მოდელების ლოკალური განთავსებიდან მასშტაბირებად, რეალურ პროექტებში გამოსაყენებელ სისტემებზე Docker-ისა და Kubernetes-ის გამოყენებით. სტატია აღწერს აპლიკაციის ლოგიკის კონტეინერიზაციას, Docker-ის კონტეინერების განთავსებას Kubernetes კლასტერზე (კერძოდ Google Kubernetes Engine-ზე - GKE), TensorFlow Serving-ის გამოყენებას მოდელების მომსახურებისთვის, მორგებული Docker გამოსახულებების შექმნას და მათ Google Container Registr
Hugging Face-ის ტრანსფორმატორები TensorFlow-ის ინჟინრებისთვის: გზამკვლევი
სტატია განიხილავს PyTorch-ის ინჟინრების მიერ TensorFlow-თან მიდგომის ხშირ შეცდომას, კერძოდ, Keras-ის მაღალი დონის API-ის უგულებელყოფას. ხაზგასმულია, რომ Keras-ის გამოყენება TensorFlow-სთან ოპტიმალურია. შემდეგ წარმოდგენილია Hugging Face-ის ტრანსფორმატორები, როგორც ძლიერი ინსტრუმენტები, რომლებიც TensorFlow-ის ინჟინრებს საშუალებას აძლევს, გამოიყენონ უახლესი მოდელები ნაცნობი Keras API-ის მეშვეობით. დეტალურად არის ახსნილი ტრანსფერული სწავლის (transfer learning) კონცეფცია, როგორც ML პრობლემების გადაჭრ