პირდაპირი უპირატესობის ოპტიმიზაცია (DPO) LLM-ების დახვეწას ამარტივებს
ეს სტატია წარმოგიდგენთ პირდაპირი უპირატესობის ოპტიმიზაციის (DPO) მეთოდს, რომელიც მნიშვნელოვნად ამარტივებს დიდი ენობრივი მოდელების (LLM) დახვეწის პროცესს. ტრადიციული გაძლიერებითი სწავლისგან ადამიანის უკუკავშირით (RLHF) განსხვავებით, DPO გამორიცხავს ჯილდოს მოდელის შექმნის კომპლექსურ საფეხურს და RL ოპტიმიზაციას, პირდაპირ ახდენს ენობრივი მოდელის ოპტიმიზაციას უპირატესობის მონაცემებზე, ბინარული კროს-ენტროპიის დანაკარგის გამოყენებით. ეს მიდგომა ვარჯიშს უფრო ეფექტურს და ნაკლებად პრობლემურს ხდის, რაც შეს

DeepSeek R1-ის გამოშვებიდან ორი კვირა: ღია-R1 პროექტის მიღწევები და გამოწვევები
სტატია აჯამებს ღია-R1 პროექტის განვითარებას, რომელიც DeepSeek R1-ის სასწავლო კონვეიერისა და სინთეზური მონაცემების რეპლიკაციას ისახავს მიზნად. მიღწევებს შორისაა DeepSeek-ის შეფასების ქულების რეპროდუცირება და GRPO-ის ინტეგრაცია TRL-ში. პროექტი DeepSeek R1-ის ხანგრძლივი პასუხების გამო GPU მეხსიერებისა და გენერაციის ეფექტურობის გამოწვევების წინაშე დგას, თუმცა ინფერენსის ოპტიმიზაციაში მნიშვნელოვანი პროგრესია. ინიციატივამ მედიის ფართო ინტერესიც გამოიწვია.

Fireworks.ai და Hugging Face: ელვისებურად სწრაფი სერვერის გარეშე AI დასკვნა ახლა ხელმისაწვდომია
Fireworks.ai ინტეგრირდა Hugging Face-ის ეკოსისტემაში, რაც მომხმარებლებს საშუალებას აძლევს, ელვისებურად სწრაფად გაუშვან სერვერის გარეშე დასკვნები (serverless inference) საყვარელ AI მოდელებზე. ეს თანამშრომლობა ამარტივებს პროცესს, გთავაზობთ მოქნილ ბილინგის ვარიანტებს და PRO მომხმარებლებისთვის განკუთვნილ უპირატესობებს, მათ შორის ყოველთვიურ კრედიტებს.

როგორ დავხვეწოთ Llama 2 70B PyTorch FSDP-ის გამოყენებით: საუკეთესო პრაქტიკები და გამოწვევების გადაჭრა
ეს ბლოგპოსტი დეტალურად განიხილავს Llama 2 70B მოდელის დახვეწას PyTorch FSDP-ის გამოყენებით. სტატია ფოკუსირებულია ძირითად გამოწვევებზე, როგორიცაა CPU RAM-ის გადატვირთვა, შუალედური ჩეკპოინტების შენახვის სირთულეები და VRAM-ის მოხმარების ოპტიმიზაცია. წარმოდგენილია გადაწყვეტები Hugging Face Transformers, Accelerate და TRL ინსტრუმენტების მეშვეობით, ასევე განხილულია Accelerate-ის გამოყენება SLURM-თან ერთად. მოცემულია საჭირო რესურსები და კონფიგურაციები შედეგების რეპროდუცირებისთვის.
Llama 2 70B-ის დახვეწა PyTorch FSDP-ის გამოყენებით: საუკეთესო პრაქტიკა და გამოწვევების გადაწყვეტა
ამ ბლოგ-პოსტში განხილულია Llama 2 70B მოდელის დახვეწის პროცესი PyTorch FSDP-ის გამოყენებით, Hugging Face Transformers, Accelerate და TRL ინსტრუმენტების მოშველიებით. დეტალურად არის აღწერილი FSDP-ის მოქმედების პრინციპი, რომელიც ოპტიმიზატორის მდგომარეობებს, გრადიენტებსა და პარამეტრებს მოწყობილობებს შორის ანაწილებს. ასევე, განხილულია ძირითადი გამოწვევები, როგორიცაა CPU RAM-ის მაღალი მოთხოვნები, შუალედური საკონტროლო წერტილების ნელი შენახვა და NCCL Timeout შეცდომები. სტატია გვთავაზობს გადაწყვეტებს ტრე
გაძლიერებითი სწავლის (RL) გამოყენება დიფუზიური მოდელების გასაუმჯობესებლად: DDPO-ს როლი ხელოვნური ინტელექტის მიერ შექმნილი გამოსახულებების ადამიანურ პრეფერენციებთან შესაბამისობაში
სტატია განიხილავს, თუ როგორ ხდება დიფუზიური მოდელების (მაგ. DALL-E 2, Stable Diffusion) ოპტიმიზაცია გაძლიერებითი სწავლის (RL) გამოყენებით, რათა მათ მიერ გენერირებული გამოსახულებები უკეთესად შეესაბამებოდეს ადამიანის პრეფერენციებსა და ესთეტიკას. ის მიმოიხილავს "შესაბამისობის პრობლემას" ხელოვნურ ინტელექტში და წარმოაჩენს Denoising Diffusion Policy Optimization (DDPO) მეთოდს, როგორც ეფექტურ გადაწყვეტას. DDPO, რომელიც იყენებს პოლიტიკის გრადიენტულ მეთოდებს (PPO) და დენოიზინგის პროცესს მარკოვის გადაწყვე
OpenAI-ის RLHF შედეგების რეპროდუცირება: ტექნიკური დეტალების სიღრმისეული ანალიზი
მოცემული ნაშრომი მიზნად ისახავს OpenAI-ის (OAI) სტილისტური ამოცანების (როგორიცაა სენტიმენტი და აღწერილობითობა) RLHF (Reinforcement Learning from Human Feedback) შედეგების რეპროდუცირებას. ჩვენი კოდების ბაზა OAI-ის კოდების ბაზის თითქმის იდენტურ სწავლის მრუდებს აჩვენებს. სტატია დეტალურად განიხილავს იმპლემენტაციის ტექნიკურ ნიუანსებს, მათ შორის, როგორ გენერირდება ჯილდოები/მნიშვნელობები და პასუხები, შევსების (padding) მექანიზმებს, ლოგიტების გამოთვლას და პასუხების გენერაციის დროს შერჩევის პროცესს. ასევ
Hugging Face-ის ბიბლიოთეკა Decision Transformer-ს აერთიანებს: ახალი ეტაპი ღრმა გაძლიერებულ სწავლაში
Hugging Face-მა სიხარულით განაცხადა, რომ Decision Transformer, ოფლაინ გაძლიერებული სწავლის (Offline Reinforcement Learning) მეთოდი, ინტეგრირებულია მათ 🤗 ტრანსფორმერების ბიბლიოთეკაში და Hugging Face ჰაბში. ეს ნაბიჯი ღრმა გაძლიერებული სწავლის (Deep RL) სფეროში ხელმისაწვდომობის გაუმჯობესების გეგმის ნაწილია. სტატია განმარტავს RL-ის საფუძვლებს, განასხვავებს ონლაინ და ოფლაინ გაძლიერებულ სწავლებას და დეტალურად აღწერს Decision Transformer-ის მოდელს, რომელიც წარმოადგენს პარადიგმის ცვლილებას, რადგან ტრადი
Hugging Face-ი Decision Transformer-ს აინტეგრირებს: ახალი მიდგომა გაძლიერებით სწავლებაში
Hugging Face-მა Decision Transformer, ოფლაინ გაძლიერებითი სწავლის (Offline Reinforcement Learning) მეთოდი, თავის 🤗 transformers ბიბლიოთეკასა და Hugging Face Hub-ში ინტეგრირება მოახდინა. ეს ინტეგრაცია მნიშვნელოვან ნაბიჯს წარმოადგენს Deep Reinforcement Learning-ის (Deep RL) სფეროში ხელმისაწვდომობის გასაუმჯობესებლად. Decision Transformer წარმოადგენს პარადიგმის ცვლას, სადაც ტრადიციული RL მეთოდების ნაცვლად გამოიყენება მიმდევრობის მოდელირების ალგორითმი სასურველი შედეგის მისაღწევად მომავალი მოქმედებები
LLM-ის გასწორების ალგორითმების ემპირიული შეფასება: DPO, IPO და KTO
ეს პოსტი წარმოადგენს დიდი ენობრივი მოდელების (LLM) გასწორების სამი პერსპექტიული ალგორითმის — Direct Preference Optimization (DPO), Identity Preference Optimisation (IPO) და Kahneman-Tversky Optimisation (KTO) — ემპირიულ შეფასებას. მასში აღწერილია IPO-ს იმპლემენტაციის მნიშვნელოვანი კორექტირება TRL-ში, რის შემდეგაც IPO DPO-ს თანაბრად ეფექტური აღმოჩნდა და KTO-ს აჯობა შეწყვილებული უპირატესობის პარამეტრებში. შეფასება მოიცავს სხვადასხვა მოდელებსა და ჰიპერპარამეტრებს, რათა დადგინდეს საუკეთესო მიდგომები

LLM-ების ოპტიმიზაცია: TRL-ის ახალი მიდგომა GRPO სწავლების მეხსიერების შესამცირებლად
დიდი ენობრივი მოდელების (LLM) დახვეწა განმტკიცებითი სწავლის (RL) გამოყენებით გადამწყვეტია რთული ქცევების მისაღწევად. ტრადიციულად ამისთვის გამოიყენება PPO ალგორითმი RLHF-თან ერთად, რაც, თუმცა, რესურსმომხმარებელია და მრავალი მოდელის მეხსიერებაში ჩატვირთვას მოითხოვს. DeepSeek-ის R1 მოდელთან ერთად პოპულარობას იძენს ჯგუფური შედარებითი პოლიტიკის ოპტიმიზაცია (GRPO), რომელიც იყენებს შემოწმებად ჯილდოს ფუნქციებს გარე ჯილდოს მოდელის გარეშე, რაც მნიშვნელოვან გაუმჯობესებას იძლევა. მიუხედავად ამისა, RL სწავლე
TRL და vLLM-ის კოლოკაცია: ხელოვნური ინტელექტის მოდელების წვრთნის რევოლუცია GPU-ების ოპტიმიზაციით
ტრადიციულად, დიდი ენობრივი მოდელების (LLM) GRPO ალგორითმით წვრთნა, vLLM-ის სერვერის რეჟიმში გამოყენებისას, გრაფიკული პროცესორების (GPU) არაეფექტურ გამოყენებას იწვევდა. TRL-ის v0.18.0 ვერსიიდან, vLLM-თან ერთობლივი მუშაობის (კოლოკაციის) მხარდაჭერა საშუალებას იძლევა, წვრთნა და ინფერენცია ერთსა და იმავე GPU-ებზე განხორციელდეს. ეს მიდგომა მნიშვნელოვნად ამცირებს უქმ დროს, აუმჯობესებს გამტარუნარიანობას და ამარტივებს განლაგებას, რაც LLM-ების წვრთნას უფრო სწრაფს, ეკონომიურს და მასშტაბირებადს ხდის.
TRL და vLLM: GPU-ის ეფექტურობის ახალი ერა კოლოკაციის წყალობით
TRL-ის ბიბლიოთეკამ მნიშვნელოვანი სიახლე დანერგა, რაც LLM-ების (დიდი ენობრივი მოდელების) წვრთნის პროცესს vLLM-თან GRPO ალგორითმის გამოყენებით უფრო ეფექტურს ხდის. ადრე vLLM სერვერის რეჟიმში მუშაობდა, რაც GPU-ის რესურსების არაეფექტურ გამოყენებასა და უმოქმედო დროს იწვევდა. ახალი „კოლოკაციის“ რეჟიმი წვრთნისა და ინფერენციის ერთსა და იმავე GPU-ებზე, ერთსა და იმავე პროცესთა ჯგუფში გაშვების საშუალებას იძლევა, რაც მნიშვნელოვნად ზრდის შესრულებას, ამცირებს აპარატურულ დანახარჯებს და ამარტივებს დეპლოირებას.
ღრმა გაძლიერებითი სწავლის კურსი: ღირებულებაზე დაფუძნებული მეთოდები და Q-სწავლება
ეს სტატია ღრმა გაძლიერებითი სწავლის (Deep Reinforcement Learning) კურსის ნაწილია, რომელიც დამწყებიდან ექსპერტამდე დონისთვის არის განკუთვნილი. ის დეტალურად განიხილავს ღირებულებაზე დაფუძნებულ მეთოდებსა და Q-სწავლებას, განმარტავს, თუ როგორ იღებენ RL აგენტები ჭკვიან გადაწყვეტილებებს გარემოსთან ცდისა და შეცდომის გზით ურთიერთქმედებით და ჯილდოების მაქსიმიზაციით. სტატია ასევე ეხება მდგომარეობისა და მოქმედების ღირებულების ფუნქციებს შორის განსხვავებას, პოლიტიკისა და ღირებულების ფუნქციის წვრთნის ნიუანსებს,
Q-სწავლა: ნულიდან RL აგენტის შექმნის გზამკვლევი
აღმოაჩინეთ Q-სწავლის ალგორითმი, ღრმა გაძლიერებითი სწავლის კლასის ფუნდამენტური ნაწილი. ეს სტატია განმარტავს Q-ფუნქციის, Q-ცხრილისა და ეფსილონ-ხარბი სტრატეგიის მუშაობის პრინციპებს, გასწავლით თუ როგორ შექმნათ თქვენი პირველი გაძლიერებითი სწავლის აგენტი ნულიდან და განაახლოთ მისი ქცევის მოდელი გარემოსთან ურთიერთქმედებისას.

Featherless AI Hugging Face Hub-ის მხარდაჭერილი ინფერენს პროვაიდერი გახდა
Featherless AI უერთდება Hugging Face Hub-ის მზარდ ეკოსისტემას, აფართოებს სერვერული ინფერენციის შესაძლებლობებს და მომხმარებლებს სთავაზობს მოდელების შეუდარებელ მრავალფეროვნებას ხელმისაწვდომ ფასად. ის მხარს უჭერს უახლეს ღია კოდის მოდელებს DeepSeek-დან, Meta-დან, Google-დან და Qwen-დან, რაც აერთიანებს მოდელების დიდ არჩევანს სერვერულ ფასებთან.
Cloudflare Workers AI და Hugging Face-ის ინტეგრაცია: ხელმისაწვდომი გენერაციული AI დეველოპერებისთვის
Cloudflare Workers AI-ზე განთავსება დეველოპერებს საშუალებას აძლევს შექმნან მძლავრი გენერაციული AI აპლიკაციები GPU ინფრასტრუქტურისა და სერვერების მართვის გარეშე, ძალიან დაბალი საოპერაციო ხარჯებით. ეს ინტეგრაცია, რომელიც აფართოებს Cloudflare-ისა და Hugging Face-ის სტრატეგიულ პარტნიორობას, გვთავაზობს სერვერების გარეშე (serverless) წვდომას პოპულარულ Hugging Face მოდელებზე, მოთხოვნის მიხედვით გადახდის (pay-per-request) მოდელით, რითაც წყდება GPU-ს სიმცირისა და ფიქსირებული ხარჯების პრობლემა.
Numina-სა და Kimi-ის გუნდი: Kimina-Prover-72B-ის გამოშვება
Numina-მ და Kimi-მ წარმოადგინეს Kimina-Prover-72B, უახლესი ხელოვნური ინტელექტის მოდელი თეორემების დამტკიცებისთვის, რომელიც გაწვრთნილია Kimi k1.5 RL სისტემით და დაფუძნებულია Qwen2.5-72B-ზე. მოდელის ძირითადი ინოვაციებია ტესტირების დროს განმტკიცებითი სწავლის ძიება (TTRL) რთული, მრავალსაფეხურიანი მტკიცებულებებისთვის ლემების გამოყენებით და შეცდომების გამოსწორების შესაძლებლობა, რაც მნიშვნელოვნად ზრდის ეფექტურობას. Kimina-Prover-მა მიაღწია 92.2%-იან უპრეცედენტო წარმატებას miniF2F ბენჩმარკზე, რამაც მას

TRL წარმოგიდგენთ ახალ ალგორითმებს Vision Language მოდელების გასაუმჯობესებლად: MPO, GRPO და GSPO
Vision Language მოდელების (VLM) მუშაობის გაუმჯობესებაზე ფოკუსირებით, TRL-მა წარმოადგინა ინოვაციური ალგორითმები - შერეული პრეფერენციის ოპტიმიზაცია (MPO), ჯგუფური შედარებითი პოლიტიკის ოპტიმიზაცია (GRPO) და ჯგუფური თანმიმდევრობის პოლიტიკის ოპტიმიზაცია (GSPO). ეს მეთოდები სცილდება ტრადიციული DPO-ს ფარგლებს, რაც უზრუნველყოფს უფრო მდიდარი სიგნალების ამოღებას მონაცემებიდან, სტაბილურ წვრთნას და მნიშვნელოვან გაუმჯობესებას მოდელების პასუხებში, განსაკუთრებით მულტიმოდალურ ამოცანებში. მათი ინტეგრაცია TRL-ის

წარმოგიდგენთ kimina-prover-rl-ს: ღია კოდის სასწავლო კონვეიერს Lean 4-ში ფორმალური თეორემების დამტკიცებისთვის
kimina-prover-rl არის ღია კოდის სასწავლო კონვეიერი Lean 4-ში ფორმალური თეორემების დასამტკიცებლად, რომელიც DeepSeek-R1-ის მიერ შთაგონებულ სტრუქტურირებულ მსჯელობა-შემდეგ-გენერაციის პარადიგმას ეფუძნება. ის წარმოადგენს Kimina Prover სისტემის გამარტივებულ ვერსიას, თუმცა ინარჩუნებს ძირითად კომპონენტებს და სრულად თავსებადია Verl ფრეიმვორკთან. მისი მიზანია დიდი ენობრივი მოდელებისთვის (LLMs) ფორმალური დამტკიცების ამოცანების გადაჭრა ასწავლოს, რაც დაგეგმვისა და შესრულების გამიჯვნის ხარჯზე ზრდის ახსნადობას,

Scaleway Hugging Face Hub-ის დასკვნის (Inference) პროვაიდერებს უერთდება
Scaleway, ღრუბლოვანი სერვისების წამყვანი პროვაიდერი, Hugging Face Hub-ის მხარდაჭერილი დასკვნის (Inference) პროვაიდერების ეკოსისტემას შეუერთდა. ეს ინტეგრაცია აფართოებს serverless inference-ის შესაძლებლობებს Hub-ზე, მომხმარებლებს უადვილებს წვდომას პოპულარულ ღია მოდელებზე, როგორიცაა gpt-oss, Qwen3 და Gemma 3. Scaleway გთავაზობთ კონკურენტულ ფასებს, ევროპულ მონაცემთა ცენტრებს და მოწინავე ფუნქციებს, რაც უზრუნველყოფს სწრაფ და უსაფრთხო AI ინფერენსს.
RLOO ტრენერი TRL-ში: RLHF სწავლების გამარტივებული მიდგომა
RLOO (REINFORCE Leave One-Out) არის ახალი ონლაინ RLHF ვარჯიშის ალგორითმი TRL-ში, რომელიც შექმნილია PPO-ს ალტერნატივად. ის გამოირჩევა უფრო მარტივი იმპლემენტაციით, GPU მეხსიერების ნაკლები მოთხოვნილებით და უფრო სწრაფი კონვერგენციით. RLOO ამარტივებს გაძლიერებითი სწავლების ონლაინ მეთოდების კვლევას RLHF კონტექსტში, რაც მას მიმზიდველ გადაწყვეტად აქცევს მაღალი ხარისხის მოდელების ეფექტურად ვარჯიშისთვის.

მანქანური სწავლება Elixir-ში: ახალი შესაძლებლობები Bumblebee-სთან ერთად
Elixir-ის ეკოსისტემაში მანქანური სწავლების მხარდაჭერა მნიშვნელოვნად გაუმჯობესდა ისეთი პროექტების წყალობით, როგორებიცაა Nx, Axon, Explorer და, განსაკუთრებით, Bumblebee. Livebook პლატფორმაში ინტეგრირებული „Smart cells“-ის მეშვეობით, დეველოპერებს შეუძლიათ ნერვული ქსელების ამოცანების სწრაფად ინტეგრირება. Erlang ვირტუალური მანქანის კონკურენტულობისა და დისტრიბუციის წყალობით, ეს მოდელები ადვილად ინტეგრირდება არსებულ Elixir აპლიკაციებში, როგორიცაა Phoenix, Broadway და Nerves, და კომპილირდება როგორც CPU-
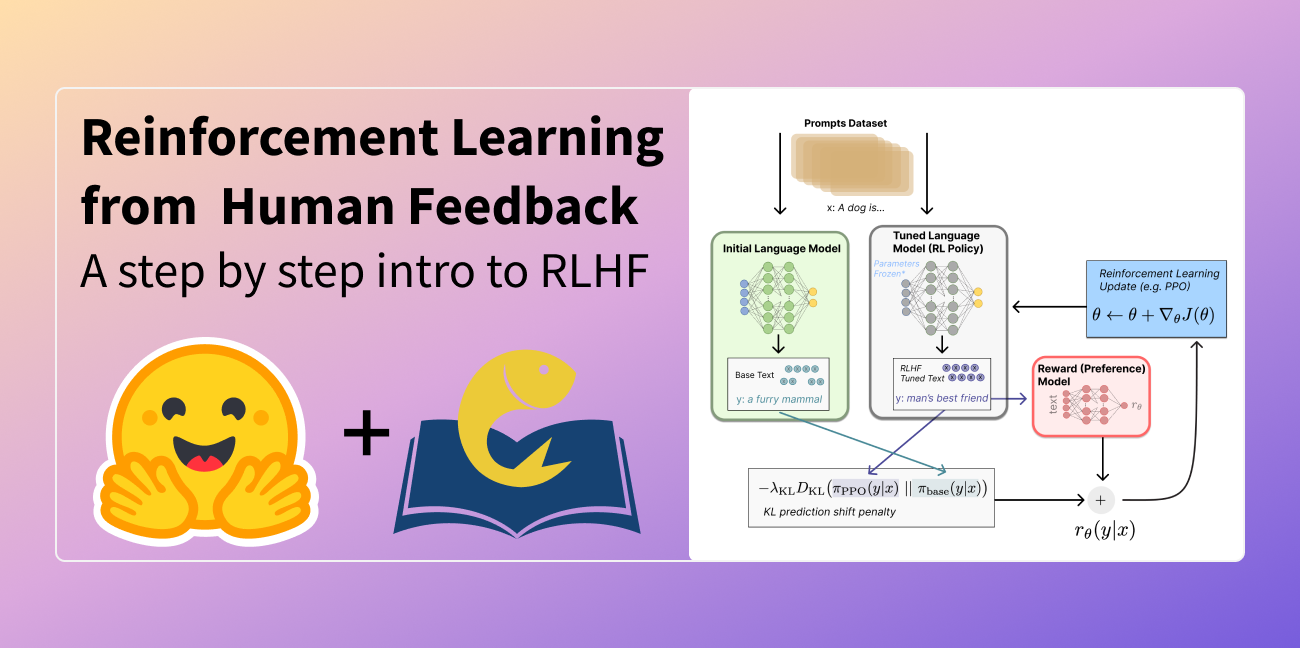
RLHF: როგორ აუმჯობესებს ადამიანის უკუკავშირი ენის მოდელებს?
RLHF (გაძლიერებული სწავლა ადამიანის უკუკავშირით) არის ინოვაციური მეთოდი, რომელიც ენის მოდელებს ადამიანის პრეფერენციებთან მისადაგებაში ეხმარება. ტრადიციული დანაკარგის ფუნქციებისა და მეტრიკების შეზღუდვების საპასუხოდ, RLHF იყენებს გაძლიერებული სწავლის ტექნიკას, რათა უშუალოდ მოახდინოს მოდელების ოპტიმიზაცია ადამიანის უკუკავშირის საფუძველზე. სტატია განმარტავს RLHF-ის კომპლექსურ პროცესს, მათ შორის წინასწარ გაწვრთნილი მოდელების გამოყენებას და ჯილდოს მოდელების შექმნას ადამიანის პრეფერენციების ინტეგრირები