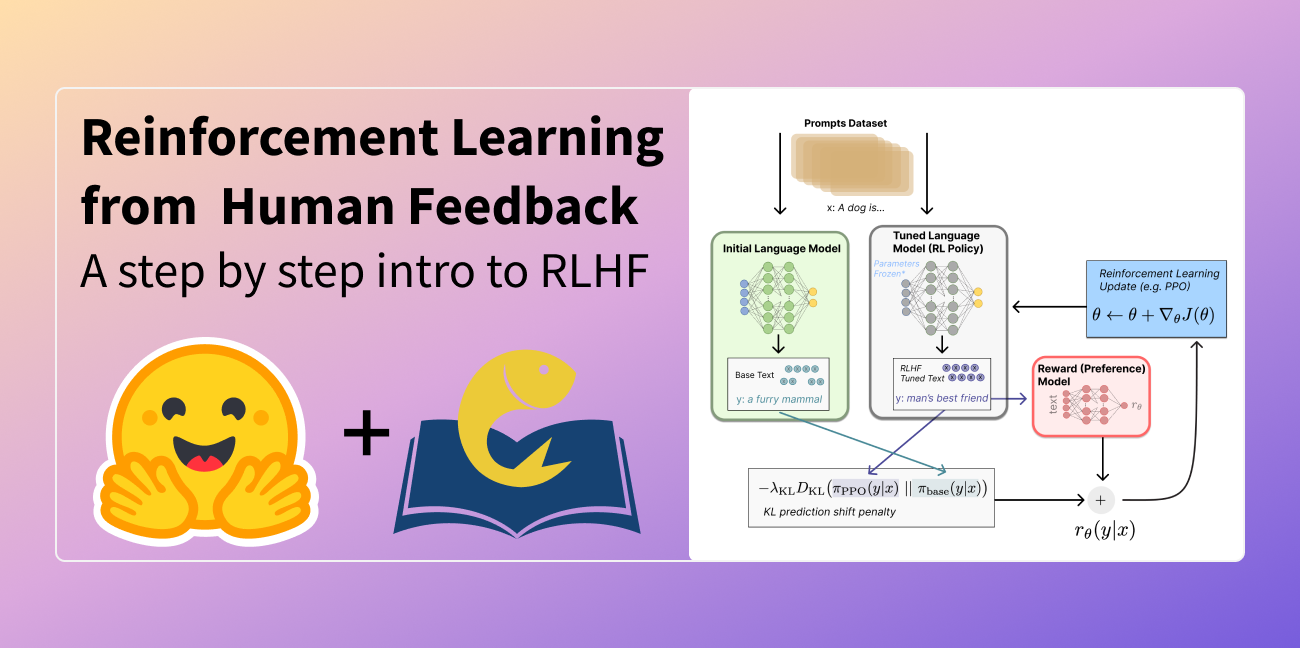
RLHF: როგორ აუმჯობესებს ადამიანის უკუკავშირი ენის მოდელებს?
RLHF (გაძლიერებული სწავლა ადამიანის უკუკავშირით) არის ინოვაციური მეთოდი, რომელიც ენის მოდელებს ადამიანის პრეფერენციებთან მისადაგებაში ეხმარება. ტრადიციული დანაკარგის ფუნქციებისა და მეტრიკების შეზღუდვების საპასუხოდ, RLHF იყენებს გაძლიერებული სწავლის ტექნიკას, რათა უშუალოდ მოახდინოს მოდელების ოპტიმიზაცია ადამიანის უკუკავშირის საფუძველზე. სტატია განმარტავს RLHF-ის კომპლექსურ პროცესს, მათ შორის წინასწარ გაწვრთნილი მოდელების გამოყენებას და ჯილდოს მოდელების შექმნას ადამიანის პრეფერენციების ინტეგრირები
ენის მოდელებმა ბოლო რამდენიმე წლის განმავლობაში შთამბეჭდავი შესაძლებლობები გამოავლინეს, ადამიანის შეყვანილი მოთხოვნებიდან მრავალფეროვანი და დამაჯერებელი ტექსტის გენერირებით. თუმცა, „კარგი“ ტექსტის განსაზღვრა არსებითად რთულია, რადგან ის სუბიექტურია და კონტექსტზეა დამოკიდებული. არსებობს მრავალი აპლიკაცია, მაგალითად, მოთხრობების წერა, სადაც კრეატიულობაა საჭირო; ინფორმაციული ტექსტები, რომლებიც სიმართლეს უნდა შეესაბამებოდეს; ან კოდის ფრაგმენტები, რომლებიც შესრულებადი უნდა იყოს. ამ ატრიბუტების აღსაწერად დანაკარგის ფუნქციის (loss function) დაწერა შეუძლებელი ჩანს და ენის მოდელების უმეტესობა კვლავ მარტივი შემდეგი ტოკენის პროგნოზირების დანაკარგის ფუნქციით (მაგ., ჯვარედინი ენტროპია) ვარჯიშდება. თავად დანაკარგის ფუნქციის ნაკლოვანებების კომპენსირებისთვის, ადამიანები განსაზღვრავენ მეტრიკებს, რომლებიც შექმნილია ადამიანის პრეფერენციების უკეთ აღსაბეჭდად, როგორიცაა BLEU ან ROUGE. მიუხედავად იმისა, რომ შესრულების გაზომვისას ისინი უფრო შესაფერისია, ვიდრე თავად დანაკარგის ფუნქცია, ეს მეტრიკები უბრალოდ ადარებენ გენერირებულ ტექსტს მითითებულ (reference) ტექსტებს მარტივი წესებით და, შესაბამისად, ისინიც შეზღუდულია. არ იქნებოდა შესანიშნავი, თუკი გენერირებული ტექსტისთვის ადამიანის უკუკავშირს გამოვიყენებდით, როგორც შესრულების საზომს, ან კიდევ ერთი ნაბიჯით წინ წავიდოდით და ამ უკუკავშირს გამოვიყენებდით, როგორც დანაკარგს მოდელის ოპტიმიზაციისთვის?
ეს არის ადამიანის უკუკავშირით გაძლიერებული სწავლის (RLHF) იდეა; გამოიყენება გაძლიერებული სწავლის მეთოდები ენის მოდელის პირდაპირი ოპტიმიზაციისთვის ადამიანის უკუკავშირით. RLHF-მა ენის მოდელებს საშუალება მისცა, საერთო ტექსტური მონაცემების კორპუსზე გაწვრთნილი მოდელი კომპლექსურ ადამიანურ ღირებულებებთან შეესაბამებინათ. RLHF-ის უახლესი წარმატება ChatGPT-ში მისი გამოყენება იყო. ChatGPT-ის შთამბეჭდავი შესაძლებლობების გათვალისწინებით, ჩვენ ვთხოვეთ მას, რომ RLHF აეხსნა ჩვენთვის: მან გასაკვირად კარგად გაართვა თავი, მაგრამ ყველაფერი არ მოუცვია. ჩვენ შევავსებთ ამ ხარვეზებს! ადამიანის უკუკავშირით გაძლიერებული სწავლა (RLHF, რომელსაც ასევე მოიხსენიებენ როგორც RL ადამიანის პრეფერენციებიდან) რთული კონცეფციაა, რადგან ის მოიცავს მრავალმოდელურ წვრთნის პროცესს და დანერგვის სხვადასხვა ეტაპს. ამ ბლოგპოსტში, ჩვენ დავყოფთ წვრთნის პროცესს სამ ძირითად ეტაპად:
დასაწყისისთვის, განვიხილავთ, თუ როგორ ხდება ენის მოდელების წინასწარი წვრთნა (pretrain). სასტარტო წერტილად RLHF იყენებს ენის მოდელს, რომელიც უკვე წინასწარ არის გაწვრთნილი კლასიკური წინასწარი წვრთნის მიზნებით (დამატებითი დეტალებისთვის იხილეთ ეს ბლოგპოსტი). OpenAI-მ GPT-3-ის უფრო მცირე ვერსია გამოიყენა თავისი პირველი პოპულარული RLHF მოდელისთვის, InstructGPT-ისთვის. თავიანთ გაზიარებულ ნაშრომებში Anthropic-მა გამოიყენა ტრანსფორმერული მოდელები 10 მილიონიდან 52 მილიარდ პარამეტრამდე, რომლებიც ამ ამოცანისთვის იყო გაწვრთნილი. DeepMind-მა დოკუმენტურად დაადასტურა Gopher-ის 280 მილიარდი პარამეტრის მქონე მოდელის გამოყენება. სავარაუდოა, რომ ყველა ეს კომპანია გაცილებით დიდ მოდელებს იყენებს მათ RLHF-ზე დაფუძნებულ პროდუქტებში. ეს საწყისი მოდელი შეიძლება დამატებით ტექსტზე ან პირობებზე იყოს დაზუსტებული (fine-tuned), თუმცა ეს აუცილებელი არ არის. მაგალითად, OpenAI-მ დაზუსტება მოახდინა ადამიანის მიერ გენერირებულ ტექსტზე, რომელიც „სასურველი“ იყო, ხოლო Anthropic-მა შექმნა თავისი საწყისი LM RLHF-ისთვის ორიგინალური LM-ის „გამოხდით“ (distilling) კონტექსტური მინიშნებებით მათი „სასარგებლო, პატიოსანი და უვნებელი“ კრიტერიუმებისთვის. ეს ორივე არის იმის წყარო, რასაც ჩვენ ძვირადღირებულ, გაფართოებულ მონაცემებად მოვიხსენიებთ, მაგრამ ეს არ არის RLHF-ის გასაგებად აუცილებელი ტექნიკა. RLHF პროცესის დასაწყებად მთავარია გვქონდეს მოდელი, რომელიც კარგად რეაგირებს მრავალფეროვან ინსტრუქციებზე. ზოგადად, არ არსებობს მკაფიო პასუხი, თუ „რომელი მოდელი“ არის საუკეთესო RLHF-ის საწყისი წერტილისთვის. ეს იქნება ამ ბლოგის საერთო თემა – RLHF წვრთნის ოფციების დიზაინის სივრცე საფუძვლიანად არ არის შესწავლილი. შემდეგ, ენის მოდელთან ერთად, საჭიროა მონაცემების გენერირება ჯილდოს მოდელის (reward model) გასაწვრთნელად, რაც გულისხმობს ადამიანის პრეფერენციების სისტემაში ინტეგრაციას.
ადამიანის პრეფერენციებით დაკალიბრებული ჯილდოს მოდელის (RM, რომელსაც ასევე უწოდებენ პრეფერენციების მოდელს) გენერირება არის ის ადგილი, სადაც იწყება RLHF-ში შედარებით ახალი კვლევა. ძირითადი მიზანია მივიღოთ მოდელი ან სისტემა, რომელიც იღებს ტექსტის თანმიმდევრობას და აბრუნებს სკალარულ ჯილდოს, რომელიც რიცხობრივად უნდა წარმოადგენდეს ადამიანის პრეფერენციას. სისტემა შეიძლება იყოს ბოლო-ბოლო ენის მოდელი (end-to-end LM), ან მოდულარული სისტემა, რომელიც ჯილდოს გამოსცემს (მაგ., მოდელი ალაგებს გამომავალ მონაცემებს და დალაგება გარდაიქმნება ჯილდოდ). გამომავალი მონაცემის სკალარული ჯილდოობა გადამწყვეტია არსებული RL ალგორითმების შემდგომ, RLHF პროცესში შეუფერხებლად ინტეგრაციისთვის. ეს ენის მოდელები ჯილდოს მოდელირებისთვის შეიძლება იყოს როგორც კიდევ ერთი დაზუსტებული LM, ასევე ნულიდან გაწვრთნილი LM პრეფერენციების მონაცემებზე. მაგალითად, Anthropic-მა გამოიყენა დაზუსტების სპეციალიზებული მეთოდი ამ მოდელების ინიციალიზაციისთვის წინასწარი წვრთნის შემდეგ (პრეფერენციების მოდელის წინასწარი წვრთნა, PMP), რადგან მათ აღმოაჩინეს, რომ ის უფრო ნიმუშურად ეფექტურია, ვიდრე დაზუსტება, მაგრამ არცერთი საბაზო მოდელი არ ითვლება ჯილდოს მოდელებისთვის საუკეთესო არჩევნად. RM-ისთვის მოთხოვნა-გენერაციის წყვილების სავარჯიშო მონაცემთა ნაკრები გენერირდება წინასწარ განსაზღვრული მონაცემთა ნაკრებიდან მოთხოვნების ნიმუშების აღებით (Anthropic-ის მონაცემები, რომელიც ძირითადად Amazon Mechanical Turk-ზე ჩეთის ხელსაწყოთი იყო გენერირებული, ხელმისაწვდომია Hub-ზე, ხოლო OpenAI-მ გამოიყენა მომხმარებლების მიერ GPT API-სთვის გაგზავნილი მოთხოვნები). მოთხოვნები გადის საწყის ენის მოდელში ახალი ტექსტის გენერირებისთვის. ადამიანური ანოტატორები გამოიყენება ენის მოდელის მიერ გენერირებული ტექსტური გამომავალი მონაცემების დასალაგებლად. თავდაპირველად შეიძლება ვიფიქროთ, რომ ადამიანებმა სკალარული ქულა უშუალოდ უნდა მიანიჭონ თითოეულ ნაწილს
თეგები:
#ხელოვნური ინტელექტი
#openai
#chatgpt
#anthropic
#მანქანური სწავლება
#ტრანსფორმერები
#ენის მოდელები
#deepmind
#rlhf
#უკუკავშირი
#ჯილდოს მოდელი
#instructgpt
წყარო: huggingface.co
AI-ით გადამუშავებული
მსგავსი სტატიები

ხელოვნური ინტელექტი
Anthropic-ის Claude-ის აღზევება Apple App Store-ის რეიტინგებში პენტაგონთან მოლაპარაკებების ფონზე

ხელოვნური ინტელექტი
ტრამპის ადმინისტრაცია Anthropic-ს სანქციებს უწესებს ხელოვნური ინტელექტის გამოყენებაზე უარის გამო: ექსპერტი ინდუსტრიის უსაფრთხოების ხარვეზებზე საუბრობს
ხელოვნური ინტელექტი