დიდი ენობრივი მოდელები: ღია წყაროების რევოლუცია ტექსტის გენერაციაში
სტატია მიმოიხილავს ტექსტის გენერაციისა და კონვერსაციული AI ტექნოლოგიების განვითარებას, ადრეული გამოწვევებიდან უახლეს მიღწევებამდე. ხაზგასმულია მომხმარებლისთვის მოსახერხებელი ინტერფეისების, GPT-4-ის მსგავსი მძლავრი მოდელების და Llama 2-ის მსგავსი ღია წყაროების ალტერნატივების მნიშვნელობა. განმარტებულია მიზეზობრივი ენობრივი მოდელები (Causal Language Models) და Text-to-Text მოდელები, ასევე Fine-tuning-ისა და RLHF-ის როლი მათ გაუმჯობესებაში. აღწერილია წამყვანი ღია წყაროების LLM-ები, მათი უპირატესობებ
პირდაპირი უპირატესობის ოპტიმიზაცია (DPO) LLM-ების დახვეწას ამარტივებს
ეს სტატია წარმოგიდგენთ პირდაპირი უპირატესობის ოპტიმიზაციის (DPO) მეთოდს, რომელიც მნიშვნელოვნად ამარტივებს დიდი ენობრივი მოდელების (LLM) დახვეწის პროცესს. ტრადიციული გაძლიერებითი სწავლისგან ადამიანის უკუკავშირით (RLHF) განსხვავებით, DPO გამორიცხავს ჯილდოს მოდელის შექმნის კომპლექსურ საფეხურს და RL ოპტიმიზაციას, პირდაპირ ახდენს ენობრივი მოდელის ოპტიმიზაციას უპირატესობის მონაცემებზე, ბინარული კროს-ენტროპიის დანაკარგის გამოყენებით. ეს მიდგომა ვარჯიშს უფრო ეფექტურს და ნაკლებად პრობლემურს ხდის, რაც შეს
OpenAI-ის RLHF შედეგების რეპროდუცირება: ტექნიკური დეტალების სიღრმისეული ანალიზი
მოცემული ნაშრომი მიზნად ისახავს OpenAI-ის (OAI) სტილისტური ამოცანების (როგორიცაა სენტიმენტი და აღწერილობითობა) RLHF (Reinforcement Learning from Human Feedback) შედეგების რეპროდუცირებას. ჩვენი კოდების ბაზა OAI-ის კოდების ბაზის თითქმის იდენტურ სწავლის მრუდებს აჩვენებს. სტატია დეტალურად განიხილავს იმპლემენტაციის ტექნიკურ ნიუანსებს, მათ შორის, როგორ გენერირდება ჯილდოები/მნიშვნელობები და პასუხები, შევსების (padding) მექანიზმებს, ლოგიტების გამოთვლას და პასუხების გენერაციის დროს შერჩევის პროცესს. ასევ

LLM-ების ოპტიმიზაცია: TRL-ის ახალი მიდგომა GRPO სწავლების მეხსიერების შესამცირებლად
დიდი ენობრივი მოდელების (LLM) დახვეწა განმტკიცებითი სწავლის (RL) გამოყენებით გადამწყვეტია რთული ქცევების მისაღწევად. ტრადიციულად ამისთვის გამოიყენება PPO ალგორითმი RLHF-თან ერთად, რაც, თუმცა, რესურსმომხმარებელია და მრავალი მოდელის მეხსიერებაში ჩატვირთვას მოითხოვს. DeepSeek-ის R1 მოდელთან ერთად პოპულარობას იძენს ჯგუფური შედარებითი პოლიტიკის ოპტიმიზაცია (GRPO), რომელიც იყენებს შემოწმებად ჯილდოს ფუნქციებს გარე ჯილდოს მოდელის გარეშე, რაც მნიშვნელოვან გაუმჯობესებას იძლევა. მიუხედავად ამისა, RL სწავლე
RLOO ტრენერი TRL-ში: RLHF სწავლების გამარტივებული მიდგომა
RLOO (REINFORCE Leave One-Out) არის ახალი ონლაინ RLHF ვარჯიშის ალგორითმი TRL-ში, რომელიც შექმნილია PPO-ს ალტერნატივად. ის გამოირჩევა უფრო მარტივი იმპლემენტაციით, GPU მეხსიერების ნაკლები მოთხოვნილებით და უფრო სწრაფი კონვერგენციით. RLOO ამარტივებს გაძლიერებითი სწავლების ონლაინ მეთოდების კვლევას RLHF კონტექსტში, რაც მას მიმზიდველ გადაწყვეტად აქცევს მაღალი ხარისხის მოდელების ეფექტურად ვარჯიშისთვის.
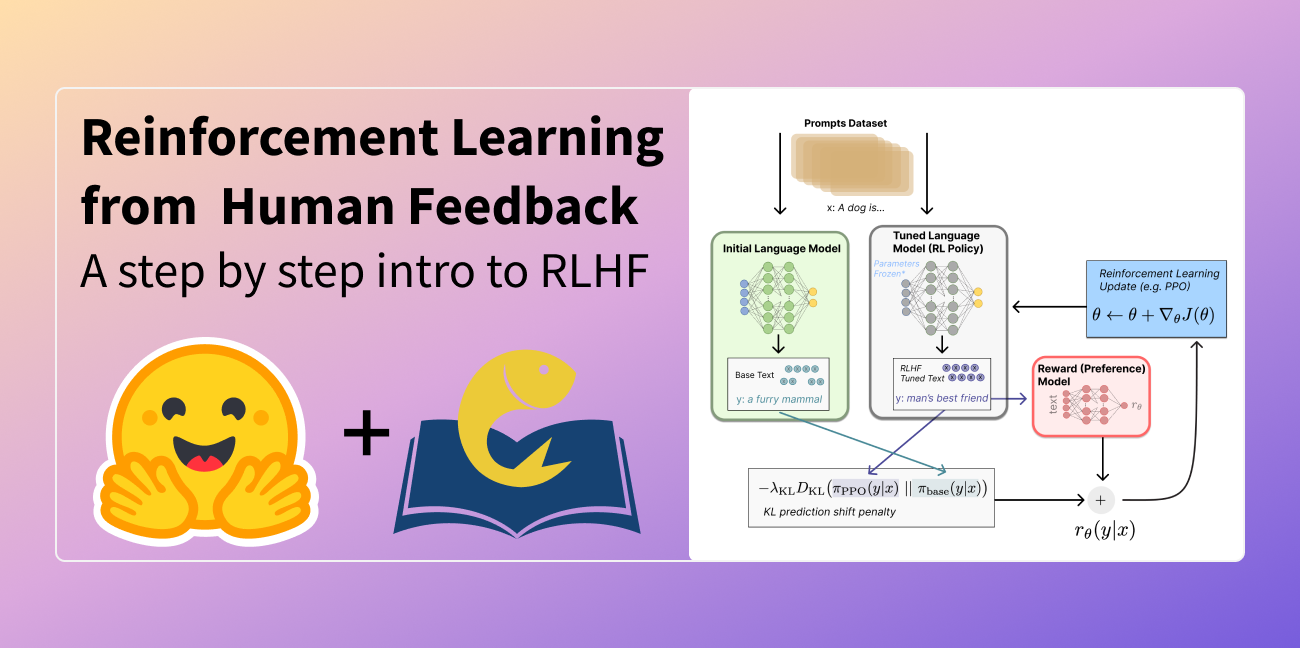
RLHF: როგორ აუმჯობესებს ადამიანის უკუკავშირი ენის მოდელებს?
RLHF (გაძლიერებული სწავლა ადამიანის უკუკავშირით) არის ინოვაციური მეთოდი, რომელიც ენის მოდელებს ადამიანის პრეფერენციებთან მისადაგებაში ეხმარება. ტრადიციული დანაკარგის ფუნქციებისა და მეტრიკების შეზღუდვების საპასუხოდ, RLHF იყენებს გაძლიერებული სწავლის ტექნიკას, რათა უშუალოდ მოახდინოს მოდელების ოპტიმიზაცია ადამიანის უკუკავშირის საფუძველზე. სტატია განმარტავს RLHF-ის კომპლექსურ პროცესს, მათ შორის წინასწარ გაწვრთნილი მოდელების გამოყენებას და ჯილდოს მოდელების შექმნას ადამიანის პრეფერენციების ინტეგრირები
AI თამაშების დიზაინში: ChatGPT, ენობრივი მოდელები და მათი გამოყენება
ეს სტატია აგრძელებს სერიას ხელოვნური ინტელექტის (AI) თამაშების განვითარებაში გამოყენების შესახებ. წინა ნაწილში განვიხილეთ AI ვიზუალური სტილის შესაქმნელად, ახლა კი ყურადღება გამახვილებულია AI-ის თამაშების დიზაინში გამოყენებაზე. კერძოდ, განხილულია, თუ როგორ შეიძლება ChatGPT-ის გამოყენება თამაშის იდეების გენერირებისთვის. სტატია დეტალურად ხსნის, რა არის ენობრივი მოდელი, როგორ მუშაობს ChatGPT (ტრანსფორმერებისა და ადამიანის უკუკავშირით გაძლიერებული სწავლის (RLHF) მექანიზმების ჩათვლით) და რა ხდის მას ა