
ZDNET-ის რეკომენდაციები: როგორ ვირჩევთ საუკეთესო 40-ინჩიან ტელევიზორებს — Sony Bravia 2 II-ის მიმოხილვა
ZDNET დეტალურად განმარტავს თავისი რეკომენდაციების მომზადების მკაცრ მეთოდოლოგიას, რომელიც მოიცავს მრავალსაათიან ტესტირებას, სიღრმისეულ კვლევასა და მომხმარებელთა უკუკავშირის ანალიზს, რათა მკითხველს მიაწოდოს ზუსტი და მიუკერძოებელი ინფორმაცია. სტატია აფასებს 40-ინჩიანი ტელევიზორების ბაზარს და წარმოგიდგენთ Sony Bravia 2 II-ს, როგორც საუკეთესო არჩევანს ამ სეგმენტში, ხაზს უსვამს მის დაბალანსებულ ფასს, 4K რეზოლუციას, 60Hz განახლების სიხშირეს და PS5-ისთვის ექსკლუზიურ VRR მხარდაჭერას. ასევე მოცემულია ინფო
ხელოვნური ინტელექტის შეცდომების გამოსწორება: ინტერაქტიული ასისტენტის ტესტირება Keras Chatbot Arena-ზე
ეს სტატია აღწერს ექსპერიმენტს, რომელიც მიზნად ისახავს შეამოწმოს, რამდენად ეფექტურად შეუძლიათ დიდ ენობრივ მოდელებს (LLM) საკუთარი შეცდომების გამოსწორება მარტივი ინგლისური უკუკავშირის საფუძველზე. ავტორი ქმნის სპეციალურ გარემოს Gradio-ზე Spaces-ით, Keras-ის, JAX-ისა და TPUs-ის გამოყენებით, რათა ერთდროულად რამდენიმე ჩეთბოტთან იმუშაოს და შეაფასოს მათი უნარი, მოახდინონ API ზარების გენერირება და შეასწორონ შეცდომები. განხილულია ტექნიკური დეტალები და მიდგომები მოდელების მრავალ ბირთვზე ოპტიმიზაციისთვის, მ
პირდაპირი უპირატესობის ოპტიმიზაცია (DPO) LLM-ების დახვეწას ამარტივებს
ეს სტატია წარმოგიდგენთ პირდაპირი უპირატესობის ოპტიმიზაციის (DPO) მეთოდს, რომელიც მნიშვნელოვნად ამარტივებს დიდი ენობრივი მოდელების (LLM) დახვეწის პროცესს. ტრადიციული გაძლიერებითი სწავლისგან ადამიანის უკუკავშირით (RLHF) განსხვავებით, DPO გამორიცხავს ჯილდოს მოდელის შექმნის კომპლექსურ საფეხურს და RL ოპტიმიზაციას, პირდაპირ ახდენს ენობრივი მოდელის ოპტიმიზაციას უპირატესობის მონაცემებზე, ბინარული კროს-ენტროპიის დანაკარგის გამოყენებით. ეს მიდგომა ვარჯიშს უფრო ეფექტურს და ნაკლებად პრობლემურს ხდის, რაც შეს

TGI ახლა პირდაპირ მხარს უჭერს Intel Gaudi აპარატურას
გაცხადდა Intel Gaudi აპარატურის სრული ინტეგრაცია TGI-ის ძირითად კოდბაზაში, რაც გამორიცხავს ცალკეული „ფორკების“ საჭიროებას. ეს ახალი მრავალბექენდური არქიტექტურა ამარტივებს გამოყენებას, უზრუნველყოფს TGI-ის უახლეს ფუნქციებზე წვდომას და ოპტიმიზაციას უკეთებს დიდი ენობრივი მოდელების (LLMs) მუშაობას Gaudi მოწყობილობებზე. განცხადება ასევე ხაზს უსვამს მოწინავე ფუნქციებს, მოსალოდნელ მოდელებს და საზოგადოებისგან უკუკავშირის მიღების მოწვევას.
ხელოვნური ინტელექტის მორგება ღია მოდელებზე: კონსტიტუციური AI და ახალი ინსტრუმენტი llm-swarm
სტატია წარმოგიდგენთ კონსტიტუციურ ხელოვნურ ინტელექტს (CAI), როგორც დიდი ენობრივი მოდელების (LLMs) მომართვის ინოვაციურ ტექნიკას მომხმარებლის მიერ განსაზღვრული პრინციპების გამოყენებით, რაც მნიშვნელოვნად ამცირებს ძვირადღირებული ადამიანური უკუკავშირის საჭიროებას. იგი გვთავაზობს CAI-ის ღია მოდელებით განხორციელების სრულყოფილ გზამკვლევს, მათ შორის ახალ ინსტრუმენტ llm-swarm-ს მასშტაბური სინთეზური მონაცემების გენერირებისთვის. განხილულია CAI მონაცემთა ნაკრებების შექმნისა და მოდელების, მაგალითად Mistral-7B-
კონსტიტუციური ხელოვნური ინტელექტი: ღია მოდელების თვითგასწორება და ახალი ინსტრუმენტი „llm-swarm“
Anthropic-ის მიერ შემოთავაზებული კონსტიტუციური ხელოვნური ინტელექტის (CAI) ტექნიკა LLM-ებს აძლევს საშუალებას, თავად შეაფასონ და გააუმჯობესონ საკუთარი გამომუშავება მომხმარებლის მიერ განსაზღვრული პრინციპების მიხედვით. ეს მიდგომა მნიშვნელოვნად ამცირებს ძვირადღირებული ადამიანური უკუკავშირის საჭიროებას. მოცემულ ნაშრომში აღწერილია კონსტიტუციური AI-ის სრულყოფილი განხორციელების რეცეპტი ღია მოდელებით, ასევე წარმოდგენილია ახალი ინსტრუმენტი „llm-swarm“, რომელიც GPU Slurm კლასტერებს იყენებს სკალირებადი სინთე
Hugging Face-ის მულტიმოდალური სწავლის ჯგუფი ხელოვნური ინტელექტის ეთიკურ პრინციპებს აფორმალებს
Hugging Face-ის მულტიმოდალური სწავლის ჯგუფმა დაასახელა ეთიკური პრინციპები თავისი ხელოვნური ინტელექტის პროექტისთვის, რაც მიზნად ისახავს გამჭვირვალობის, ადრეული უკუკავშირისა და პოტენციური ზიანის შემცირების უზრუნველყოფას. დოკუმენტი აღიარებს „ეთიკური ხელოვნური ინტელექტის“ არასრულყოფილ დეფინიციას და ხაზს უსვამს რისკებისა და სარგებლის შეფასების აუცილებლობას თითოეულ კონკრეტულ შემთხვევაში, ამასთან ერთად აცხადებს, რომ ეს არის მუშა პროცესში არსებული დოკუმენტი.
Twitter-ზე სენტიმენტების ანალიზი: დამწყებთათვის სრული გზამკვლევი
ეს გზამკვლევი მოიცავს ყველაფერს, რაც უნდა ისწავლოთ Twitter-ზე სენტიმენტების ანალიზის დასაწყებად, როგორც პროგრამისტებისთვის, ასევე არაპროგრამისტებისთვის. თქვენ გაეცნობით Inference API-ის გამოყენებას კოდის რამდენიმე ხაზით ან Zapier-ის, უ-კოდო ხელსაწყოს მეშვეობით, ტვიტების შესაგროვებლად, გასაანალიზებლად და შედეგების Google Sheets-ში გასაგზავნად. ისწავლეთ, როგორ გამოიყენოთ მანქანური სწავლება ბრენდის მონიტორინგისთვის და მომხმარებლის უკუკავშირის გასაანალიზებლად.
Twitter-ზე სენტიმენტების ანალიზი: სრული გზამკვლევი
ეს გზამკვლევი წარმოგიდგენთ Twitter-ზე სენტიმენტების ანალიზის ყოვლისმომცველ, ნაბიჯ-ნაბიჯ პროცესს, რომელიც განკუთვნილია როგორც პროგრამისტებისთვის, ასევე არაპროგრამისტებისთვის. ის განმარტავს სენტიმენტების ანალიზის არსს, მის მნიშვნელობას ბიზნესისთვის და გვიჩვენებს, თუ როგორ შეიძლება ისეთი ხელსაწყოების გამოყენება, როგორიცაა Inference API, Zapier და Python-ის ბიბლიოთეკები, რათა ტვიტებიდან ღირებული ინფორმაცია მოვიპოვოთ, მომხმარებელთა უკუკავშირი აღმოვაჩინოთ და ბრენდის ხსენებებს რეალურ დროში დავაკვირდეთ.
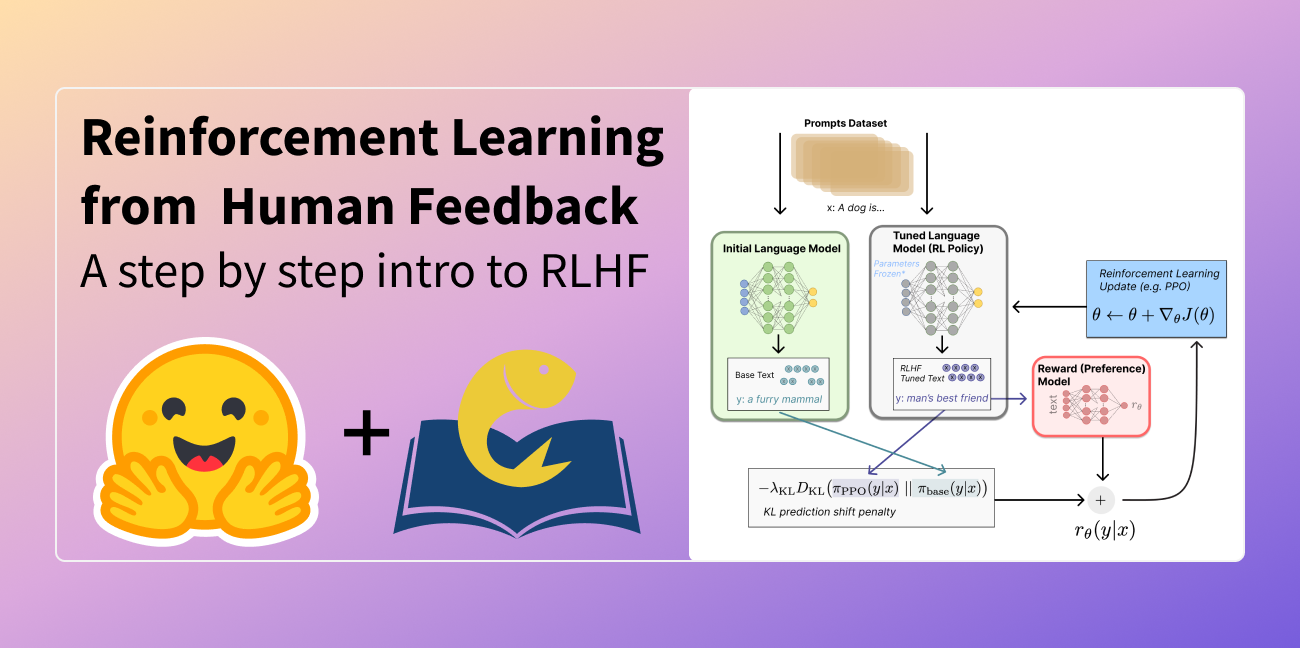
RLHF: როგორ აუმჯობესებს ადამიანის უკუკავშირი ენის მოდელებს?
RLHF (გაძლიერებული სწავლა ადამიანის უკუკავშირით) არის ინოვაციური მეთოდი, რომელიც ენის მოდელებს ადამიანის პრეფერენციებთან მისადაგებაში ეხმარება. ტრადიციული დანაკარგის ფუნქციებისა და მეტრიკების შეზღუდვების საპასუხოდ, RLHF იყენებს გაძლიერებული სწავლის ტექნიკას, რათა უშუალოდ მოახდინოს მოდელების ოპტიმიზაცია ადამიანის უკუკავშირის საფუძველზე. სტატია განმარტავს RLHF-ის კომპლექსურ პროცესს, მათ შორის წინასწარ გაწვრთნილი მოდელების გამოყენებას და ჯილდოს მოდელების შექმნას ადამიანის პრეფერენციების ინტეგრირები
AI თამაშების დიზაინში: ChatGPT, ენობრივი მოდელები და მათი გამოყენება
ეს სტატია აგრძელებს სერიას ხელოვნური ინტელექტის (AI) თამაშების განვითარებაში გამოყენების შესახებ. წინა ნაწილში განვიხილეთ AI ვიზუალური სტილის შესაქმნელად, ახლა კი ყურადღება გამახვილებულია AI-ის თამაშების დიზაინში გამოყენებაზე. კერძოდ, განხილულია, თუ როგორ შეიძლება ChatGPT-ის გამოყენება თამაშის იდეების გენერირებისთვის. სტატია დეტალურად ხსნის, რა არის ენობრივი მოდელი, როგორ მუშაობს ChatGPT (ტრანსფორმერებისა და ადამიანის უკუკავშირით გაძლიერებული სწავლის (RLHF) მექანიზმების ჩათვლით) და რა ხდის მას ა
MIT-ის კვლევა: დიდი ენის მოდელების (LLM) რეიტინგები საოცრად მგრძნობიარეა მომხმარებლის უკუკავშირის მიმართ
MIT-ის მკვლევრებმა აღმოაჩინეს, რომ დიდი ენის მოდელების (LLM) რეიტინგული პლატფორმები საოცრად მგრძნობიარეა მომხმარებლის უკუკავშირის მიმართ. მათმა კვლევამ აჩვენა, რომ კრაუდსორსინგული მონაცემების მცირე ნაწილის ამოღებასაც კი შეუძლია რეიტინგების შეცვლა, რამაც შესაძლოა კომპანიები შეცდომაში შეიყვანოს საუკეთესო მოდელის არჩევისას. მკვლევრებმა შეიმუშავეს ეფექტური მეთოდი, რომელიც ავლენს შედეგების დამახინჯებაზე პასუხისმგებელ ინდივიდუალურ შეფასებებს, რაც ხაზს უსვამს რეიტინგების შეფასების უფრო მკაცრი სტრატეგიე