Hugging Face-მა ახალი ბიბლიოთეკა Skops წარადგინა: scikit-learn მოდელების ჰოსტინგი და თანამშრომლობა გაუმჯობესდა
Hugging Face-მა წარმოადგინა Skops, ახალი ბიბლიოთეკა, რომელიც შექმნილია scikit-learn მოდელების Hugging Face Hub-ზე განთავსების პროცესის გასამარტივებლად. Skops უზრუნველყოფს მოდელების უსაფრთხო ჰოსტინგს, დოკუმენტაციას მოდელის ბარათების მეშვეობით და გაუმჯობესებულ თანამშრომლობას, რითაც ღია კოდის მანქანური სწავლების პროექტებისთვის რეპროდუცირებადობა და ახსნადობა უფრო ხელმისაწვდომი ხდება.

Hugging Face-ის Trackio: ახალი ღია კოდის გადაწყვეტა მანქანური სწავლის ექსპერიმენტების თრექინგისთვის
Trackio არის Hugging Face-ის მიერ შემუშავებული ღია კოდის Python ბიბლიოთეკა მანქანური სწავლის მოდელების ვარჯიშის პროგრესის თრექინგისთვის. ის გვთავაზობს მარტივ გაზიარებას, მონაცემთა ხელმისაწვდომობას, ენერგიის მოხმარების გამჭვირვალობას და მოქნილობას ექსპერიმენტებისთვის. ბიბლიოთეკა, რომელიც თავსებადია ისეთ ინსტრუმენტებთან, როგორიცაა wandb, საშუალებას გაძლევთ ადვილად ვიზუალიზაცია მოახდინოთ Gradio დაფაზე და სინქრონიზაცია გაუკეთოთ Hugging Face Spaces-ს.
Hugging Face წარმოგიდგენთ Trackio-ს: ღია კოდის ბიბლიოთეკა ML ექსპერიმენტების მარტივი თვალთვალისთვის
Hugging Face-ის გუნდმა შეიმუშავა Trackio, ღია კოდის Python ბიბლიოთეკა მანქანური სწავლების ექსპერიმენტების თვალთვალისთვის. ის გამოირჩევა გაზიარების სიმარტივით, მონაცემთა ხელმისაწვდომობითა და მოქნილობით. Trackio იყენებს ლოკალურ Gradio დაფას, რომელიც შეიძლება სინქრონიზდეს Hugging Face Spaces-თან, რაც მომხმარებლებს საშუალებას აძლევს მარტივად გააზიარონ პროგრესი. ის ინტეგრირდება Hugging Face-ის სხვა ბიბლიოთეკებთან და მიზნად ისახავს საზოგადოების ჩართულობით განვითარებას, როგორც მსუბუქი და გამჭვირვალე ალ
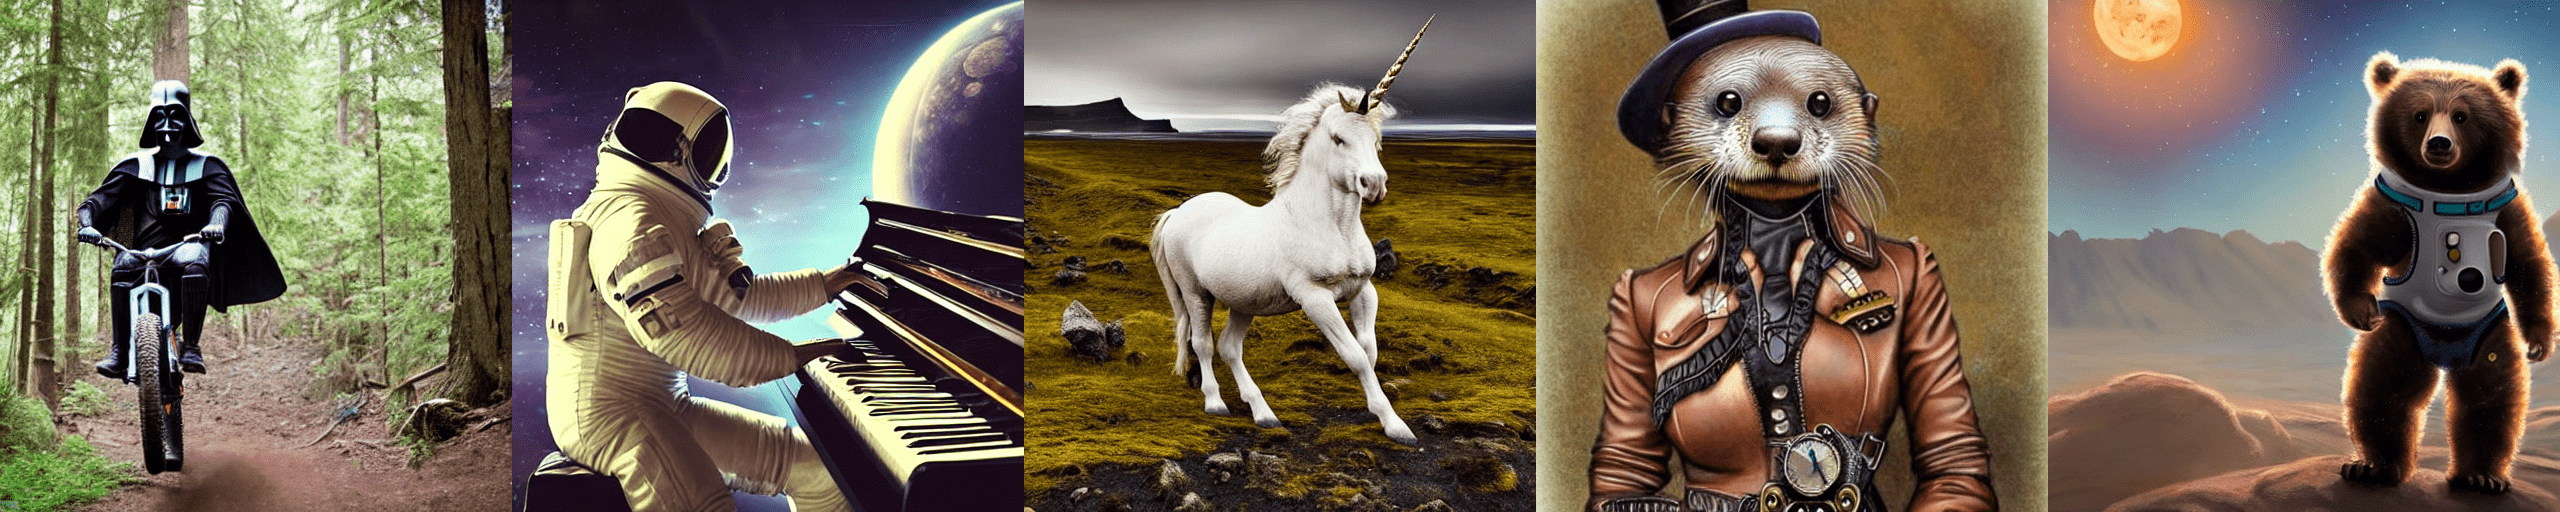
Stable Diffusion: ტექსტიდან გამოსახულების გენერირების მოდელის გამოყენების გზამკვლევი
Stable Diffusion არის მოწინავე ტექსტიდან გამოსახულების გენერირების ლატენტური დიფუზიური მოდელი, შექმნილი CompVis-ის, Stability AI-სა და LAION-ის მკვლევრებისა და ინჟინრების მიერ. ის გაწვრთნილია LAION-5B მონაცემთა ბაზის ქვესიმრავლიდან მიღებულ 512x512 ზომის სურათებზე. ეს სტატია დეტალურად განმარტავს, თუ როგორ გამოვიყენოთ Stable Diffusion 🧨 Diffusers ბიბლიოთეკასთან ერთად, როგორ მუშაობს მოდელი და როგორ შეიძლება მისი გენერირების კონვეიერის მორგება. ასევე განხილულია ლიცენზირების, ინფერენციის ნაბიჯების, g
როგორ გავუშვათ მასშტაბური ენობრივი მოდელები მომხმარებლის აპარატურაზე: Hugging Face-ის Accelerate
Meta AI-მ და BigScience-მა ცოტა ხნის წინ საჯაროდ ხელმისაწვდომი გახადეს ძალიან დიდი ენობრივი მოდელები, რომლებიც მომხმარებლის უმეტესი აპარატურის მეხსიერებაში (RAM ან GPU) არ ეტევა. Hugging Face-ის Accelerate ბიბლიოთეკა გვთავაზობს ინოვაციურ გადაწყვეტებს, მათ შორის PyTorch-ის „მეტა მოწყობილობის“ გამოყენებას და ავტომატურ მოწყობილობათა რუკას, რათა შესაძლებელი გახდეს ამ მოდელების ეფექტურად ჩატვირთვა და გაშვება შეზღუდული RAM-ისა და GPU მეხსიერების პირობებშიც კი. ეს მეთოდები საშუალებას იძლევა უზარმაზარი
„Transformers Agents 2.0“-ის (ახლა უკვე smolagents!) გამოშვება: აგენტების ახალი, მძლავრი ჩარჩო
Hugging Face-ი აცხადებს „Transformers Agents 2.0“-ის გამოშვებას, რომელიც ახლა დამოუკიდებელი ბიბლიოთეკა smolagents-ის სახით არის ხელმისაწვდომი. ეს განახლება წარმოგიდგენთ აგენტების ახალ ტიპებს, რომლებსაც შეუძლიათ წარსული დაკვირვებების საფუძველზე იტერაცია მოახდინონ რთული ამოცანების გადასაჭრელად, გამოირჩევიან გაუმჯობესებული შესრულებით (Llama-3-70B-Instruct აგენტები GPT-4-ზე უკეთეს შედეგებს აჩვენებენ GAIA Leaderboard-ზე) და აქცენტი კეთდება კოდის სიცხადეზე, მოდულარულობაზე და საზოგადოების ჩართულობაზე გ

მორგებული CUDA ბირთვები: შექმნა, ოპტიმიზაცია და განთავსება kernel-builder-ის გამოყენებით
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ გამოიყენოთ kernel-builder ბიბლიოთეკა მორგებული CUDA ბირთვების შესაქმნელად PyTorch-ისთვის. ის მოიცავს ნაბიჯებს ადგილობრივი განვითარებიდან მრავალ არქიტექტურაზე აწყობამდე, ეფექტური და შენარჩუნებადი სისტემების შექმნას, PyTorch-ის C++ API-ის გამოყენებით ფუნქციების მშობლიურ ოპერატორებად რეგისტრაციას და `nix` გარემოს გამოყენებას რეპროდუცირებადი აწყობის პროცესისთვის. ასევე განხილულია ბირთვების ოპტიმიზაცია, განთავსების გამოწვევები და მათი გაზიარება დეველოპერულ

Bloom მოდელის ოპტიმიზაცია: გზა 5x შეყოვნების შემცირებამდე და 50x გამტარუნარიანობამდე
ამ სტატიაში განხილულია Bloom-ის დიდი ენობრივი მოდელის (LLM) ოპტიმიზაციის პროცესი, რამაც გამოიწვია ინფერენციის შეყოვნების 5-ჯერ შემცირება და გამტარუნარიანობის 50-ჯერ გაზრდა. აღწერილია გამოწვევები, მათ შორის მოდელის `transformers` ბიბლიოთეკაში პორტირება, მკაცრი ტესტირების ნაკრების შექმნა, მონაცემთა სხვადასხვა ტიპებთან (bfloat16 vs float16) მუშაობა და ტენზორული პარალელიზმის საკითხები. საბოლოოდ, განიხილება ისეთი გადაწყვეტილებები, როგორიცაა `Megatron-Deepspeed` ტრენინგისთვის, მცირე მოდელების გამოყენე
BLOOM მოდელის ოპტიმიზაცია: 5-ჯერ შემცირებული ლატენტურობა და 50-ჯერ გაზრდილი გამტარუნარიანობა
ამ სტატიაში აღწერილია BLOOM მოდელის ინფერენსის სიჩქარის გაუმჯობესების რთული, მაგრამ წარმატებული პროცესი, რამაც გამოიწვია ლატენტურობის 5-ჯერ შემცირება და გამტარუნარიანობის 50-ჯერ გაზრდა. განხილულია მოდელის „ტრანსფორმერების“ ბიბლიოთეკასთან ადაპტაციის, ტესტირებისა და განაწილებული ინფერენსისთვის მომზადების ეტაპები, გამოწვევები და გადაწყვეტილებები.
PyTorch-ის განაწილებული წვრთნა: DDP-დან Accelerate-მდე
ეს სტატია განიხილავს PyTorch-ში მრავალ GPU-ზე მოდელის წვრთნის პროცესს Distributed Data Parallelism (DDP) მექანიზმის გამოყენებით. მოცემულია საბაზისო კოდის მაგალითები და ნაჩვენებია, თუ როგორ ამარტივებს `torch.distributed` და შემდგომში `Accelerate` ბიბლიოთეკა ამ პროცესს, რაც საშუალებას იძლევა ეფექტური განაწილებული წვრთნისთვის კოდის მინიმალური ცვლილებებით. ასევე განხილულია მონაცემთა მილსადენის გაუმჯობესება და Jupyter Notebook-თან ინტეგრაცია.
Hugging Face-ის ბიბლიოთეკაში ენის მოდელების მიკერძოების შეფასების ახალი მეტრიკები დაემატა
Hugging Face-მა თავის 🤗 Evaluate ბიბლიოთეკას დაამატა ახალი მეტრიკები და საზომები, რომლებიც მიმართულია ენის მოდელებში (როგორიცაა GPT-2 და BLOOM) არსებული მიკერძოებების შესასწავლად. ეს ხელსაწყოები საშუალებას იძლევა შეფასდეს ტოქსიკურობა, პოლარობა და მტკივნეულობა (hurtfulness), რითაც ხელს უწყობს ენის მოდელებში დაშიფრული სოციალური საკითხების უკეთ გაგებას და მათთან ბრძოლას. სტატია დეტალურად განიხილავს ამ ხელსაწყოების გამოყენებას სხვადასხვა ამოცანებში.

swift-transformers 1.0: ლოკალური ხელოვნური ინტელექტის ახალი ერა Apple Silicon-ზე
`swift-transformers` ბიბლიოთეკამ გამოუშვა ვერსია 1.0, რაც მის სტაბილურობასა და Apple Silicon პლატფორმებზე, iPhone-ების ჩათვლით, ლოკალური მანქანური სწავლების მოდელების უწყვეტი ინფერენციის მხარდაჭერის მზადყოფნას ადასტურებს. განახლება მიზნად ისახავს საზოგადოებისთვის მაქსიმალური სარგებლის მოტანას, მომავალი განვითარების საფუძვლების ჩაყრას და განსაკუთრებულ ყურადღებას უთმობს MLX-სა და აგენტურ გამოყენების შემთხვევებს.
Hugging Face-ის 🤗 Datasets: აუდიო მონაცემთა ნაკრებების ჩამოტვირთვა და დამუშავება
🤗 Datasets წარმოადგენს ღია კოდის ბიბლიოთეკას, რომელიც უზრუნველყოფს სხვადასხვა სფეროდან მონაცემთა ნაკრებების მარტივად ჩამოტვირთვასა და მომზადებას. მისი მინიმალისტური API მომხმარებლებს საშუალებას აძლევს, ერთი ხაზის კოდით მოამზადონ მონაცემები, განსაკუთრებული ყურადღება ეთმობა აუდიო მონაცემთა დამუშავებას. Hugging Face Hub-თან ინტეგრაციის წყალობით, ბიბლიოთეკა მკვლევრებსა და პრაქტიკოსებს სთავაზობს უპრეცედენტო რაოდენობის აუდიო მონაცემთა ნაკრებებს.
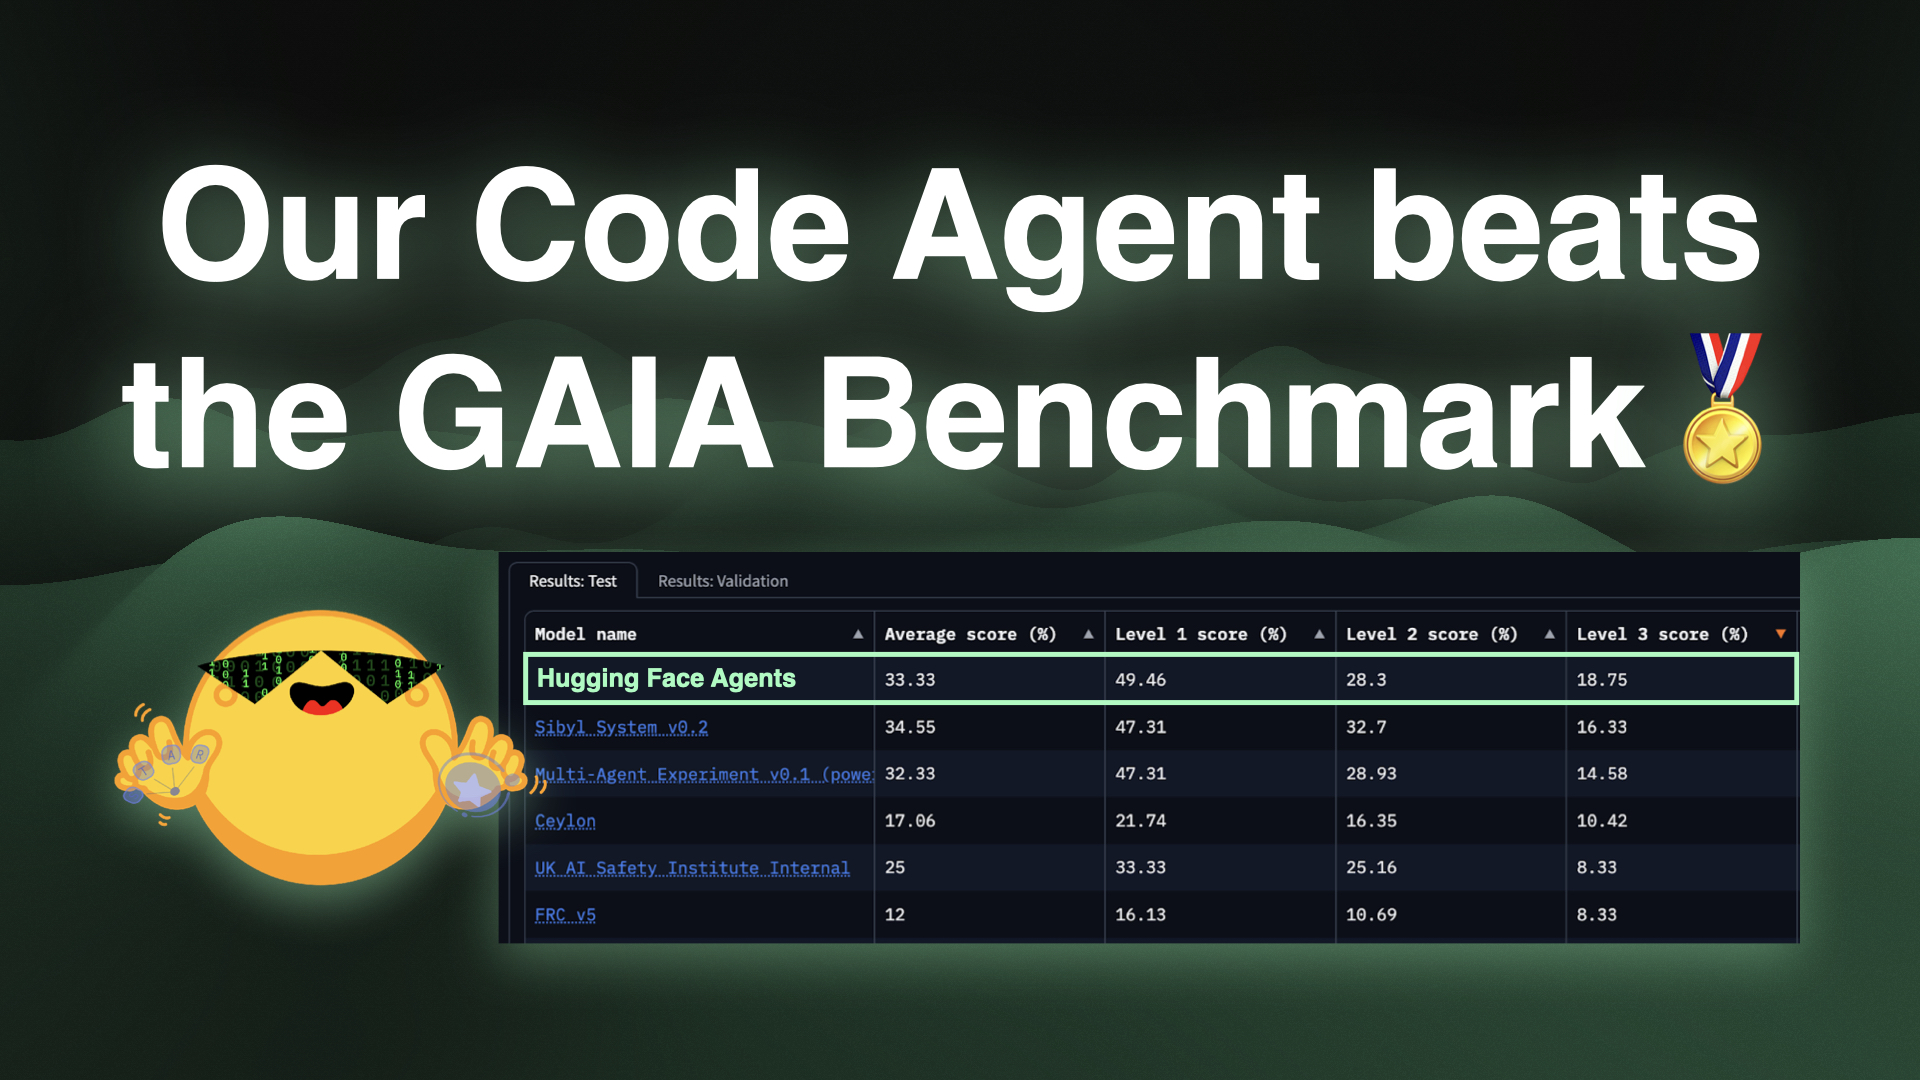
Transformers Agents-ის ტრიუმფი GAIA ბენჩმარკზე: აგენტური სისტემების ახალი ერა
ექსპერიმენტების სერიის შემდეგ, ჩვენზე დიდი შთაბეჭდილება მოახდინა Transformers Agents-ის შესაძლებლობებმა აგენტური სისტემების შექმნაში. GAIA ბენჩმარკზე, რომელიც ყველაზე რთულ და ყოვლისმომცველ აგენტურ ბენჩმარკად ითვლება, ბიბლიოთეკის გამოყენებით შექმნილმა Code Agent-მა მოწინავე პოზიციები დაიკავა. აღნიშნული ფრეიმვორკი, transformers.agents, ახლა განახლებულია და ფუნქციონირებს, როგორც დამოუკიდებელი ბიბლიოთეკა smolagents. სტატია განმარტავს აგენტების კონცეფციას, როგორც LLM-ზე დაფუძნებულ სისტემებს, რომლებსა
smolagents-მა GAIA ბენჩმარკზე საუკეთესო შედეგი აჩვენა
ექსპერიმენტების შემდეგ, Transformers აგენტების (ახლა უკვე smolagents ბიბლიოთეკა) მიერ აგებული აგენტური სისტემების შესაძლებლობებით მოხიბლულებმა, გადავწყვიტეთ შეგვემოწმებინა მათი ეფექტურობა. ჩვენ გამოვცადეთ ბიბლიოთეკის გამოყენებით შექმნილი კოდის აგენტი GAIA ბენჩმარკზე, რომელიც ითვლება აგენტების ყველაზე რთულ და ყოვლისმომცველ ტესტად, და საბოლოოდ, საუკეთესო შედეგი ვაჩვენეთ. სტატია განმარტავს, თუ რა არის აგენტები, როგორ აძლევენ ისინი LLM-ებს სუპერ შესაძლებლობებს და რა ინსტრუმენტები გამოიყენეს GAIA-ს რ
TRL ბიბლიოთეკა DPO-ს მხარდაჭერას იწყებს ვიზუალური ენობრივი მოდელებისთვის (VLM-ები)
უპირატესობების ოპტიმიზაცია, რომელიც ფართოდ გამოიყენება ენობრივი მოდელების დასახვეწად, ახლა ვრცელდება ვიზუალურ ენობრივ მოდელებზე (VLM-ები) TRL ბიბლიოთეკის მეშვეობით. TRL-მა დაამატა პირდაპირი უპირატესობის ოპტიმიზაციის (DPO) მხარდაჭერა VLM-ებისთვის, რაც საშუალებას იძლევა მოდელების გაწვრთნას მომხმარებლის პრეფერენციების ამსახველი მონაცემებით. სტატია დეტალურად აღწერს VLM-ების DPO-ით გაწვრთნის პროცესს, მონაცემთა ნაკრების მომზადებიდან (მაგ., `openbmb/RLAIF-V-Dataset`) და მეხსიერების ოპტიმიზაციის ტექნიკე
როგორ ვავარჯიშოთ ვიზუალურ-ენობრივი მოდელები (VLMs) TRL-ისა და DPO-ს გამოყენებით
უპირატესობის ოპტიმიზაცია ფართოდ გამოიყენება ენობრივი მოდელების დაზუსტებისთვის, თუმცა მისი გამოყენება შესაძლებელია ვიზუალურ-ენობრივი მოდელებისთვისაც (VLM). TRL ბიბლიოთეკა ახლა უკვე პირდაპირი უპირატესობის ოპტიმიზაციას (DPO) უჭერს მხარს VLMs-ისთვის. ეს სტატია დაწვრილებით განგიმარტავთ VLMs-ის წვრთნის პროცესს TRL-ისა და DPO-ს გამოყენებით, მონაცემთა მომზადებიდან დაწყებული მეხსიერების ოპტიმიზაციის ტექნიკების ჩათვლით.

Sentence Transformers Hugging Face-ის ოჯახს უერთდება
Sentence Transformers (SBERT), სემანტიკური მნიშვნელობის მქონე მაღალი ხარისხის ემბედინგების გენერირების პოპულარული ღია კოდის ბიბლიოთეკა, ოფიციალურად შეუერთდა Hugging Face-ის ოჯახს. 2019 წელს ნილს რაიმერსის მიერ დაარსებული პროექტი ფართოდ გამოიყენება ბუნებრივი ენის დამუშავების (NLP) ამოცანებში და უკვე 16,000-ზე მეტ მოდელს მოიცავს, რომლებიც ყოველთვიურად მილიონობით მომხმარებელს ემსახურება. Hugging Face პირობას დებს, რომ გააგრძელებს პროექტის ზრდისა და ინოვაციების მხარდაჭერას, ამავდროულად შეინარჩუნებს

Nvidia-ს ბრალი ედება ხელოვნური ინტელექტის მოდელების გასაწვრთნელად პირატული წიგნების გამოყენებაში
განახლებული სარჩელის მიხედვით, Nvidia-ს ბრალი ედება მილიონობით პირატული წიგნის შეგნებულად გამოყენებაში თავისი ხელოვნური ინტელექტის მოდელების გასაწვრთნელად, მას შემდეგ, რაც კომპანია დაუკავშირდა საკამათო „ჩრდილოვან ბიბლიოთეკას“ Anna’s Archive. ავტორები საავტორო უფლებების დარღვევისთვის კომპენსაციას ითხოვენ. ეს ფაქტი კითხვებს აჩენს ტექნოლოგიური კომპანიების ეთიკისა და მონაცემების მიმართ სასოწარკვეთილების შესახებ, მიუხედავად იმისა, რომ მათ გაფრთხილება ჰქონდათ მიღებული შინაარსის უკანონობის შესახებ.