
Optimum-NVIDIA: LLM-ის ინფერენსის რევოლუციური აჩქარება NVIDIA პლატფორმაზე
Hugging Face-ის Optimum-NVIDIA ბიბლიოთეკა მნიშვნელოვნად აჩქარებს დიდი ენობრივი მოდელების (LLM) ინფერენსს NVIDIA პლატფორმაზე, კოდის მხოლოდ ერთი ხაზის შეცვლით 28-ჯერ უფრო სწრაფ მუშაობას და 1,200 ტოკენს/წამში სიჩქარეს უზრუნველყოფს. ის პირველი Hugging Face ბიბლიოთეკაა, რომელიც სარგებლობს ახალი float8 (FP8) ფორმატით, რაც კიდევ უფრო აუმჯობესებს გამტარუნარიანობას და ამცირებს პირველი ტოკენის ლატენტურობას, რაც საშუალებას იძლევა, უფრო დიდი მოდელები ერთ GPU-ზე გაეშვას სიზუსტის დაკარგვის გარეშე. აღნიშნული ტ
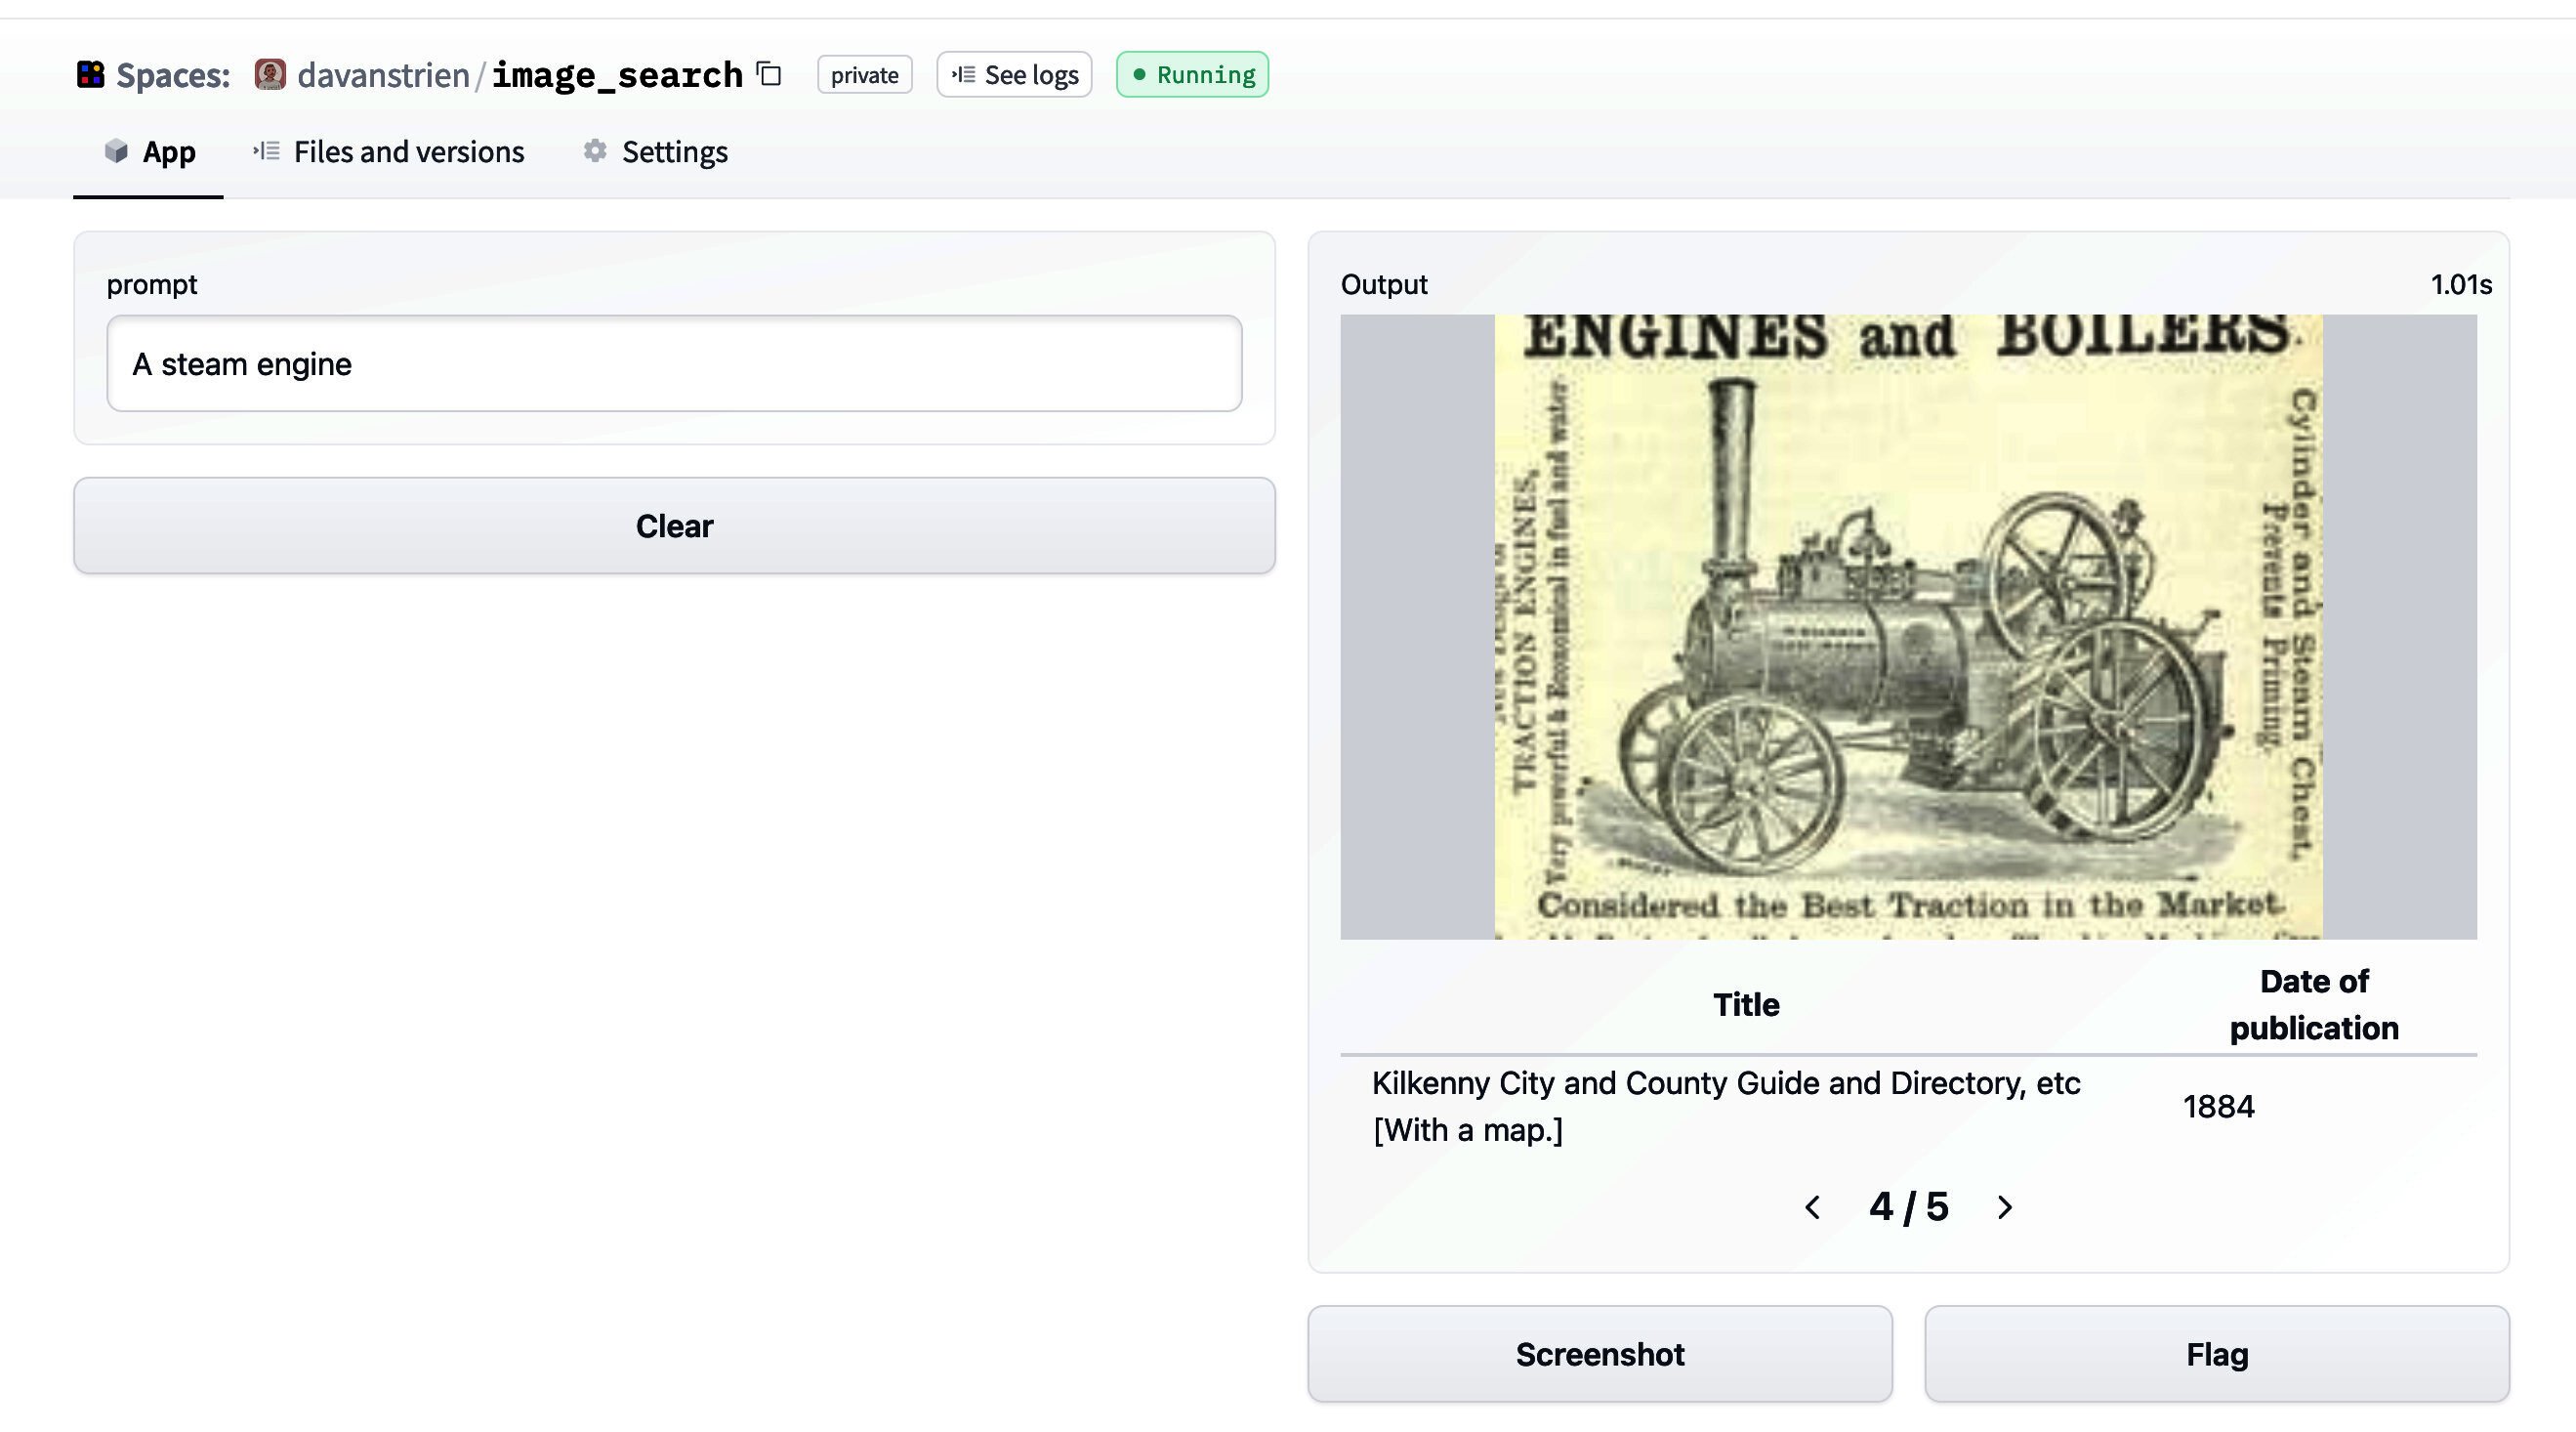
`datasets` ბიბლიოთეკა: ახალი შესაძლებლობები სურათების ძიებისთვის
თავდაპირველად ტექსტურ მონაცემებთან ასოცირებული `datasets` ბიბლიოთეკა ახლა გაძლიერებულ მხარდაჭერას გვთავაზობს აუდიო და სურათებისთვის. ეს სტატია განიხილავს, თუ როგორ შეიძლება `datasets`-ის, `sentence_transformers`-ისა და `faiss`-ის გაერთიანებით სურათების საძიებო აპლიკაციის შექმნა, ბრიტანეთის ბიბლიოთეკის ციფრული კოლექციიდან მიღებული სურათების მაგალითზე.

Gradio: ყოვლისმომცველი ჩარჩო AI/ML აპლიკაციების შესაქმნელად – მეტი, ვიდრე უბრალო UI ბიბლიოთეკა
Gradio, რომელიც ხშირად აღიქმება მხოლოდ UI ბიბლიოთეკად, სინამდვილეში არის ყოვლისმომცველი ჩარჩო მანქანური სწავლების მოდელებთან ურთიერთობისთვის UI-ებისა და API-ების მეშვეობით, რომელიც უზრუნველყოფს მაღალ შესრულებას, უსაფრთხოებასა და რეაგირებას. სტატია დეტალურად განიხილავს Gradio-ს უნიკალურ მახასიათებლებს, როგორებიცაა API Recorder, სერვერული რენდერინგი (SSR), დახვეწილი რიგების სისტემა, სტრიმინგი, მრავალგვერდიანი აპლიკაციების მხარდაჭერა, Groovy ტრანსპილაცია, თემების სისტემა, დინამიური რენდერინგი, Grad
Gradio: მეტი ვიდრე უბრალოდ UI ბიბლიოთეკა – ხელოვნური ინტელექტის აპლიკაციების მძლავრი ჩარჩო
Gradio, რომელიც ხშირად მხოლოდ UI ბიბლიოთეკად აღიქმება, სინამდვილეში არის ყოვლისმომცველი ჩარჩო მანქანური სწავლების მოდელებთან ინტერფეისებისა და API-ების მეშვეობით ურთიერთობისთვის, რაც უზრუნველყოფს მაღალ წარმადობას, უსაფრთხოებასა და რეაგირებას. ეს სტატია წარმოგიდგენთ მის უნიკალურ მახასიათებლებს, რომლებიც გადამწყვეტია თანამედროვე AI აპლიკაციების შესაქმნელად.
Hugging Face-ის ბიბლიოთეკა Decision Transformer-ს აერთიანებს: ახალი ეტაპი ღრმა გაძლიერებულ სწავლაში
Hugging Face-მა სიხარულით განაცხადა, რომ Decision Transformer, ოფლაინ გაძლიერებული სწავლის (Offline Reinforcement Learning) მეთოდი, ინტეგრირებულია მათ 🤗 ტრანსფორმერების ბიბლიოთეკაში და Hugging Face ჰაბში. ეს ნაბიჯი ღრმა გაძლიერებული სწავლის (Deep RL) სფეროში ხელმისაწვდომობის გაუმჯობესების გეგმის ნაწილია. სტატია განმარტავს RL-ის საფუძვლებს, განასხვავებს ონლაინ და ოფლაინ გაძლიერებულ სწავლებას და დეტალურად აღწერს Decision Transformer-ის მოდელს, რომელიც წარმოადგენს პარადიგმის ცვლილებას, რადგან ტრადი
Hugging Face-ი Decision Transformer-ს აინტეგრირებს: ახალი მიდგომა გაძლიერებით სწავლებაში
Hugging Face-მა Decision Transformer, ოფლაინ გაძლიერებითი სწავლის (Offline Reinforcement Learning) მეთოდი, თავის 🤗 transformers ბიბლიოთეკასა და Hugging Face Hub-ში ინტეგრირება მოახდინა. ეს ინტეგრაცია მნიშვნელოვან ნაბიჯს წარმოადგენს Deep Reinforcement Learning-ის (Deep RL) სფეროში ხელმისაწვდომობის გასაუმჯობესებლად. Decision Transformer წარმოადგენს პარადიგმის ცვლას, სადაც ტრადიციული RL მეთოდების ნაცვლად გამოიყენება მიმდევრობის მოდელირების ალგორითმი სასურველი შედეგის მისაღწევად მომავალი მოქმედებები
Unsloth: დააჩქარეთ LLM მოდელების დახვეწა Hugging Face-ის ეკოსისტემაში
Unsloth არის მსუბუქი ბიბლიოთეკა, რომელიც შექმნილია დიდი ენობრივი მოდელების (LLM) დახვეწის პროცესის დასაჩქარებლად. ის სრულად თავსებადია Hugging Face-ის ეკოსისტემასთან და აქტიურად ვითარდება Unsloth-ის გუნდისა და ღია წყაროს საზოგადოების მიერ. ბიბლიოთეკა მხარს უჭერს NVIDIA GPU-ებს, Llama-სა და Mistral-ის არქიტექტურებს, რაც უზრუნველყოფს მნიშვნელოვნად უფრო სწრაფ დახვეწას და მეხსიერების ნაკლებ გამოყენებას სტანდარტულ QLoRA-სთან შედარებით, სიზუსტის დაკარგვის გარეშე.
რატომ არღვევს Hugging Face-ის Transformers ბიბლიოთეკა DRY პრინციპს?
პროგრამული უზრუნველყოფის განვითარებაში ცნობილი „ნუ გაიმეორებ საკუთარ თავს“ (DRY) პრინციპის მიუხედავად, Hugging Face-ის Transformers ბიბლიოთეკა შეგნებულად უარს ამბობს მის გამოყენებაზე და იყენებს „ერთი მოდელის ფაილის პოლიტიკას“. ეს გადაწყვეტილება მიღებულია გარე კონტრიბუციების წახალისების, კოდის წაკითხვადობის გაუმჯობესების და მანქანური სწავლების სფეროს სწრაფი ევოლუციის გამო, რაც სტანდარტული ლოგიკური შაბლონების განსაზღვრას ართულებს.
Habana Labs და Hugging Face-ი თანამშრომლობენ ტრანსფორმერული მოდელების ტრენინგის დასაჩქარებლად
Habana Labs, ღრმა სწავლის პროცესორების პიონერი, და Hugging Face, ტრანსფორმერული მოდელების ცენტრალური პლატფორმა, აცხადებენ პარტნიორობის შესახებ, რომლის მიზანია მაღალი ხარისხის ტრანსფორმერული მოდელების სწავლების პროცესის გამარტივება, დაჩქარება და გაიაფება. Habana-ს SynapseAI პროგრამული პაკეტის Hugging Face Optimum-ის ღია კოდის ბიბლიოთეკასთან ინტეგრაცია საშუალებას მისცემს მონაცემთა მეცნიერებსა და მანქანური სწავლების ინჟინრებს, ეფექტურად გამოიყენონ Habana Gaudi პროცესორები, შეამცირონ ხარჯები და გაზა

Gradio-ს ახალი შესაძლებლობები: LLM ინსტრუმენტების სერვერები Model Context Protocol-ით (MCP)
Gradio, პოპულარული Python ბიბლიოთეკა მანქანური სწავლების ინტერფეისებისთვის, ახლა მხარს უჭერს Model Context Protocol (MCP) სერვერების გაშვებას დიდი ენობრივი მოდელებისთვის (LLMs). ეს ინოვაცია Gradio აპლიკაციებს საშუალებას აძლევს ფუნქციონირებდნენ როგორც ხელსაწყოები LLM-ებისთვის, რაც მათ სთავაზობს დამატებით შესაძლებლობებს, როგორიცაა გამოსახულების გენერაცია, აუდიო სინთეზი ან კონკრეტული გამოთვლები. სტატია აღწერს, თუ როგორ შეიძლება რამდენიმე ხაზი კოდით Gradio-ს MCP სერვერად გადაქცევა და წარმოადგენს მის
Gradio-ს რევოლუციური განახლება: MCP სერვერები LLM-ებისთვის
Gradio, პოპულარული Python ბიბლიოთეკა, რომელიც გამოიყენება მანქანური სწავლების მოდელებისთვის ინტერფეისების შესაქმნელად, ახლა დეველოპერებს საშუალებას აძლევს, გაუშვან Gradio აპლიკაციები Model Context Protocol (MCP) სერვერებად დიდი ენობრივი მოდელებისთვის (LLMs). ეს ინოვაცია Gradio აპებს აქცევს მძლავრ ხელსაწყოებად, რომელთა გამოყენება LLM-ებს შეუძლიათ სხვადასხვა ამოცანებისთვის – გამოსახულების გენერირებიდან დაწყებული, კონკრეტული გამოთვლებით დამთავრებული. სტატია აღწერს MCP სერვერის აგებას რამდენიმე ხაზი
მანქანური სწავლების მოდელების ნახშირბადის კვალის თვალყურის დევნება და შემცირება
ეს სტატია განიხილავს მანქანური სწავლების მოდელების ვარჯიშისა და განთავსების ეკოლოგიურ ზემოქმედებას, კერძოდ, მათ ნახშირბადის ემისიებს. წარმოდგენილია ისეთი ხელსაწყოები, როგორიცაა huggingface_hub ბიბლიოთეკა და codecarbon ინტეგრაცია, რომლებიც ხელს უწყობენ ამ ემისიების თვალყურის დევნას, ანგარიშგებას და მართვას, რითაც ხდება ეკო-მეგობრული AI-ის განვითარების ხელშეწყობა.
PatchTSMixer: IBM Research-ისა და Hugging Face-ის რევოლუციური მოდელი დროითი სერიების მოდელირებისთვის
IBM Research-მა Hugging Face-თან ერთად წარმოადგინა PatchTSMixer, ინოვაციური მოდელი, რომელიც Transformers ბიბლიოთეკაშია ინტეგრირებული. ეს მოდელი შექმნილია მრავალვარიანტული დროითი სერიების ეფექტური მოდელირებისთვის, მსუბუქი შერევის გამოყენებით პაჩებს, არხებსა და დამალულ მახასიათებლებს შორის. PatchTSMixer მნიშვნელოვნად აღემატება არსებულ MLP და Transformer მოდელებს პროგნოზირებაში, აჩვენებს 8-60%-იან გაუმჯობესებას და ამცირებს მეხსიერების მოხმარებასა და შესრულების დროს. იგი მხარს უჭერს ტრანსფერულ სწავლ
ღია კოდის LLM-ები აგენტურ სისტემებს აძლიერებენ: Mixtral-მა GPT-3.5-საც კი აჯობა
ღია კოდის დიდი ენობრივი მოდელები (LLM) ახლა მიაღწიეს ისეთ დონეს, რომ შეუძლიათ აგენტური სამუშაო პროცესების მართვა, Mixtral-8x7B-მა კი ტესტებში GPT-3.5-საც კი აჯობა. სტატია წარმოგიდგენთ `smolagents`-ს, ახალ ბიბლიოთეკას აგენტების შესაქმნელად, და განმარტავს, თუ როგორ შეიძლება LLM-ების ინტეგრირება ხელსაწყოებთან „LLM აგენტების“ შესაქმნელად. ის დეტალურად განიხილავს ReAct აგენტების (მსჯელობა + მოქმედება) კონცეფციას, აჩვენებს მათ შექმნას LangChain-ის ChatHuggingFace კლასის გამოყენებით და წარმოადგენს ტესტ

Transformers ბიბლიოთეკა: ხელოვნური ინტელექტის მოდელების ინტეგრაციისა და სტანდარტიზაციის ახალი ეტაპი
Transformers, რომელიც 2019 წელს დაარსდა, გახდა ხელოვნური ინტელექტის მოდელების, განსაკუთრებით დიდი ენობრივი (LLM) და ვიზუალური ენობრივი (VLM) მოდელებთან მუშაობის სტანდარტული ბიბლიოთეკა Python ეკოსისტემაში. ის მხარს უჭერს 300-ზე მეტ არქიტექტურას, აქტიურად თანამშრომლობს სხვა ბიბლიოთეკებთან (როგორიცაა llama.cpp და MLX) თავსებადობის გასაუმჯობესებლად და მიზნად ისახავს წვლილის შეტანის ბარიერის შემცირებას ხელოვნური ინტელექტის საზოგადოებაში, რითაც ხელს უწყობს ეკოსისტემის სტანდარტიზაციას და ფრაგმენტაციის

Dell Enterprise Hub: ხელოვნური ინტელექტის გადაწყვეტილებების სრული ეკოსისტემა საწარმოებისთვის
Dell Enterprise Hub აფართოებს ხელოვნური ინტელექტის გადაწყვეტილებების სპექტრს, სთავაზობს ოპტიმიზებულ მოდელებს (Meta Llama 4, Google Gemma 3) და მზა აპლიკაციებს Dell-ის AI სერვერებისა და AI კომპიუტერებისთვის. პლატფორმა უზრუნველყოფს სწრაფ, ადგილობრივ განთავსებას Docker-ის, Kubernetes-ის და ახალი Dell Pro AI Studio-ს მეშვეობით, ასევე წარმოგიდგენთ `dell-ai` ღია კოდის ბიბლიოთეკას, რაც საწარმოებს საშუალებას აძლევს, ეფექტურად ინტეგრირდნენ გენერაციულ ხელოვნურ ინტელექტთან.

TRL და vLLM: GPU-ის ეფექტურობის ახალი ერა კოლოკაციის წყალობით
TRL-ის ბიბლიოთეკამ მნიშვნელოვანი სიახლე დანერგა, რაც LLM-ების (დიდი ენობრივი მოდელების) წვრთნის პროცესს vLLM-თან GRPO ალგორითმის გამოყენებით უფრო ეფექტურს ხდის. ადრე vLLM სერვერის რეჟიმში მუშაობდა, რაც GPU-ის რესურსების არაეფექტურ გამოყენებასა და უმოქმედო დროს იწვევდა. ახალი „კოლოკაციის“ რეჟიმი წვრთნისა და ინფერენციის ერთსა და იმავე GPU-ებზე, ერთსა და იმავე პროცესთა ჯგუფში გაშვების საშუალებას იძლევა, რაც მნიშვნელოვნად ზრდის შესრულებას, ამცირებს აპარატურულ დანახარჯებს და ამარტივებს დეპლოირებას.
LoRA ადაპტერების შერწყმის ახალი მეთოდები AI მოდელებში
ეს პოსტი Hugging Face-ის PEFT ბიბლიოთეკაში LoRA ადაპტერების შერწყმის ინოვაციურ მეთოდებს წარმოგიდგენთ. ის დეტალურად განიხილავს, თუ როგორ შეიძლება ერთი და იგივე საბაზისო მოდელიდან მიღებული სხვადასხვა ადაპტერების გაერთიანება, რათა მიღებულ იქნეს ოპტიმალური შედეგები, მეხსიერების შეზღუდვის მიუხედავად. აღწერილია კონკატენაციის, შეწონილი ჯამის, ამოცანის არითმეტიკისა და TIES მეთოდები, კოდის მაგალითებითა და სამომავლო გეგმებით.

OOM შეცდომები წარსულს ჩაბარდა: დიდი მოდელების ვარჯიში DeepSpeed ZeRO-სა და Accelerate-ით
სტატია განმარტავს, თუ როგორ შეიძლება თავიდან ავიცილოთ მეხსიერების უკმარისობის (OOM) შეცდომები დიდი ხელოვნური ინტელექტის მოდელების ვარჯიშისას. იგი აღწერს DeepSpeed ZeRO ოპტიმიზატორის გამოყენებას Accelerate ბიბლიოთეკასთან ერთად, რაც საშუალებას იძლევა, ეფექტურად გამოვიყენოთ არსებული აპარატურა, გავზარდოთ პაკეტის ზომა და დავაჩქაროთ ვარჯიშის პროცესი. წარმოდგენილია შედარებები DDP-სა და DeepSpeed ZeRO Stage-2-ს შორის, რაც აჩვენებს მნიშვნელოვან გაუმჯობესებას შესრულებაში.
Hugging Face: მანქანური სწავლის სამყარო არატექნიკური მომხმარებლებისთვის
ეს გზამკვლევი მიზნად ისახავს მანქანური სწავლის (ML) ფუნდამენტური პრინციპების ხელმისაწვდომად ახსნას არატექნიკური მომხმარებლებისთვის, პითონის ცოდნის საჭიროების გარეშე. იგი დეტალურად განიხილავს Hugging Face-ის ეკოსისტემას, მათ შორის Transformers-ის ბიბლიოთეკას, Hugging Face Hub-ს და Spaces-ს, რომლებიც აადვილებს ML მოდელების გამოყენებასა და განლაგებას. ასევე განმარტებულია LLM-ებისთვის საჭირო GPU-ების დაქირავების პროცესი Hugging Face-ის მეშვეობით, Docker-ის შაბლონების მნიშვნელობა და ძირითადი პროგრამი
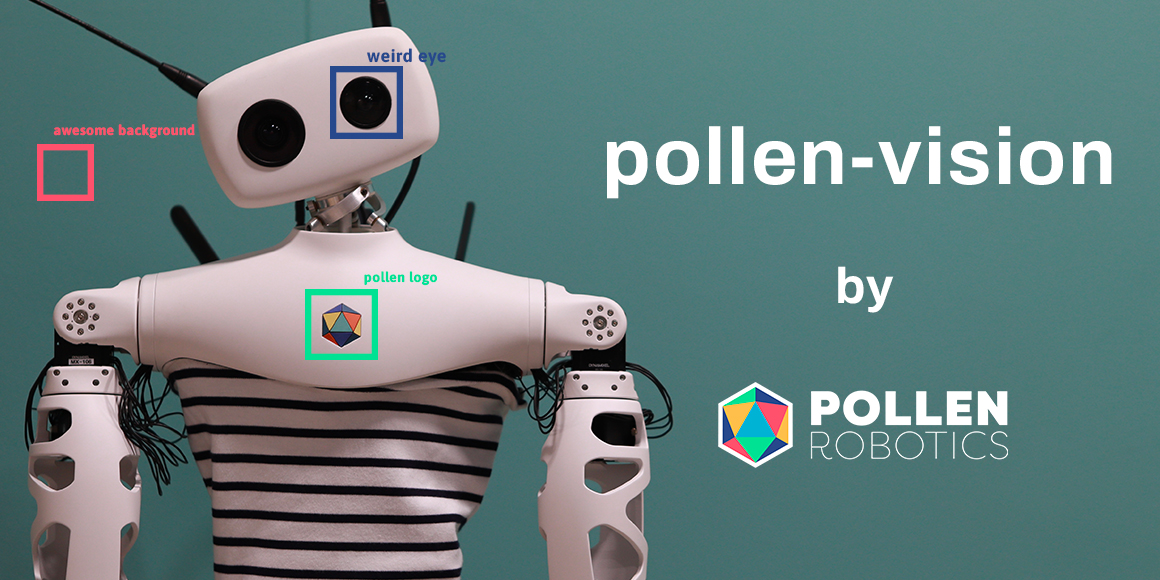
Pollen-vision: ღია კოდის ბიბლიოთეკა, რომელიც რობოტებს უცნობი ობიექტების ავტონომიურ დაჭერაში ეხმარება
წარდგენილია Pollen-vision, ახალი ღია კოდის ბიბლიოთეკა, რომელიც რობოტებს გარემოს ვიზუალური აღქმის საფუძველზე გაგებაში და 3D ობიექტების დეტექციაში ეხმარება. მისი მთავარი მიზანია რობოტების ავტონომიური ფუნქციონირება უცნობი ობიექტების წინასწარი წვრთნის გარეშე დაჭერის მიზნით.

TensorFlow-ში ტექსტის გენერაციის დაჩქარება XLA-ს მეშვეობით
სტატია მიმოიხილავს დიდი ენობრივი მოდელების (LLM) განვითარებას და მათ ტექსტის გენერაციის შესაძლებლობებს. დეტალურად არის განხილული Hugging Face-ის `transformers` ბიბლიოთეკაში ტექსტის გენერაციის საფუძვლები TensorFlow-ს გამოყენებით, მათ შორის დეტერმინისტული და სტოქასტური მეთოდები, სემპლინგის კონტროლი და Beam Search. მთავარი აქცენტი გაკეთებულია TensorFlow-ში ტექსტის გენერაციის ოპტიმიზაციაზე XLA (Accelerated Linear Algebra) კომპაილერის მეშვეობით, რომელიც მნიშვნელოვნად აჩქარებს პროცესს და ამცირებს დაყო
Hugging Face Datasets: ახალი შესაძლებლობები აუდიო და გამოსახულების მონაცემებთან მუშაობისთვის
Hugging Face Datasets ბიბლიოთეკა აფართოებს თავის მხარდაჭერას ტექსტური მონაცემთა ნაკრებების მიღმა, რათა მოიცვას აუდიო და გამოსახულების ფორმატები. განახლებები მოიცავს ახალ ინსტრუმენტებს, როგორიცაა ImageFolder გამოსახულების მონაცემთა ნაკრებების მარტივად ჩატვირთვისა და მართვისთვის, to_tf_dataset ფუნქცია TensorFlow-თან ინტეგრაციის გასამარტივებლად და გაუმჯობესებულ დოკუმენტაციას სხვადასხვა მონაცემთა მოდალობასთან მუშაობისთვის. ეს ცვლილებები მიზნად ისახავს დეველოპერებისთვის მოდელების გაწვრთნისა და აპლიკა
Hugging Face-ის მიდგომა: Transformers-ის ათვისება TensorFlow-ში Keras-ისა და ტრანსფერული სწავლების მეშვეობით
სტატია განიხილავს Hugging Face-ის ფილოსოფიას TensorFlow-ის ინჟინრებისთვის, რომლებიც იყენებენ Transformers-ის ბიბლიოთეკას. ის აკრიტიკებს Keras-ის მაღალდონიანი API-ის გვერდის ავლის გავრცელებულ პრაქტიკას და ხაზს უსვამს მის მნიშვნელობას. სტატია განმარტავს, თუ როგორ შეიძლება მძლავრი, წინასწარ გაწვრთნილი მოდელების გამოყენება ტრანსფერული სწავლების გზით, რაც ამცირებს მონაცემების საჭიროებას და ზრდის სიზუსტეს. ასევე, აღწერილია Hugging Face-ის მოდელების ინტეგრაცია ნაცნობ Keras-ის მეთოდებთან, როგორიცაა `fit