`datasets` ბიბლიოთეკა: ახალი შესაძლებლობები სურათების ძიებისთვის
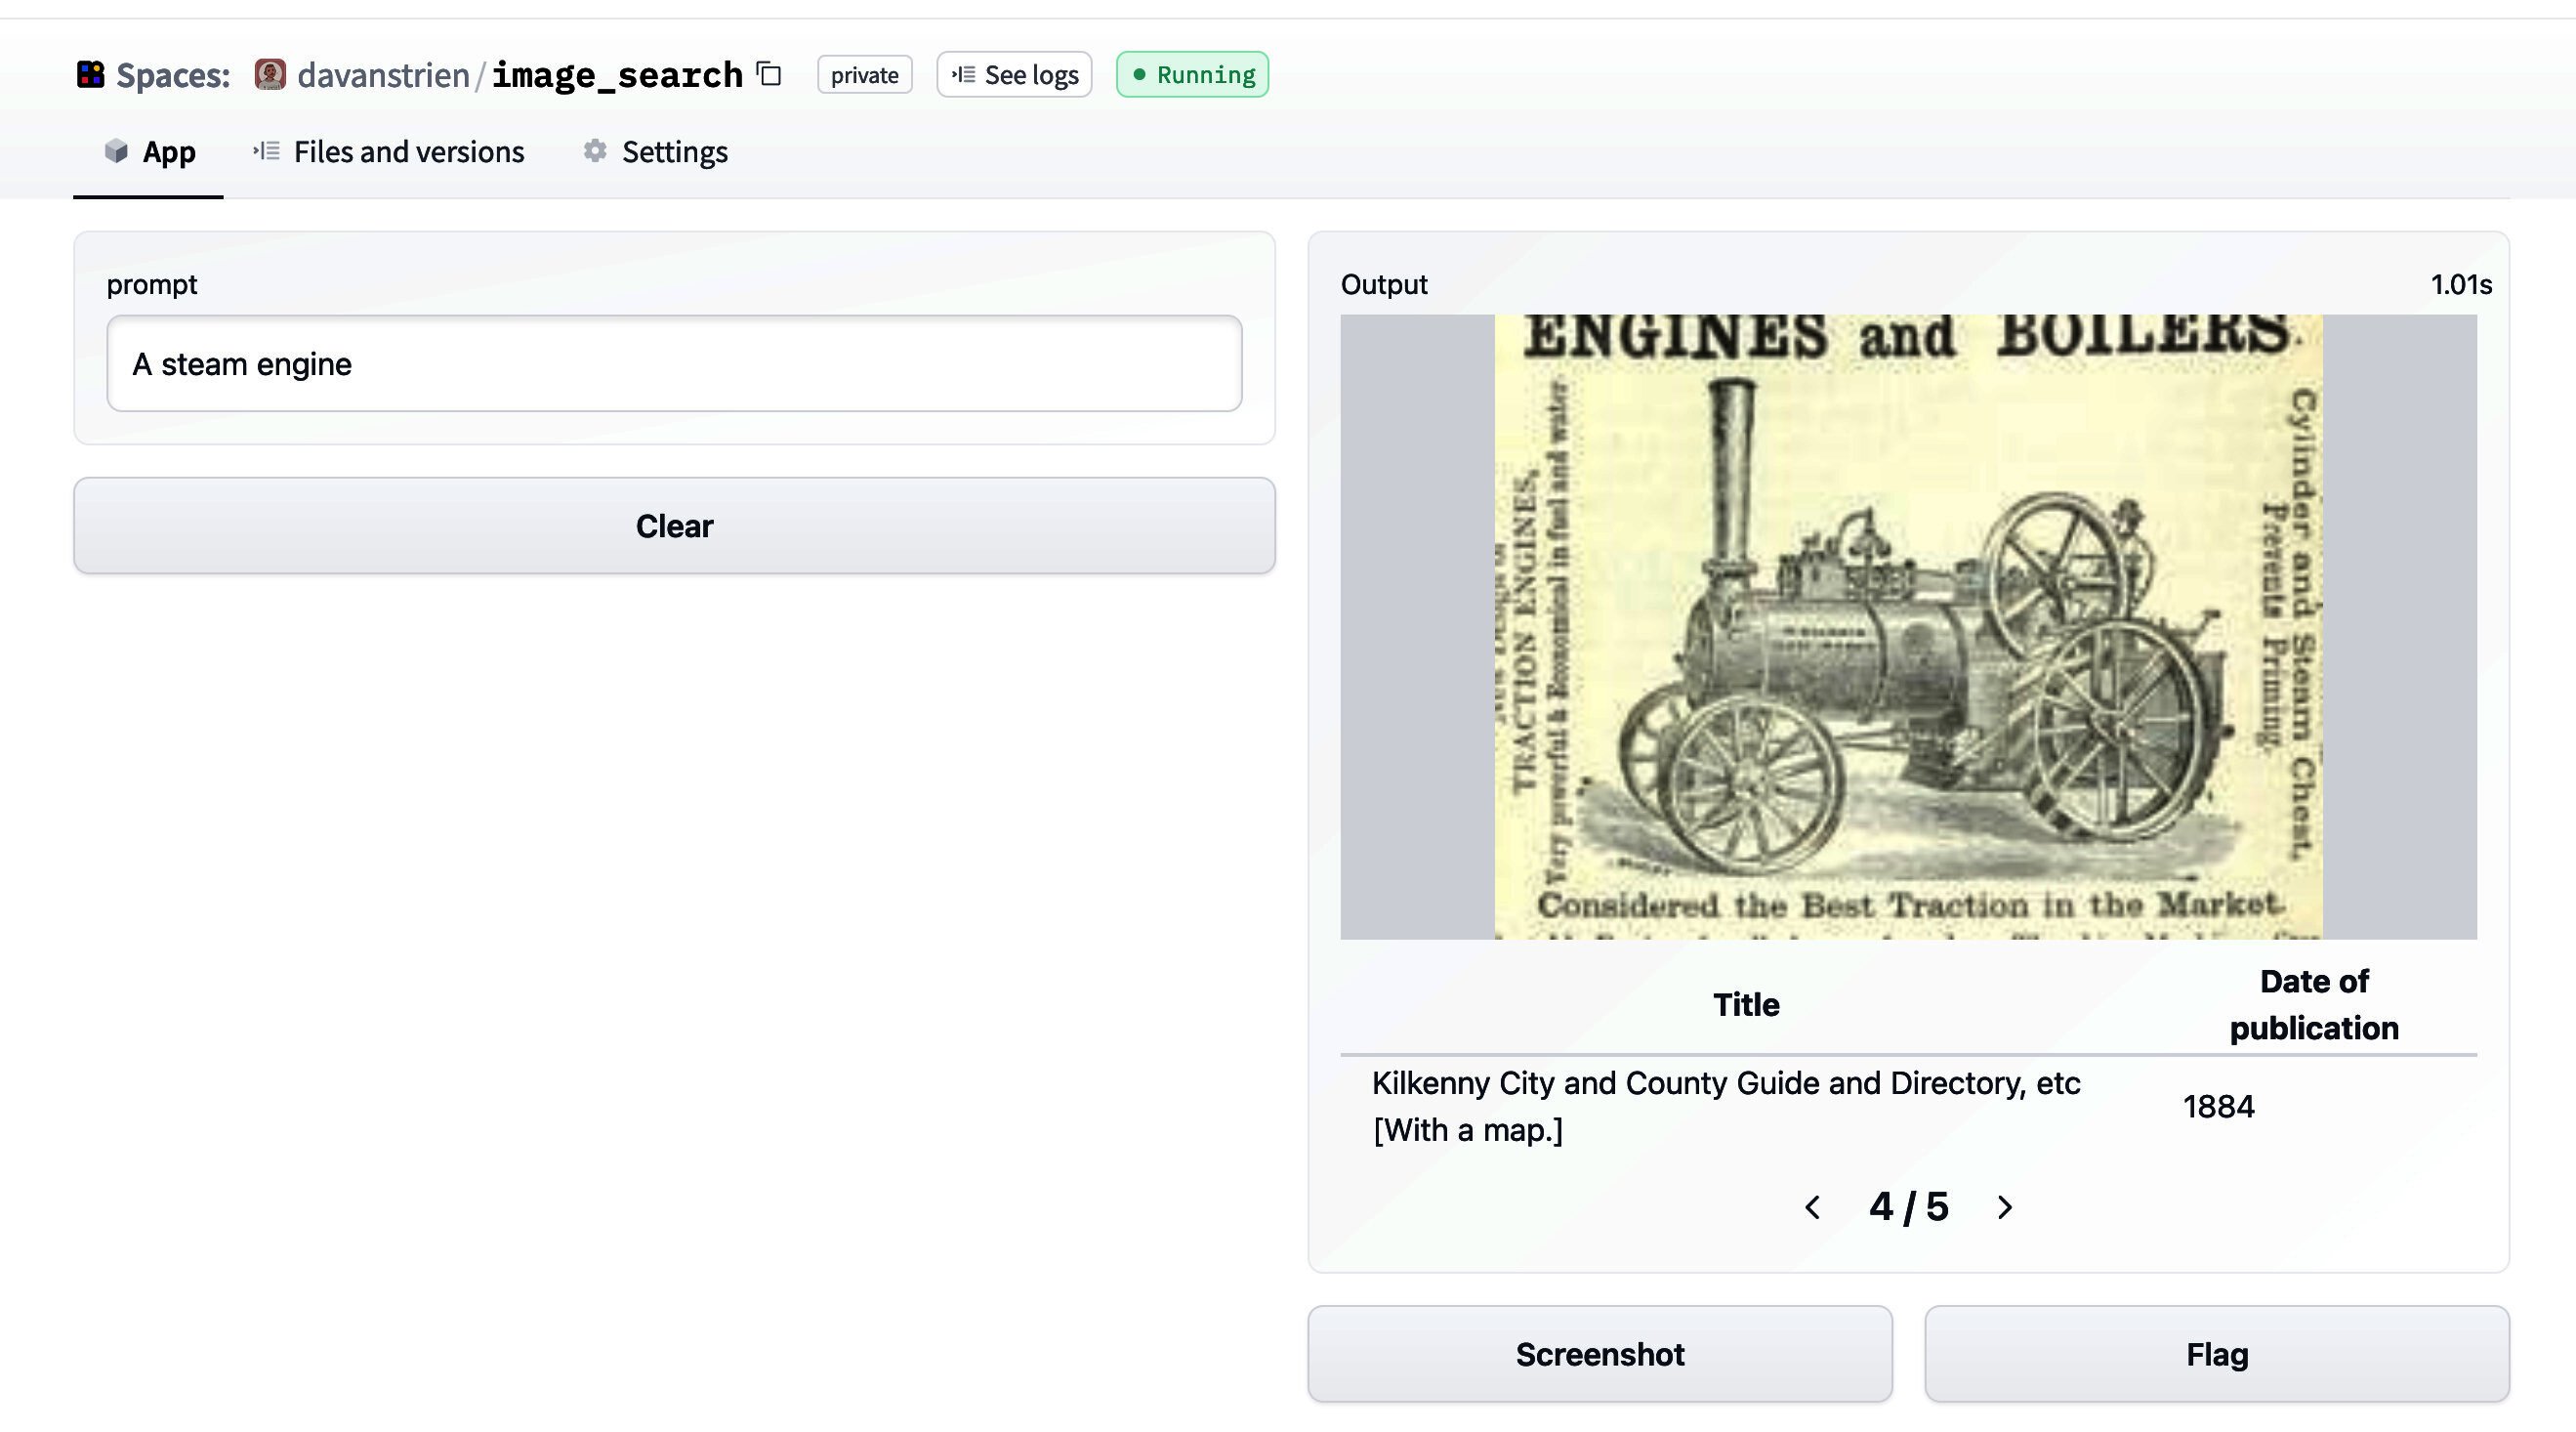
თავდაპირველად ტექსტურ მონაცემებთან ასოცირებული `datasets` ბიბლიოთეკა ახლა გაძლიერებულ მხარდაჭერას გვთავაზობს აუდიო და სურათებისთვის. ეს სტატია განიხილავს, თუ როგორ შეიძლება `datasets`-ის, `sentence_transformers`-ისა და `faiss`-ის გაერთიანებით სურათების საძიებო აპლიკაციის შექმნა, ბრიტანეთის ბიბლიოთეკის ციფრული კოლექციიდან მიღებული სურათების მაგალითზე.
`datasets` ბიბლიოთეკის პირველადი გამოშვებისას, ის ძირითადად ტექსტურ მონაცემებთან იყო დაკავშირებული. თუმცა, ბოლო დროს, `datasets`-მა გააძლიერა აუდიო და სურათების მხარდაჭერა. კერძოდ, ახლა არსებობს `datasets` ფუნქციური ტიპი სურათებისთვის. წინა ბლოგპოსტში ნაჩვენები იყო, თუ როგორ შეიძლება `datasets`-ის გამოყენება 🤗 transformers-თან ერთად სურათების კლასიფიკაციის მოდელის განსავითარებლად. ამ ბლოგპოსტში განვიხილავთ, თუ როგორ შეგვიძლია `datasets` და რამდენიმე სხვა ბიბლიოთეკის გაერთიანება სურათების საძიებო აპლიკაციის შესაქმნელად.
პირველ რიგში, დავაინსტალირებთ `datasets`-ს. ვინაიდან სურათებთან ვიმუშავებთ, ასევე დავაინსტალირებთ `pillow`-ს. დაგვჭირდება `sentence_transformers` და `faiss` ბიბლიოთეკებიც, რომლებსაც ქვემოთ უფრო დეტალურად განვიხილავთ. ასევე დავაინსტალირებთ `rich`-ს – მას აქ მოკლედ გამოვიყენებთ, მაგრამ ეს ძალიან მოსახერხებელი პაკეტია, რომლის შემდგომი შესწავლაც ნამდვილად რეკომენდებულია! დასაწყისისთვის, მოდით გადავხედოთ სურათის ფუნქციას. ჩვენ შეგვიძლია გამოვიყენოთ შესანიშნავი `rich` ბიბლიოთეკა Python ობიექტების (ფუნქციები, კლასები და ა.შ.) შესასწავლად. ვნახავთ, რომ არსებობს რამდენიმე განსხვავებული გზა, რომლითაც შეგვიძლია ჩვენი სურათების გადაცემა. ამ საკითხს მალე დავუბრუნდებით.
`datasets` ბიბლიოთეკის ერთ-ერთი მართლაც სასიამოვნო ფუნქცია (მონაცემთა დამუშავების, მეხსიერების ასახვის და ა.შ. ფუნქციონალის გარდა) ის არის, რომ ის გთავაზობთ გარკვეულ სასარგებლო შესაძლებლობებს "უფასოდ". ერთ-ერთი ასეთია `faiss` ინდექსის დამატების შესაძლებლობა მონაცემთა ნაკრებზე (`dataset`). `faiss` არის "ბიბლიოთეკა მკვრივი ვექტორების ეფექტური მსგავსების ძიებისა და კლასტერიზაციისთვის". `datasets` დოკუმენტაცია აჩვენებს `faiss` ინდექსის გამოყენების მაგალითს ტექსტის მოსაძიებლად. ამ პოსტში ვნახავთ, შეგვიძლია თუ არა იგივეს გაკეთება სურათებისთვის.
ეს არის სურათების მონაცემთა ნაკრები, რომელიც მოპოვებულია ბრიტანეთის ბიბლიოთეკის ციფრული წიგნების კოლექციიდან. ეს სურათები მომდინარეობს წიგნებიდან ფართო დროითი პერიოდიდან და მრავალფეროვანი დომენებიდან. სურათები ამოღებულ იქნა თითოეული წიგნის OCR (ოპტიკური სიმბოლოების ამოცნობა) გამომავალში არსებული ინფორმაციის გამოყენებით. შედეგად, ცნობილია, თუ რომელი წიგნიდან არის სურათები, მაგრამ არა აუცილებლად სხვა რამ იმ სურათის შესახებ, მაგ. რა არის ნაჩვენები სურათზე. ამის დასაძლევად ზოგიერთი მცდელობა მოიცავდა სურათების Flickr-ზე ატვირთვას. ეს საშუალებას აძლევს ადამიანებს, მონიშნონ სურათები ან მოათავსონ ისინი სხვადასხვა კატეგორიაში. ასევე განხორციელდა პროექტები მონაცემთა ნაკრების მანქანური სწავლის გამოყენებით მოსანიშნად. ეს სამუშაო შესაძლებელს ხდის ტეგებით ძიებას, მაგრამ ჩვენ შეიძლება გვსურდეს ძიების უფრო "მდიდარი" შესაძლებლობა.
ამ კონკრეტული ექსპერიმენტისთვის, ვიმუშავებთ კოლექციების ქვეჯგუფთან, რომელიც შეიცავს "გაფორმებებს" (embellishments). ეს მონაცემთა ნაკრები შედარებით მცირეა, ამიტომ უკეთესი იქნება ექსპერიმენტებისთვის. სრული მონაცემების მიღება შესაძლებელია ბრიტანეთის ბიბლიოთეკის მონაცემთა საცავიდან: https://doi.org/10.21250/db17. ვინაიდან სრული მონაცემთა ნაკრები მაინც საკმაოდ დიდია, ალბათ, გირჩევნიათ დაიწყოთ უფრო მცირე ნიმუშით. ჩვენი მონაცემთა ნაკრები შედგება საქაღალდისგან, რომელიც შეიცავს ქვესაქაღალდეებს, რომლებშიც მოთავსებულია სურათები. ეს არის გამოსახულების მონაცემთა ნაკრებების გაზიარების საკმაოდ სტანდარტული ფორმატი.
ცოტა ხნის წინ გაერთიანებული pull request-ის წყალობით, ჩვენ შეგვიძლია უშუალოდ ჩავტვირთოთ ეს მონაცემთა ნაკრები `datasets ImageFolder loader`-ის გამოყენებით. მოდით ვნახოთ, რას მივიღებთ უკან. შეგვიძლია მივიღოთ `DatasetDict` და გვაქვს `Dataset` სურათისა და ეტიკეტის ფუნქციებით. ვინაიდან აქ არ გვაქვს train/validation გაყოფა, ავიღოთ ჩვენი მონაცემთა ნაკრების train ნაწილი. ასევე, მოდით გადავხედოთ ერთ მაგალითს ჩვენი მონაცემთა ნაკრებიდან, რათა ვნახოთ, როგორ გამოიყურება ეს. დავიწყოთ ეტიკეტის სვეტით. ის შეიცავს ჩვენი სურათების მშობელ საქაღალდეს. ამ შემთხვევაში, ეტიკეტის სვეტი წარმოადგენს წიგნების გამოცემის წელს, საიდანაც სურათებია აღებული.
ამ კონკრეტულ მონაცემთა ნაკრებში, სურათების ფაილის სახელები ასევე შეიცავს გარკვეულ მეტამონაცემებს წიგნის შესახებ, საიდანაც სურათი იქნა აღებული. ამ ინფორმაციის მიღების რამდენიმე გზა არსებობს. როდესაც ჩვენ ვუყურებთ ერთ მაგალითს ჩვენი მონაცემთა ნაკრებიდან, სურათის ფუნქცია იყო `PIL.JpegImagePlugin.JpegImageFile`. ვინაიდან `PIL.Images`-ს აქვს filename ატრიბუტი, ერთ-ერთი გზა, რომლითაც შეგვიძლია ჩვენი ფაილის სახელების მიღება, არის ამ ატრიბუტზე წვდომა. ვინაიდან ეს ინფორმაცია მოგვიანებით შეიძლება მარტივად დაგვჭირდეს, მოდით შევქმნათ ახალი სვეტი ფაილის სახელის ამოსაღებად. ამისთვის გამოვიყენებთ `map` მეთოდს. შეგვიძლია გადავხედოთ ერთ მაგალითს, რათა ვნახოთ, როგორ გამოიყურება ეს ახლა.
ჩვენ უკვე მივიღეთ ჩვენი მეტამონაცემები. მოდით ვნახოთ რამდენიმე სურათი! თუ მივწვდებით მაგალითს და ინდექსირებას მოვახდენთ სურათის სვეტში, დავინახავთ ჩვენს სურათს. აღსანიშნავია, რომ ამ ბლოგპოსტის ადრინდელ ვერსიაში სურათების ჩამოტვირთვისა და ჩატვირთვის ნაბიჯები გაცილებით რთული იყო. ახალი `ImageFolder loader` ამ პროცესს ბევრად აადვილებს. კერძოდ, ჩვენ არ გვჭირდება ფიქრი იმაზე, თუ როგორ ჩავტვირთოთ ჩვენი სურათები, რადგან `datasets`-მა ეს ჩვენთვის გააკეთა.
🤗 ეკოსისტემის ერთ-ერთი უაღრესად შესანიშნავი ნაწილია Hugging Face Hub. ჩვენ შეგვიძლია გამოვიყენოთ Hub მოდელებსა და მონაცემთა ნაკრებებზე წვდომისთვის. ის ხშირად გამოიყენება სხვებთან სამუშაოს გასაზიარებლად, მაგრამ ასევე შეიძლება იყოს სასარგებლო ინსტრუმენტი მიმდინარე პროექტებისთვის. `datasets`-მა ცოტა ხნის წინ დაამატა `push_to_hub` მეთოდი, რომელიც საშუალებას გაძლევთ, მინიმალური ძალისხმევით ატვირთოთ მონაცემთა ნაკრები Hub-ზე. ეს შეიძლება მართლაც სასარგებლო იყოს, რადგან საშუალებას გაძლევთ, გადასცეთ მონაცემთა ნაკრები ყველა უკვე შესრულებული ტრანსფორმაციით. ამჟამად, ჩვენ ავტვირთავთ მონაცემთა ნაკრებს Hub-ზე და თავდაპირველად მას პირადულად დავტოვებთ.
თეგები:
#ხელოვნური ინტელექტი
#მანქანური სწავლება
#hugging face
#faiss
#python
#datasets
#სურათების ძიება
#ბრიტანეთის ბიბლიოთეკა
წყარო: huggingface.co
AI-ით გადამუშავებული


