Renumics Spotlight: ინტერაქტიული ვიზუალიზაცია და მონაცემთა ინსპექცია Hugging Face-ის მონაცემთა ნაკრებებისთვის
Renumics Spotlight გთავაზობთ ინტერაქტიულ ვიზუალიზაციებს Hugging Face-ის მონაცემთა ნაკრებებში კრიტიკული კლასტერების იდენტიფიცირებისთვის. ის იყენებს მოდელის შედეგებს (პროგნოზები, ემბედინგები) მონაცემთა სეგმენტებისა და მოდელის შეცდომების ღრმა გაგებისთვის, რაც აადვილებს მონაცემთა ინსპექციას და ხდის მას მასშტაბირებადს. ხელსაწყო პირდაპირ ინტეგრირდება `datasets` ბიბლიოთეკასთან და მხარს უჭერს სხვადასხვა ტიპის მონაცემებსა და ML ამოცანებს, მათ შორის NLP, აუდიო და კომპიუტერული ხედვა.

გამოსახულებების ტოკენიზაცია და ViT მოდელების დახვეწა გამოსახულების კლასიფიკაციისთვის
ეს სტატია განიხილავს, თუ როგორ ხდება გამოსახულებების ტოკენიზაცია ტრანსფორმატორის მოდელებისთვის, ნატურალური ენის დამუშავების (NLP) ამოცანების ანალოგიით. დეტალურად არის აღწერილი 🤗 datasets-ისა და 🤗 transformers-ის გამოყენებით ViT (Vision Transformer) მოდელის წინასწარი წვრთნა და დახვეწა გამოსახულების კლასიფიკაციის ამოცანებისთვის. მოცემულია ინსტრუქციები მონაცემთა ჩამოტვირთვის, დამუშავების, გამოსახულების ტრანსფორმაციებისა და წვრთნის კონვეიერის დაყენების შესახებ, მათ შორის ისეთი კომპონენტების, როგორიც
ხელოვნური ინტელექტი: გამოსახულებების ტოკენიზაცია და ViT მოდელების წვრთნა
ეს სტატია განმარტავს, თუ როგორ ხდება გამოსახულებების ტოკენიზაცია წინადადებების მსგავსად, რაც მათ საშუალებას აძლევს, დამუშავდეს ტრანსფორმერული მოდელებით. დეტალურად არის აღწერილი 🤗 datasets-ის გამოყენებით მონაცემთა მომზადება, ViTImageProcessor-ის ინტეგრირება და წინასწარ გაწვრთნილი ViT მოდელების დაზუსტება. მიმოხილულია ტრენინგის კონფიგურაციის, შეფასების მეტრიკების განსაზღვრისა და ეფექტური წვრთნის კონვეიერის აგების პროცესები, რაც მნიშვნელოვან წინსვლას წარმოადგენს გამოსახულების კლასიფიკაციის ამოცანებშ
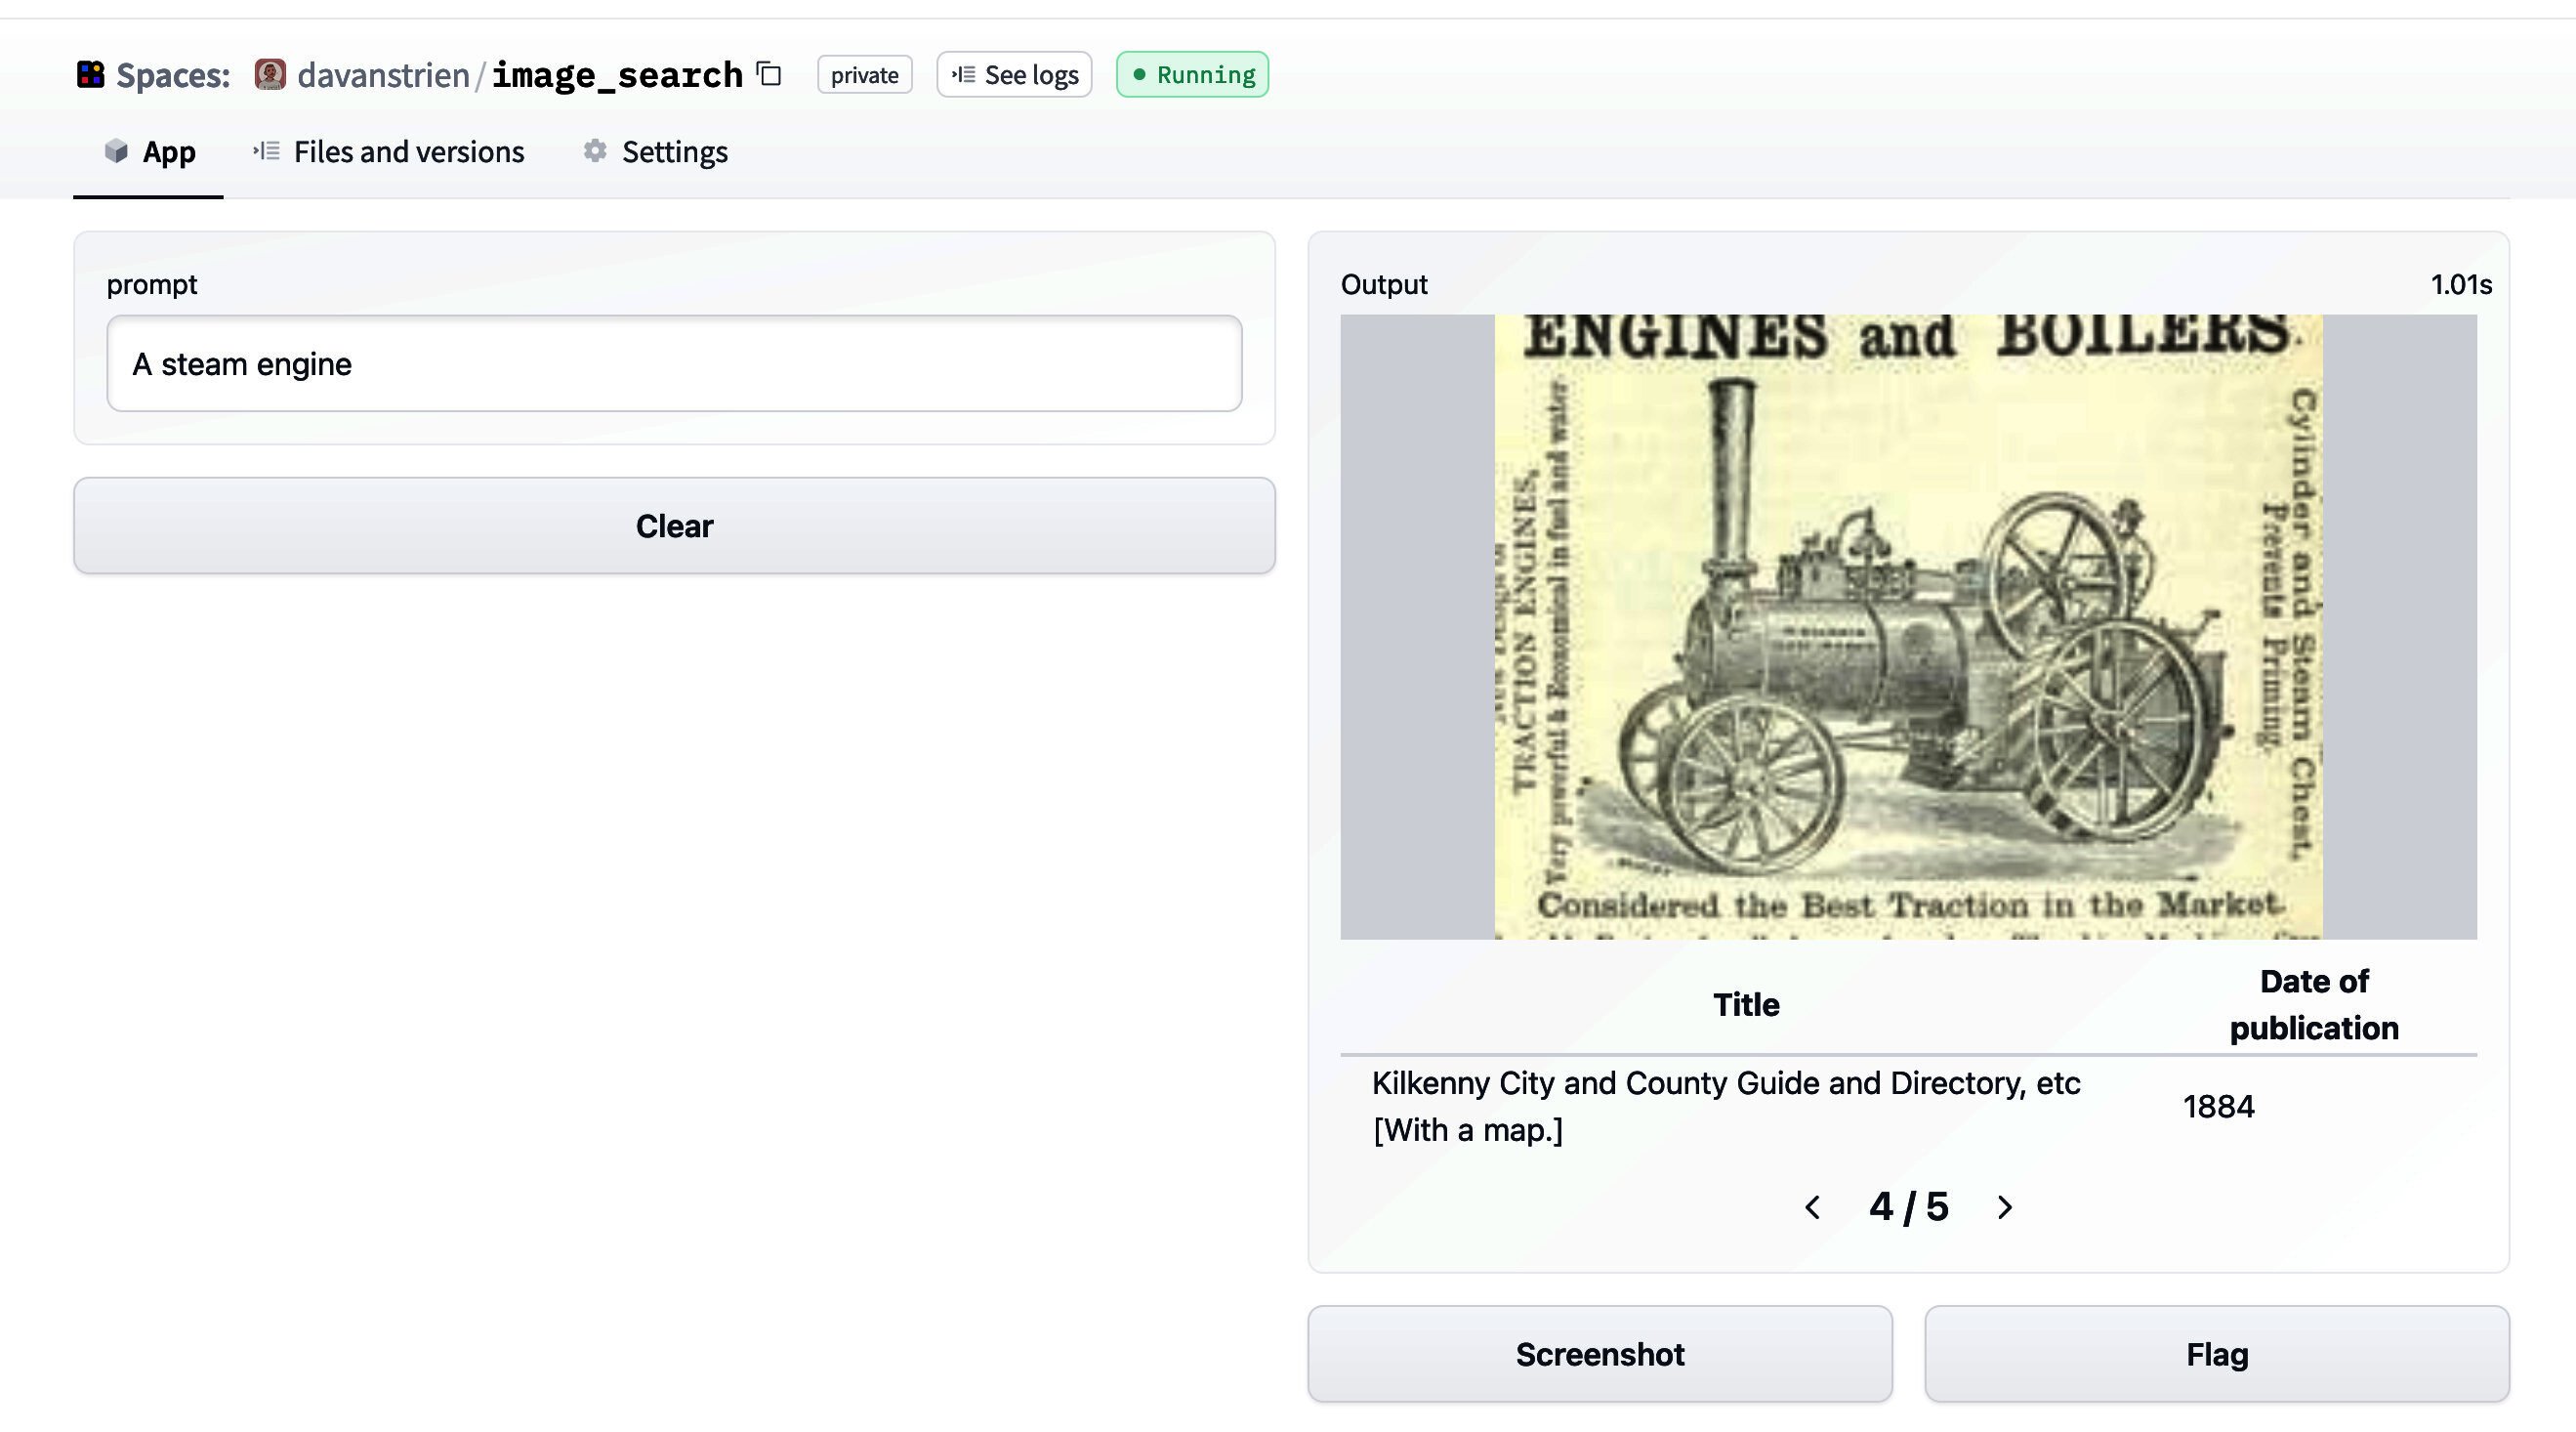
`datasets` ბიბლიოთეკა: ახალი შესაძლებლობები სურათების ძიებისთვის
თავდაპირველად ტექსტურ მონაცემებთან ასოცირებული `datasets` ბიბლიოთეკა ახლა გაძლიერებულ მხარდაჭერას გვთავაზობს აუდიო და სურათებისთვის. ეს სტატია განიხილავს, თუ როგორ შეიძლება `datasets`-ის, `sentence_transformers`-ისა და `faiss`-ის გაერთიანებით სურათების საძიებო აპლიკაციის შექმნა, ბრიტანეთის ბიბლიოთეკის ციფრული კოლექციიდან მიღებული სურათების მაგალითზე.
Hugging Face Datasets: ახალი შესაძლებლობები აუდიო და გამოსახულების მონაცემებთან მუშაობისთვის
Hugging Face Datasets ბიბლიოთეკა აფართოებს თავის მხარდაჭერას ტექსტური მონაცემთა ნაკრებების მიღმა, რათა მოიცვას აუდიო და გამოსახულების ფორმატები. განახლებები მოიცავს ახალ ინსტრუმენტებს, როგორიცაა ImageFolder გამოსახულების მონაცემთა ნაკრებების მარტივად ჩატვირთვისა და მართვისთვის, to_tf_dataset ფუნქცია TensorFlow-თან ინტეგრაციის გასამარტივებლად და გაუმჯობესებულ დოკუმენტაციას სხვადასხვა მონაცემთა მოდალობასთან მუშაობისთვის. ეს ცვლილებები მიზნად ისახავს დეველოპერებისთვის მოდელების გაწვრთნისა და აპლიკა
Hugging Face-ის 🤗 Datasets: აუდიო მონაცემთა ნაკრებების ჩამოტვირთვა და დამუშავება
🤗 Datasets წარმოადგენს ღია კოდის ბიბლიოთეკას, რომელიც უზრუნველყოფს სხვადასხვა სფეროდან მონაცემთა ნაკრებების მარტივად ჩამოტვირთვასა და მომზადებას. მისი მინიმალისტური API მომხმარებლებს საშუალებას აძლევს, ერთი ხაზის კოდით მოამზადონ მონაცემები, განსაკუთრებული ყურადღება ეთმობა აუდიო მონაცემთა დამუშავებას. Hugging Face Hub-თან ინტეგრაციის წყალობით, ბიბლიოთეკა მკვლევრებსა და პრაქტიკოსებს სთავაზობს უპრეცედენტო რაოდენობის აუდიო მონაცემთა ნაკრებებს.
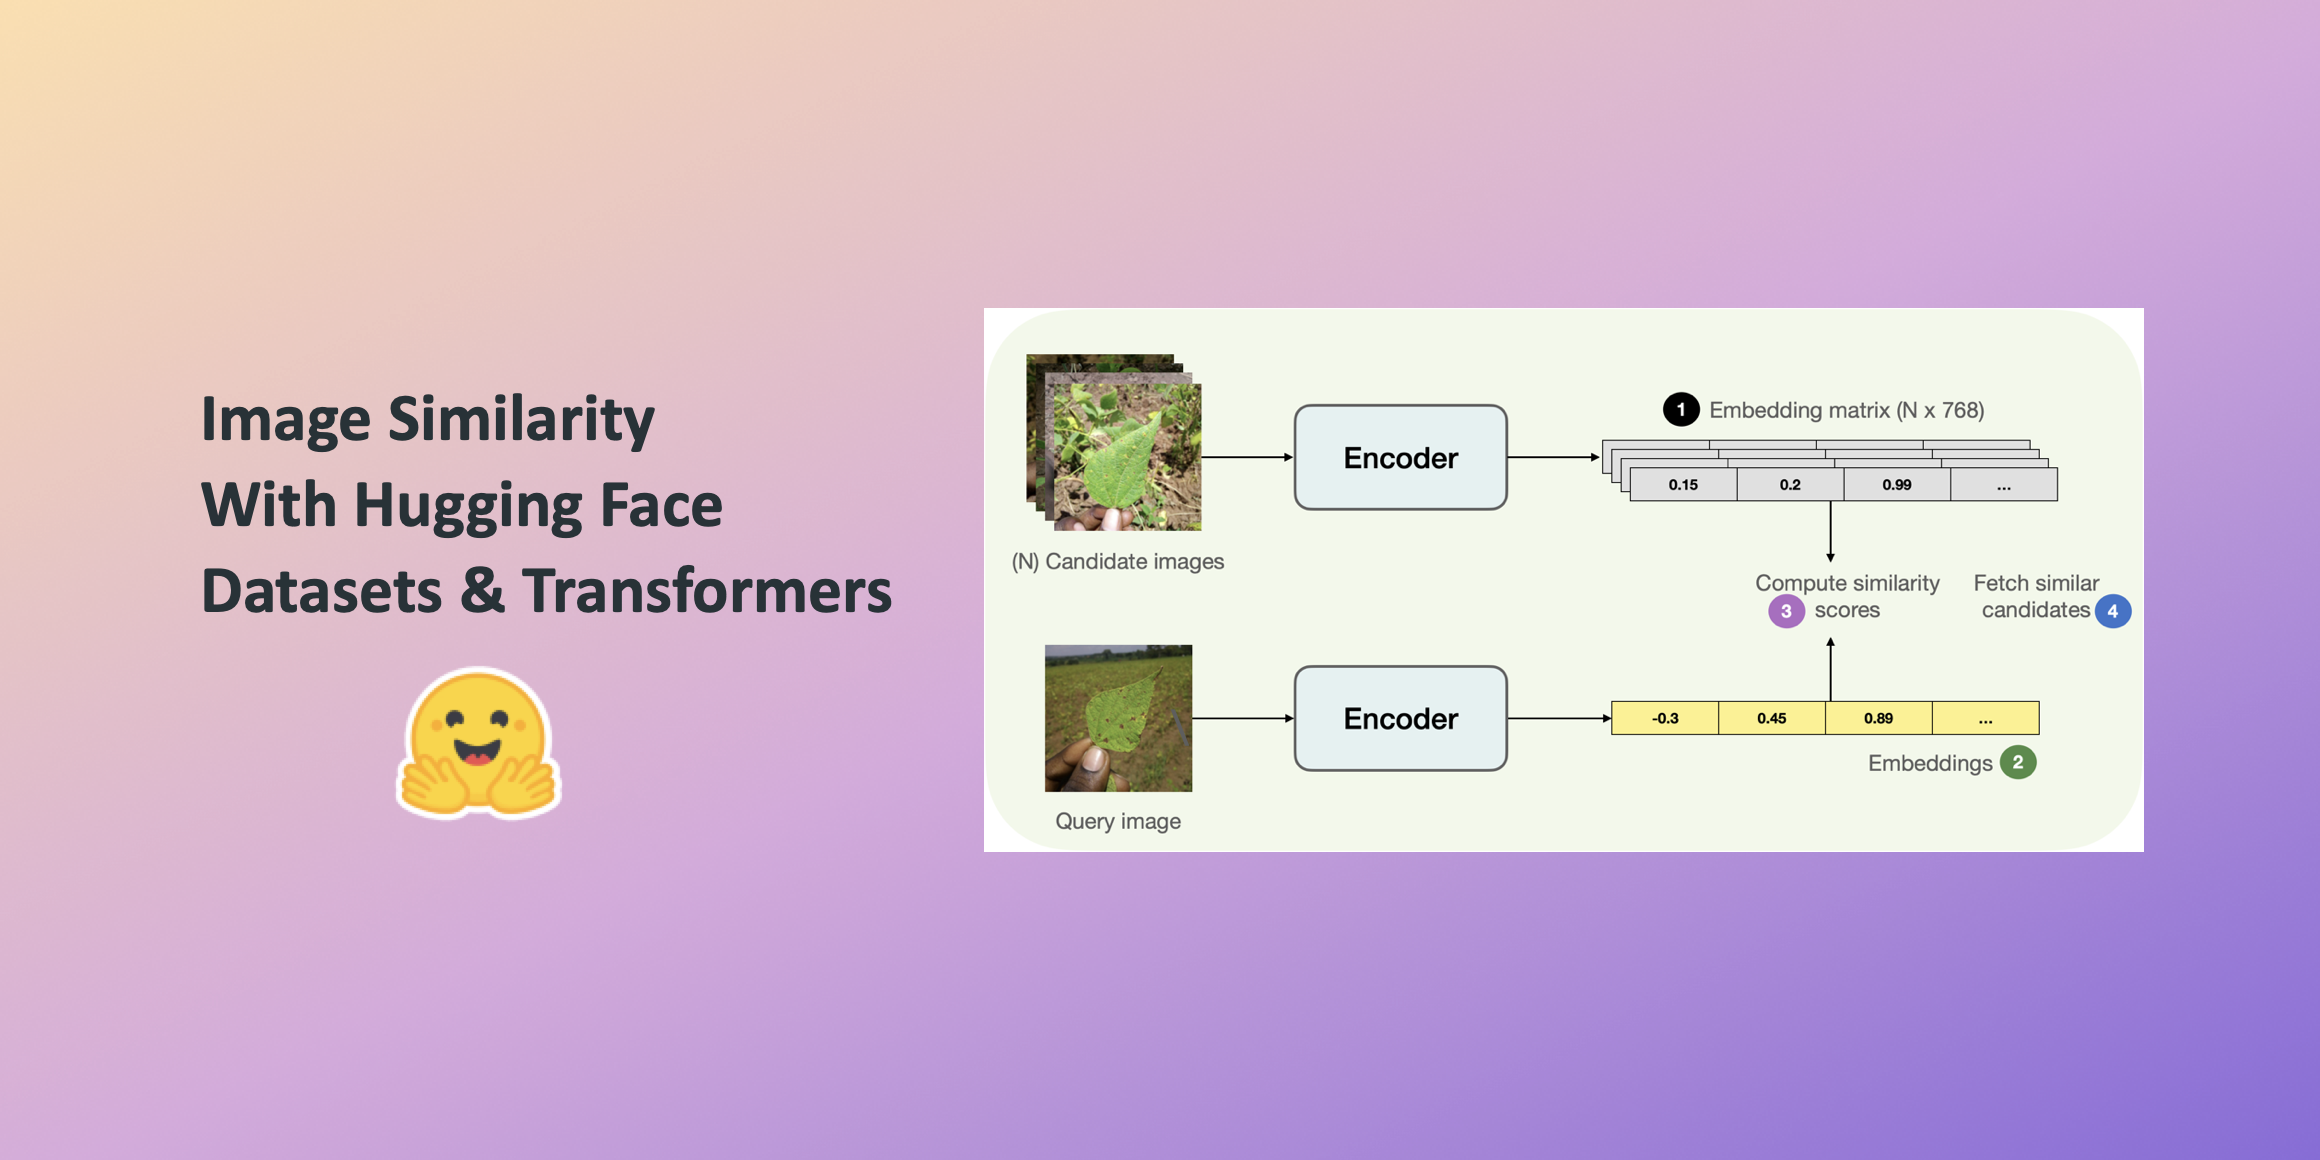
როგორ ავაშენოთ გამოსახულების მსგავსების სისტემა: ღრმა სწავლისა და ეფექტური ძიების გზები
ეს სტატია დეტალურად აღწერს გამოსახულების მსგავსების სისტემის აგების პროცესს, რომელიც ეფუძნება ღრმა სწავლებას და ემბედინგების გამოყენებას. განხილულია გამოსახულებების ვექტორულ სივრცეში წარმოდგენა, კოსინუსური მსგავსების გამოთვლა, Hugging Face-ის `datasets` ბიბლიოთეკისა და `AutoModel` კლასის გამოყენება. ასევე, მოცემულია რჩევები მოდელის შერჩევისა და სისტემის ეფექტურობის გაუმჯობესების შესახებ, მათ შორის განზომილების შემცირებისა და FAISS ინტეგრაციის შესაძლებლობები.