Panel: Python ბიბლიოთეკა მძლავრი აპლიკაციების მარტივად შესაქმნელად
Panel არის ღია წყაროს Python ბიბლიოთეკა, რომელიც დეველოპერებს საშუალებას აძლევს, სრულად Python-ზე შექმნან მძლავრი ხელსაწყოები, დაფები (dashboards) და კომპლექსური აპლიკაციები. ის გთავაზობთ მდიდარ ეკოსისტემას და მოქნილ API-ებს სწრაფი და ინტერაქტიული აპლიკაციების ასაშენებლად.

DeepSeek-R1 მოდელების გამოშვება და განთავსება AWS-სა და Hugging Face-ზე: ახალი შესაძლებლობები ხელოვნურ ინტელექტში
DeepSeek-მა გამოუშვა თავისი DeepSeek-R1 მოდელი, რომელიც მნიშვნელოვნად აუმჯობესებს მსჯელობითი ამოცანების გადაჭრას, როგორიცაა მათემატიკა და კოდირება, OpenAI-ის მსგავსად. Hugging Face, Amazon Web Services-თან თანამშრომლობით, დეველოპერებს სთავაზობს ამ მოდელების მარტივად განთავსებასა და დახვეწას AWS სერვისებზე, მათ შორის Inference Endpoints-სა და Amazon SageMaker-ზე. სტატია დეტალურად აღწერს განთავსების პროცესს Python SageMaker SDK-ისა და Jumpstart-ის გამოყენებით, ასევე Neuron ინსტანციებზე, რაც ხელს უ
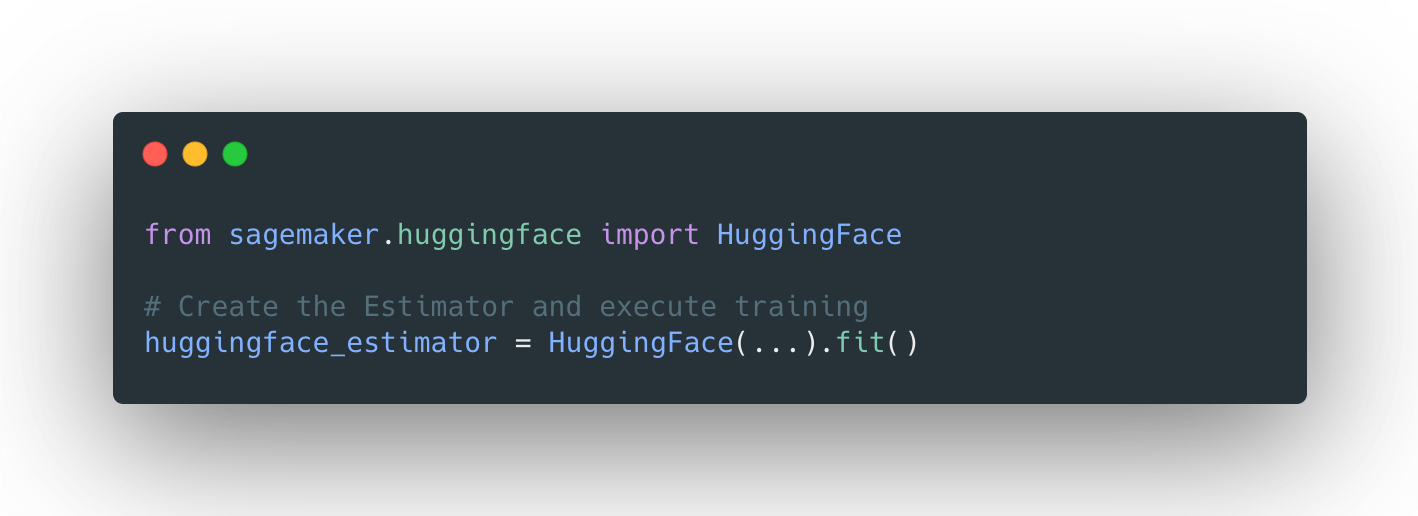
Hugging Face Transformers-ისა და AWS SageMaker-ის ინტეგრაცია: მარტივი და სწრაფი AI მოდელების ტრენინგი
Hugging Face-ისა და AWS SageMaker-ის გუნდებმა ერთობლივად შექმნეს Transformers-ის ოპტიმიზებული ღრმა სწავლების კონტეინერები, რაც მნიშვნელოვნად აჩქარებს Transformers-ზე დაფუძნებული მოდელების ტრენინგს. ახალი HuggingFace estimator-ის წყალობით SageMaker Python SDK-ში, ტრენინგის დაწყება კოდის ერთი ხაზითაა შესაძლებელი. ეს ინტეგრაცია დეტალურად აღწერილია ბლოგ-პოსტში, რომელიც მოიცავს დაწყების მაგალითებსა და დოკუმენტაციას. სტატია განმარტავს, თუ როგორ ხდება Facebook-ის BART-large-cnn მოდელის დახვეწა Samsum მ
AWS SageMaker-ისა და Hugging Face-ის ინტეგრაცია: Transformer-ზე დაფუძნებული მოდელების ოპტიმიზებული ტრენინგი
AWS SageMaker-ისა და Hugging Face-ის გუნდებმა ერთობლივად შექმნეს ოპტიმიზებული ღრმა სწავლის კონტეინერები (DLCs) Transformer-ზე დაფუძნებული მოდელების ტრენინგის დასაჩქარებლად. ახალი HuggingFace estimator-ის SageMaker Python SDK-ში ინტეგრაციის წყალობით, მომხმარებლებს შეუძლიათ ტრენინგის დაწყება კოდის მხოლოდ ერთი ხაზით. სტატია დეტალურად აღწერს ამ ინტეგრაციას, მოიცავს განაწილებული Seq2Seq-transformer მოდელის გაწვრთნის პროცესს შეჯამების ამოცანისთვის და განხილულია მოდელის ატვირთვისა და ტესტირების ნაბიჯებ
Hugging Face-ის ეკოსისტემაში Code Llama-ს ინტეგრაცია გამოცხადდა: პროგრამირების ახალი ეპოქა
Code Llama, Llama 2-ის საფუძველზე შექმნილი კოდზე სპეციალიზებული ხელოვნური ინტელექტის მოდელების ოჯახი, Hugging Face-ის ეკოსისტემაში ინტეგრირდა. ის პროგრამისტების პროდუქტიულობის გაზრდას ისახავს მიზნად კოდის შევსებით, დოკუმენტაციის გენერირებით და ერთეული ტესტების შექმნით. მოდელები ხელმისაწვდომია 7B, 13B და 34B პარამეტრის ვარიანტებში, მათ შორის Python-ის სპეციალისტი და ინსტრუქციებზე მორგებული ვერსიები, და მხარს უჭერენ 100,000-მდე ტოკენის კონტექსტურ ფანჯარას.
SmolVLM2: ვიდეოს გაგება ხელმისაწვდომი ხდება ყველა მოწყობილობაზე
SmolVLM2 წარმოადგენს ფუნდამენტურ ცვლილებას ვიდეოს გაგების მიდგომაში, მოძრაობს მასიური, რესურსმომთხოვნი მოდელებიდან ეფექტურ, ნებისმიერ მოწყობილობაზე გაშვებად გადაწყვეტილებებზე. მიზანია ვიდეოს გაგება ხელმისაწვდომი გახდეს ყველა მოწყობილობისთვის, ტელეფონებიდან სერვერებამდე. გამოშვებულია სამი ზომის (2.2B, 500M და 256M) მოდელი, MLX-თან თავსებადობით (Python და Swift API-ები). ეს მოდელები, მიუხედავად მცირე ზომისა, მნიშვნელოვნად აღემატება არსებულ ანალოგებს მეხსიერების მოხმარების მხრივ და ზოგიერთ შემთხვევ

FastRTC: ახალი Python ბიბლიოთეკა რეალურ დროში AI აუდიო და ვიდეო აპლიკაციებისთვის
მიუხედავად ხელოვნური ინტელექტის მოდელებისა და დაფინანსების მხრივ სწრაფი განვითარებისა, რეალურ დროში AI აპლიკაციების შექმნა, რომლებიც აუდიო და ვიდეო ნაკადებს ამუშავებენ, განსაკუთრებით Python-ში, კვლავ სირთულეებთანაა დაკავშირებული. FastRTC, ახალი კომუნიკაციის ბიბლიოთეკა Python-ისთვის, შექმნილია სწორედ ამ პროცესის გასამარტივებლად, რაც დეველოპერებს საშუალებას აძლევს მარტივად ააწყონ რეალურ დროში აუდიო და ვიდეო AI აპლიკაციები მხოლოდ Python-ის გამოყენებით.
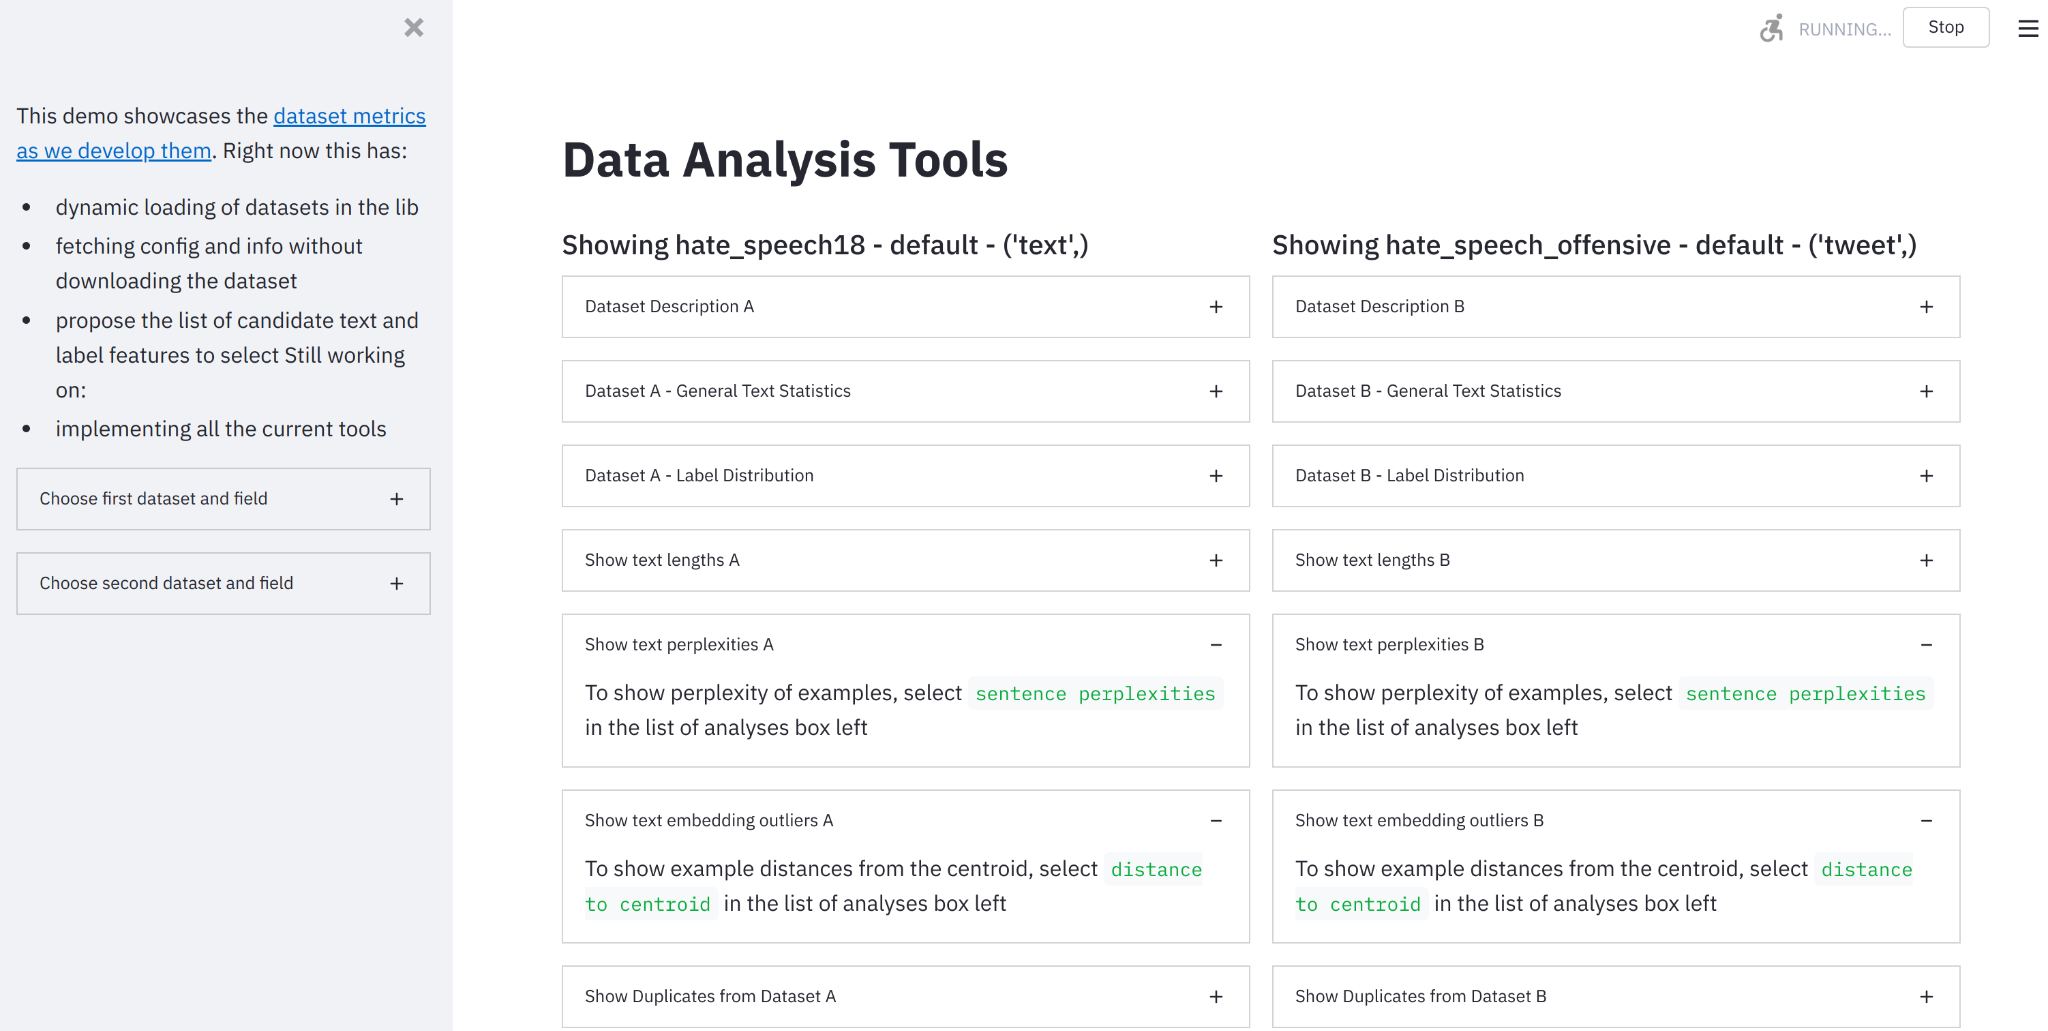
Hugging Face წარმოგიდგენთ მონაცემთა გაზომვის ხელსაწყოს AI მონაცემთა პასუხისმგებლიანი განვითარებისთვის
Hugging Face-ის გუნდმა გამოუშვა ღია კოდის Python ბიბლიოთეკა და უკოდო ინტერფეისი, სახელწოდებით „მონაცემთა გაზომვის ხელსაწყო“ (Data Measurements Tool - DMT). ეს ინსტრუმენტი მიზნად ისახავს მანქანური სწავლების მონაცემთა ნაკრებების გაგებას, შექმნას, კურირებასა და შედარებას. DMT პასუხობს ხელოვნური ინტელექტის განვითარებაში მონაცემთა გააზრებული ანალიზის ხარვეზს, განსაკუთრებით „დიდი მონაცემების“ გამოყენებისას არსებულ მიკერძოებებსა და ხარვეზებს. ის მომხმარებლებს საშუალებას აძლევს ავტომატურად გამოთვალონ მნ
Gradio-lite: Gradio აპლიკაციების გაშვება პირდაპირ ბრაუზერში Pyodide-ით
Gradio-lite არის JavaScript ბიბლიოთეკა, რომელიც საშუალებას გაძლევთ გაუშვათ Gradio აპლიკაციები პირდაპირ ვებ ბრაუზერში, Pyodide-ის გამოყენებით (Python runtime WebAssembly-ისთვის). ეს გამორიცხავს სერვერის ინფრასტრუქტურის საჭიროებას, ამარტივებს დეპლოიმენტს, ამცირებს ხარჯებს და უზრუნველყოფს სწრაფ ინტერაქციასა და მონაცემთა დაცვას. სტატიაში აღწერილია Gradio-lite-ის ძირითადი ფუნქციები, აპლიკაციის შექმნა, მრავალფაილიანი პროექტებისა და დამატებითი მოთხოვნების მართვა. განხილულია მისი უპირატესობები, როგორიცა
კოდის გენერაციის მოდელის წვრთნის დეტალები: Python-ის მაგალითზე
სტატია დეტალურად აღწერს პითონის კოდის გენერაციის მოდელის შექმნისა და წვრთნის კომპლექსურ პროცესს. ის მოიცავს მონაცემთა მოპოვებას GitHub-იდან, 180 GB-იანი მონაცემთა ნაკრების გაწმენდას დუბლიკატებისაგან Codex-ის ევრისტიკის გამოყენებით (რაც 50 GB-იან გაწმენდილ ნაკრებს იძლევა). შემდეგ აღწერილია სპეციალიზებული ტოკენაიზერის წვრთნა, GPT-2 Large-ზე დაფუძნებული მოდელის ინიციალიზაცია სპეციალური კორექტირებით, და ეფექტიანი სავარჯიშო ციკლის დაყენება 🤗 Accelerate ბიბლიოთეკის გამოყენებით განაწილებული (multi-GPU)
Hugging Face Hub-ის ძიების გამარტივება: პროგრამული ინტერფეისის ახალი შესაძლებლობები
სტატიაში წარმოდგენილია `huggingface_hub` ბიბლიოთეკის ახალი ფუნქციები, `ModelSearchArguments` და `ModelFilter`, რომლებიც მნიშვნელოვნად ამარტივებს Hugging Face Hub-ზე AI მოდელებისა და მონაცემთა ნაკრებების ძიებას პირდაპირ Python-ის ან Jupyter-ის გარემოდან. ეს სიახლე დეველოპერებს საშუალებას აძლევს, არ დატოვონ IDE და ეფექტურად მართონ რთული მოთხოვნები, რაც მნიშვნელოვნად აუმჯობესებს სამუშაო პროცესს.
სენტიმენტების ანალიზი ყველასთვის: როგორ გამოვიყენოთ ხელოვნური ინტელექტის თანამედროვე ხელსაწყოები
წარსულში სენტიმენტების ანალიზი მხოლოდ სპეციალისტებისთვის იყო ხელმისაწვდომი, მაგრამ ხელოვნური ინტელექტის საზოგადოების მიერ შექმნილმა ინოვაციურმა ხელსაწყოებმა ის ყველასთვის მარტივად ხელმისაწვდომი გახადა. ეს სახელმძღვანელო გვიჩვენებს, თუ როგორ შეიძლება Python-ისა და Hugging Face Hub-ის გამოყენებით ტექსტის ემოციური პოლარობის იდენტიფიცირება, მონაცემების მასშტაბური დამუშავება და მოდელების ოპტიმიზაცია კონკრეტული ამოცანებისთვის, გამოცდილების გარეშეც კი.
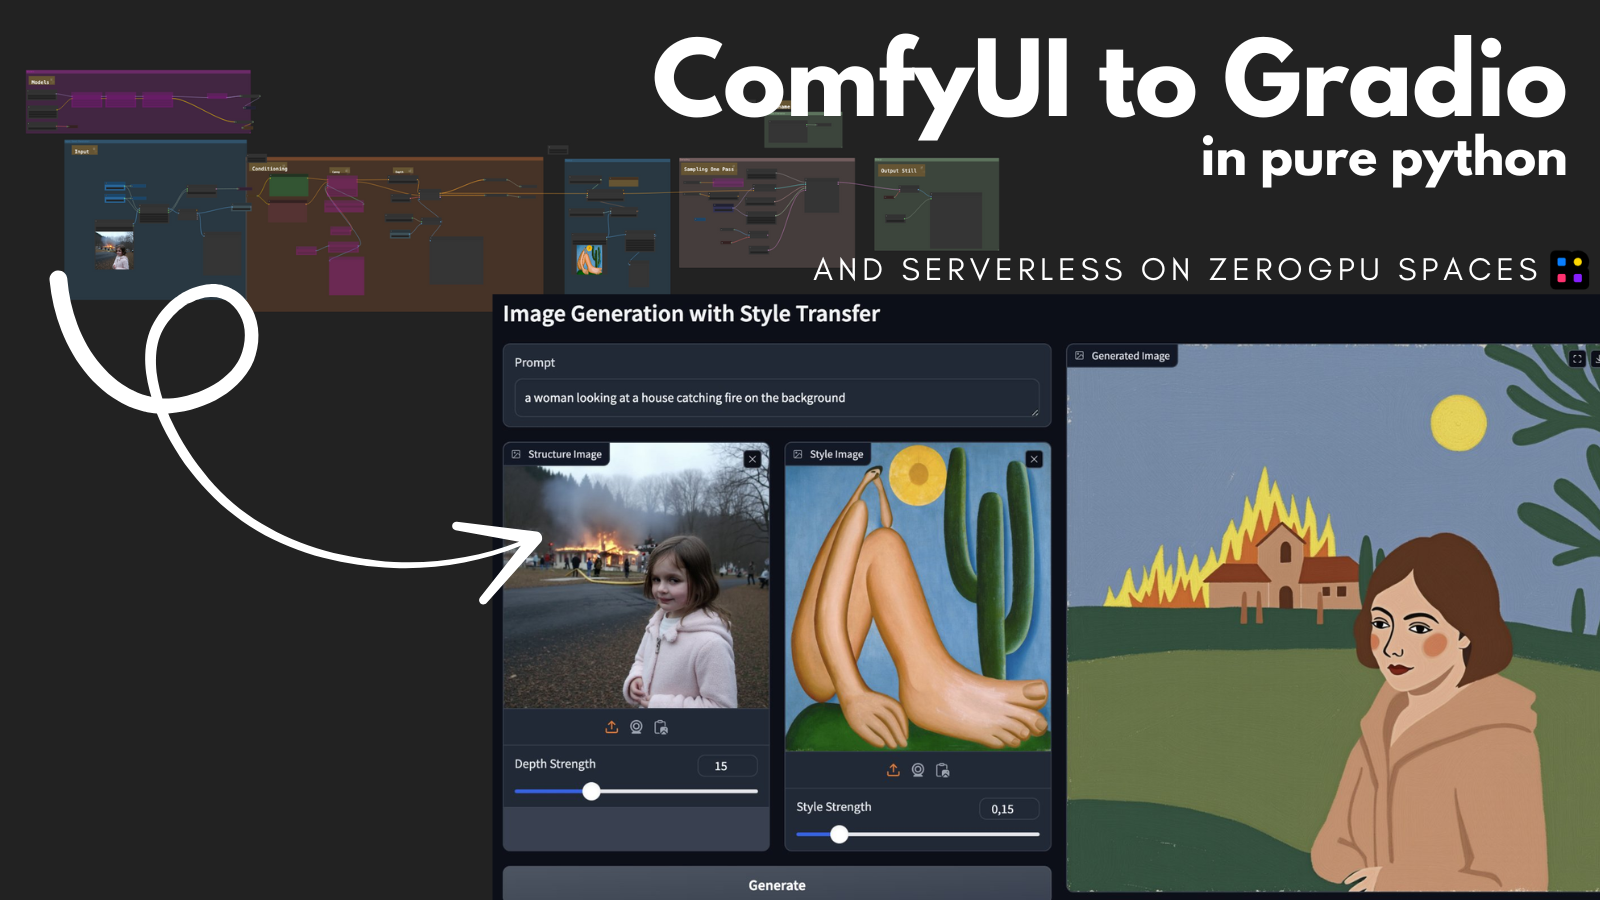
ComfyUI-ის სამუშაო პროცესის Gradio აპლიკაციად გარდაქმნა და Hugging Face Spaces-ზე უფასო განთავსება: სრული გზამკვლევი
ეს გაკვეთილი დეტალურად აღწერს, თუ როგორ უნდა გარდაქმნათ რთული ComfyUI სამუშაო პროცესი მარტივ Gradio აპლიკაციად და განათავსოთ იგი Hugging Face Spaces ZeroGPU სერვერულ სტრუქტურაზე უფასოდ. პროცესი მოიცავს ComfyUI-to-Python-Extension-ის გამოყენებით სამუშაო პროცესის Python სკრიპტად ექსპორტს, Gradio ინტერფეისის შექმნას ექსპორტირებული სკრიპტისთვის და მოდელების Hugging Face-ის ვერსიებთან დაკავშირებას ეფექტური განთავსებისთვის. გაკვეთილი ეფუძნება Nathan Shipley-ის Flux[dev] Redux + Flux[dev] Depth ComfyUI

Gradio-ს ახალი შესაძლებლობები: LLM ინსტრუმენტების სერვერები Model Context Protocol-ით (MCP)
Gradio, პოპულარული Python ბიბლიოთეკა მანქანური სწავლების ინტერფეისებისთვის, ახლა მხარს უჭერს Model Context Protocol (MCP) სერვერების გაშვებას დიდი ენობრივი მოდელებისთვის (LLMs). ეს ინოვაცია Gradio აპლიკაციებს საშუალებას აძლევს ფუნქციონირებდნენ როგორც ხელსაწყოები LLM-ებისთვის, რაც მათ სთავაზობს დამატებით შესაძლებლობებს, როგორიცაა გამოსახულების გენერაცია, აუდიო სინთეზი ან კონკრეტული გამოთვლები. სტატია აღწერს, თუ როგორ შეიძლება რამდენიმე ხაზი კოდით Gradio-ს MCP სერვერად გადაქცევა და წარმოადგენს მის
Gradio-ს რევოლუციური განახლება: MCP სერვერები LLM-ებისთვის
Gradio, პოპულარული Python ბიბლიოთეკა, რომელიც გამოიყენება მანქანური სწავლების მოდელებისთვის ინტერფეისების შესაქმნელად, ახლა დეველოპერებს საშუალებას აძლევს, გაუშვან Gradio აპლიკაციები Model Context Protocol (MCP) სერვერებად დიდი ენობრივი მოდელებისთვის (LLMs). ეს ინოვაცია Gradio აპებს აქცევს მძლავრ ხელსაწყოებად, რომელთა გამოყენება LLM-ებს შეუძლიათ სხვადასხვა ამოცანებისთვის – გამოსახულების გენერირებიდან დაწყებული, კონკრეტული გამოთვლებით დამთავრებული. სტატია აღწერს MCP სერვერის აგებას რამდენიმე ხაზი

Transformers ბიბლიოთეკა: ხელოვნური ინტელექტის მოდელების ინტეგრაციისა და სტანდარტიზაციის ახალი ეტაპი
Transformers, რომელიც 2019 წელს დაარსდა, გახდა ხელოვნური ინტელექტის მოდელების, განსაკუთრებით დიდი ენობრივი (LLM) და ვიზუალური ენობრივი (VLM) მოდელებთან მუშაობის სტანდარტული ბიბლიოთეკა Python ეკოსისტემაში. ის მხარს უჭერს 300-ზე მეტ არქიტექტურას, აქტიურად თანამშრომლობს სხვა ბიბლიოთეკებთან (როგორიცაა llama.cpp და MLX) თავსებადობის გასაუმჯობესებლად და მიზნად ისახავს წვლილის შეტანის ბარიერის შემცირებას ხელოვნური ინტელექტის საზოგადოებაში, რითაც ხელს უწყობს ეკოსისტემის სტანდარტიზაციას და ფრაგმენტაციის
Hugging Face Hub-ი აფართოებს fastai-ის შესაძლებლობებს: ღრმა სწავლის მოდელების გაზიარება ერთი ხაზით
Hugging Face-ი, რომლის მიზანია მანქანური სწავლების დემოკრატიზაცია, სიამაყით აცხადებს fastai-თან ახალ ინტეგრაციას. ეს ინტეგრაცია fastai-ის მომხმარებლებს საშუალებას აძლევს, მარტივად გააზიარონ და ატვირთონ ღრმა სწავლის მოდელები Hugging Face Hub-ზე Python-ის ერთი ხაზის გამოყენებით. სტატიაში ხაზგასმულია fastai-ის წვლილი ღრმა სწავლების ხელმისაწვდომობაში და აღწერილია Hub-ის, როგორც მოდელების, მონაცემთა ნაკრებებისა და ML დემოების ცენტრალური პლატფორმის, უპირატესობები. ინტეგრაცია მოიცავს ვერსიის კონტროლს G
Gradio 3.0 და Gradio Blocks: მანქანური სწავლების დემოების შექმნის რევოლუცია
2019 წლიდან Gradio-ს ბიბლიოთეკით 600 000-ზე მეტი მანქანური სწავლების დემო აშენდა. დღეს წარმოდგენილია Gradio 3.0, რომელიც მოიცავს ფრონტენდის სრულ განახლებას, თანამედროვე ტექნოლოგიების (როგორიცაა Svelte) გამოყენებით, რამაც გამოიწვია სწრაფი მუშაობა და დახვეწილი ვიზუალური ესთეტიკა. გარდა ამისა, ახალი დაბალდონიანი ენა, Gradio Blocks, დეველოპერებს საშუალებას აძლევს შექმნან კომპლექსური, მორგებული ვებ აპლიკაციები უშუალოდ Python-ში, რაც უზრუნველყოფს განლაგებისა და მონაცემთა ნაკადზე მეტ კონტროლს. ამ მოვლე
Twitter-ზე სენტიმენტების ანალიზი: სრული გზამკვლევი
ეს გზამკვლევი წარმოგიდგენთ Twitter-ზე სენტიმენტების ანალიზის ყოვლისმომცველ, ნაბიჯ-ნაბიჯ პროცესს, რომელიც განკუთვნილია როგორც პროგრამისტებისთვის, ასევე არაპროგრამისტებისთვის. ის განმარტავს სენტიმენტების ანალიზის არსს, მის მნიშვნელობას ბიზნესისთვის და გვიჩვენებს, თუ როგორ შეიძლება ისეთი ხელსაწყოების გამოყენება, როგორიცაა Inference API, Zapier და Python-ის ბიბლიოთეკები, რათა ტვიტებიდან ღირებული ინფორმაცია მოვიპოვოთ, მომხმარებელთა უკუკავშირი აღმოვაჩინოთ და ბრენდის ხსენებებს რეალურ დროში დავაკვირდეთ.

Reachy Mini: ხელოვნური ინტელექტის რობოტი კოდირებისა და ექსპერიმენტებისთვის
წარმოგიდგენთ Reachy Mini-ს, ექსპრესიულ, ღია კოდის რობოტს, რომელიც შექმნილია ადამიანისა და რობოტის ურთიერთქმედებისთვის, კრეატიული კოდირებისა და ხელოვნური ინტელექტის ექსპერიმენტებისთვის. $299-დან ხელმისაწვდომი და Python-ზე სრულად პროგრამირებადი (მალე JavaScript-სა და Scratch-ზეც), ის თქვენი კარიბჭეა რობოტიკულ ხელოვნურ ინტელექტში. ეს სახალისო, კონფიგურირებადი სისტემა მზადაა გახდეს თქვენი შემდეგი კოდირების პროექტის ნაწილი, რაც დეველოპერებს, მკვლევარებს, მასწავლებლებს და ენთუზიასტებს საშუალებას აძლევ
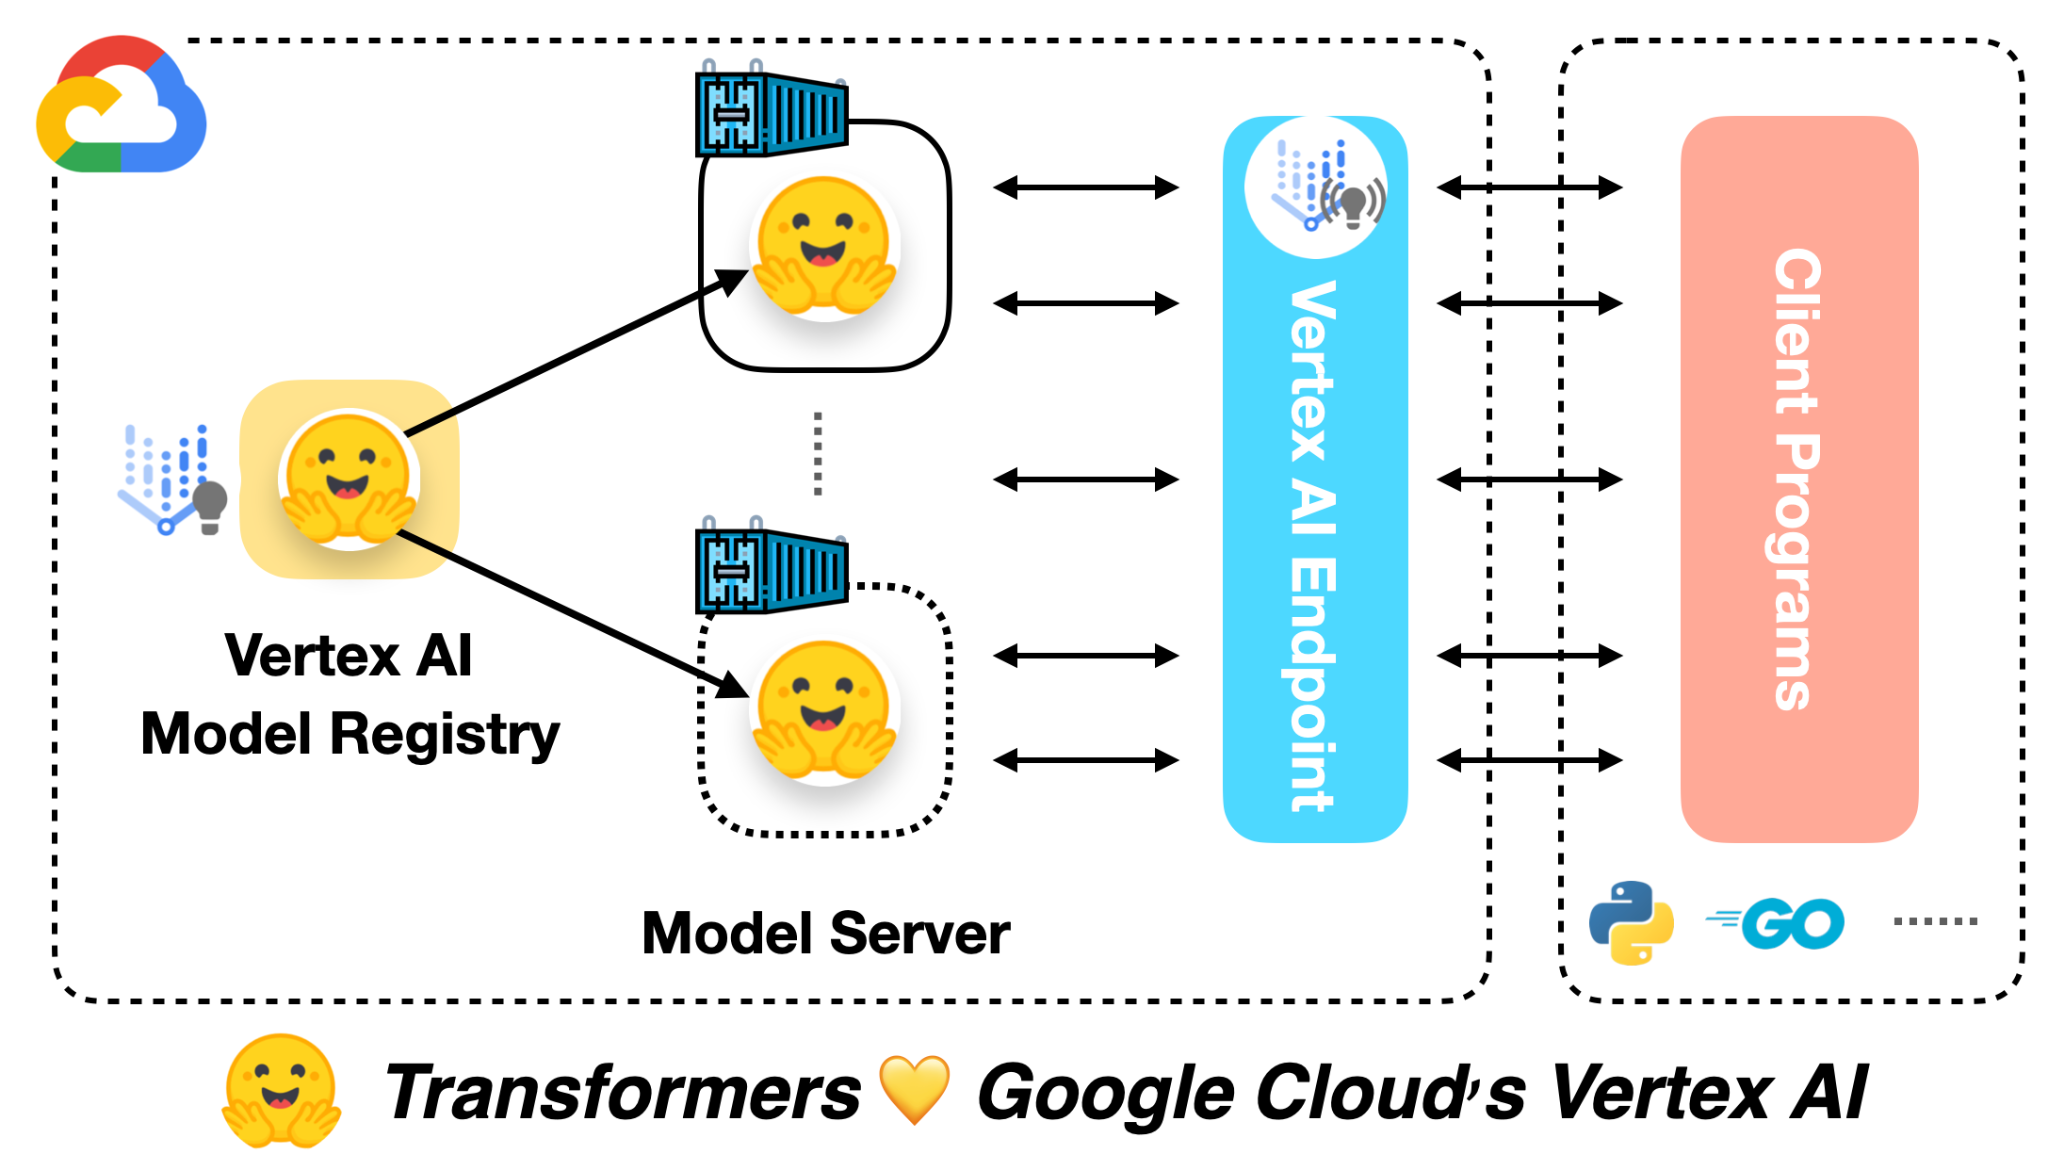
Vertex AI-ის გამოყენება ML მოდელების განლაგებისთვის: დეტალური მიმოხილვა
ეს პუბლიკაცია განიხილავს Google Cloud-ის Vertex AI პლატფორმის შესაძლებლობებს მანქანური სწავლის (ML) მოდელების განლაგებისთვის. ის მოიცავს ისეთ ფუნქციებს, როგორიცაა აუთენტიფიკაცია, ავტომატური სკალირება, მოდელის ვერსიონირება და მონიტორინგი, ასევე TensorFlow მოდელებთან მუშაობის სპეციფიკას. განმარტებულია Vertex AI Model Registry-ის და Endpoint-ის როლი, და მოცემულია განლაგების ნაბიჯ-ნაბიჯ ინსტრუქცია Python SDK-ის გამოყენებით.

Hugging Face-ის Trackio: ახალი ღია კოდის გადაწყვეტა მანქანური სწავლის ექსპერიმენტების თრექინგისთვის
Trackio არის Hugging Face-ის მიერ შემუშავებული ღია კოდის Python ბიბლიოთეკა მანქანური სწავლის მოდელების ვარჯიშის პროგრესის თრექინგისთვის. ის გვთავაზობს მარტივ გაზიარებას, მონაცემთა ხელმისაწვდომობას, ენერგიის მოხმარების გამჭვირვალობას და მოქნილობას ექსპერიმენტებისთვის. ბიბლიოთეკა, რომელიც თავსებადია ისეთ ინსტრუმენტებთან, როგორიცაა wandb, საშუალებას გაძლევთ ადვილად ვიზუალიზაცია მოახდინოთ Gradio დაფაზე და სინქრონიზაცია გაუკეთოთ Hugging Face Spaces-ს.
Hugging Face წარმოგიდგენთ Trackio-ს: ღია კოდის ბიბლიოთეკა ML ექსპერიმენტების მარტივი თვალთვალისთვის
Hugging Face-ის გუნდმა შეიმუშავა Trackio, ღია კოდის Python ბიბლიოთეკა მანქანური სწავლების ექსპერიმენტების თვალთვალისთვის. ის გამოირჩევა გაზიარების სიმარტივით, მონაცემთა ხელმისაწვდომობითა და მოქნილობით. Trackio იყენებს ლოკალურ Gradio დაფას, რომელიც შეიძლება სინქრონიზდეს Hugging Face Spaces-თან, რაც მომხმარებლებს საშუალებას აძლევს მარტივად გააზიარონ პროგრესი. ის ინტეგრირდება Hugging Face-ის სხვა ბიბლიოთეკებთან და მიზნად ისახავს საზოგადოების ჩართულობით განვითარებას, როგორც მსუბუქი და გამჭვირვალე ალ