Hugging Face წარმოგიდგენთ მონაცემთა გაზომვის ხელსაწყოს AI მონაცემთა პასუხისმგებლიანი განვითარებისთვის
Hugging Face-ის გუნდმა გამოუშვა ღია კოდის Python ბიბლიოთეკა და უკოდო ინტერფეისი, სახელწოდებით „მონაცემთა გაზომვის ხელსაწყო“ (Data Measurements Tool - DMT). ეს ინსტრუმენტი მიზნად ისახავს მანქანური სწავლების მონაცემთა ნაკრებების გაგებას, შექმნას, კურირებასა და შედარებას. DMT პასუხობს ხელოვნური ინტელექტის განვითარებაში მონაცემთა გააზრებული ანალიზის ხარვეზს, განსაკუთრებით „დიდი მონაცემების“ გამოყენებისას არსებულ მიკერძოებებსა და ხარვეზებს. ის მომხმარებლებს საშუალებას აძლევს ავტომატურად გამოთვალონ მნ
აქ შეგიძლიათ მიიღოთ წვდომა 🤗 მონაცემთა გაზომვის ხელსაწყოზე.
როგორც მანქანური სწავლების მონაცემთა ნაკრებების სწრაფად მზარდი ერთიანი რეპოზიტორიუმის შემქმნელები (Lhoest et al. 2021), Hugging Face-ის გუნდი მუშაობდა მონაცემთა ნაკრებების დოკუმენტაციის კარგი პრაქტიკის მხარდაჭერაზე (McMillan-Major et al., 2021). მიუხედავად იმისა, რომ სტატიკური (თუმცა განვითარებადი) დოკუმენტაცია აუცილებელი პირველი ნაბიჯია ამ მიმართულებით, იმის ზუსტი გაგება, თუ რა არის რეალურად მონაცემთა ნაკრებში, მოითხოვს კარგად დასაბუთებულ გაზომვებს და მასთან ინტერაქციის შესაძლებლობას, დინამიურად ვიზუალიზაციას სხვადასხვა საინტერესო ასპექტისა.
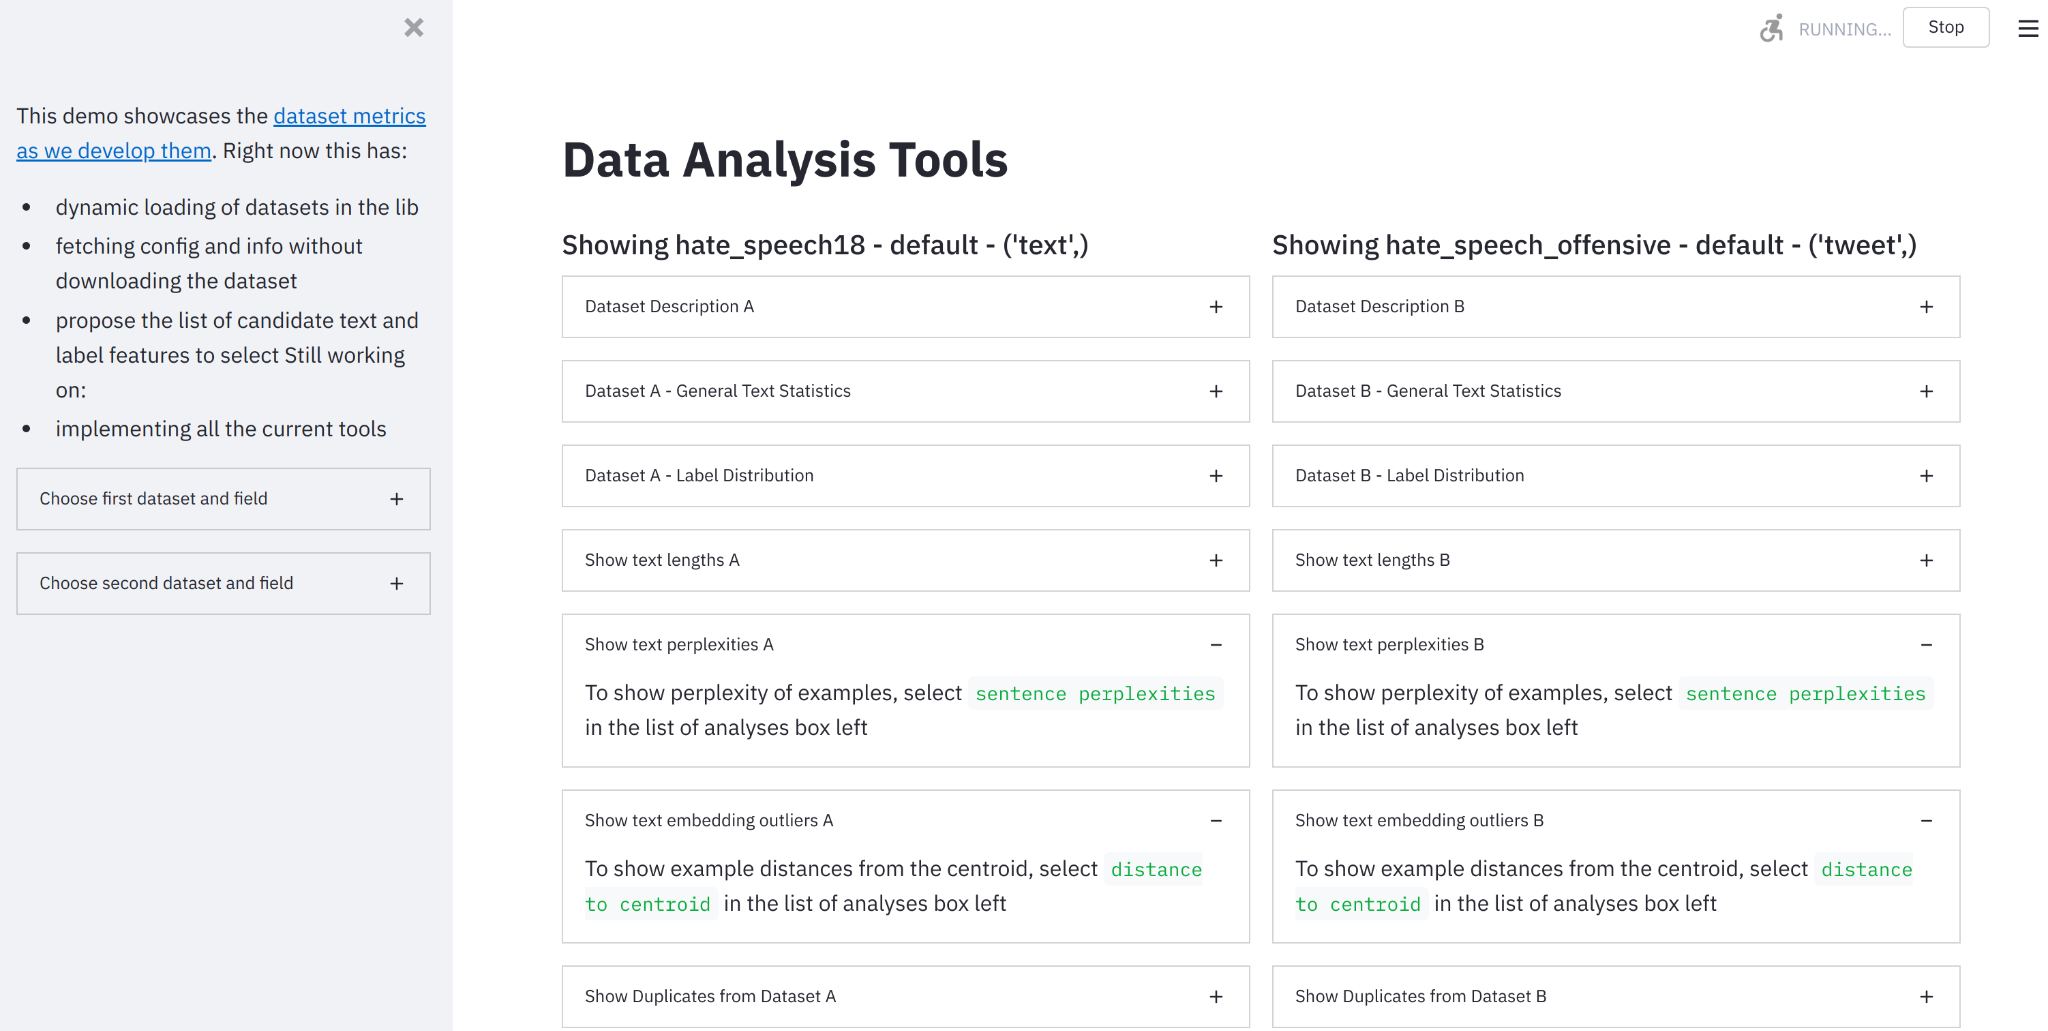
ამ მიზნით, ჩვენ წარმოგიდგენთ ღია კოდის Python ბიბლიოთეკას და უკოდო ინტერფეისს, სახელწოდებით 🤗 მონაცემთა გაზომვის ხელსაწყო (Data Measurements Tool), რომელიც იყენებს ჩვენს Dataset და Spaces Hubs-ს, დიდებულ Streamlit ხელსაწყოსთან ერთად. მისი გამოყენება შესაძლებელია მონაცემთა ნაკრებების გასაგებად, შესაქმნელად, კურირებისთვის და შესადარებლად.
მონაცემთა გაზომვის ხელსაწყო (DMT) არის ინტერაქტიული ინტერფეისი და ღია კოდის ბიბლიოთეკა, რომელიც მონაცემთა ნაკრებების შემქმნელებსა და მომხმარებლებს საშუალებას აძლევს ავტომატურად გამოთვალონ მეტრიკები, რომლებიც მნიშვნელოვანი და სასარგებლოა მონაცემთა პასუხისმგებლიანი განვითარებისთვის. მანქანური სწავლების მონაცემთა ნაკრებების გააზრებული კურირება და ანალიზი ხშირად უგულებელყოფილია ხელოვნური ინტელექტის განვითარებაში. ხელოვნურ ინტელექტში „დიდი მონაცემების“ ამჟამინდელი ნორმები (Luccioni et al., 2021, Dodge et al., 2021) მოიცავს სხვადასხვა ვებგვერდიდან მოპოვებული მონაცემების გამოყენებას, მცირე ან საერთოდ უყურადღებობით იმის მიმართ, თუ რას წარმოადგენს სხვადასხვა მონაცემთა წყარო, ან რა დეტალებით შეიძლება გავლენა მოახდინონ იმაზე, თუ რას სწავლობს მოდელი.
მიუხედავად იმისა, რომ მონაცემთა ნაკრებების ანოტაციის მიდგომებს შეუძლიათ ხელი შეუწყონ ისეთი მონაცემთა ნაკრებების კურირებას, რომლებიც უფრო მეტად შეესაბამება დეველოპერის მიზნებს, ამ მონაცემთა ნაკრებების სხვადასხვა ასპექტის „გაზომვის“ მეთოდები საკმაოდ შეზღუდულია (Sambasivan et al., 2021). ხელოვნურ ინტელექტში კვლევის ახალმა ტალღამ მოითხოვა ფუნდამენტური პარადიგმული ცვლილება იმის შესახებ, თუ როგორ უდგება სფერო მანქანური სწავლების მონაცემთა ნაკრებებს (Paullada et al., 2020, Denton et al., 2021). ეს მოიცავს მონაცემთა ნაკრების შექმნის დაწვრილებითი მოთხოვნების განსაზღვრას თავიდანვე (Hutchinson et al., 2021), მონაცემთა ნაკრებების კურირებას პრობლემური შინაარსისა და მიკერძოების გათვალისწინებით (Yang et al., 2020, Prabhu and Birhane, 2020) და მონაცემთა ნაკრების კონსტრუქციასა და შენარჩუნებაში არსებული ღირებულებების მკაფიოდ გამოკვეთას (Scheuerman et al., 2021, Birhane et al., 2021).
მიუხედავად იმისა, რომ არსებობს ზოგადი შეთანხმება, რომ მონაცემთა ნაკრების განვითარება არის ამოცანა, რომლის ინფორმირებაც მრავალი სხვადასხვა დისციპლინის ადამიანებს უნდა შეეძლოთ, პრაქტიკაში ხშირად არსებობს შეფერხება ნედლ მონაცემებთან ინტერფეისისას, რაც მოითხოვს კომპლექსურ კოდირების უნარებს მონაცემთა ნაკრების ანალიზისა და მოთხოვნებისთვის. ამის მიუხედავად, საზოგადოებისთვის ღიად ხელმისაწვდომია ცოტა ინსტრუმენტი, რომელიც სხვადასხვა დისციპლინის ადამიანებს საშუალებას მისცემს მონაცემთა ნაკრებების გაზომვას, შესწავლას და შედარებას. ჩვენ მიზნად ვისახავთ ამ ხარვეზის შევსებას.
ჩვენ ვსწავლობთ და ვაშენებთ უახლესი ინსტრუმენტების საფუძველზე, როგორიცაა Know Your Data და Data Quality for AI, ასევე მონაცემთა ნაკრების დოკუმენტაციის კვლევითი წინადადებების საფუძველზე, როგორიცაა Vision and Language Datasets (Ferraro et al., 2015), Datasheets for Datasets (Gebru et al, 2018) და Data Statements (Bender & Friedman 2019). შედეგად მივიღეთ ღია კოდის ბიბლიოთეკა მონაცემთა ნაკრების გაზომვებისთვის და თანმხლები უკოდო ინტერფეისი მონაცემთა ნაკრების დეტალური ანალიზისთვის.
🤗 მონაცემთა გაზომვის ხელსაწყოს გამოყენება შესაძლებელია იტერაციულად ერთი ან მეტი არსებული NLP მონაცემთა ნაკრების შესასწავლად, და მალე მხარს დაუჭერს მონაცემთა ნაკრებების იტერაციულ განვითარებას ნულიდან. ის გვაწვდის პრაქტიკულ დასკვნებს, რომლებიც ეფუძნება მონაცემთა ნაკრებებისა და პასუხისმგებლიანი მონაცემთა ნაკრებების განვითარების კვლევებს, რაც მომხმარებლებს საშუალებას აძლევს ფოკუსირება მოახდინონ როგორც მაღალი დონის ინფორმაციაზე, ასევე კონკრეტულ ელემენტებზე.
**მონაცემთა ნაკრების მაღალი დონის მიმოხილვისთვის:**
ეს იწყებს ისეთ კითხვებზე პასუხის გაცემას, როგორიცაა „რა არის ეს მონაცემთა ნაკრები? აქვს თუ არა მას დაკარგული ელემენტები?“. შეგიძლიათ ეს გამოიყენოთ, როგორც „საღი აზრის შემოწმება“, რომ მონაცემთა ნაკრები, რომელთანაც მუშაობთ, არის ისეთი, როგორსაც ელოდით.
* მონაცემთა ნაკრების აღწერა (Hugging Face Hub-დან)
* დაკარგული მნიშვნელობების ან NaN-ების რაოდენობა
**მონაცემთა ნაკრების ზედაპირული მახასიათებლების სანახავად:**
ეს იწყებს ისეთ კითხვებზე პასუხის გაცემას, როგორიცაა „რა სახის ენაა ამ მონაცემთა ნაკრებში? რამდენად მრავალფეროვანია ის?“
* მონაცემთა ნაკრების ლექსიკონის ზომა და სიტყვების განაწილება, როგორც ღია, ასევე დახურული კლასის სიტყვებისთვის.
* მონაცემთა ნაკრების ეტიკეტის განაწილება და ინფორმაცია კლასის (დის)ბალანსის შესახებ.
* ინსტანციების სიგრძის საშუალო, მედიანა, დიაპაზონი და განაწილება.
* დუბლიკატების რაოდენობა მონაცემთა ნაკრებში და რამდენჯერ მეორდება ისინი.
შეგიძლიათ გამოიყენოთ ეს ვიჯეტები იმის შესამოწმებლად, რამდენად შეესაბამება მონაცემთა ნაკრებში ყველაზე მეტად და ყველაზე ნაკლებად წარმოდგენილი ინფორმაცია ნაკრების მიზნებს. ეს გაზომვები მიზნად ისახავს ინფორმაციის მიწოდებას იმის შესახებ, შეიძლება თუ არა მონაცემთა ნაკრები სასარგებლო იყოს სხვადასხვა კონტექსტის ასახვისთვის, ან რამდენად შეზღუდულია ის, რასაც ის აფიქსირებს, და ასევე იმის გაზომვას, თუ რამდენად „დაბალანსებულია“ ეტიკეტები და ინსტანციების სიგრძე. ასევე შეგიძლიათ გამოიყენოთ ეს ვიჯეტები გარე მნიშვნელობებისა და დუბლიკატების იდენტიფიცირებისთვის, რომელთა წაშლაც შეიძლება მოგინდეთ.
**მონაცემთა ნაკრებში ენის ნიმუშების გასაზომად:**
ეს იწყებს ისეთ კითხვებზე პასუხის გაცემას, როგორიცაა „როგორ იქცევა ენა ამ მონაცემთა ნაკრებში?“ შეგიძლიათ ეს გამოიყენოთ იმის გასარკვევად, წარმოადგენს თუ არა თქვენი მონაცემთა ნაკრები ენას ისე, როგორც ის ბუნებრივ სამყაროში იქცევა, თუ მასში არის რაღაცები, რაც უფრო არაბუნებრივია.
თეგები:
#ხელოვნური ინტელექტი
#მანქანური სწავლება
#მონაცემთა ანალიზი
#hugging face
#ღია კოდი
#მონაცემთა ნაკრები
#python
#პასუხისმგებლიანი ai
#streamlit
წყარო: huggingface.co
AI-ით გადამუშავებული


