
NVIDIA Cosmos Reasoning 2B მოდელის განთავსება Jetson მოწყობილობებზე vLLM-ის გამოყენებით
ხელოვნური ინტელექტის მოდელების სწრაფმა ევოლუციამ, რაც ზრდის მათ სიზუსტესა და ეფექტურობას, ისინი იდეალურს ხდის პერიფერიული მოწყობილობებისთვის. NVIDIA Jetson-ის ოჯახი, მაღალპროდუქტიული AGX Thor-დან და AGX Orin-დან დაწყებული კომპაქტური Orin Nano Super-ით დამთავრებული, შექმნილია ფიზიკური ხელოვნური ინტელექტისა და რობოტიკისთვის განკუთვნილი აპლიკაციების დასაჩქარებლად, რაც უზრუნველყოფს ოპტიმიზებულ შესრულებას ღია კოდის წამყვანი მოდელებისთვის. ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა განათავსოთ N

გიორგი გერგანოვის გუნდი Hugging Face-ს უერთდება: ახალი ეტაპი ადგილობრივი AI-ის განვითარებაში
გიორგი გერგანოვი და მისი გუნდი, რომლებიც დგანან ggml-ისა და llama.cpp-ის პროექტების უკან, უერთდებიან Hugging Face-ს. ეს ნაბიჯი მიზნად ისახავს ადგილობრივი ხელოვნური ინტელექტის (AI) ექსპონენციურ განვითარებას მომდევნო წლებში, პროექტის გრძელვადიანი, მდგრადი რესურსებით უზრუნველყოფას და მისი ღია კოდის ბუნების შენარჩუნებას. გუნდი სრულ ავტონომიას შეინარჩუნებს ტექნიკურ მიმართულებებსა და საზოგადოებასთან მუშაობაში.

Red Hat-ის ახალი ინსტრუმენტი ციფრული სუვერენიტეტის შესაფასებლად
Red Hat, ამერიკული ტექნოლოგიური გიგანტი, ევროპულ ორგანიზაციებს ციფრული სუვერენიტეტის მიღწევაში ეხმარება. კომპანიამ გამოუშვა ღია კოდის ინსტრუმენტი, "Digital Sovereignty Readiness Assessment", რომელიც მთავრობებსა და საწარმოებს საკუთარი მონაცემების, ინფრასტრუქტურისა და ოპერაციების კონტროლის დონის შეფასების კონკრეტულ გზას სთავაზობს. ინიციატივა ხელს უწყობს გამჭვირვალობას და მოშორებას "ბრმა ნდობისგან" აუდიტორული და გადამოწმებადი სუვერენიტეტის მოდელისკენ.

NTT DATA-ს სიახლე: სინთეზური მონაცემები იაპონური AI-ის „მონაცემთა კედელს“ ანგრევს
იაპონელი AI დეველოპერები კულტურულად სპეციფიკური სასწავლო მონაცემების ქრონიკულ დეფიციტს აწყდებიან, რაც ინოვაციას აფერხებს. NTT DATA-ს ახალი კვლევა, NVIDIA Nemotron-Personas-Japan-ის გამოყენებით, აჩვენებს, თუ როგორ შეუძლია სინთეზურ მონაცემებს ამ გამოწვევის დაძლევა. ექსპერიმენტმა იურიდიული კითხვა-პასუხის ამოცანებში მოდელის სიზუსტე 15.3%-დან 79.3%-მდე გაზარდა კონფიდენციალურობის დარღვევის გარეშე. ეს მიდგომა კომპანიებს საშუალებას აძლევს, ააგონ დომენ-სპეციფიკური AI ღია კოდის ინფრასტრუქტურით, შეამცირონ

AI კოდირების გავლენა ღია კოდის პროგრამულ უზრუნველყოფაზე: ხარისხის კრიზისი თუ პროდუქტიულობის ზრდა?
AI კოდირების ინსტრუმენტები, რომლებიც პროგრამული უზრუნველყოფის შექმნის გამარტივებასა და გაიაფებას ჰპირდებოდნენ, ღია კოდის პროექტებში არაერთგვაროვან შედეგებს იწვევს. მიუხედავად იმისა, რომ მათ შეუძლიათ ახალი მოდულების შექმნა გააადვილონ გამოცდილი დეველოპერებისთვის, ისინი ასევე ხელს უწყობენ დაბალი ხარისხის კოდის მოზღვავებას, რაც ართულებს პროექტების მართვას, ზრდის რევიუერების დატვირთვას და საფრთხეს უქმნის ეკოსისტემების ფრაგმენტაციას. ეს იწვევს დებატებს AI-ის გავლენის შესახებ პროგრამული უზრუნველყოფის ხ

GPT4All: ლოკალური, ღია კოდის ხელოვნური ინტელექტი, რომელიც ყურადღებას იმსახურებს
სტატია განიხილავს GPT4All-ს, უფასო და ღია კოდის ხელოვნური ინტელექტის ინსტრუმენტს, რომელიც მუშაობს ლოკალურად Windows-ზე, MacOS-ზე და Linux-ზე. ავტორი უზიარებს თავის გამოცდილებას GPT4All-ის ინსტალაციისა და გამოყენების შესახებ, ადარებს მას Ollama-ს და აღნიშნავს მის ძირითად ფუნქციებს, როგორიცაა მრავალი LLM-ის მხარდაჭერა და დოკუმენტების ლოკალური დამუშავება.

ინდურმა AI ლაბორატორიამ „სარვამმა“ ახალი დიდი ენობრივი მოდელები წარადგინა, კონკურენციას უწევს გლობალურ გიგანტებს
ინდურმა ხელოვნური ინტელექტის ლაბორატორიამ Sarvam-მა წარმოადგინა ახალი თაობის დიდი ენობრივი მოდელები, მათ შორის 30-მილიარდიანი და 105-მილიარდიანი პარამეტრების მოდელები. კომპანია ფსონს დებს მცირე, ეფექტურ ღია კოდის AI მოდელებზე, რათა დაეუფლოს ბაზრის წილს უფრო ძვირი ამერიკული და ჩინური სისტემებისგან. ეს გაშვება შეესაბამება ინდოეთის მიზანს, შეამციროს დამოკიდებულება უცხოურ AI პლატფორმებზე და მოარგოს მოდელები ადგილობრივ ენებსა და გამოყენების შემთხვევებს, რეალურ დროში აპლიკაციების მხარდაჭერით.
ევროკავშირის AI აქტი: რა უნდა იცოდნენ ღია კოდის AI სისტემების შემქმნელებმა
ევროკავშირის ხელოვნური ინტელექტის აქტი (AI Act) შესაძლოა გავრცელდეს ღია კოდის AI სისტემებსა და მოდელებზე, სპეციფიკური წესებით, რომლებიც დამოკიდებულია მოდელის ტიპსა და მის გამოშვებაზე. უმეტეს შემთხვევაში, ვალდებულებები მოიცავს მკაფიო დოკუმენტაციის მიწოდებას, მოდელის შესახებ ინფორმაციის გასამჟღავნებლად ხელსაწყოების დამატებას განთავსებისას და არსებული საავტორო უფლებებისა და კონფიდენციალურობის წესების დაცვას. საბედნიეროდ, ამ პრაქტიკის უმეტესობა უკვე გავრცელებულია ღია კოდის სივრცეში, და Hugging Face
Hugging Face Hub: მანქანური სწავლების შესაძლებლობები GLAM სექტორისთვის
Hugging Face მიზნად ისახავს უმაღლესი ხარისხის მანქანური სწავლების საყოველთაო ხელმისაწვდომობას. ამის მისაღწევად კომპანია აწვდის ღია კოდის ბიბლიოთეკებს, უფასო კურსებს და Hugging Face Hub-ს – ცენტრალურ საცავს 190,000-ზე მეტი მოდელით, 33,000 მონაცემთა ნაკრებით და 100,000-ზე მეტი აპლიკაციით. ეს სტატია განკუთვნილია GLAM სექტორში (გალერეები, ბიბლიოთეკები, არქივები, მუზეუმები) მომუშავე პირებისთვის, რათა გაიგონ, როგორ გამოიყენონ და როგორ შეიტანონ წვლილი Hub-ში. მაგალითად, NER მოდელის გამოყენება ციფრული დ
„მონაცემები ერთად უკეთესია“: Hugging Face და ღია კოდის AI საზოგადოება რევოლუციას ახდენენ გამოსახულების გენერაციაში
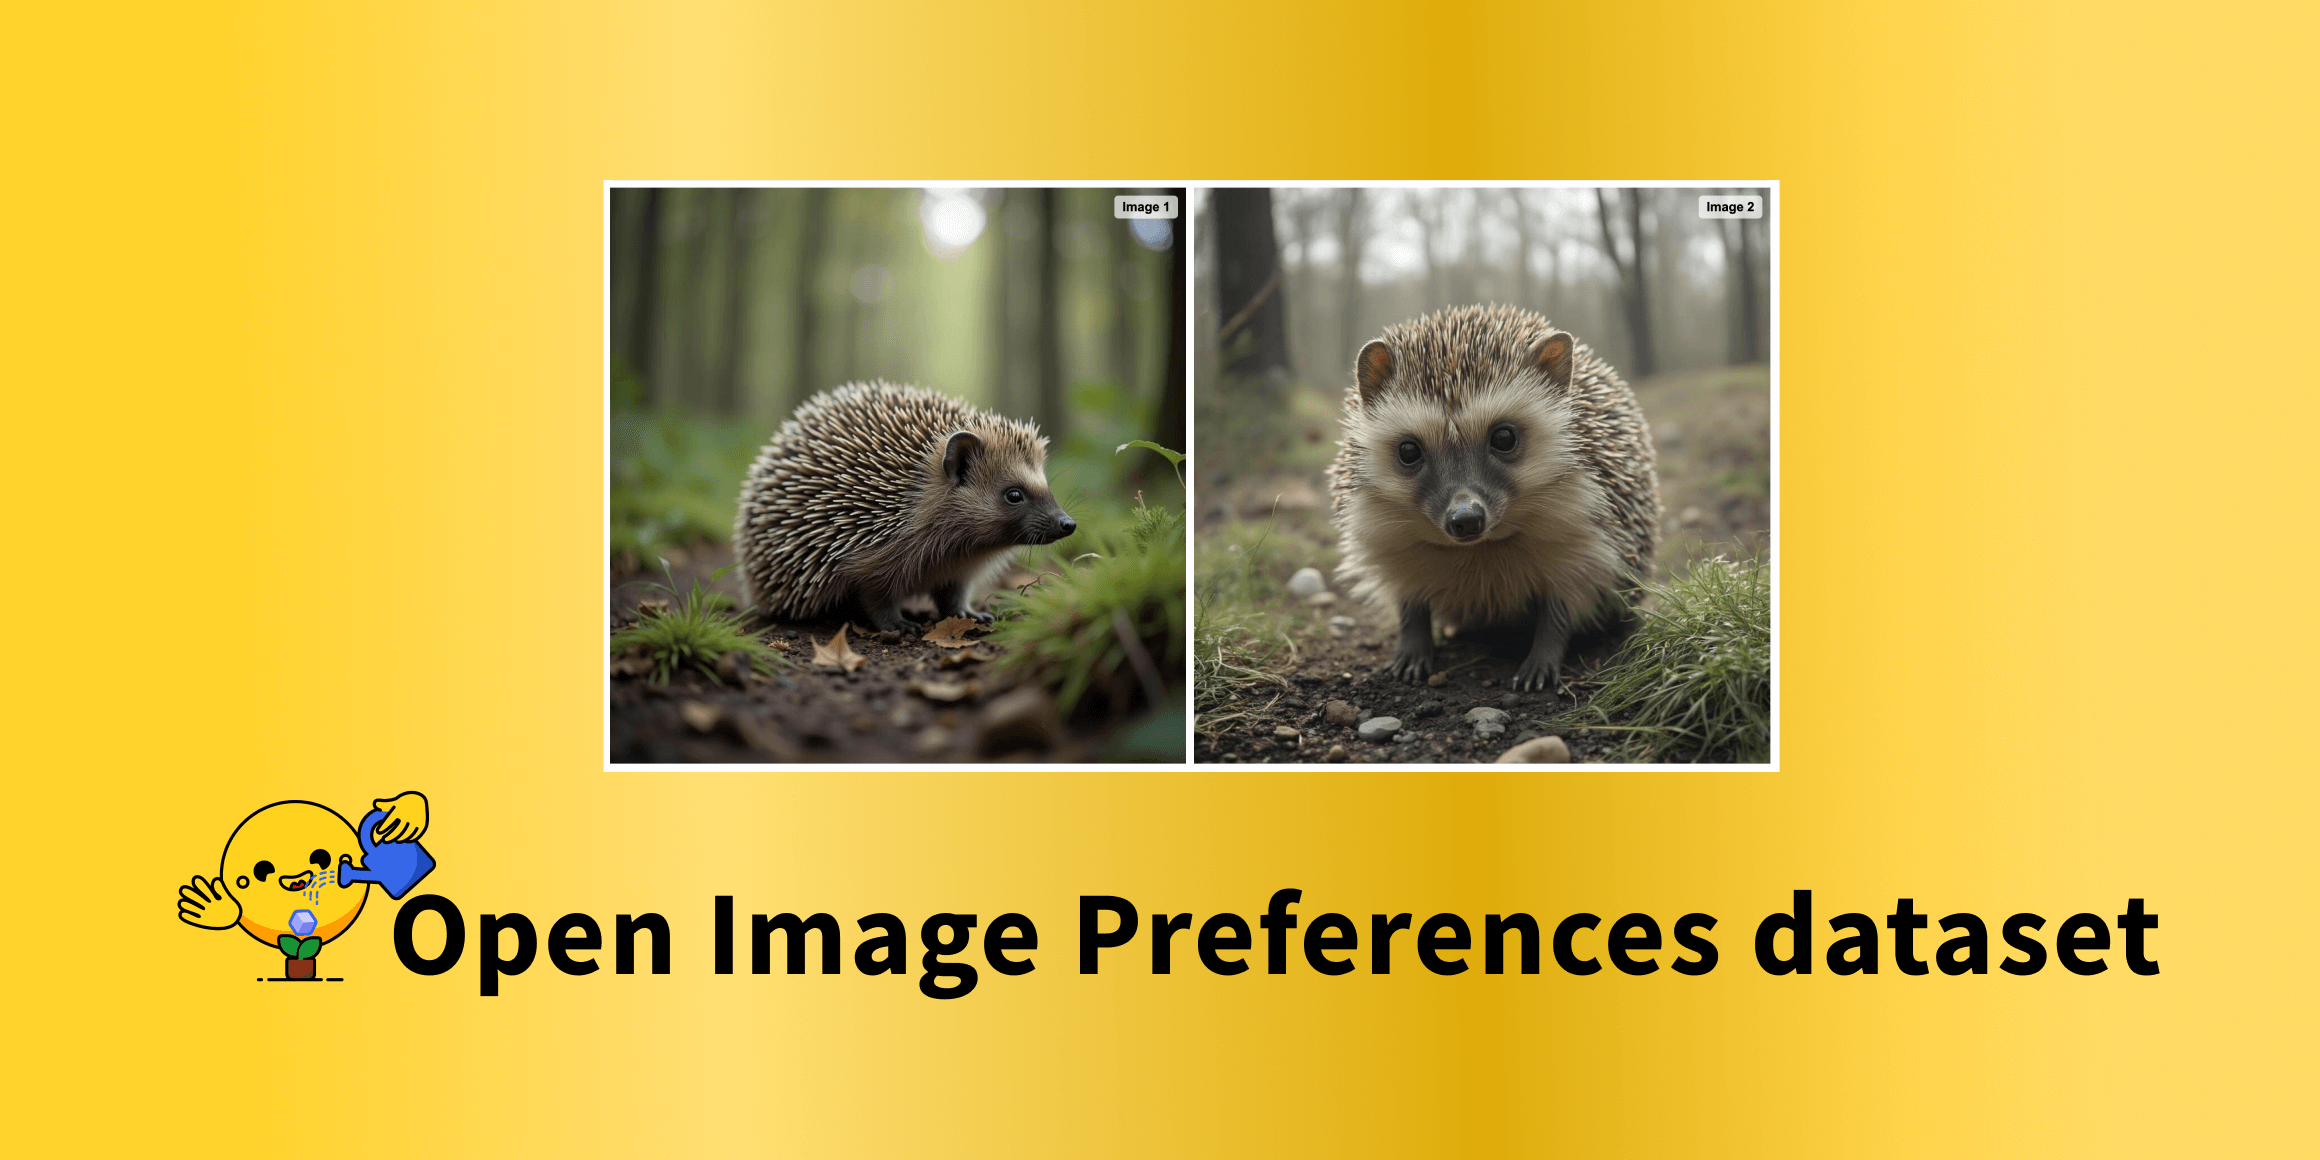
სტატია აღწერს Hugging Face-ისა და ღია კოდის AI საზოგადოების ერთობლივ პროექტს, სახელწოდებით „მონაცემები ერთად უკეთესია“, რომელიც მიზნად ისახავს ღია კოდის ეფექტური მონაცემთა ნაკრებების შექმნას. მნიშვნელოვანი მიღწევაა `open-image-preferences-v1`, უნიკალური გამოსახულების უპირატესობის მონაცემთა ნაკრები, რომელიც გამოირჩევა მრავალფეროვანი პრომპტებითა და ღია განვითარებით. მონაცემთა ნაკრები დეტალურად შეიქმნა სინთეზური მონაცემების გენერაციის, ტოქსიკურობის მოწინავე ფილტრაციისა და Flux-ისა და Stable Diffusi

LeMaterial-ის გაშვება: ღია კოდის კოლაბორაციული პროექტი მასალების კვლევისთვის Entalpic-ისა და Hugging Face-ისგან
Entalpic-ისა და Hugging Face-ის მიერ ინიცირებული ღია კოდის კოლაბორაციული პროექტი LeMaterial ამოქმედდა, რომლის მიზანია მასალების კვლევის გამარტივება და დაჩქარება. პროექტი ხელს შეუწყობს მანქანური სწავლების მოდელების გაწვრთნას, ახალი მასალების იდენტიფიცირებას და ქიმიური სივრცეების შესწავლას. პირველ ეტაპზე გამოვიდა LeMat-Bulk მონაცემთა ნაკრები, რომელიც აერთიანებს, ასუფთავებს და სტანდარტიზაციას უკეთებს წამყვან მონაცემთა ბაზებს (Materials Project, Alexandria, OQMD), ქმნის 6.7 მილიონი ჩანაწერისა და 7 მ
Writer-ის გზა: Hugging Face-ის მომხმარებლიდან ღია კოდის კონტრიბუტორამდე
ამ ინტერვიუში Writer-ის თანადამფუძნებელი და ტექნიკური დირექტორი, ვასიმ ალშიხი, საუბრობს Hugging Face-თან მათი თანამშრომლობის ევოლუციაზე, დაწყებული უბრალო მომხმარებლობიდან, დამთავრებული ღია კოდის მოდელების შექმნამდე.
LLM-ების განთავსება Hugging Face Inference Endpoints-ზე: სრული გზამკვლევი
ამ ბლოგპოსტში განხილულია, თუ როგორ უნდა განათავსოთ ღია კოდის დიდი ენობრივი მოდელები (LLM) Hugging Face Inference Endpoints-ის გამოყენებით, მართული SaaS გადაწყვეტის, რომელიც ამარტივებს მოდელების განთავსებას. სტატია მოიცავს პასუხების სტრიმინგის მეთოდებსა და ენდპოინტების წარმადობის ტესტირებას. Hugging Face Inference Endpoints უზრუნველყოფს AI აპლიკაციების სწრაფ და უსაფრთხო შექმნას ინფრასტრუქტურის მართვის გარეშე, ავტომატური მასშტაბირების, ნულამდე შემცირებისა და გაუმჯობესებული უსაფრთხოების ფუნქციებით.
AI WebTV: ხელოვნური ინტელექტით შექმნილი ვიდეო კონტენტის ინოვაციური პლატფორმა
AI WebTV წარმოადგენს ინოვაციურ პლატფორმას, რომელიც დემონსტრირებს ღია კოდის ტექსტი-ვიდეოდ გადამყვანი მოდელებით, როგორიცაა Zeroscope და MusicGen, გენერირებულ ვიდეოებს. ის შექმნილია მოკლე, ტექნოლოგიური დემო კლიპების სახით, სადაც დიდი ენობრივი მოდელები (LLM), მაგალითად ChatGPT, გამოიყენება ვიდეო კადრებისთვის მრავალფეროვანი მოთხოვნების შესაქმნელად. სისტემა დანერგილია NodeJS-სა და TypeScript-ში, იყენებს Hugging Face-ის სერვისებს და მოიცავს კადრების გაფართოებას FILM ალგორითმით, ასევე მუსიკის დამატებას
ღია კოდის AI თამაშების ჯემი: გამარჯვებული და გამორჩეული ნამუშევრები
ღია კოდის ხელოვნური ინტელექტის თამაშების ჯემმა, რომლის მიზანიც იყო ღია კოდის AI ინსტრუმენტების თამაშებში ინტეგრირება, მოლოდინს გადააჭარბა 1300-ზე მეტი რეგისტრაციითა და 88 თამაშის წარდგენით. თემამ „გაფართოება“ ხელი შეუწყო მრავალფეროვან შემოქმედებას. თანატოლთა შეფასებისა და ჟიურის მსჯელობის შემდეგ, „Snip It“ (ohmlet-ის მიერ) დასახელდა გამარჯვებულად, რომელმაც წარმოაჩინა ინოვაციური, ხელოვნური ინტელექტის მიერ გენერირებული გეიმპლეი.
Stable Diffusion XL Core ML-ზე: მოდელის ზომის შემცირება და მუშაობის გაუმჯობესება
Hugging Face-ი და Apple-ი აგრძელებენ ხელოვნური ინტელექტის მოდელების ოპტიმიზაციას სამომხმარებლო მოწყობილობებზე ადგილობრივად გასაშვებად. უახლესი მცდელობა Stable Diffusion XL-ის Core ML-ზე ადაპტაციაა Apple Silicon-ის Mac-ებისთვის, რაც საშუალებას იძლევა მოდელი შემცირდეს ზომით და გაუმჯობესდეს მისი მუშაობა ინოვაციური კვანტიზაციის მეთოდებით, მათ შორის შერეული ბიტების პალეტიზაციით. პროექტი სრულად ღია კოდით არის ხელმისაწვდომი და community-ის ჩართულობას ელის.

ღია კოდის ვიდეო გენერაციის მოდელების აღზევება: დგას თუ არა AI „Stable Diffusion-ის მომენტის“ ზღურბლზე?
ბოლო დროს შეინიშნება ღია კოდის ვიდეოს გენერაციის მოდელების, მათ შორის CogVideoX, Mochi-1, Hunyuan და LTX Video-ს სწრაფი ზრდა, რაც ბადებს კითხვას, დგას თუ არა ვიდეო საზოგადოება ხელოვნური ინტელექტის „Stable Diffusion-ის მომენტის“ ზღურბლზე. ეს სტატია მიმოიხილავს ვიდეოს გენერაციის მოდელების მიმდინარე მდგომარეობას, ხაზს უსვამს ისეთ შეზღუდვებს, როგორიცაა მოძრაობის ხარისხი, დროითი თანმიმდევრულობა და მეხსიერების მაღალი მოთხოვნები. Diffusers-ის გუნდი აქტიურად მუშაობს ამ გამოწვევების გადასაჭრელად სხვადასხ
ხელოვნური ინტელექტის ვიდეო გენერაციის მოდელები: მიმდინარე მდგომარეობა და ოპტიმიზაციის გზები
ღია კოდის პროექტებში ვიდეოს გენერაციის მოდელების სწრაფი განვითარება შეინიშნება, რამაც შეიძლება გამოიწვიოს „Stable Diffusion მომენტის“ განმეორება ვიდეო საზოგადოებაში. ეს სტატია მიმოიხილავს ვიდეოს გენერაციის მოდელების მიმდინარე მდგომარეობას, მათ შეზღუდვებს (კერძოდ, მოძრაობის ხარისხს, თანმიმდევრულობასა და კონსისტენტურობას დროის განმავლობაში) და არქიტექტურულ თავისებურებებს, როგორიცაა 3D ვიდეო ტოკენების დამუშავება. ყურადღება ექცევა Diffusers-ის გუნდის მიერ შემოთავაზებულ მეხსიერების ოპტიმიზაციის ტექნი

ხელოვნური ინტელექტი და ხელოვნება: 2024 წლის საკვანძო მიღწევების მიმოხილვა და 2025 წლის მოლოდინები
ბოლო რამდენიმე წელი გადამწყვეტი აღმოჩნდა ღია კოდის მოდელებისა და ინსტრუმენტებისთვის ხელოვნების სფეროში. შემოქმედებითი გამოხატვისთვის განკუთვნილი ხელოვნური ინტელექტის ხელსაწყოები არასოდეს ყოფილა ასეთი ხელმისაწვდომი, და ეს მხოლოდ დასაწყისია. ეს სტატია მიმოიხილავს 2024 წლის ძირითად მიღწევებს ხელოვნური ინტელექტის მიერ გენერირებულ გამოსახულებებში, მათ შორის DiT არქიტექტურის, პერსონალიზაციისა და „ზერო-შოთ“ ტექნიკების წინსვლას. ხაზგასმულია, თუ როგორ ეჯიბრებიან ღია კოდის მოდელები დახურული კოდის გიგანტებ
ხელოვნური ინტელექტი ხელოვნებაში: ღია კოდის მოდელების გარდამტეხი წელი (2024-ის მიღწევები და 2025-ის მოლოდინები)
ბოლო რამდენიმე წელი, განსაკუთრებით კი 2024, გარდამტეხი აღმოჩნდა ხელოვნური ინტელექტის (AI) ღია კოდის მოდელებისა და ინსტრუმენტებისთვის ხელოვნებითი გამოყენების კუთხით. ამ მიმოხილვაში განვიხილავთ 2024 წლის მთავარ მიღწევებს, როგორიცაა DiT არქიტექტურის და Flux.1-ის გამოჩენა, პერსონალიზაციის ტექნიკების გაუმჯობესება და „ნულოვანი ოპტიმიზაციის“ მეთოდების აღმასვლა გამოსახულების გენერაციაში. სტატია ასევე მიმოიხილავს ვიდეოს გენერაციის სფეროში არსებულ გამოწვევებს და 2025 წლის მოლოდინებს, რომელიც AI და ხელოვნე
DeepFloyd IF-ის ინტეგრაცია BentoML-თან პროდუქტიული განთავსებისთვის
სტატია მიმოიხილავს, თუ როგორ ხდება BentoML-ის, ღია კოდის პლატფორმის, გამოყენება DeepFloyd IF-ის, თანამედროვე ტექსტიდან გამოსახულების გენერირების მოდელის, განთავსებისთვის. აღწერილია DeepFloyd IF-ის უნიკალური არქიტექტურა (პიქსელურ სივრცეში მუშაობა, კასკადური დიფუზია, LLM-ის გამოყენება მოთხოვნებისთვის) და BentoML-ის მეშვეობით რესურსების ოპტიმალური მართვა, მათ შორის GPU-ს განაწილება. მოცემულია ინსტრუქციები პროექტის ლოკალურად გაშვებისთვის, მოდელების ჩამოტვირთვისთვის, სერვერის Gradio-სთან ერთად გაშვებ
OpenAI-მ Deep Research გამოუშვა: ვებ-დათვალიერების სისტემა და ღია კოდით მისი რეპროდუცირების მცდელობები
OpenAI-მ წარმოადგინა „Deep Research“ – ინოვაციური სისტემა, რომელიც ვებ-კონტენტს აჯამებს და კითხვებზე პასუხობს. სისტემამ შთამბეჭდავი შედეგები აჩვენა General AI Assistants (GAIA) ბენჩმარკზე, მიაღწია თითქმის 67%-იან სიზუსტეს საშუალოდ და 47.6%-ს რთულ „დონე 3“ კითხვებზე. Deep Research აგებულია დიდ ენობრივ მოდელზე (LLM) და აგენტურ ჩარჩოზე, რომელიც მას ინსტრუმენტების გამოყენებაში ეხმარება. მიუხედავად OpenAI-ს მიერ აგენტური ჩარჩოს დეტალების არგამჟღავნებისა, ღია კოდის საზოგადოებამ 24-საათიანი მისია დაიწყ
Hugging Face წარმოგიდგენთ SafeCoder-ს: უსაფრთხო, თვით-ჰოსტინგით AI პროგრამისტს საწარმოებისთვის
Hugging Face-ის SafeCoder მიზნად ისახავს პროგრამული უზრუნველყოფის შემუშავების პროდუქტიულობის გაზრდას საწარმოებში, სრულად შესაბამისი, თვით-ჰოსტინგითა და უსაფრთხო AI კოდის ასისტენტის შეთავაზებით. გადაწყვეტა ეფუძნება ღია კოდის მოდელებს, როგორიცაა StarCoder, და უზრუნველყოფს მონაცემთა კონფიდენციალურობასა და იურიდიულ შესაბამისობას, რადგან კომპანიებს საშუალებას აძლევს, საკუთარ ინფრასტრუქტურაზე დაახვეწონ LLM-ები, მესამე მხარესთან კოდის გაზიარების გარეშე.

ვიდეო გენერაციის მონაცემთა ნაკრებების შექმნა: ახალი ინსტრუმენტები საზოგადოებისთვის
ამ სტატიაში განვიხილავთ ვიდეო გენერაციის მონაცემთა ნაკრებების შექმნისთვის შემუშავებულ ახალ ინსტრუმენტებს, რომლებიც მიზნად ისახავს ამ პროცესის გამარტივებას, სურათების გენერაციის მსგავსად. წარმოდგენილია ღია კოდის სკრიპტები მცირე მასშტაბისთვის და video2dataset დიდი მასშტაბისთვის. დეტალურად აღიწერება მონაცემთა დამუშავების 3-ეტაპიანი კონვეიერი, ფილტრაციის სტრატეგიები (მათ შორის pwatermark-ისა და ესთეტიკური ქულების გამოყენებით) და მათი გავლენა ვიდეო გენერაციის მოდელების ხარისხზე. მიზანია, საზოგადოებას