
ZDNET-ის რეკომენდაციები და პრეზიდენტების დღის გარიგებები: ჭკვიანი სათვალეების შეძენის სახელმძღვანელო
სტატია განმარტავს ZDNET-ის მკაცრ მეთოდოლოგიას პროდუქტების ტესტირებისა და შეფასებისას, ხაზს უსვამს სარედაქციო მიუკერძოებლობას და მომხმარებლისთვის ზუსტი ინფორმაციის მიწოდების მიზანს. ასევე, მიმოიხილავს პრეზიდენტების დღის ფასდაკლებებს, განსაკუთრებით ჭკვიან სათვალეებზე, ხელოვნური ინტელექტის მხარდაჭერითა და გაფართოებული რეალობის (XR) ფუნქციებით. მოცემულია რეკომენდაციები ისეთი მოდელების შესახებ, როგორებიცაა RayNeo Air 3s, Meta Oakley და Amazon Echo Glasses.

ZDNET-ის რეკომენდაციები: რას ნიშნავს ეს და რატომ იქცა Kindle Paperwhite Signature Edition შეუცვლელ ელექტრონულ წიგნად?
ZDNET განმარტავს თავის სარედაქციო პრინციპებსა და პროდუქციის შეფასების მეთოდოლოგიას, რომელიც დაფუძნებულია ტესტირებაზე, კვლევასა და დამოუკიდებელ მიმოხილვებზე. სტატიაში ავტორი იზიარებს საკუთარ გამოცდილებას ელექტრონულ წიგნებთან დაკავშირებით, ადარებს TCL Nxtpaper Tab 10-სა და Kindle Paperwhite Signature Edition-ს. მიუხედავად TCL-ის უპირატესობებისა, Kindle Paperwhite SE გამოირჩევა თავისი მცირე ზომით, სიმსუბუქით, 12-კვირიანი ბატარეის ხანგრძლივობით, გვერდების სწრაფი გადაფურცვლით და ყურადღების გამფანტავი

Dream Mate AI Chatbot: ახალი პლატფორმა შეუზღუდავი კომუნიკაციისა და როლური თამაშებისთვის
Dream Mate AI Chatbot-ი წარმოადგენს ხელოვნური ინტელექტის პლატფორმას, რომელიც მომხმარებლებს საშუალებას აძლევს, ინტუიციური ინტერფეისის მეშვეობით თავისუფლად გამოხატონ საკუთარი თავი. ის შექმნილია მათთვის, ვისაც სურს AI გამოცდილება, რომელიც სცილდება უბრალო დახმარებას და არის რეაგირებადი და ევოლუციური. პლატფორმა ადაპტირდება საუბრის ჩვევებთან, ითვალისწინებს პირად საზღვრებს და გვთავაზობს შეუზღუდავ კომუნიკაციას, მათ შორის როლურ თამაშებს პერსონალიზებულ პერსონაჟებთან. Dream Mate ჰიბრიდული ფასების სისტემით

Neural Love Photo Generator: AI გამოსახულებების გენერაცია პერსონალური კონტროლით
Neural Love Photo Generator ხელოვნური ინტელექტის გამოსახულების გენერაციას პირად პროცესად აყენებს, მომხმარებლის კონტროლსა და თავისუფალ გადაწყვეტილებაზე აქცენტით, რაც საშუალებას აძლევს ზრდასრულთა კონტენტის შექმნას დაწესებული ფილტრების გარეშე. GetHoney AI-ის მსგავსი ინტუიციური ინტერფეისი მომხმარებელს საშუალებას აძლევს, ადვილად დაიწყოს მუშაობა და ეტაპობრივად, ცდისა და შეცდომის მეთოდით მიაღწიოს სასურველ შედეგს. პლატფორმის ფასების მოდელი მოხმარებაზეა დაფუძნებული, უფასო საცდელი პერიოდით და ფასიანი კრედ

ZDNET-ის რეკომენდაციები: VPN სმარტ ტელევიზორებისთვის და NordVPN-ის დეტალური მიმოხილვა
ZDNET-ის რეკომენდაციები ეფუძნება მრავალსაათიან ტესტირებას, კვლევასა და შედარებით შოპინგს, რათა მომხმარებლებს მიაწოდოს ზუსტი და სანდო ინფორმაცია. სტატია განმარტავს ZDNET-ის შეფასების მეთოდოლოგიას, ხაზს უსვამს VPN-ის მნიშვნელობას სმარტ ტელევიზორებისთვის კონფიდენციალურობის დასაცავად და სტრიმინგ სერვისებზე წვდომისთვის. იგი დეტალურად მიმოიხილავს საუკეთესო VPN სერვისებს სმარტ ტელევიზორებისთვის, განსაკუთრებით გამოყოფს NordVPN-ს, როგორც უსწრაფეს და ყველაზე საიმედო ვარიანტს მისი შესანიშნავი სიჩქარის, სერ

ZDNET-ის რეკომენდაციები: რატომ არის ძველი ლეპტოპები კვლავ საუკეთესო არჩევანი ბიუჯეტურ ფასად?
ZDNET განმარტავს თავის სარედაქციო დამოუკიდებლობასა და პროდუქტის შეფასების მეთოდოლოგიას, რომელიც მოიცავს მრავალსაათიან ტესტირებას, კვლევასა და მომხმარებელთა გამოხმაურების ანალიზს. სტატია ხაზს უსვამს, რომ ზოგიერთი ძველი ლეპტოპის მოდელი კვლავაც გვთავაზობს ძლიერ შესრულებას და შესანიშნავ ხარისხს, განსაკუთრებით მაშინ, როდესაც RAM-ის ფასები იზრდება. წარმოდგენილია კონკრეტული რეკომენდაციები, მათ შორის განახლებული M1 MacBook Pro, Lenovo ThinkPad T14s Gen 6 და Samsung Galaxy Book5 Pro 360, რომლებიც დღესაც

ZDNET: როგორ ვირჩევთ საუკეთესოს და რობოტი Mova Mobius 60 – სახლის სისუფთავის ახალი სტანდარტი
ZDNET განმარტავს თავის მკაცრ სარედაქციო პრინციპებსა და პროდუქტის შეფასების მეთოდოლოგიას, რომელიც დაფუძნებულია მრავალსაათიან ტესტირებასა და მომხმარებელთა მიმოხილვებზე, რათა უზრუნველყოს დამოუკიდებელი და სანდო რჩევები. სტატია ასევე მიმოიხილავს Mova Mobius 60 რობოტ მტვერსასრუტ-მოპს, რომელიც გამოირჩევა 30,000Pa შეწოვის სიმძლავრით, ავტონომიური მოპის ბალიშების ცვლისა და თვითწმენდის ინოვაციური სისტემით. ეს მოწყობილობა განსაკუთრებით ეფექტურია მყარი და შერეული იატაკის მქონე სახლებისთვის, რადგან ის შექმნილ
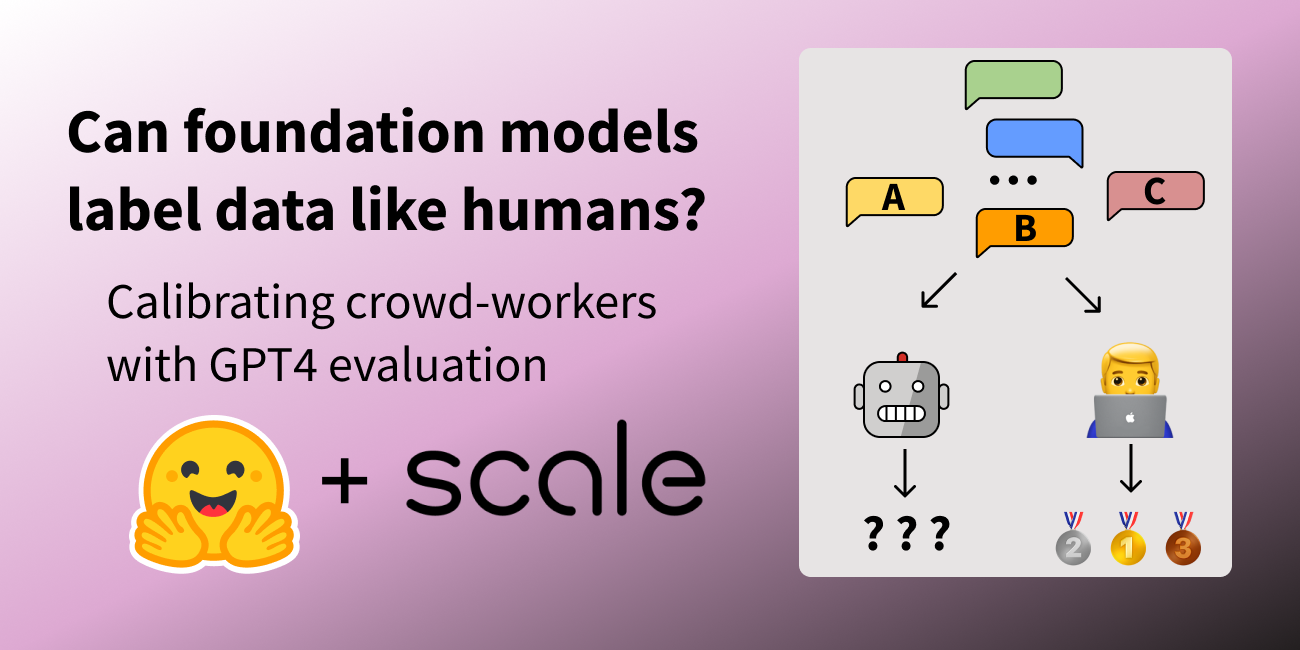
LLM-ების შეფასება: სად შეგვიძლია ვენდოთ მონაცემებს?
სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) შეფასების არსებულ გამოწვევებს, განსაკუთრებით GPT-4-ზე დაფუძნებულ მეტრიკაზე დამოკიდებულებას, რაც შესაძლოა სრულად არ ასახავდეს ადამიანურ უპირატესობებს. ხაზგასმულია ადამიანურად მარკირებული მონაცემების მნიშვნელობა რეალური უპირატესობების გასაზომად და წარმოდგენილია Hugging Face Open LLM ლიდერბორდის გაფართოება. ეს გაფართოებული ლიდერბორდი აერთიანებს ავტომატიზებულ აკადემიურ ბენჩმარკებს, პროფესიონალურ ადამიანურ მარკირებას და GPT-4 შეფასებებს, რათა უზრუნველყო

AraGen-ის ლიდერბორდი: ინოვაციური ჩარჩო დიდი ენობრივი მოდელების ყოვლისმომცველი შეფასებისთვის
AraGen-ის ლიდერბორდი წარმოადგენს ახალ, ინოვაციურ ჩარჩოს დიდი ენობრივი მოდელების (დემ) შესაფასებლად. ის გვთავაზობს 3C3H საზომს, რომელიც აფასებს მოდელის პასუხებს ექვს განზომილებაში (სისწორე, სრულყოფილება, ლაკონურობა, გამოსადეგობა, პატიოსნება და უვნებლობა) დემ-მოსამართლის პრინციპზე დაყრდნობით, ფაქტობრივი სიზუსტისა და გამოყენებადობის გათვალისწინებით. სისტემა მოიცავს დინამიურ შეფასებებს ბრმა ტესტირების ციკლებით მონაცემთა დაბინძურების თავიდან ასაცილებლად. AraGen განსაკუთრებულ აქცენტს აკეთებს არაბული ე

LLaMA-ს MMLU შეფასება: უთანხმოება ხელოვნური ინტელექტის მოდელების რეიტინგში
Open LLM ლიდერბორდზე LLaMA მოდელის MMLU (Massive Multitask Language Understanding) შეფასების ქულები გაცილებით დაბალი აღმოჩნდა, ვიდრე მის გამოქვეყნებულ ნაშრომში იყო მითითებული. ამან საზოგადოებაში გაკვირვება გამოიწვია. გამოძიებამ გამოავლინა MMLU შეფასების სხვადასხვა იმპლემენტაცია, მათ შორის EleutherAI Harness, ორიგინალი UC Berkeley-ის კოდი და Stanford HELM, რომლებიც განსხვავებულ შედეგებს იძლევა და მოდელების რეიტინგსაც კი ცვლის. სტატია დეტალურად განმარტავს ამ შეუსაბამობის მიზეზებს და დიდი ენობრივი
ღია კოდის AI თამაშების ჯემი: გამარჯვებული და გამორჩეული ნამუშევრები
ღია კოდის ხელოვნური ინტელექტის თამაშების ჯემმა, რომლის მიზანიც იყო ღია კოდის AI ინსტრუმენტების თამაშებში ინტეგრირება, მოლოდინს გადააჭარბა 1300-ზე მეტი რეგისტრაციითა და 88 თამაშის წარდგენით. თემამ „გაფართოება“ ხელი შეუწყო მრავალფეროვან შემოქმედებას. თანატოლთა შეფასებისა და ჟიურის მსჯელობის შემდეგ, „Snip It“ (ohmlet-ის მიერ) დასახელდა გამარჯვებულად, რომელმაც წარმოაჩინა ინოვაციური, ხელოვნური ინტელექტის მიერ გენერირებული გეიმპლეი.

DeepSeek R1-ის გამოშვებიდან ორი კვირა: ღია-R1 პროექტის მიღწევები და გამოწვევები
სტატია აჯამებს ღია-R1 პროექტის განვითარებას, რომელიც DeepSeek R1-ის სასწავლო კონვეიერისა და სინთეზური მონაცემების რეპლიკაციას ისახავს მიზნად. მიღწევებს შორისაა DeepSeek-ის შეფასების ქულების რეპროდუცირება და GRPO-ის ინტეგრაცია TRL-ში. პროექტი DeepSeek R1-ის ხანგრძლივი პასუხების გამო GPU მეხსიერებისა და გენერაციის ეფექტურობის გამოწვევების წინაშე დგას, თუმცა ინფერენსის ოპტიმიზაციაში მნიშვნელოვანი პროგრესია. ინიციატივამ მედიის ფართო ინტერესიც გამოიწვია.

Math-Verify-ის დანერგვა: ღია LLM ლიდერბორდის რეიტინგების გადაფასება უფრო სამართლიანი შედარებებისთვის
Hugging Face-ის ღია LLM ლიდერბორდმა მნიშვნელოვანი განახლება განიცადა Math-Verify ინსტრუმენტის დანერგვით. ამ ახალმა სისტემამ ხელახლა შეაფასა ყველა 3,751 წარმოდგენილი მოდელი, რამაც გამოასწორა მათემატიკური ამოცანების შეფასების კრიტიკული პრობლემები. შედეგად, ბევრი მოდელის, განსაკუთრებით Qwen-ისა და DeepSeek-ის, ქულები მნიშვნელოვნად გაუმჯობესდა, ხოლო MATH ქვეჯგუფის ტოპ 20 რეიტინგი სრულად გადალაგდა, სადაც Nvidia-ს AceMath მოდელები ახლა დომინირებენ. ეს უზრუნველყოფს მსხვილი ენობრივი მოდელების (LLM) უფრო
ობიექტის ამოცნობის ლიდერბორდი: მეტრული მაჩვენებლების გაგება და კრიტიკული შეფასება
Hugging Face Hub-მა გამოაქვეყნა ობიექტის ამოცნობის ლიდერბორდი, რომელიც აფასებს მოდელებს სხვადასხვა მეტრიკის საფუძველზე, როგორიცაა „კვეთა გაერთიანებაზე“ (IoU), „საშუალო სიზუსტე“ (AP) და „საშუალო გახსენება“ (AR). ეს ბლოგი დეტალურად განიხილავს მოდელების შეფასების მეთოდებს, განმარტავს გამოყენებულ მეტრიკას და მიზნად ისახავს შეფასებისას წარმოშობილი სირთულეების გამარტივებას, რათა მომხმარებლებს შეეძლოთ მოდელის მუშაობის კრიტიკულად შეფასება. ასევე ახსნილია ობიექტის ამოცნობის კონცეფცია, მისი აპლიკაციები და
Hugging Face-ის სიახლეები: ივნისი, ივლისი, აგვისტო
ბოლო თვეებში Hugging Face Hub მნიშვნელოვნად გაფართოვდა, დაინერგა „Spaces“ მანქანური სწავლების დემო აპლიკაციებისთვის, ასევე დაემატა ახალი ფუნქციები, როგორიცაა რეპოზიტორების მოწონება, TensorBoard-ის ინტეგრაცია და შეფასების დეტალური მეტრიკა. დაინერგა ახალი ვიჯეტები სხვადასხვა ხელოვნური ინტელექტის მოდელებისთვის (ტექსტი, აუდიო, გამოსახულება). პლატფორმამ გააუმჯობესა დოკუმენტაცია, რეპოზიტორების მართვა და გამოუშვა უფასო ონლაინ კურსი. დიდი საზოგადოებრივი ღონისძიება, რომელშიც 800-მდე მონაწილე იყო ჩართული,
Hugging Face-ის ზაფხულის განახლებები: ივნისი, ივლისი, აგვისტო
ეს პოსტი აჯამებს Hugging Face-ის ივნის-აგვისტოს განახლებებს, მათ შორის საჯარო მოდელების რეპოზიტორიების 10,000-დან 16,000-მდე ზრდას. წარმოდგენილია ახალი ფუნქციები, როგორიცაა „Spaces“ ML დემო აპლიკაციების ჰოსტინგისთვის, ნივთების „მოწონების“ შესაძლებლობა, TensorBoard-ის ინტეგრაცია, შეფასების მეტრიკები, რომლებიც დაკავშირებულია Papers With Code-თან, ახალი ვიჯეტები სხვადასხვა ML ამოცანებისთვის (აუდიო, სტრუქტურირებული მონაცემები, გამოსახულება), გაუმჯობესებული დოკუმენტაცია, რეპოზიტორიების გადატანა/გადარ
3D Gaussian Splatting: რა არის და რატომ იპყრობს ის ყურადღებას?
3D Gaussian Splatting არის რასტერიზაციის ინოვაციური ტექნიკა, რომელიც საშუალებას იძლევა მაღალი ხარისხის 3D სცენების რეალურ დროში რენდერირებისთვის. ის იყენებს გაუსიანებს სამკუთხედების ნაცვლად, რათა შექმნას სივრცის მკვრივი წარმოდგენა. მეთოდი იწყება SfM-ით წერტილოვანი ღრუბლის შეფასებით, რასაც მოჰყვება გაუსიანებად გარდაქმნა და სტოქასტური გრადიენტული დაშვების გამოყენებით წვრთნა. მისი პოტენციალი მოიცავს ანიმაციას, ანარეკლებს და მნიშვნელოვან გავლენას Embodied AI-ის კვლევაზე, თუმცა მისი სრული ინტეგრაცია

Reranker მოდელების მორგება: ძალა, რომელიც აჭარბებს დიდ მოდელებს
Reranker მოდელების მორგება (finetuning) გადამწყვეტია მათი პოტენციალის მაქსიმალურად გამოსაყენებლად. ეს პროცესი მოიცავს მონაცემთა ბაზებს, დანაკარგის ფუნქციებს, ტრენინგის არგუმენტებსა და შემფასებლებს. სტატია ხაზს უსვამს, რომ დომენზე სპეციალურად მორგებულ პატარა reranker მოდელსაც კი შეუძლია მნიშვნელოვნად აჯობოს ბევრად უფრო დიდ, ზოგადი დანიშნულების მოდელებს. embedding მოდელებისგან განსხვავებით, reranker მოდელები (ჯვარედინი ენკოდერები) ტექსტების წყვილებს ერთად ამუშავებენ, რაც მათ შესაბამისობის შეფასები
Hugging Face: კონფიდენციალური მონაცემების ცენტრალიზებული მართვა Infisical-ით
Hugging Face-ის ინფრასტრუქტურის მრავალღრუბლოვან გარემოში განვითარებასთან ერთად, საინჟინრო გუნდმა მოითხოვა კონფიდენციალური მონაცემების მართვის უფრო მოქნილი, უსაფრთხო და ცენტრალიზებული მეთოდი. HashiCorp Vault-ის მსგავსი გადაწყვეტილებების შეფასების შემდეგ, მათ აირჩიეს Infisical მისი დეველოპერებისთვის მოსახერხებელი სამუშაო პროცესების, მრავალღრუბლოვანი აბსტრაქციისა და უსაფრთხოების მძლავრი შესაძლებლობების გამო. ამ მიგრაციამ მნიშვნელოვნად გააუმჯობესა უსაფრთხოების პოზიცია Kubernetes Operator-თან, CI/CD
არაბული AI მოდელების შეფასების პლატფორმისა და AraGen ეტალონის მნიშვნელოვანი განახლებები
მიმდინარე ძალისხმევის ფარგლებში, წარმოდგენილია მნიშვნელოვანი განახლებები არაბული AI მოდელების შეფასების პლატფორმაზე. ამოქმედდა Arabic-Leaderboards, რომელიც არაბული ენის მოდელების შეფასებისთვის ერთიან სივრცეს წარმოადგენს. დეკემბერში დაინერგა AraGen ეტალონი დინამიური შეფასების მეთოდოლოგიით, სადაც მონაცემთა ნაკრები სამი თვის განმავლობაში კონფიდენციალური რჩება სამართლიანი შეფასებისთვის. გაფართოვდა AraGen მონაცემთა ნაკრები და დაიხვეწა შემფასებელი სისტემის მოთხოვნები. მიუხედავად იმისა, რომ ახალმა განა
LLM შეფასების კრიტიკული ხარვეზები DROP ბენჩმარკში: ნორმალიზაციისა და „გაჩერების ტოკენების“ პრობლემა
Open LLM Leaderboard-ზე DROP ბენჩმარკის დამატების შემდეგ, მოდელების f1-ქულებმა მოულოდნელად დაბალი შედეგები აჩვენა. გამოკვლევამ გამოავლინა ორი ძირითადი პრობლემა: არასწორი ნორმალიზაცია, რომელიც უგულებელყოფდა რიცხვით პასუხებს არასტანდარტული სიცარიელის სიმბოლოების გამო, და წერტილის (.) „გაჩერების ტოკენად“ გამოყენება. ამ ხარვეზების აღმოფხვრა, მათ შორის \n სიმბოლოზე დაყოფა, მნიშვნელოვნად აუმჯობესებს ქულების კორელაციას საერთო შესრულებასთან. თუმცა, სრული ხელახალი შეფასება ძვირი და შრომატევადია, რაც მიუთ

ხელოვნური ინტელექტი: გამოსახულებების ტოკენიზაცია და ViT მოდელების წვრთნა
ეს სტატია განმარტავს, თუ როგორ ხდება გამოსახულებების ტოკენიზაცია წინადადებების მსგავსად, რაც მათ საშუალებას აძლევს, დამუშავდეს ტრანსფორმერული მოდელებით. დეტალურად არის აღწერილი 🤗 datasets-ის გამოყენებით მონაცემთა მომზადება, ViTImageProcessor-ის ინტეგრირება და წინასწარ გაწვრთნილი ViT მოდელების დაზუსტება. მიმოხილულია ტრენინგის კონფიგურაციის, შეფასების მეტრიკების განსაზღვრისა და ეფექტური წვრთნის კონვეიერის აგების პროცესები, რაც მნიშვნელოვან წინსვლას წარმოადგენს გამოსახულების კლასიფიკაციის ამოცანებშ

HELMET: ყოვლისმომცველი ბენჩმარკი გრძელკონტექსტური ენობრივი მოდელების შესაფასებლად
HELMET, რომელიც გასულ ოქტომბერს გამოვიდა, გახდა პოპულარული ინსტრუმენტი გრძელკონტექსტური ენობრივი მოდელების (LCLM) შესაფასებლად, რომელსაც იყენებენ ისეთი კომპანიები, როგორებიცაა Microsoft და AI21. მუდმივად განვითარებადი LCLM-ების გათვალისწინებით, HELMET გთავაზობთ ახალ, გაფართოებულ შეფასების მეთოდებს, რომლებიც წარმოდგენილი იქნება ICLR 2025-ზე. ეს ბენჩმარკი მიზნად ისახავს გადაჭრას არსებული შეფასების მეთოდების ნაკლოვანებები, უზრუნველყოფს მოდელების მრავალფეროვან, კონტროლირებად და საიმედო შედარებას რეა
Vectara-ს HHEM ლიდერბორდი Hugging Face-ის შაბლონით LLM-ის „ჰალუცინაციის“ შესაფასებლად
კომპანია Vectara-მ წარმოადგინა ჰიუზის ჰალუცინაციის შეფასების მოდელი (HHEM), ღია კოდის ინსტრუმენტი, რომელიც ზომავს დიდი ენობრივი მოდელების (LLM) მიერ „ჰალუცინაციის“ (უაზრო ტექსტის გენერირება) ხარისხს. მოდელი აფასებს როგორც ღია კოდის, ასევე კომერციულ LLM-ებს, ხაზს უსვამს მათ შორის არსებულ განსხვავებებს. HHEM ლიდერბორდის მართვის საჭიროების გამო, Vectara-მ Hugging Face-ის ახალი ლიდერბორდის შაბლონები გამოიყენა და გამოუშვა HHEM ლიდერბორდი. ეს ინიციატივა მიზნად ისახავს LLM „ჰალუცინაციების“ შეფასების დე