DecodingTrust: LLM-ების სანდოობის შეფასების პლატფორმა და ახალი უსაფრთხოების ლიდერბორდი
2023 წელს Secure Learning Lab-მა წარმოადგინა DecodingTrust, პირველი ყოვლისმომცველი პლატფორმა დიდი ენობრივი მოდელების (LLM) სანდოობის შესაფასებლად. პლატფორმა მოიცავს რვა პერსპექტივას, მათ შორის ტოქსიკურობას, სტერეოტიპულ მიკერძოებას, კონფიდენციალურობასა და ეთიკას, და იყენებს ინოვაციურ „წითელი გუნდის“ (red-teaming) მეთოდოლოგიებს. ცოტა ხნის წინ, გამოქვეყნდა ახალი LLM უსაფრთხოების ლიდერბორდი, რომელიც LLM-ების უსაფრთხოების შეფასებაზეა ორიენტირებული.
ახალი LLM ლიდერბორდი რეალურ ბიზნეს სცენარებში ენის მოდელების შეფასებისთვის
ეს ლიდერბორდი მიზნად ისახავს ენის დიდი მოდელების (LLM) მუშაობის შეფასებას რეალური ბიზნეს ამოცანების კონტექსტში. ის მხარს უჭერს 6 მრავალფეროვან დავალებას, როგორიცაა FinanceBench და იურიდიული კონფიდენციალურობა, და ზომავს მოდელების ეფექტურობას ისეთი მეტრიკებით, როგორიცაა სიზუსტე, ჩართულობა და ტოქსიკურობა. ლიდერბორდი შემუშავდა იმისათვის, რომ დაეხმაროს მომხმარებლებს პრაქტიკული გამოყენებისთვის საუკეთესო მოდელის არჩევაში და აქტიურად ცდილობს თავიდან აიცილოს ტესტ-კომპლექტის დაბინძურება ზოგიერთი მონაცემთა
NPHardEval: ახალი დინამიური ჩარჩო დიდი ენობრივი მოდელების მსჯელობის უნარის შესაფასებლად
NPHardEval წარმოგიდგენთ ინოვაციურ, დინამიურ და სირთულეზე დაფუძნებულ ჩარჩოს დიდი ენობრივი მოდელების (LLMs) მსჯელობის უნარების მკაცრი შეფასებისთვის. ის მოიცავს 900 ალგორითმულ კითხვას NP-რთული სირთულის კლასიდან და ქვედა დონეებიდან, რომლებიც ყოველთვიურად განახლდება მოდელების ზედმეტი მორგების თავიდან ასაცილებლად. NPHardEval გამოირჩევა გამოთვლითი სირთულის კლასების გამოყენებით, რაც LLM-ის აზროვნების უნარების რაოდენობრივ და მტკიცე შეფასებას უზრუნველყოფს, რეალურ სამყაროში არსებული გამოწვევების ასახვით.
Hugging Face-ის მულტიმოდალური სწავლის ჯგუფი ხელოვნური ინტელექტის ეთიკურ პრინციპებს აფორმალებს
Hugging Face-ის მულტიმოდალური სწავლის ჯგუფმა დაასახელა ეთიკური პრინციპები თავისი ხელოვნური ინტელექტის პროექტისთვის, რაც მიზნად ისახავს გამჭვირვალობის, ადრეული უკუკავშირისა და პოტენციური ზიანის შემცირების უზრუნველყოფას. დოკუმენტი აღიარებს „ეთიკური ხელოვნური ინტელექტის“ არასრულყოფილ დეფინიციას და ხაზს უსვამს რისკებისა და სარგებლის შეფასების აუცილებლობას თითოეულ კონკრეტულ შემთხვევაში, ამასთან ერთად აცხადებს, რომ ეს არის მუშა პროცესში არსებული დოკუმენტი.
Open Ko-LLM ლიდერბორდი: კორეული ხელოვნური ინტელექტის განვითარების ახალი ეტაპი
Upstage-მა 2023 წლის სექტემბერში Open Ko-LLM ლიდერბორდი წარადგინა, რომლის მიზანიც კორეული დიდი ენობრივი მოდელების (LLM) შეფასების ეკოსისტემის შექმნა და გამჭვირვალობის ხელშეწყობა იყო. პლატფორმა, რომელიც კორეული ენის უნიკალურ მახასიათებლებს ითვალისწინებს, მოკლე დროში დიდი პოპულარობით სარგებლობს, 5 თვეში 1000-ზე მეტი მოდელის წარდგენით. მიუხედავად ინფრასტრუქტურული გამოწვევებისა, ლიდერბორდი აქტიურად ვითარდება, რათა რეალურ სამყაროში გამოყენების შემთხვევებს უკეთ მოერგოს და კორეული AI-ის განვითარებას ხე

ScreenSuite: ახალი სტანდარტი GUI აგენტებისა და VLM-ების შეფასებაში
ბოლო კვირების განმავლობაში, ინტენსიური მუშაობის შედეგად, შევქმენით GUI აგენტების მუშაობის შეფასების უმსხვილესი ბენჩმარკინგ პლატფორმა – ScreenSuite. ეს არის ყველაზე ყოვლისმომცველი და მარტივი გზა Vision Language Models (VLM)-ების მრავალ აგენტურ შესაძლებლობაზე შესაფასებლად, რაც მიზნად ისახავს AI აგენტების ხელმისაწვდომობისა და ინტეგრაციის გაუმჯობესებას.
TTS Arena: მეტყველების სინთეზის მოდელების შეფასების დემოკრატიზაცია
მეტყველების სინთეზის სფეროში დიდი ხანია არ არსებობდა მოდელების ხარისხის ზუსტი გაზომვის მეთოდი. არსებული ობიექტური და სუბიექტური მეთოდები არაეფექტურია მსგავსი ხარისხის მოდელების შესადარებლად. ამ გამოწვევის საპასუხოდ, შეიქმნა TTS Arena, სადაც საზოგადოებას შეუძლია შეაფასოს სინთეზირებული აუდიო და დაეხმაროს მოდელების რანჟირების დემოკრატიზაციას. პლატფორმა იყენებს ადამიანის შეფასებას, მსგავსად Chatbot Arena-ისა, მოდელების ობიექტური შედარებისთვის.
UCLA-ს მკვლევრებმა LMM-ების შესაფასებლად კონტექსტზე მგრძნობიარე ვიზუალური ამოცანების ახალი მონაცემთა ბაზა – ConTextual შექმნეს
კალიფორნიის უნივერსიტეტის ლოს-ანჯელესის (UCLA) მკვლევრებმა წარმოადგინეს ConTextual – ინოვაციური მონაცემთა ბაზა, რომელიც მიზნად ისახავს დიდი მულტიმოდალური მოდელების (LMMs) კონტექსტზე მგრძნობიარე, ტექსტით მდიდარი ვიზუალური მსჯელობის შესაძლებლობების შეფასებას. ეს მონაცემთა ბაზა 506 რთულ ინსტრუქციას მოიცავს 8 რეალური სამყაროს სცენარში, რათა შეავსოს არსებული შეფასების მეთოდების ხარვეზები, რომლებიც ხშირად უგულებელყოფენ კონტექსტის გაგებას. პროექტის ფარგლებში ასევე შეიქმნა ლიდერბორდი, სადაც საზოგადოებას
როგორ გავხადოთ ხელოვნური ინტელექტის მოდელები უფრო სანდო: დინამიური მოწინააღმდეგე მონაცემთა შეგროვება MNIST-ის მაგალითზე
სტატიკური ბენჩმარკები ხელოვნური ინტელექტის მოდელების შეფასებისას მრავალ პრობლემას ქმნის. სტატია განიხილავს დინამიურ მოწინააღმდეგე მონაცემთა შეგროვების (DADC) მეთოდს, რომელიც ამცირებს ამ ნაკლოვანებებს და ხელს უწყობს სანდო მოდელების შექმნას. MNIST-ის მაგალითზე ნაჩვენებია, თუ როგორ შეუძლიათ ადამიანებს მოდელების „მოტყუება“ და მათი გაწვრთნა უფრო გამძლე სისტემების მისაღებად.
Google-მა CodeGemma - კოდზე ორიენტირებული დიდი ენობრივი მოდელები - გამოუშვა
Google-მა გამოუშვა CodeGemma, კოდზე სპეციალიზებული დიდი ენობრივი მოდელების (LLM) ოჯახი, რომელიც ეფუძნება 2B და 7B Gemma მოდელებს. ის ხელმისაწვდომია Hugging Face Hub-ზე სამ ვერსიად – CodeGemma 2B, CodeGemma 7B და CodeGemma 7B Instruct – და გამიზნულია კოდის შევსების, გენერაციისა და გაგების ამოცანებისთვის, ასევე მათემატიკური და ლოგიკური მსჯელობის გასაუმჯობესებლად. მოდელები გაწვრთნილია დამატებით 500 მილიარდ ტოკენზე და აჩვენებენ მაღალ წარმადობას კოდის შეფასების პოპულარულ ბენჩმარკებზე, როგორიცაა Human

FutureBench: ხელოვნური ინტელექტის შეფასების ახალი სტანდარტი მომავლის პროგნოზირებაში
არსებული AI ბენჩმარკები ძირითადად წარსულის ინფორმაციის ცოდნაზეა ორიენტირებული. FutureBench-ის ახალი მიდგომა ხელოვნური ინტელექტის შეფასებას მომავლის მოვლენების პროგნოზირებაზე ამახვილებს ყურადღებას. ეს კომპლექსური ამოცანა მოითხოვს დახვეწილ მსჯელობასა და სინთეზს, რაც რეალურ ღირებულებას ქმნის. ის გამორიცხავს მონაცემთა დაბინძურების რისკს და უზრუნველყოფს შედეგების ობიექტურ გადამოწმებას. FutureBench იყენებს რეალური სამყაროს მონაცემებსა და ახალ ამბებს საპროგნოზო ამოცანების შესაქმნელად, რაც AI აგენტებს ს
LiveCodeBench: ხელოვნური ინტელექტის პროგრამირების აგენტების შეფასების ინოვაციური სისტემა კონტამინაციის პრევენციით
LiveCodeBench არის პლატფორმა, რომელიც აგროვებს კოდირების ამოცანებს სხვადასხვა კონკურსის პლატფორმებიდან და აღნიშნავს მათ გამოშვების თარიღებს. ეს საშუალებას იძლევა მოდელების შეფასებას დროთა განმავლობაში, რაც ხელს უშლის მონაცემთა დაბინძურებას (კონტამინაციას). სტანდარტული კოდის გენერაციის გარდა, LiveCodeBench ასევე აფასებს თვითშეკეთებას, ტესტის შედეგის პროგნოზირებას და კოდის შესრულებას, რაც ჰოლისტურ ხედვას იძლევა AI პროგრამირების აგენტების შესაძლებლობებზე. ამოცანები LeetCode-დან, AtCoder-იდან და Cod
დიდი ენობრივი მოდელები ჯანდაცვაში: პოტენციალი, გამოწვევები და შეფასების პლატფორმა
დიდი ენობრივი მოდელები (LLM) უდიდეს პოტენციალს ფლობს ჯანდაცვის სფეროს რევოლუციონიზაციისთვის, თუმცა მათ გამოყენებას თან ახლავს სერიოზული გამოწვევები სიზუსტისა და სანდოობის კუთხით, რადგან სამედიცინო შეცდომებმა შეიძლება სიცოცხლისთვის საშიში შედეგები გამოიწვიოს. ამ პრობლემების გადასაჭრელად შეიქმნა „Open Medical-LLM Leaderboard“, სტანდარტიზებული პლატფორმა, რომელიც აფასებს და ადარებს LLM-ების მუშაობას სხვადასხვა სამედიცინო ამოცანასა და მონაცემთა ბაზაზე (როგორიცაა MedQA, MedMCQA, PubMedQA, MMLU). მიზან
ღია CoT ლიდერბორდი: ხელოვნური ინტელექტის მოდელების შეფასება აზროვნების ჯაჭვის გავლენის მიხედვით
ღია CoT ლიდერბორდი წარმოადგენს ახალ პლატფორმას ხელოვნური ინტელექტის (LLM) მოდელების შესაფასებლად. ტრადიციული ლიდერბორდებისგან განსხვავებით, ის ზომავს არა აბსოლუტურ სიზუსტეს, არამედ იმ განსხვავებას, რასაც აზროვნების ჯაჭვის (Chain-of-Thought, CoT) მოთხოვნა იწვევს მოდელის სიზუსტეში. ეს მიდგომა საშუალებას იძლევა ჭეშმარიტად შემოწმდეს CoT-ის გავლენა მოდელის მსჯელობის უნარზე და მიზნად ისახავს შეამციროს ტრენინგის მონაცემების დაბინძურების რისკი, რაც აძლიერებს შეფასების სანდოობას. ლიდერბორდი იყენებს მოდულ

FilBench: ფილიპინური ენებისთვის LLM-ების შეფასების ყოვლისმომცველი სისტემა
FilBench, ახალი ყოვლისმომცველი შეფასების სისტემა, შეიქმნა დიდი ენობრივი მოდელების (LLM) შესაძლებლობების შესაფასებლად ფილიპინურ ენებზე: ტაგალურზე, ფილიპინურსა და სებუანურზე. ის აფასებს ენობრივ უნარებს, მთარგმნელობით შესაძლებლობებს და კულტურულ ცოდნას ოთხი ძირითადი კატეგორიისა და 12 ამოცანის მიხედვით. FilBench-მა გამოავლინა, რომ მიუხედავად SEA-სპეციფიკური LLM-ების ეფექტურობისა, დახურული კოდის მოდელები (როგორიცაა GPT-4o) ჯერ კიდევ სჯობია მათ. ასევე, უმეტეს მოდელს გენერაციის უნარები უჭირს. კვლევამ აჩ
ახალი ლიდერთა დაფა ებრაული ენის LLM-ებისთვის: ნიუანსების შეფასება
ებრაული ენის მორფოლოგიური სირთულის გამო, არსებულ დიდ ენობრივ მოდელებს (LLM) უჭირთ მისი ნიუანსების ზუსტად დამუშავება. ამ ხარვეზის შესავსებად, შეიქმნა ახალი ლიდერთა დაფა, რომელიც სპეციალიზებულ შეფასების ეტალონებს გვთავაზობს ებრაული ენის LLM-ებისთვის. პლატფორმა მოიცავს ოთხ ძირითად მონაცემთა ნაკრებს: კითხვა-პასუხი, განწყობის სიზუსტე, ვინოგრადის სქემის გამოწვევა და თარგმანი. ინიციატივა მიზნად ისახავს მკვლევრებისა და დეველოპერების გაერთიანებას, ღია საზოგადოების წახალისებას და ისრაელის ტექნოლოგიური საზ
ნულოვანი ცდის შეფასება Hugging Face Hub-ზე: დიდი ენობრივი მოდელების მიკერძოების გამოვლენა
Hugging Face Hub-ზე დანერგილი ახალი ნულოვანი ცდის შეფასების ფუნქცია, რომელიც AutoTrain-ის მეშვეობით მუშაობს, მკვლევრებს საშუალებას აძლევს შეაფასონ დიდი ენობრივი მოდელები კოდის წერის ან ეტიკეტირებული მონაცემების გარეშე. ეს მეთოდი მნიშვნელოვნად ამცირებს შეფასების ხარჯებსა და სირთულეს, რაც შეფასებას ხელმისაწვდომს ხდის ფართო საზოგადოებისთვის. ამ ინსტრუმენტის გამოყენებით ჩატარებულმა კვლევამ WinoBias-ის მონაცემთა ნაკრებზე აჩვენა უკუ მასშტაბირების ტენდენცია გენდერულ მიკერძოებასთან დაკავშირებით: უფრო დი

ღია არაბული LLM ლიდერბორდი (OALL): AI-ს განვითარება არაბულენოვანი სამყაროსთვის
ღია არაბული LLM ლიდერბორდი (OALL) არის ინიციატივა, რომელიც მიზნად ისახავს არაბული დიდი ენობრივი მოდელების (LLM) შეფასებასა და გაუმჯობესებას. პროექტი ემსახურება მსოფლიოში 380 მილიონზე მეტ არაბულენოვან მომხმარებელს, სთავაზობს ყოვლისმომცველ შეფასების სისტემას მრავალფეროვანი მონაცემთა ნაკრებებისა და სპეციფიკური მეტრიკების გამოყენებით. OALL-ის მიზანია შექმნას მოდელები, რომლებიც ზუსტად იქნება მორგებული არაბული ენის, კულტურისა და მემკვიდრეობის ნიუანსებზე, სამომავლო გეგმებით, გააფართოვოს ბენჩმარკები და
Hugging Face-ის ბიბლიოთეკაში ენის მოდელების მიკერძოების შეფასების ახალი მეტრიკები დაემატა
Hugging Face-მა თავის 🤗 Evaluate ბიბლიოთეკას დაამატა ახალი მეტრიკები და საზომები, რომლებიც მიმართულია ენის მოდელებში (როგორიცაა GPT-2 და BLOOM) არსებული მიკერძოებების შესასწავლად. ეს ხელსაწყოები საშუალებას იძლევა შეფასდეს ტოქსიკურობა, პოლარობა და მტკივნეულობა (hurtfulness), რითაც ხელს უწყობს ენის მოდელებში დაშიფრული სოციალური საკითხების უკეთ გაგებას და მათთან ბრძოლას. სტატია დეტალურად განიხილავს ამ ხელსაწყოების გამოყენებას სხვადასხვა ამოცანებში.

RiskRubric.ai: ხელოვნური ინტელექტის მოდელების რისკების სტანდარტიზებული შეფასება
Hugging Face-ის ჰაბზე არსებული 500,000-ზე მეტი AI მოდელის უსაფრთხოებისა და სანდოობის შეფასების გამოწვევის საპასუხოდ, Cloud Security Alliance-მა და Noma Security-მ, Haize Labs-ისა და Harmonic Security-ის მონაწილეობით, წამოიწყეს RiskRubric.ai ინიციატივა. ეს პლატფორმა უზრუნველყოფს AI მოდელების რისკების გამჭვირვალე, სტანდარტიზებულ შეფასებას ექვსი ძირითადი სვეტის მიხედვით: გამჭვირვალობა, სანდოობა, უსაფრთხოება, კონფიდენციალურობა, უვნებლობა და რეპუტაცია. მიზანია დეველოპერებსა და ორგანიზაციებს დაეხმაროს
ხელოვნური ინტელექტის ტექსტიდან გამოსახულების გენერაციის ლიდერბორდი ადამიანის შეფასებებით
კომპანია Artificial Analysis-მა შექმნა ტექსტიდან გამოსახულების გენერაციის ხელოვნური ინტელექტის მოდელების ლიდერბორდი, რომელიც ადამიანის შეფასებებზე დაყრდნობით ზომავს მათ ხარისხს. ELO ქულები ეფუძნება 45,000-ზე მეტ ადამიანურ შეფასებას „Image Arena“-დან. ლიდერბორდზე წარმოდგენილია წამყვანი ღია კოდის და კომერციული მოდელები, როგორიცაა Midjourney, DALL·E და Stable Diffusion. საზოგადოებას შეუძლია მონაწილეობა მიიღოს შეფასების პროცესში და მიიღოს პერსონალიზებული რეიტინგი.
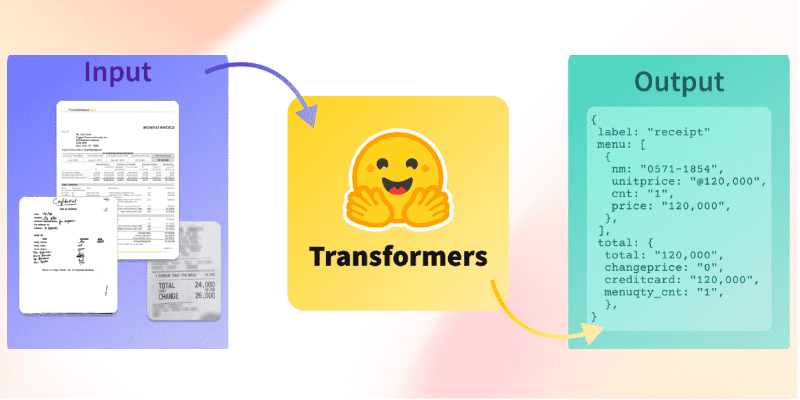
დოკუმენტების ხელოვნური ინტელექტი: OCR-დან დამუშავებამდე წამყვანი მოდელების გამოყენებით
ეს პოსტი იკვლევს დოკუმენტების ხელოვნურ ინტელექტს (Document AI), რომელიც მოიცავს მონაცემთა მეცნიერების სხვადასხვა ამოცანას, როგორიცაა ოპტიკური სიმბოლოების ამოცნობა (OCR), დოკუმენტების კლასიფიკაცია, განლაგების ანალიზი და დამუშავება (parsing). მასში წარმოდგენილია გამოყენების შემთხვევების ტაქსონომია, ხაზგასმულია საუკეთესო ღია კოდის მოდელები (მაგ., LayoutLM, Donut, DiT) და განხილულია ძირითადი ასპექტები, როგორიცაა ლიცენზირება, მონაცემთა მომზადება და შეფასების მეტრიკა. ტექსტი ხაზს უსვამს მულტიმოდალურ მ
BigCodeBench: ახალი ეტალონი LLM-ების პროგრამირების შეფასებისთვის
კვლევითი გუნდი წარმოგიდგენთ BigCodeBench-ს, ახალ, ყოვლისმომცველ ეტალონს, რომელიც მიზნად ისახავს დიდი ენობრივი მოდელების (LLM) პროგრამირების შესაძლებლობების შეფასებას. ეს ინსტრუმენტი, არსებული ალტერნატივების შეზღუდვების საპასუხოდ შეიქმნა და მოიცავს 1,140 ფუნქციურ დავალებას, რომლებიც მოითხოვს პრაქტიკული და რთული პროგრამირების ამოცანების გადაჭრას მკაცრი ტესტირების პირობებში, დაბინძურების გარეშე. BigCodeBench-ი ეხმარება დეველოპერებს, უკეთ შეაფასონ LLM-ების უნარი, მიჰყვნენ ინსტრუქციებს და მოახდინონ ფ
BigCodeBench: ახალი ბენჩმარკი ხელოვნური ინტელექტის პროგრამირების შესაძლებლობების შესაფასებლად
საზოგადოებას კვლავ აკლია მარტივი გამოსაყენებელი ბენჩმარკი, რომელსაც შეუძლია დიდი ენობრივი მოდელების (LLM) პროგრამირების შესაძლებლობების ფართოდ შეფასება. ამ გამოწვევის საპასუხოდ, წარდგენილია BigCodeBench – ახალი, ყოვლისმომცველი შეფასების პლატფორმა, რომელიც 1,140 ფუნქციის დონის ამოცანის საშუალებით ამოწმებს LLM-ებს პრაქტიკული და რთული პროგრამირების ამოცანების გადაწყვეტაში, მათ შორის ინსტრუქციების შესრულებასა და მრავალი ფუნქციის გამოძახებაში 139 ბიბლიოთეკიდან. BigCodeBench მკაცრად აფასებს მოდელებს მ